Redis 入門:從 Key 到資料型別
Remote Dictionary Server

Redis 十大資料型別
Key
命令不區分大小寫 Key 區分大小寫
查看所有 key
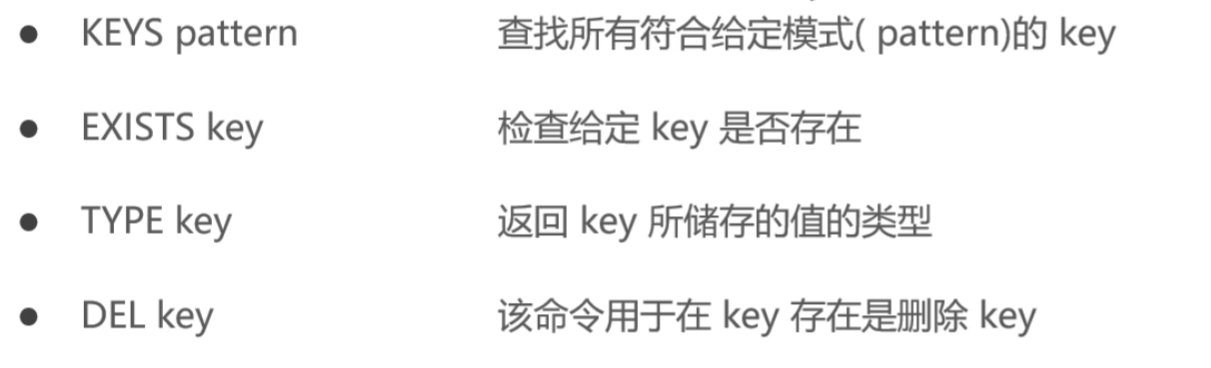
keys *exists keytype keydel keyunlink key非阻塞刪除,僅僅將 keys 從keyspace中繼資料中刪除,真正的刪除會在後續非同步中操作。del key是原子的刪除,只有刪除成功了才會回傳刪除結果,如果是刪除大 key 用 del 會將後面的操作都阻塞,而 unlink key 不會阻塞,它會在背景非同步刪除資料ttl key查看還有多少秒過期,-1 表示永不過期,-2 表示已過期expire key為給定的 key 設定過期時間move key dbindex[0-15]將目前資料庫的 key 移動到給定的資料庫 DB 當中select dbindex切換資料庫 (0-15),預設為 0dbsizeflushdb [ASYNC/SYNC]flushallhelp @型別,help @hash
keys pattern keys * keys set*
exists key
type key
del key
字串 String
string 是 redis 最基本的型別,一個 key 對應 一個 value
string 型別是 二進位安全 的,意思是 redis 的 string 可以包含任何資料,比如 jpg 圖片或者序列化的物件。
string 型別是 Redis 最基本的資料型別,一個 redis 中字串 value 最多可以是 512M
SET key valueGet keySETEX key seconds valueSETNX key valueSet if not exists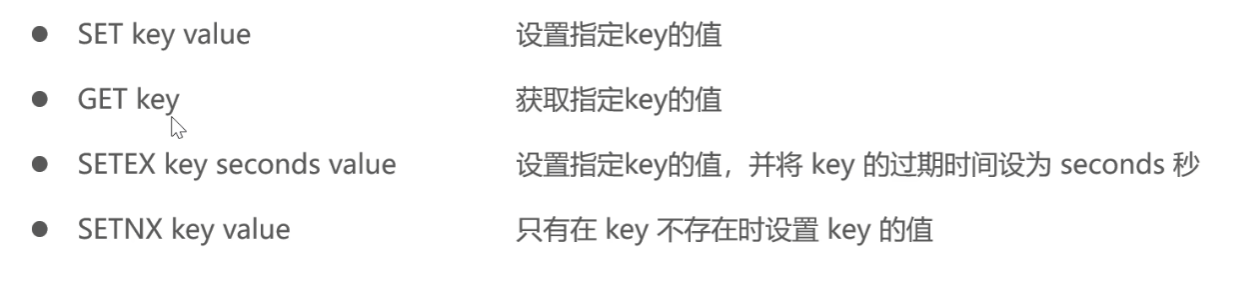
列表 (list)
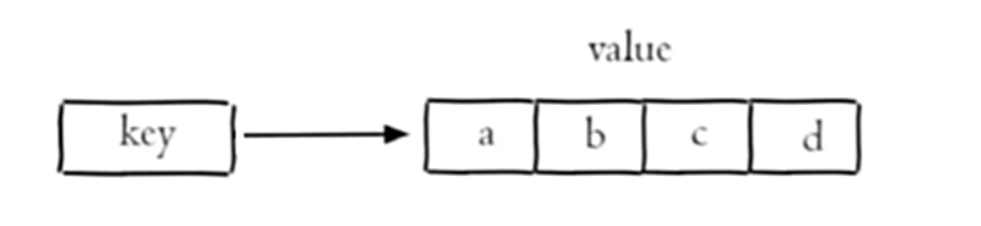
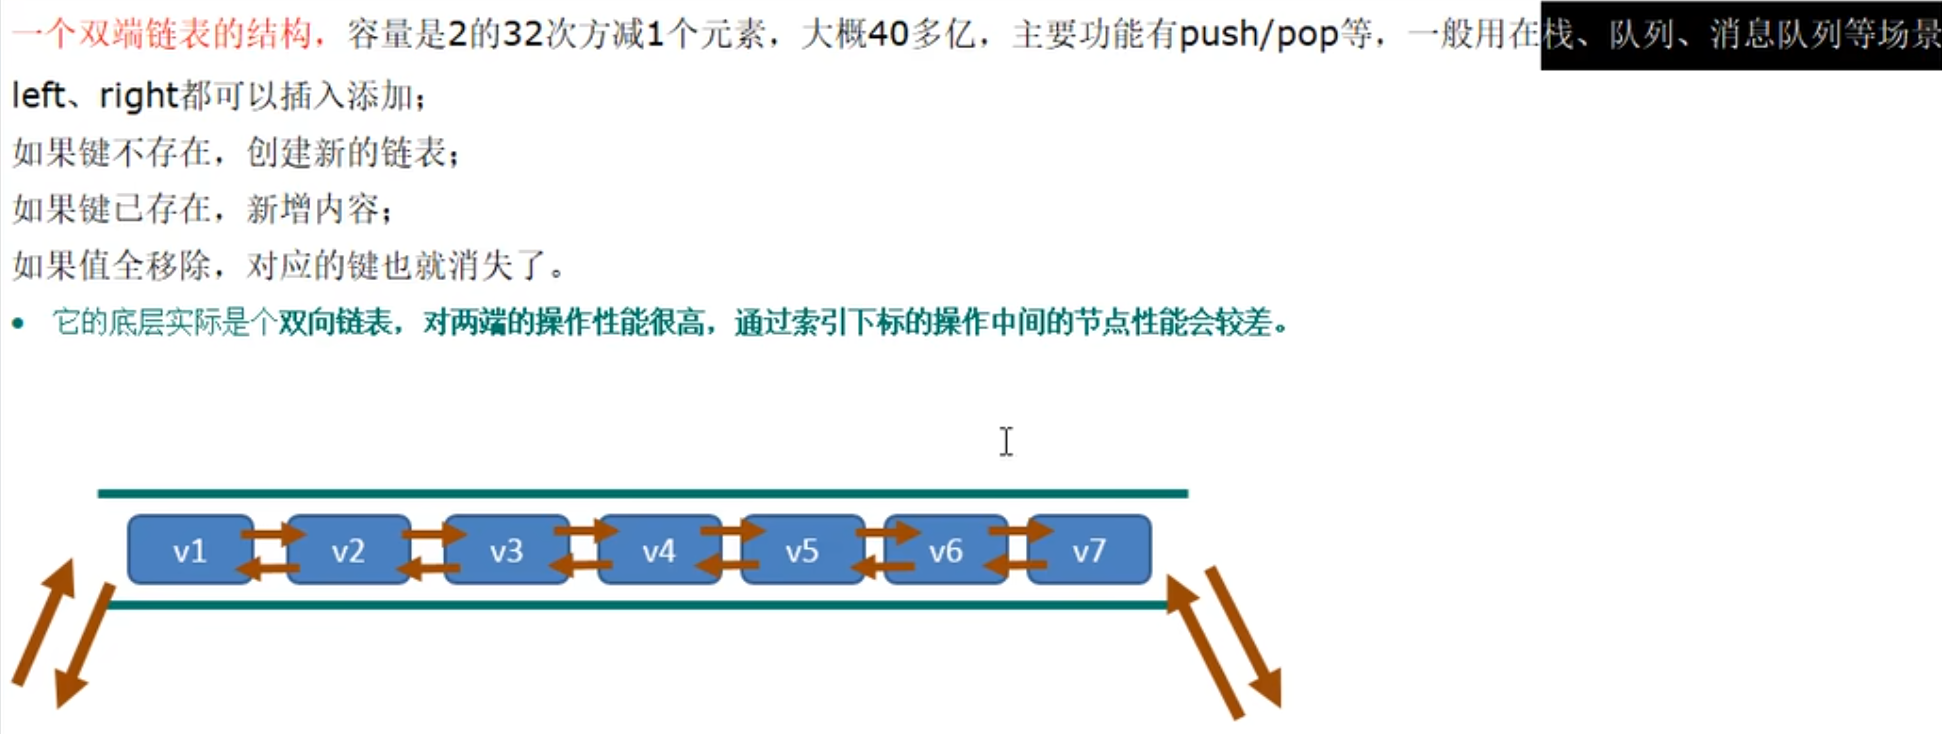
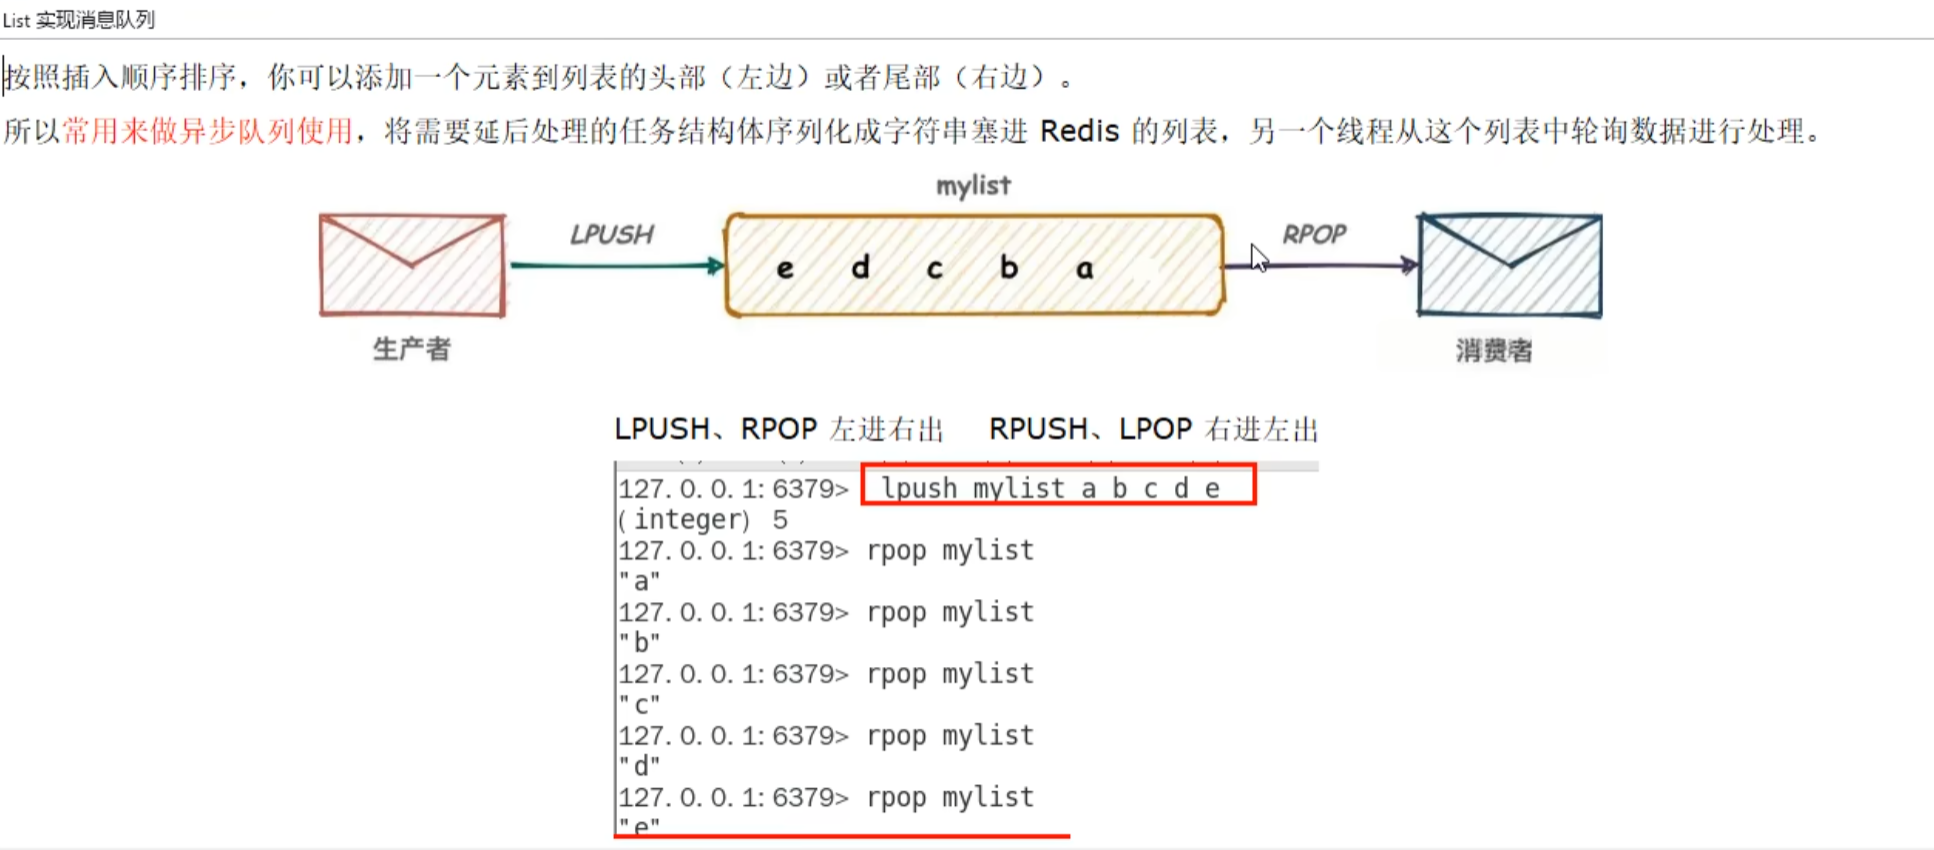
Redis 列表是簡單的字串列表,按照插入順序排序。你可以新增一個元素到列表的頭部 (左邊) 或者尾部 (右邊)
它的底層實際是個雙端鏈結串列,最多可以包含 2^32-1 個元素 (4294967295,每個列表超過 40 億個元素)
簡單的字串列表,按照插入順序排序
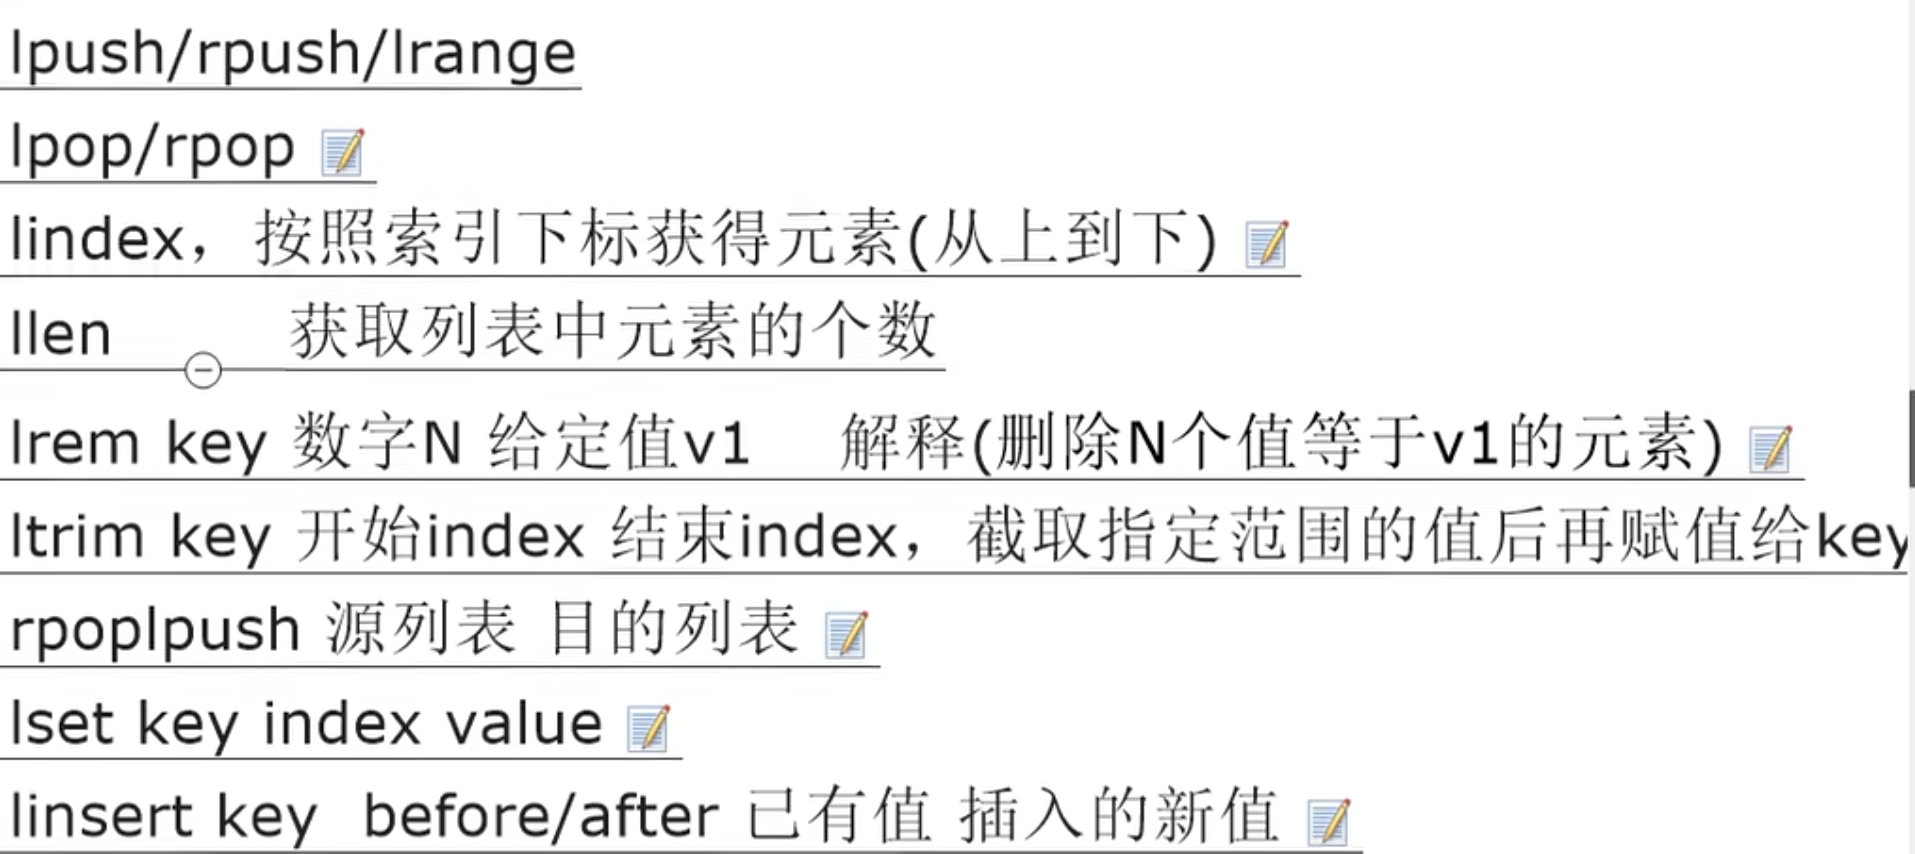
lpush key value1 value2 value3lrange key start stop0 代表頭部,-1 代表尾部rpop keyllen keylindex key indexllen keylrem key number valuenumber=0 代表全部ltrim key index1 index2刪除從索引index1到索引index2的值rpoplpush key1 key2將 key1 最後一個資料彈到 key2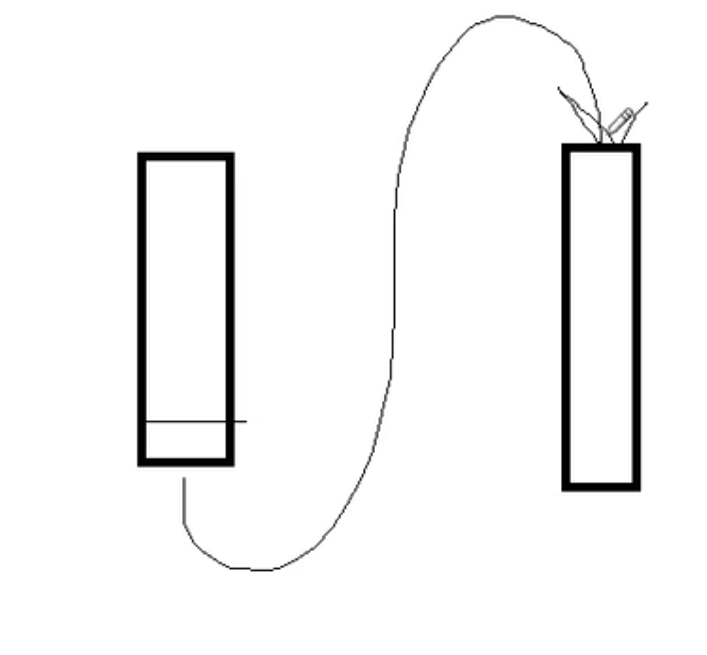
lset key index value替換linsert before value1 value2/aftervalue1 value2before 在 value 1 前插入 value 2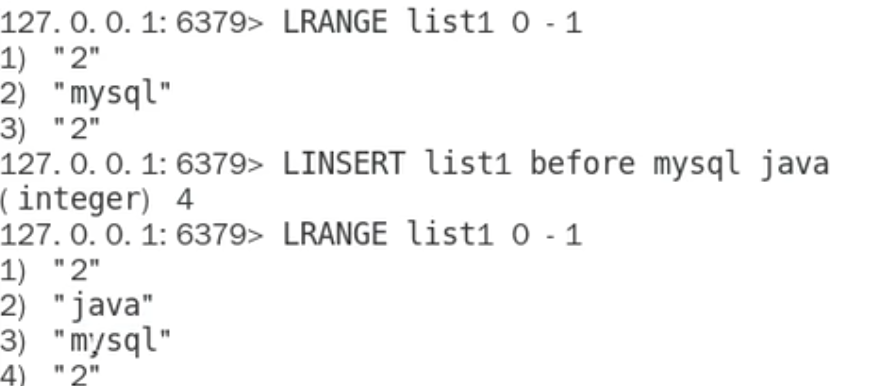


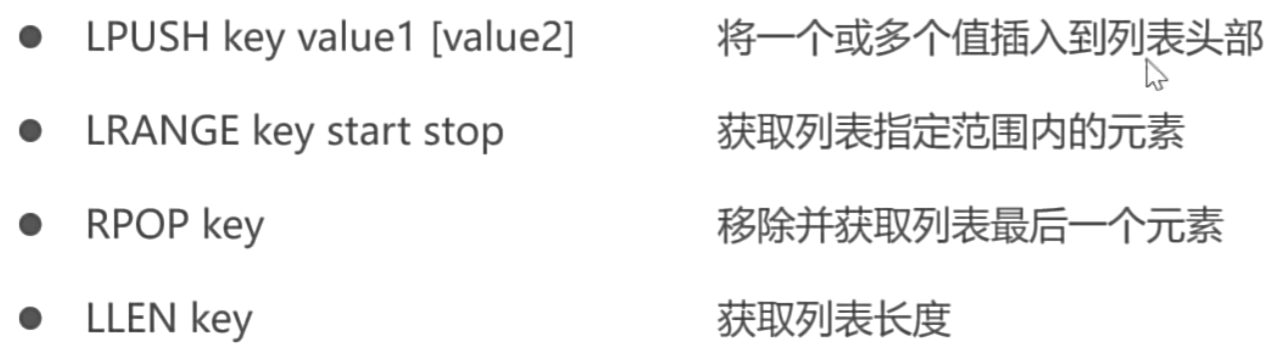
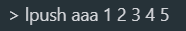
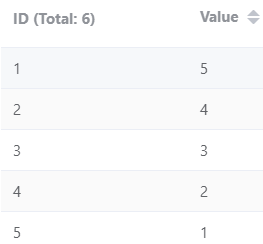 最後插入的在第一位
雜湊 (hash)
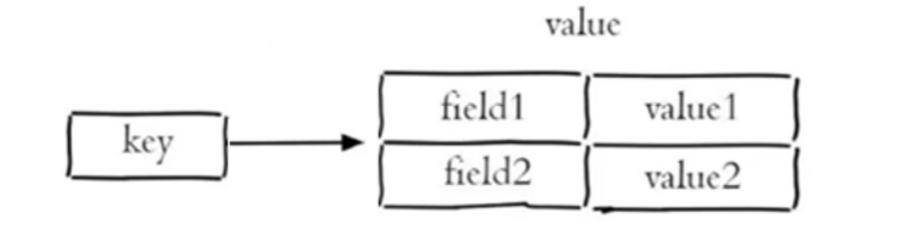
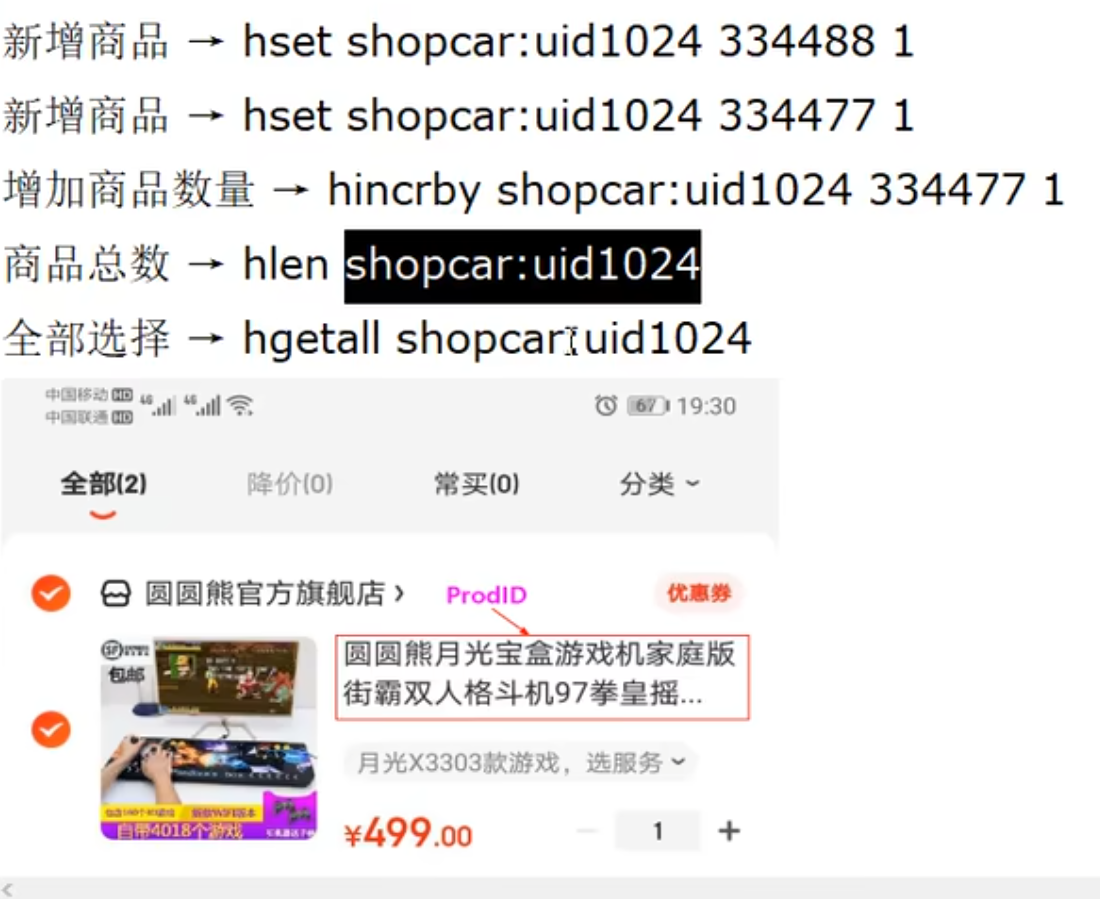
一個 String 型別的 field 和 value 的映射表,hash 特別適合儲存 物件
Redis hash 是一個 string 型別 field (欄位) 和 value (值) 的映射表, hash 特別適合用於儲存物件。Redis 中每個 hash 可以儲存 2^32-1 鍵值對 (40 多億)
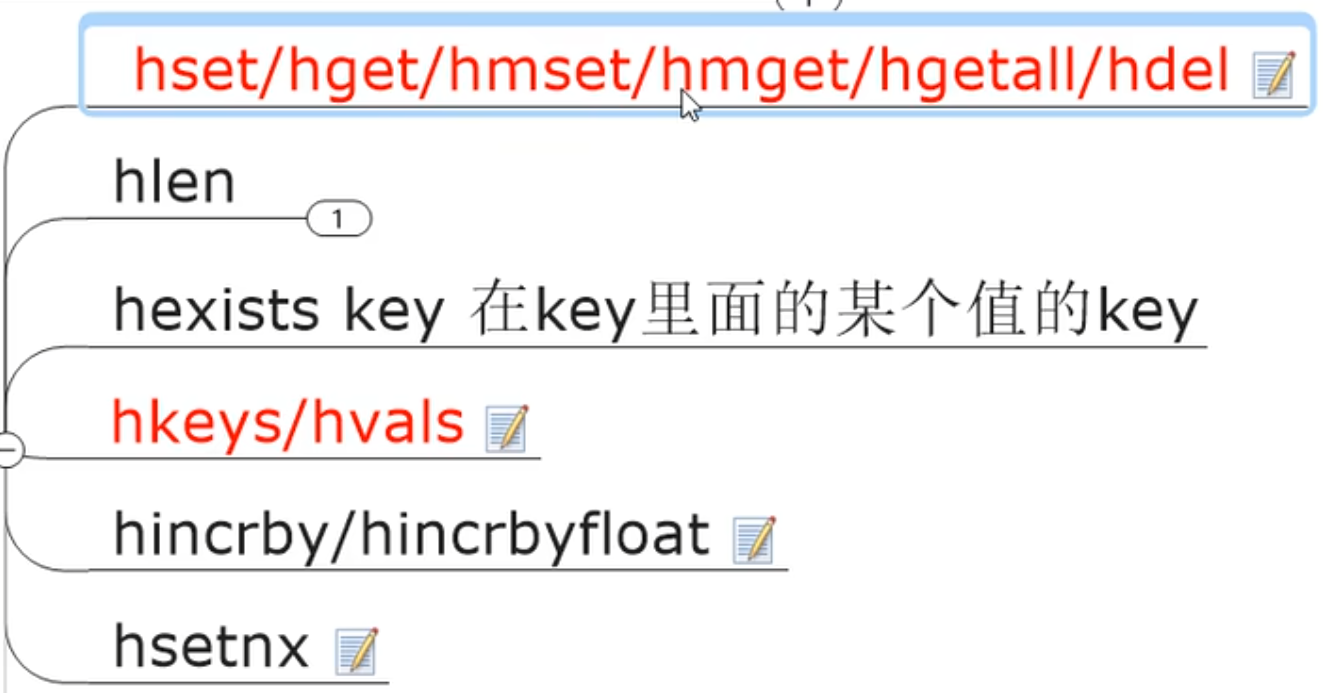
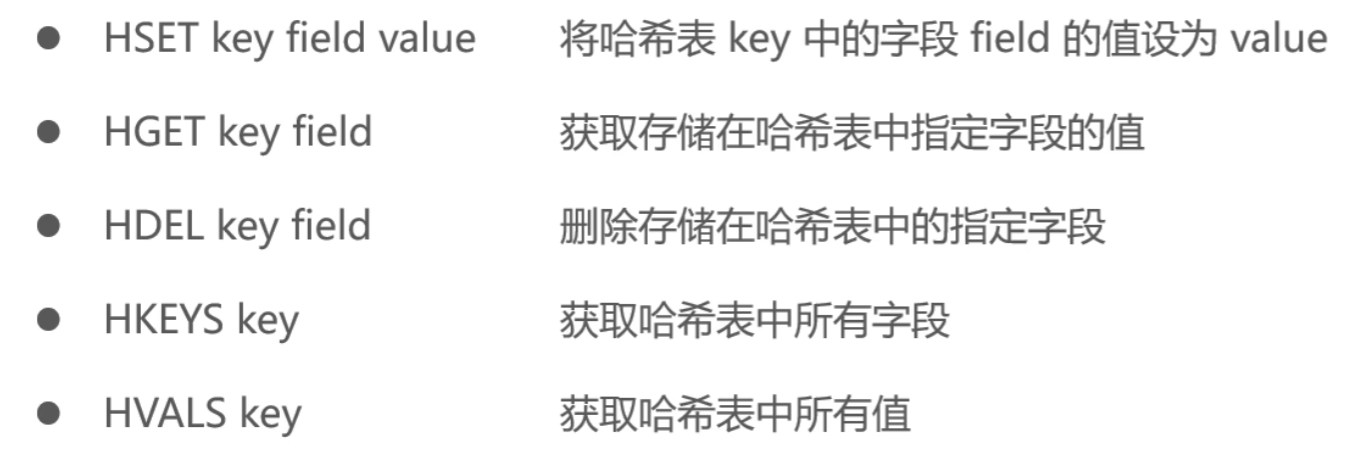
HSET key field valueHGET key fieldHDEL key fieldHKEYS keyHVALS keyhlen keyhexists keyhkeys/hvalshincrby/hincrbyfloathsetnx
集合 (set)
單值多 value,無重複,無序無重複, list 是有序有重複
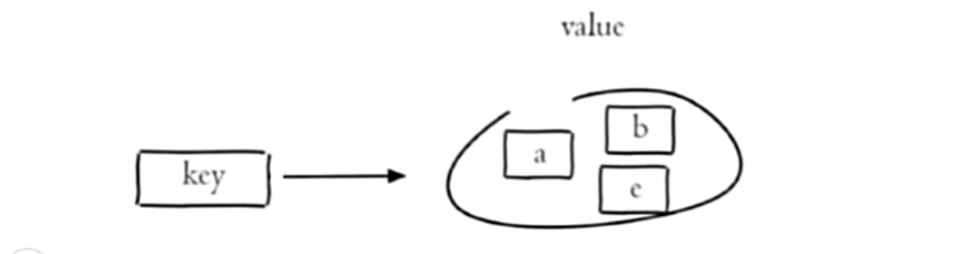
String 型別的無序集合,集合成員是唯一的,集合中 不能重複 的資料
Redis 的 Set 是 String 類型的無序集合。集合成員是唯一的,這就意味著集合中不能出現重複的資料,集合對象的編碼可以是 intset 或者 hashtable
Redis 中 Set 集合是透過雜湊表實作的,所以新增,刪除,查找的複雜度都是 O(1)
集合中最大的成員數為 2^32-1 (4294967295,每個集合可儲存 40 多億個成員)
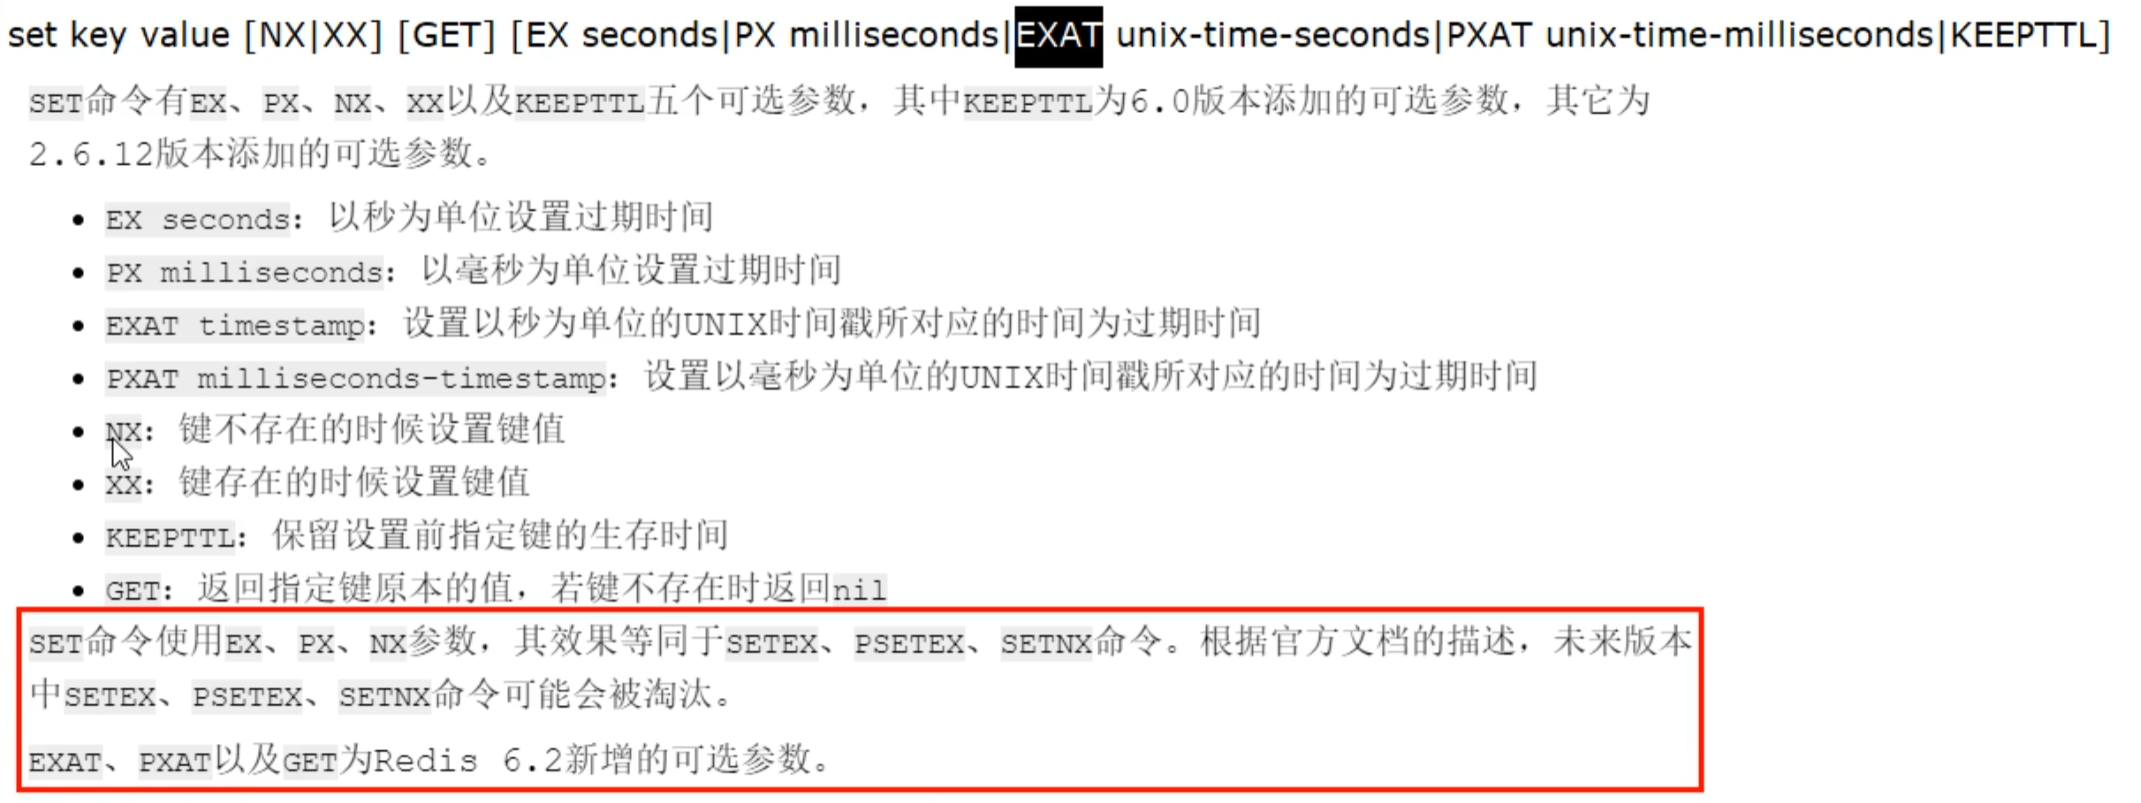
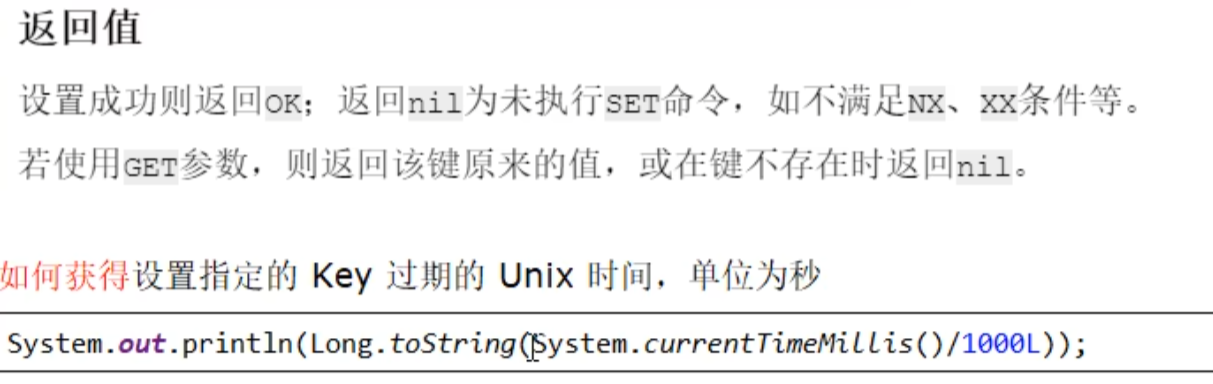
kepptll預設改後的ttl會變成-1, 需要指定不變
mset/mget 批次
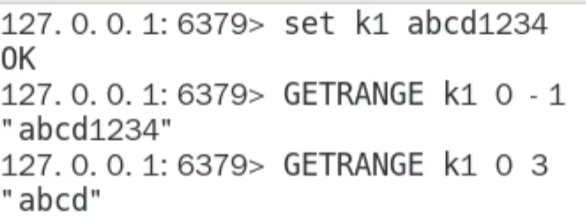
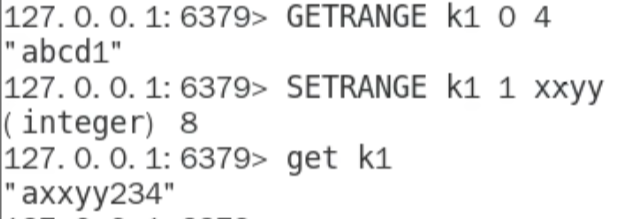
getrange/setrange
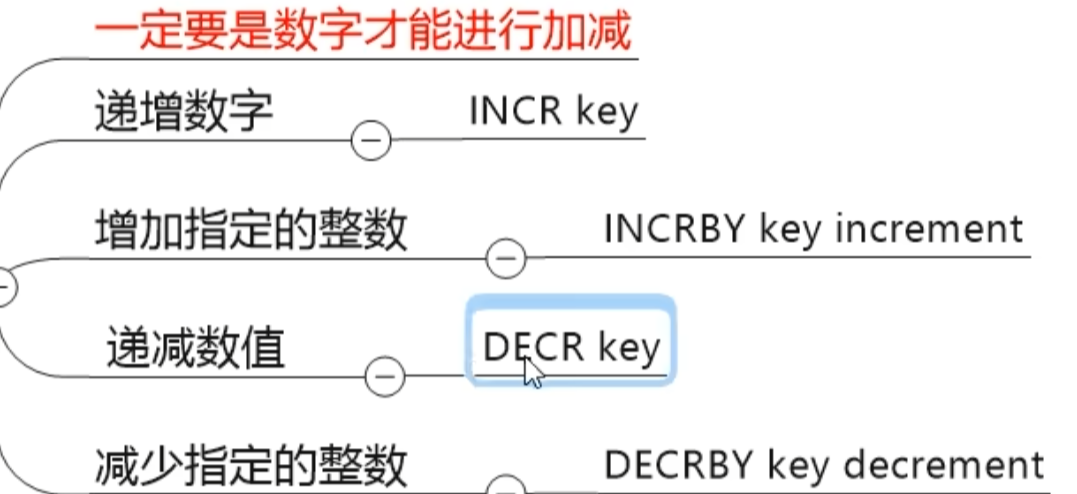
INCR
INCRBY
DECR
DECRBY
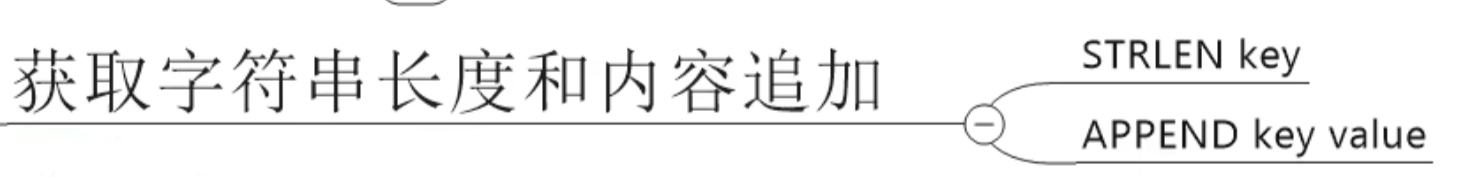
STRLEN k1 xxx (String Length)
APPEND key value
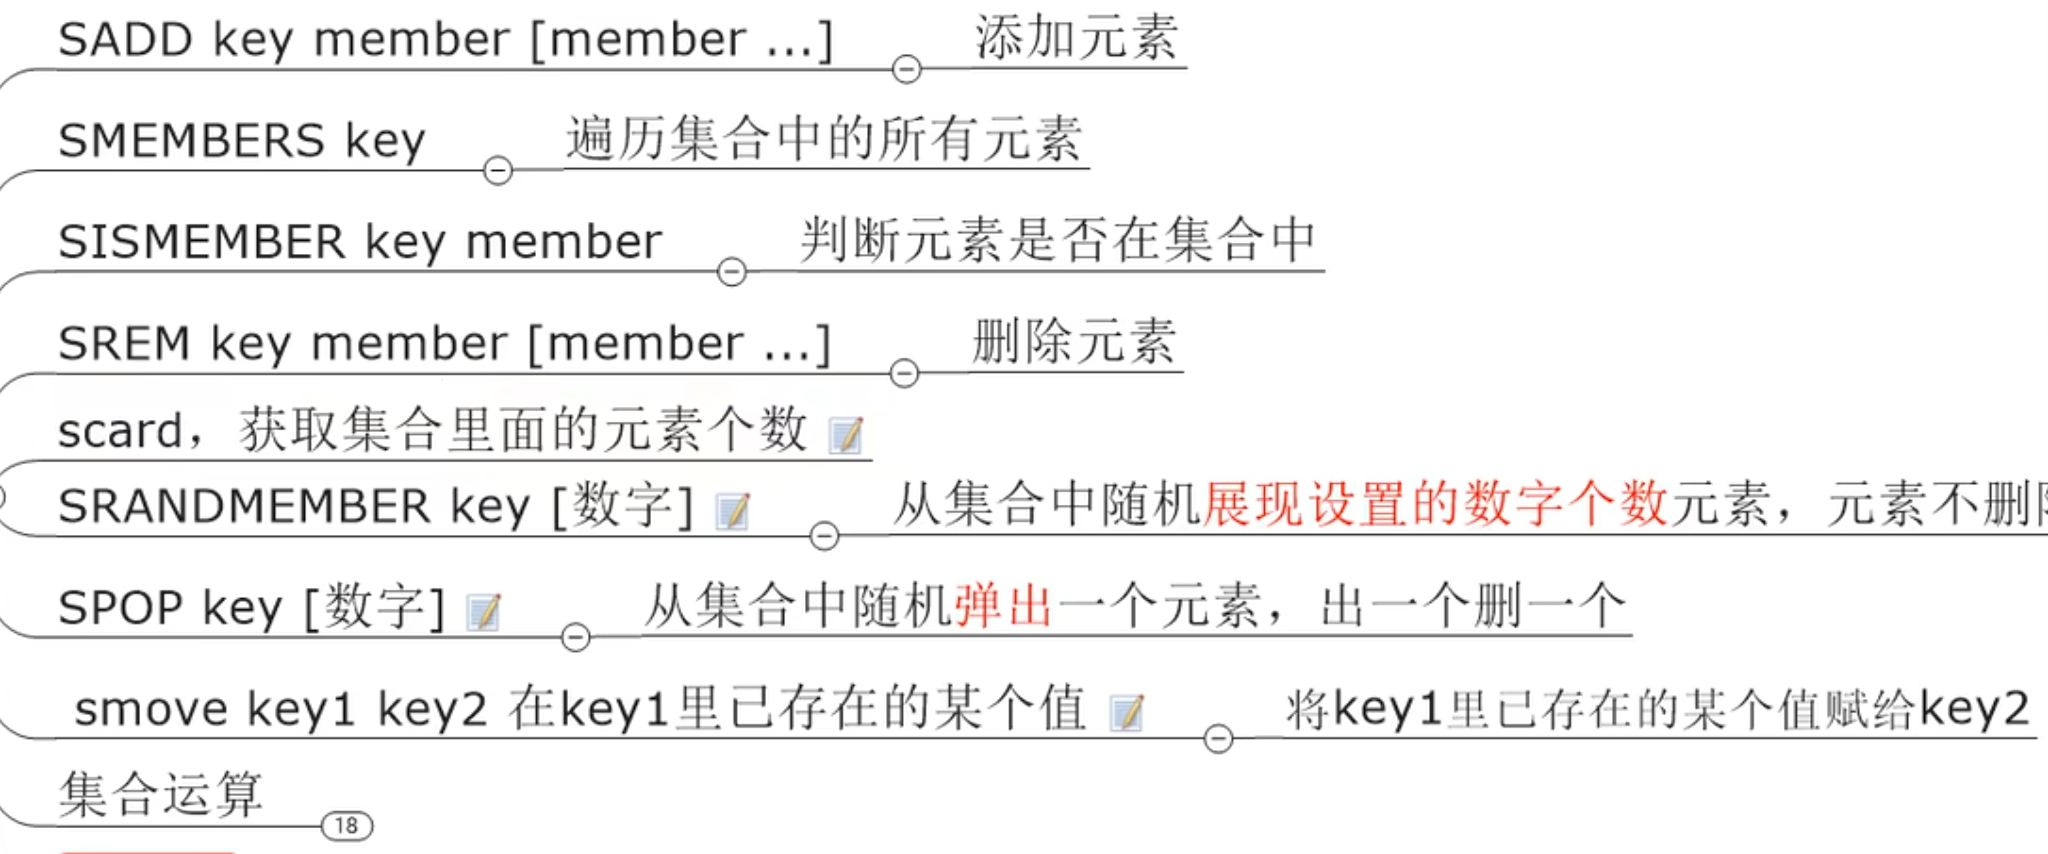
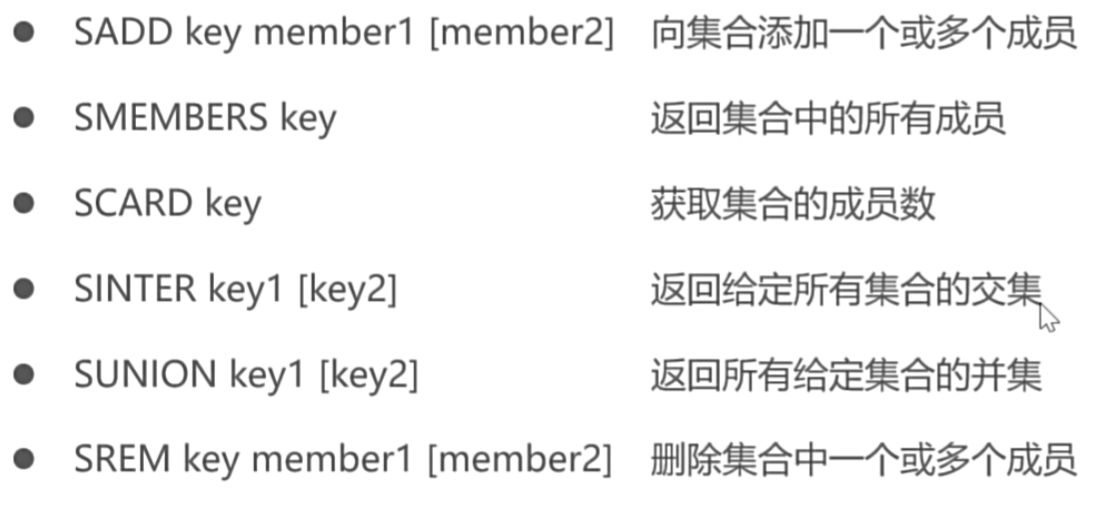
sadd key nember1 number2 number3新增的有重複時會自動去重smembers key走訪scard key個數srem key member1 member2 member3刪除srandmember key [number]從 key 中隨機展示[數字]個的元素,元素不刪除spop key[number]從集合中隨機彈出一個元素,彈一個刪除一個smove key1 key2 value將 key1 中的 value 遷移給 key2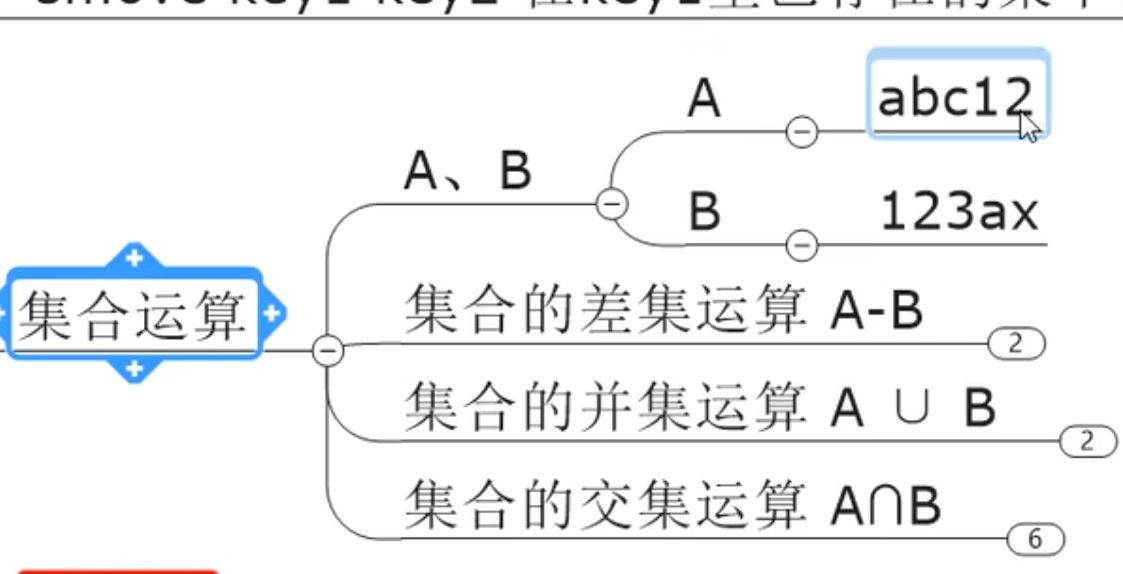
sdiff key1 key2:key 1-key 2的結果sinter key1 key2 key3交集sintercard numkeys key [key...] [LIMIT limit]也是交集,回傳個數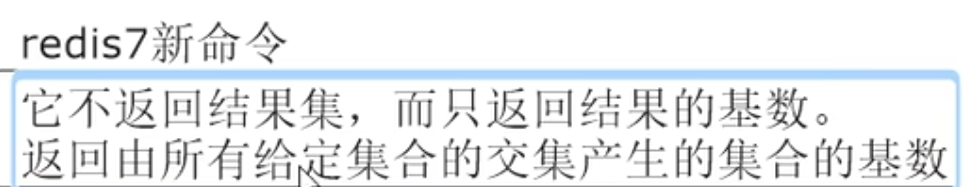
sunion key1 key2 key3聯集
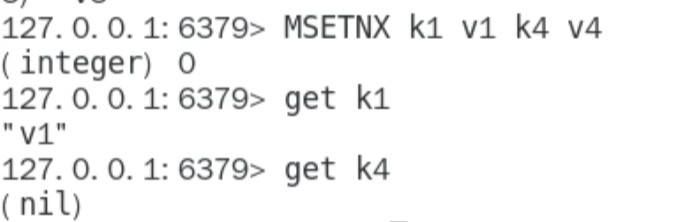 全部成功才有效
有序集合 (ZSET)
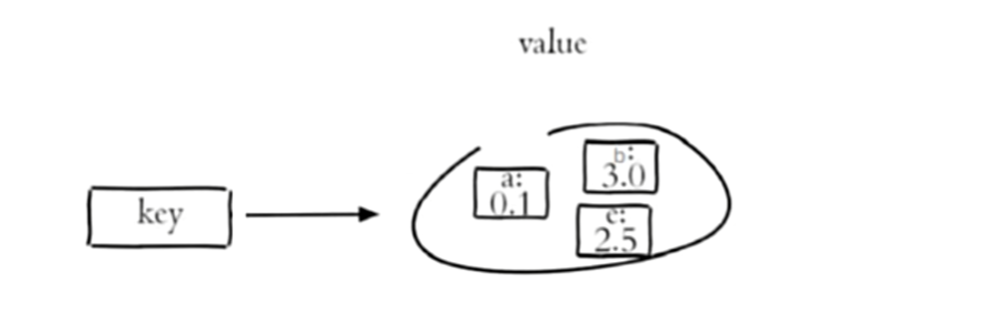
String 類型元素的集合,且不允許有重複成員,每個元素都會關聯一個 double 類型的分數,透過分數進行排序
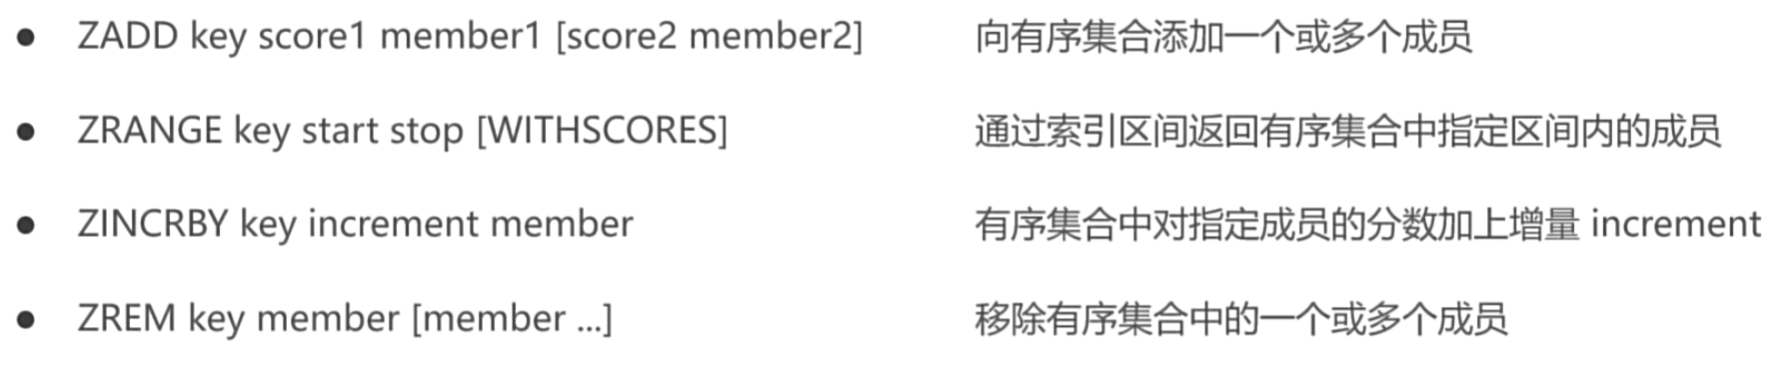
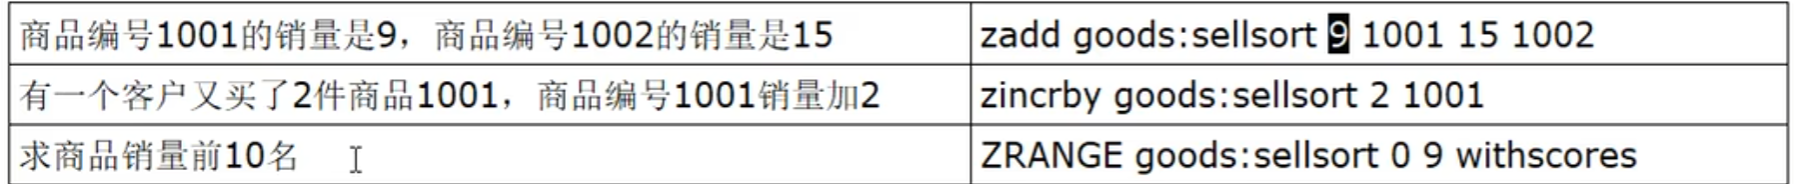
zadd key minutes 1 name 1 minutes 2 name 2 minutes 3 name 3zscore key member取得元素分數zCARD key取得集合中元素的數量zrangen key start stop [withscores]zincrby key increment memberzrem key member [memeber ...]刪除zmpop number key min count 1zrank key values/zrevrank key values取得下標值或逆序下標值
地理空間 (GEO)
亂碼 : 使用中文連接 reids 時候要加 --raw
Redis GEO 主要用於儲存地理位置資訊,並對儲存的資訊進行操作
(longitude,dimension)
新增 地理位置的座標。
取得 地理位置的座標。
計算 兩個位置之間的距離。
根據 使用者給定的經緯度座標來取得指定範圍內的address location set
geoadd key longitude dimension nameGEOADD city 116.403963 39.915119 "天安门" 116.403414 39.924091 "故宫" 116.024067 40.362639 "长城"geopos回傳經緯度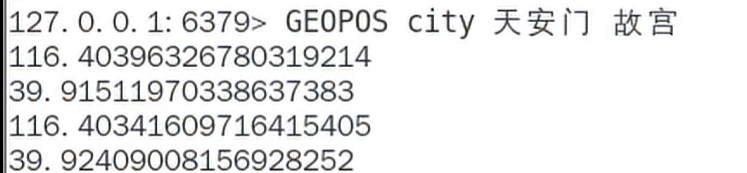
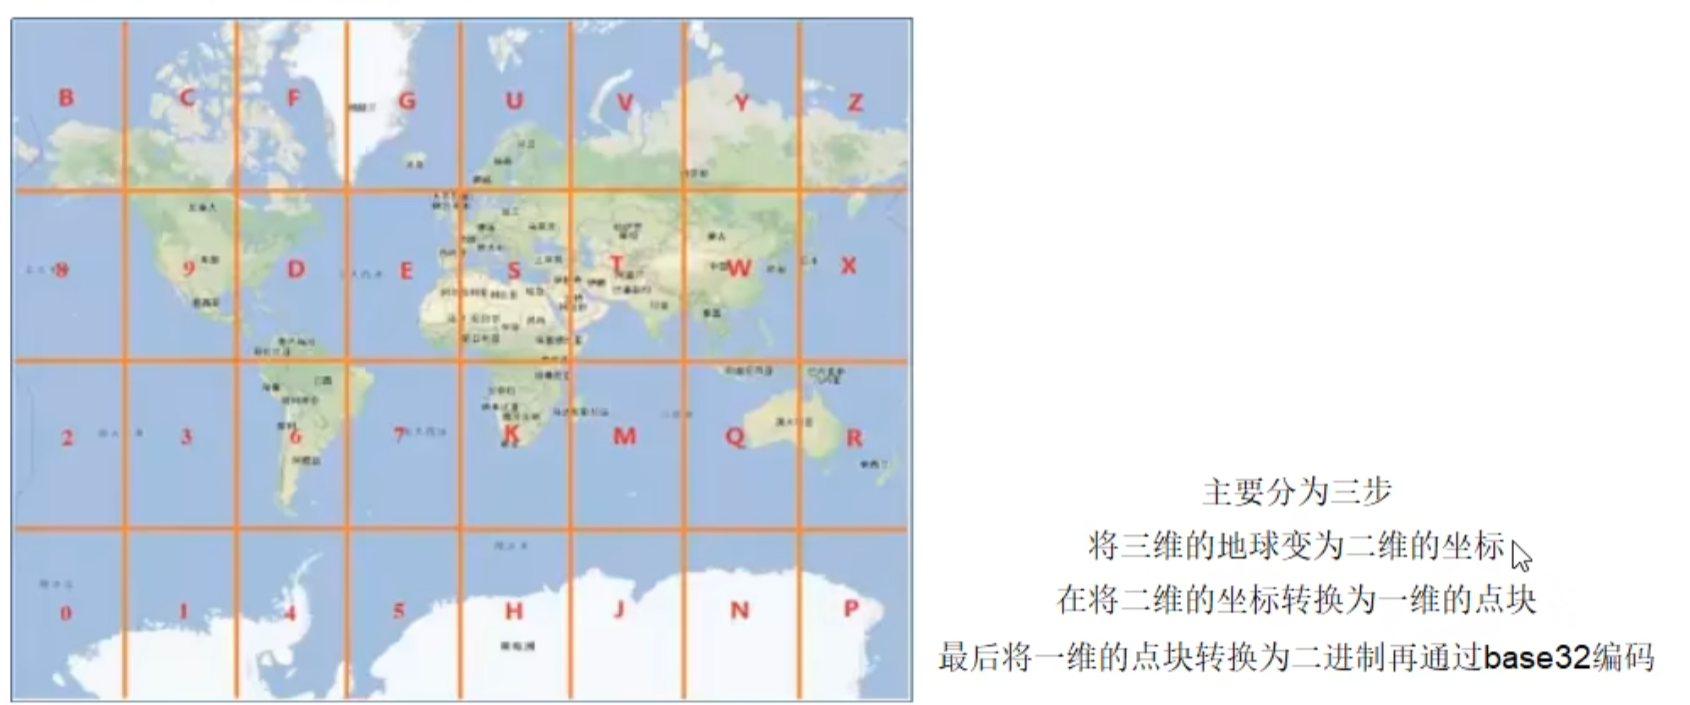
geohash回傳座標的geohash表示 產生base32的編碼值,代表了座標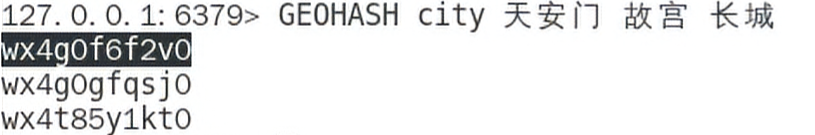
geodist key name1 name2 [m|km|ft|mi]自動計算兩個地方相距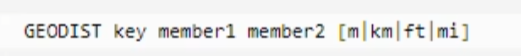
georadius以給定的經緯度為中心,回傳鍵包含的位置元素中,與中心的距離不超過給定最大距離的所有位置元素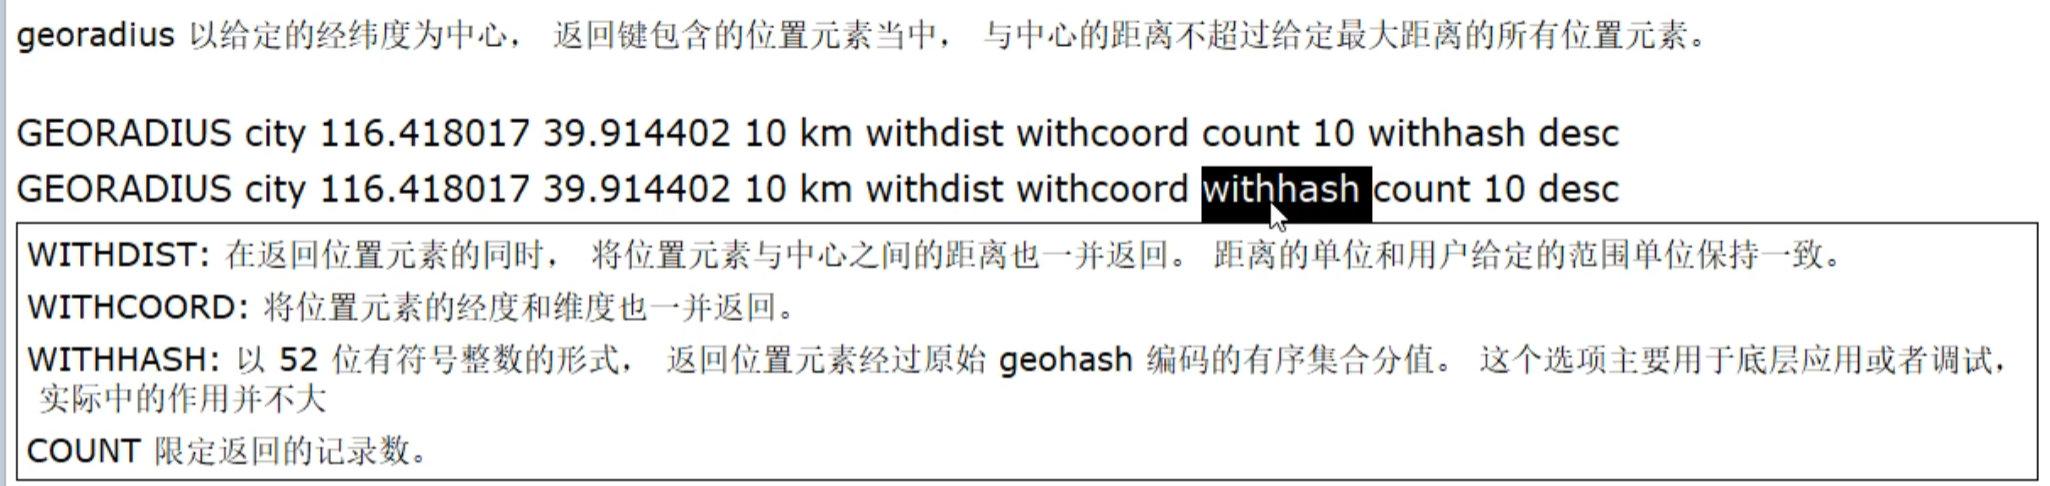
georadiusbymember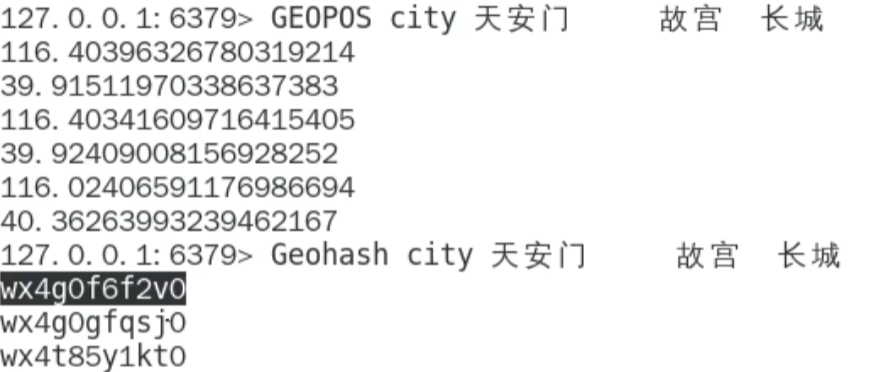
redis 基數統計(HyperLogLog)
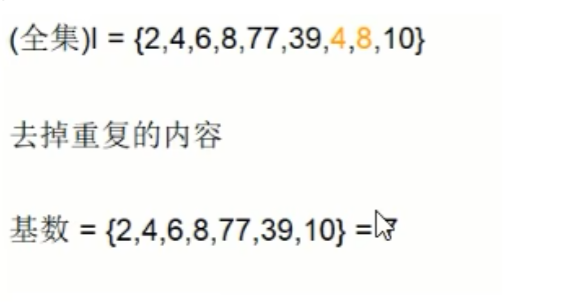
儲存資料個數,不儲存實際內容
HyperLogLog 是用來做 基數統計 的演算法,具有 去重複統計 功能,是 String 型別
優點 : 輸入元素的數量或者體積非常非常大時,計算基數所需要的空間總是固定且是很小的。
HyperLogLog是一種機率演算法,儲存的是資料的個數
在Redis裡面,每個HyperLogLog鍵只需要花費12KB記憶體,就可以計算接近2^64個不同元素的基數。這和計算基數時,元素越多耗費記憶體就越多的集合形成鮮明對比。
但是,因為HyperLogLog只會根據輸入元素來計算基數,而不會儲存輸入元素本身,所以HyperLogLog不能像集合那樣,返回輸入的各個元素。
統計大致多少人訪問過一個頁面,IP 同一個只代表一個,去重複統計獨立訪客

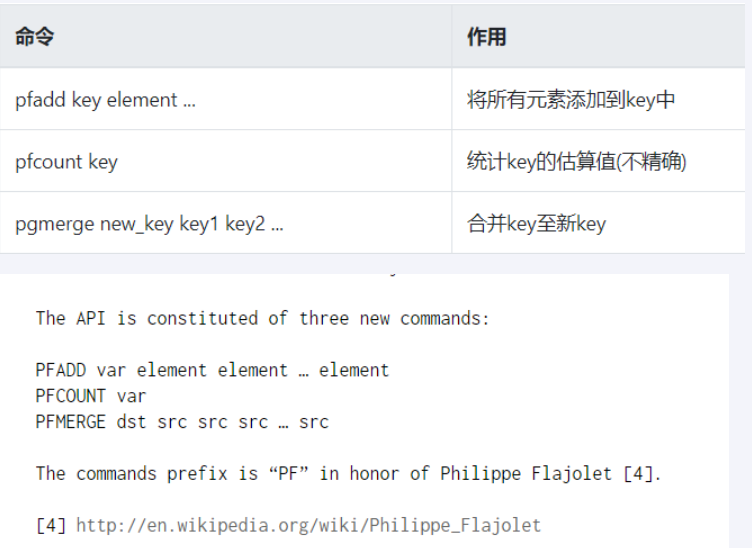
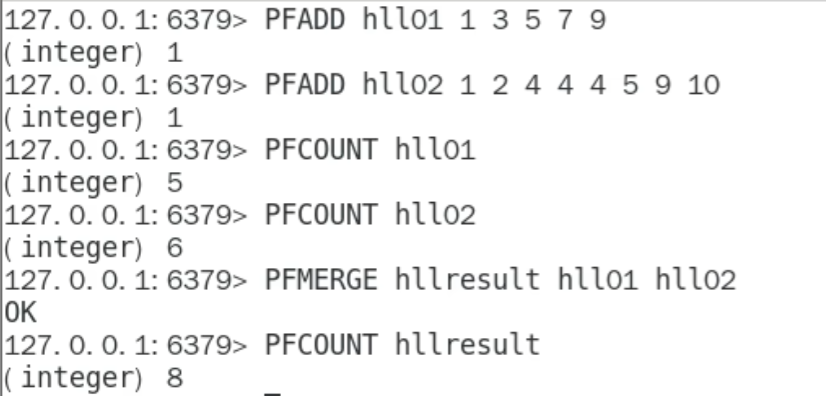
pfadd key value1 value2 value3pfcount keypfmerge key key1 key2合併 key1 ,key 2 ,並不會儲存具體的值,只會告訴你數量
一句話:去重脫水後的真實資料
redis 位圖(bitmap)
由 0 和 1 狀態表現的二進位位的 bit 陣列,相當於 string 的子類,型別還是string
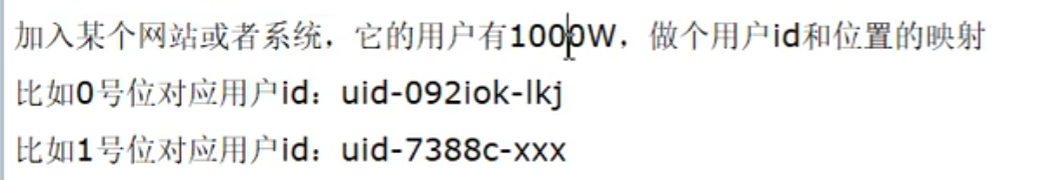
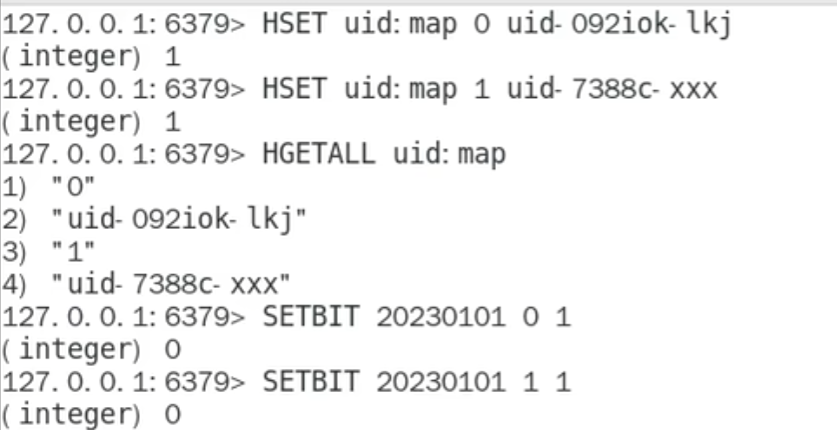
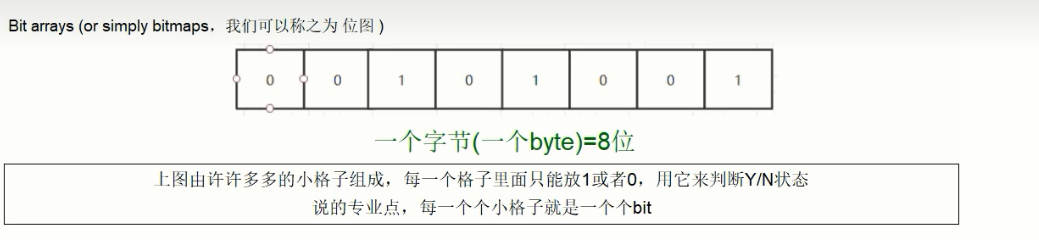 是否登陸過,是否點過,打卡上下班,簽到統計
使用
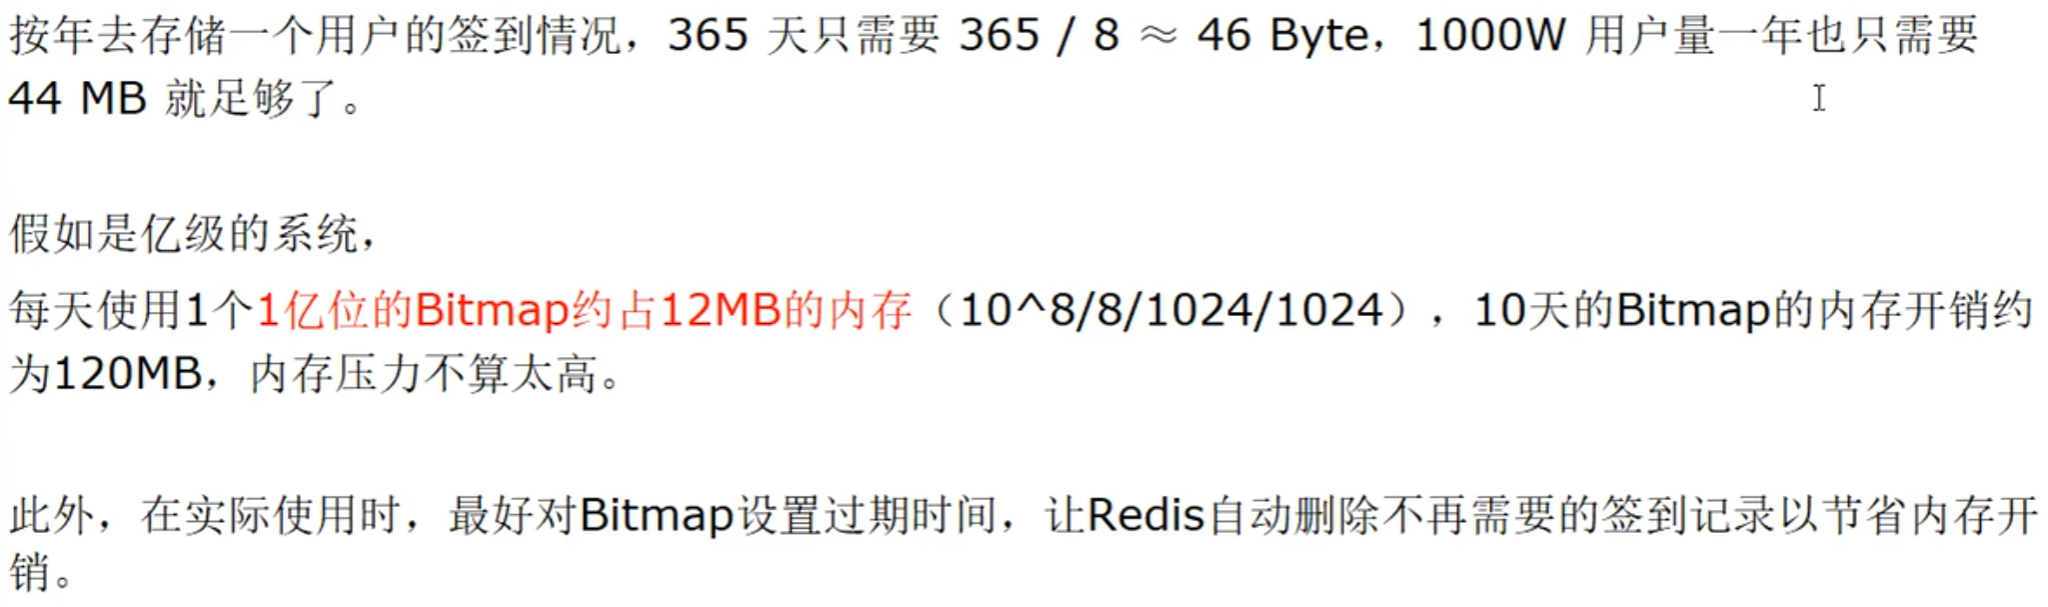
mysql 的資料量過大
setbit key 位置 值值只能 0 或 1getbit key 位置strlen統計位元組佔用多少, 8 位一個 bitmapsetbit k1 1 1setbit k1 7 1佔用一個位元組setbit k1 1 1setbit k1 8 1佔用兩個位元組bitcount key統計
redis 串流(Stream)
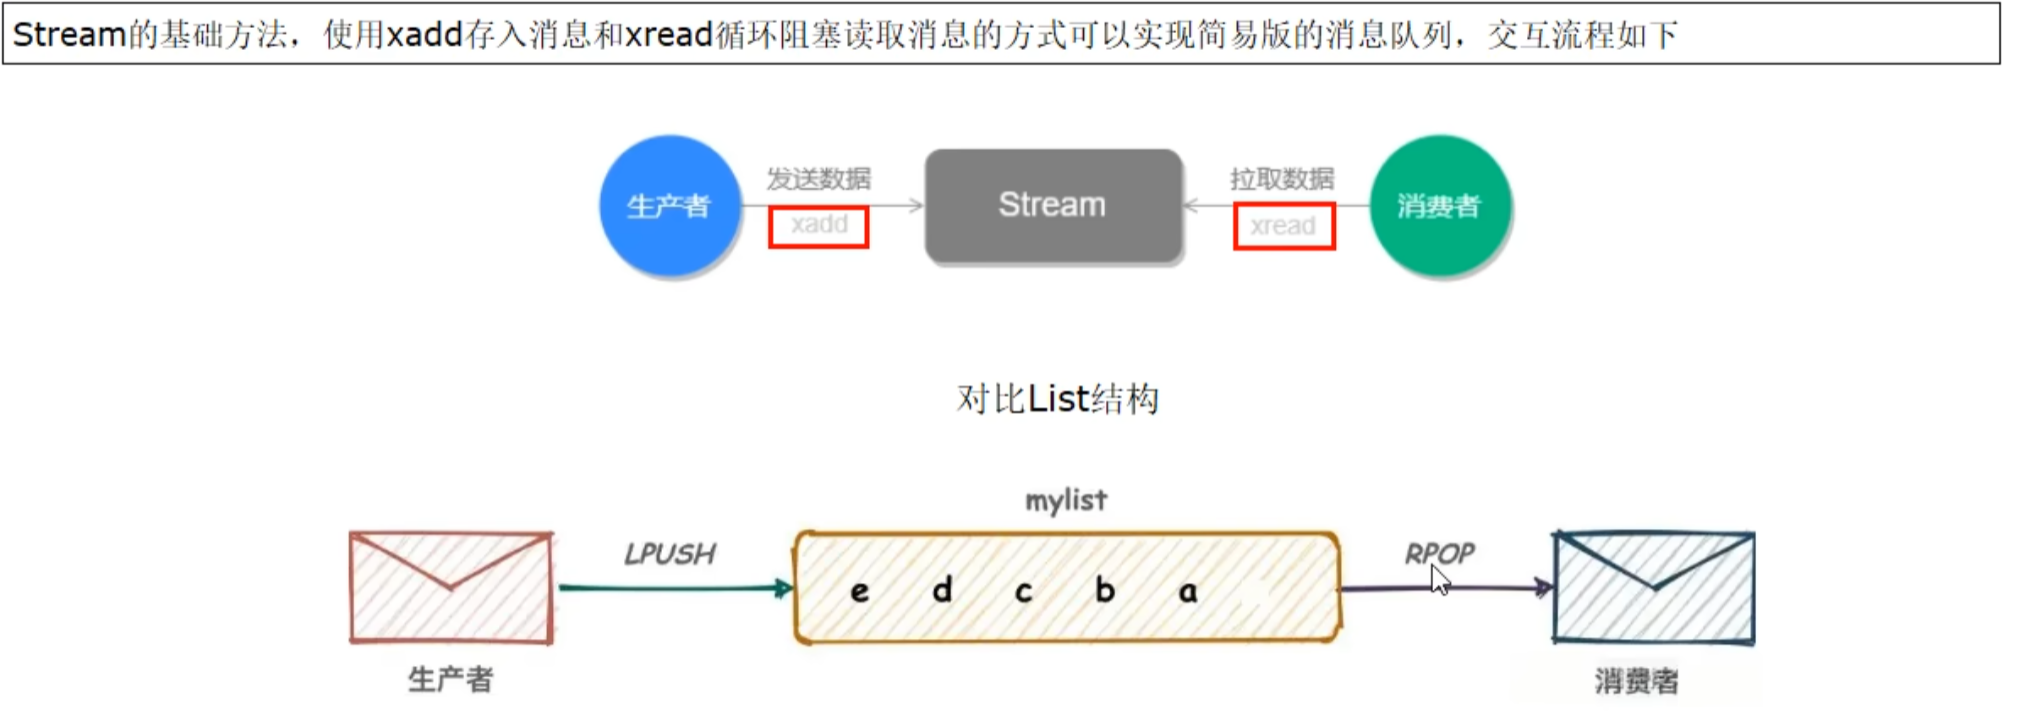
Redis Stream 是 Redis5.0版本新增加的資料結構。
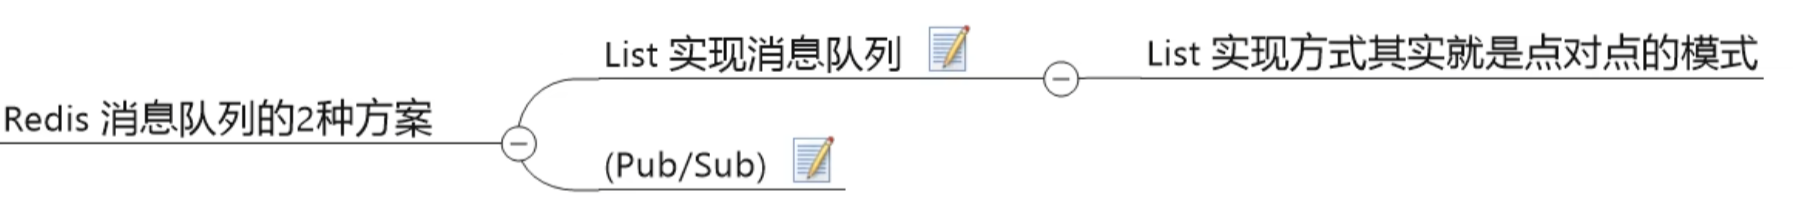
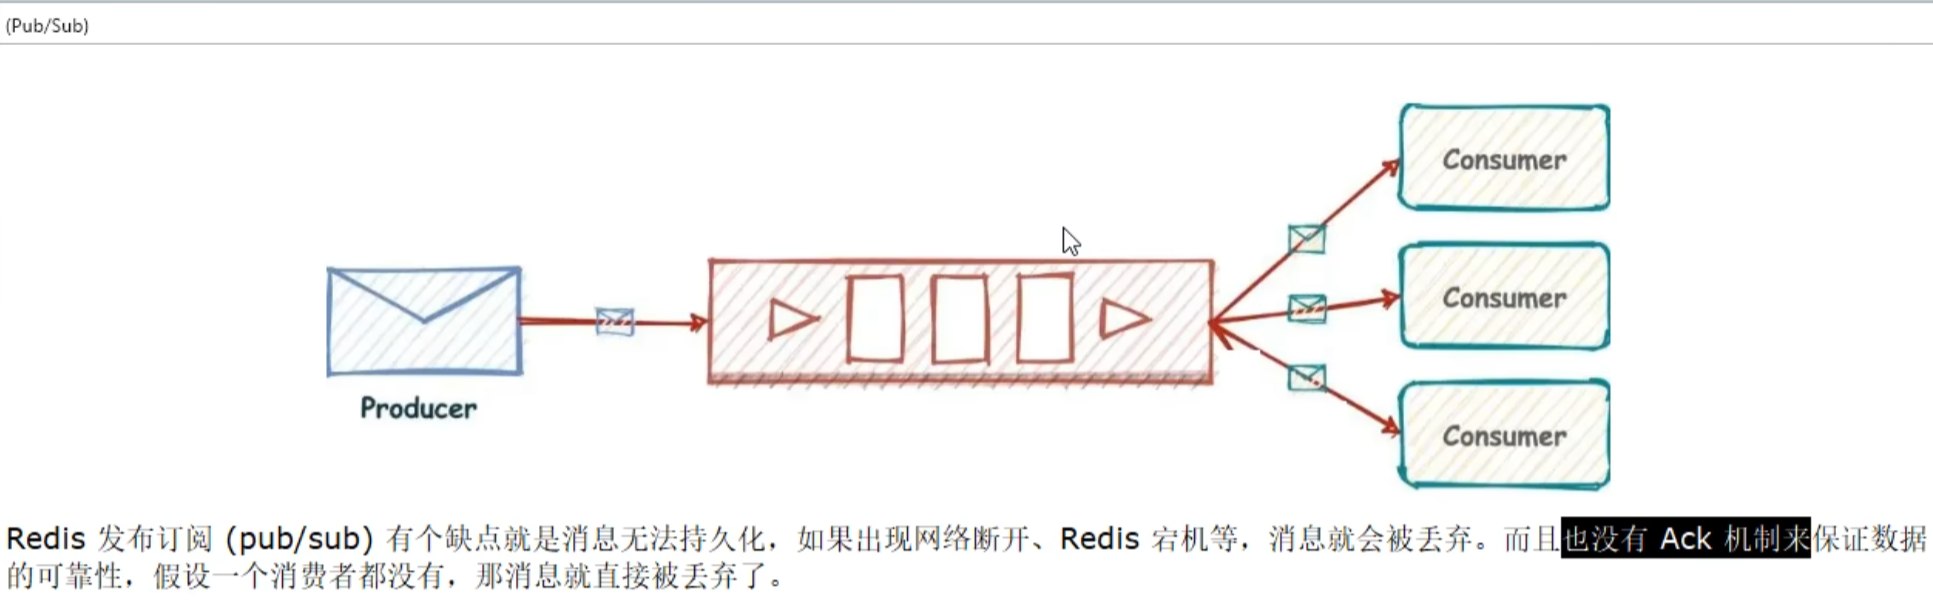
Redis Stream主要用於訊息佇列(MQ,Message Queue),Redis本身就是一個Redis發布訂閱(pub/sub)來實現訊息佇列的功能,但它有個缺點就是訊息無法持久化,如果出現網路斷開、Redis宕機等,訊息就會被丟棄。
簡單來說發布訂閱(pub/sub)可以分發訊息,但無法記錄歷史訊息。
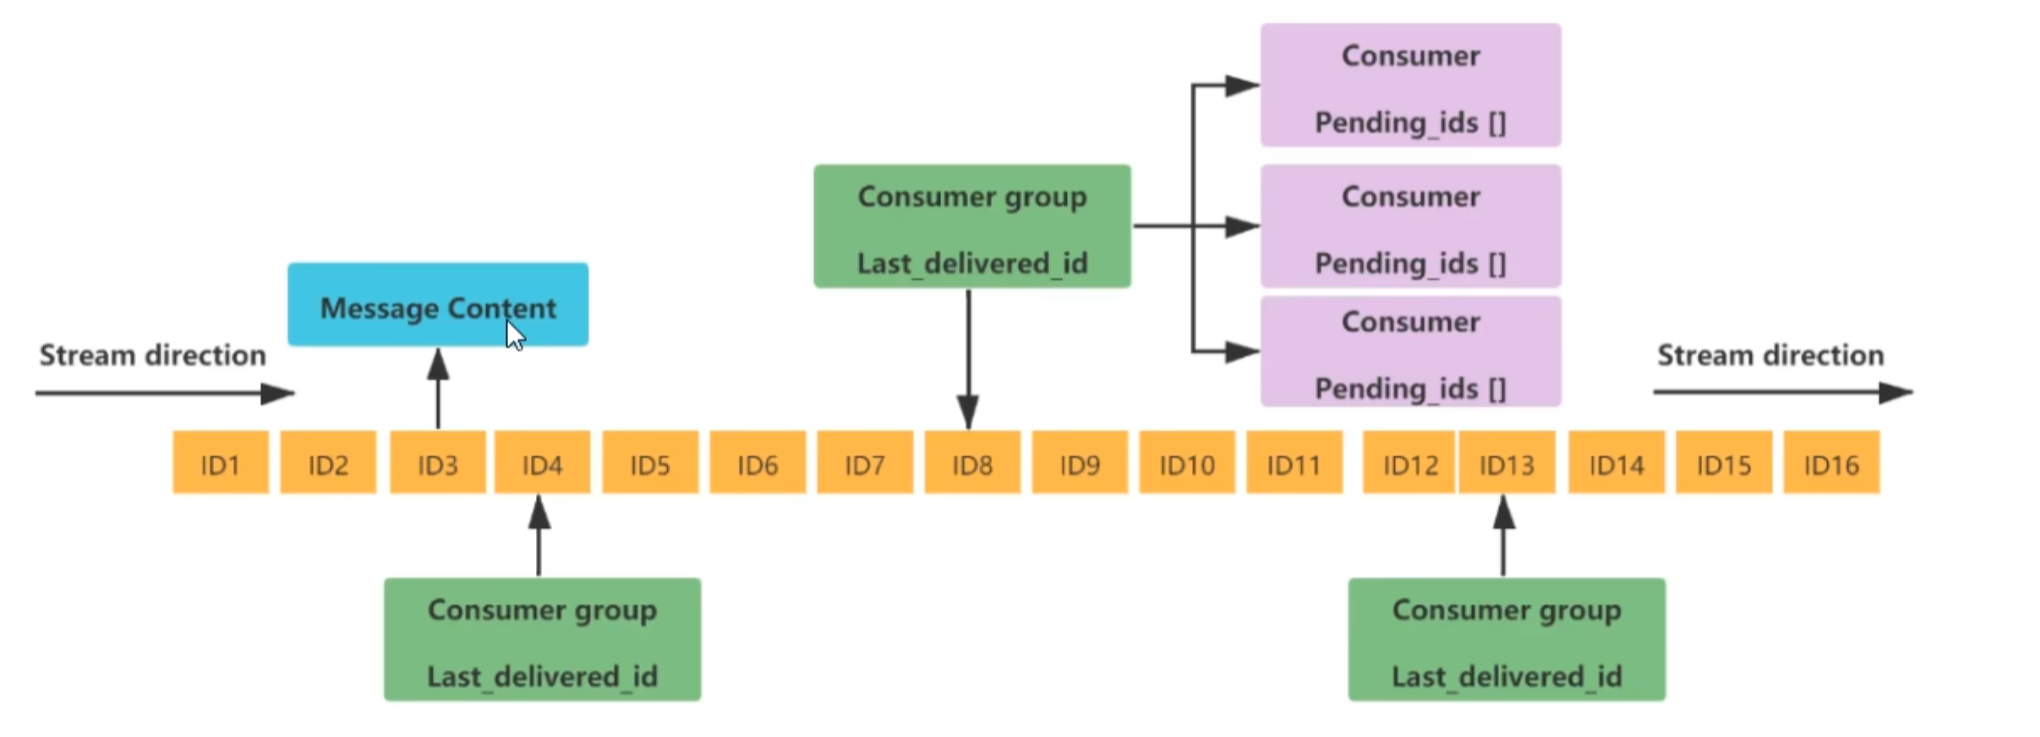
而Redis Stream提供了訊息的持久化和主備複製功能,可以讓任何客戶端訪問任何時刻的資料,並且能記住每一個客戶端的訪問位置,還能保證訊息不丟失。
5.0 之前
佇列相關指令
佇列: 即產生的一列 IDx
佇列相關指令
xadd 佇列名 * key1 value1 key2 value2訊息 id 必須比上一個大,*用於讓系統自動生成 id, 會生成訊息 ID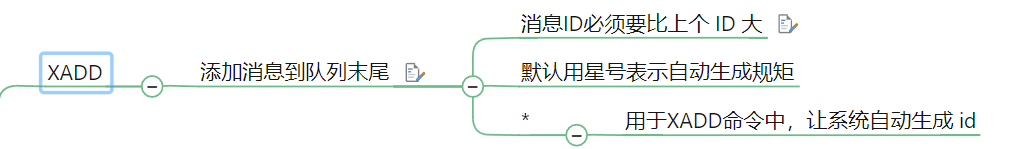

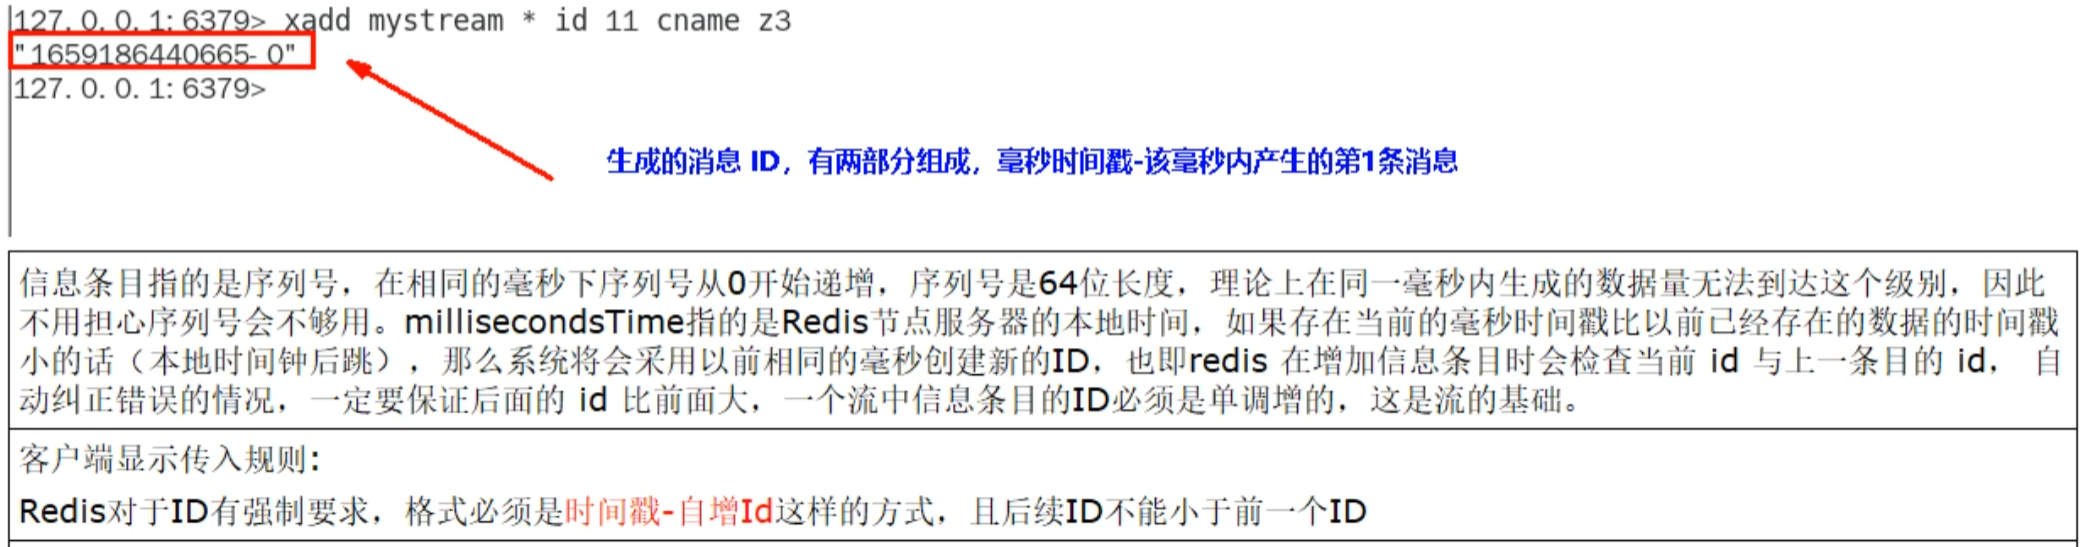
xrange mstream - +
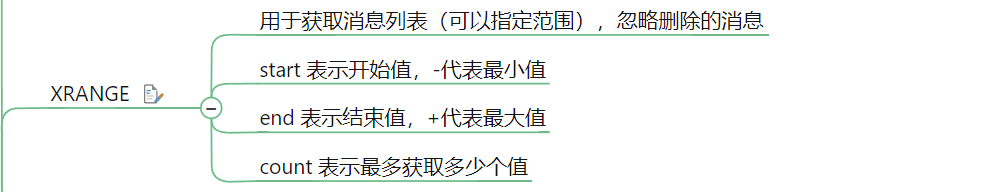

xdel key IDxlen key - +xtrim key maxlen number最大的數量,前面的會被截掉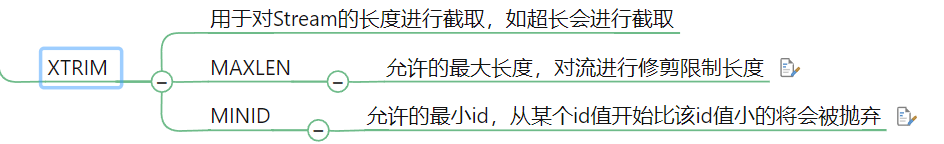
xread mstream - +
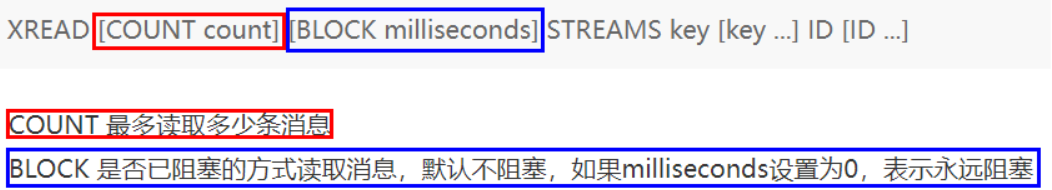
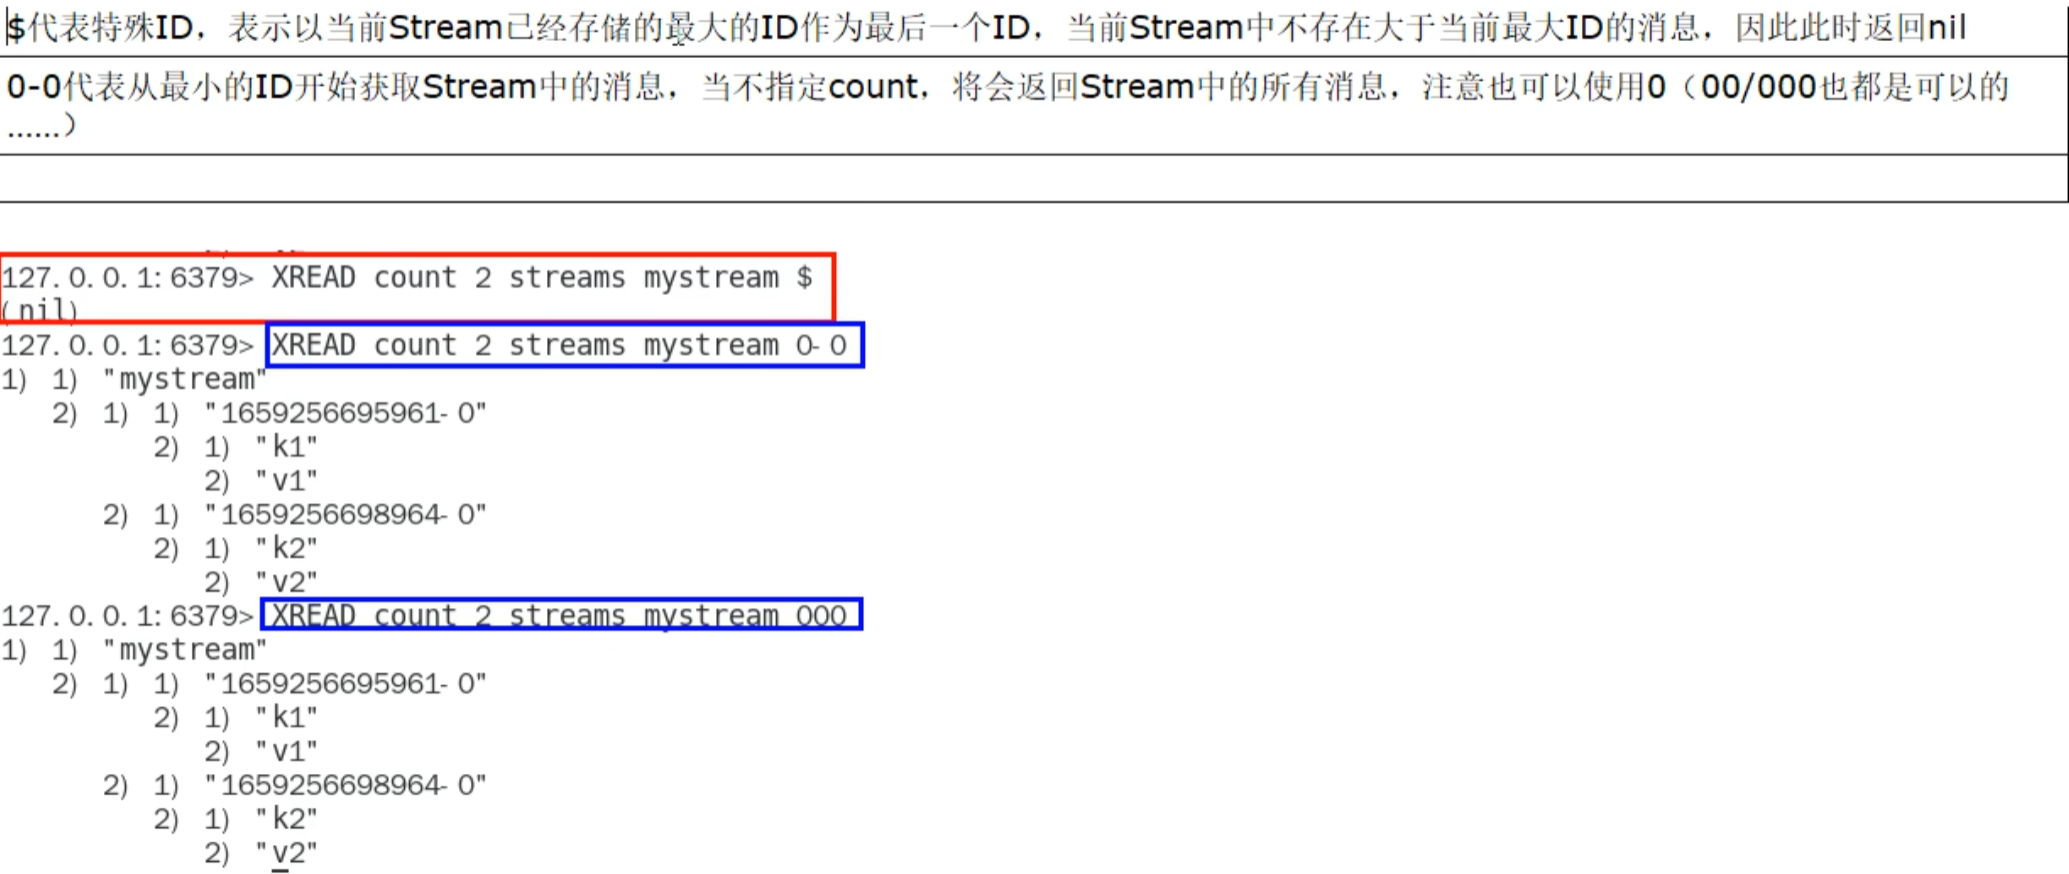
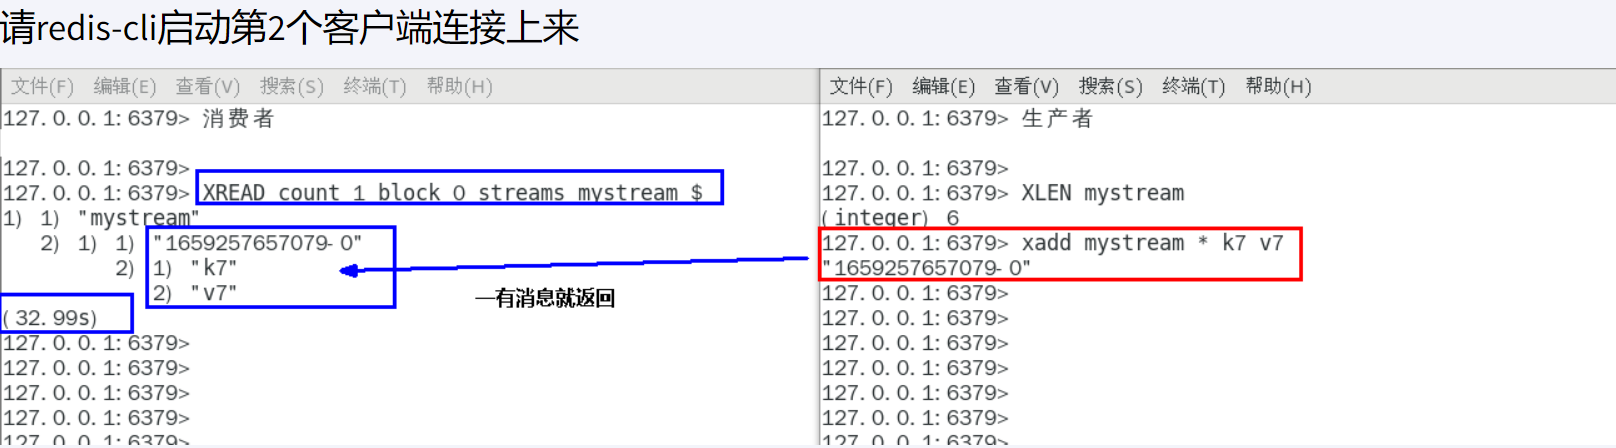 阻塞有最大的而才會返回,會告訴你等了多久
消費相關指令
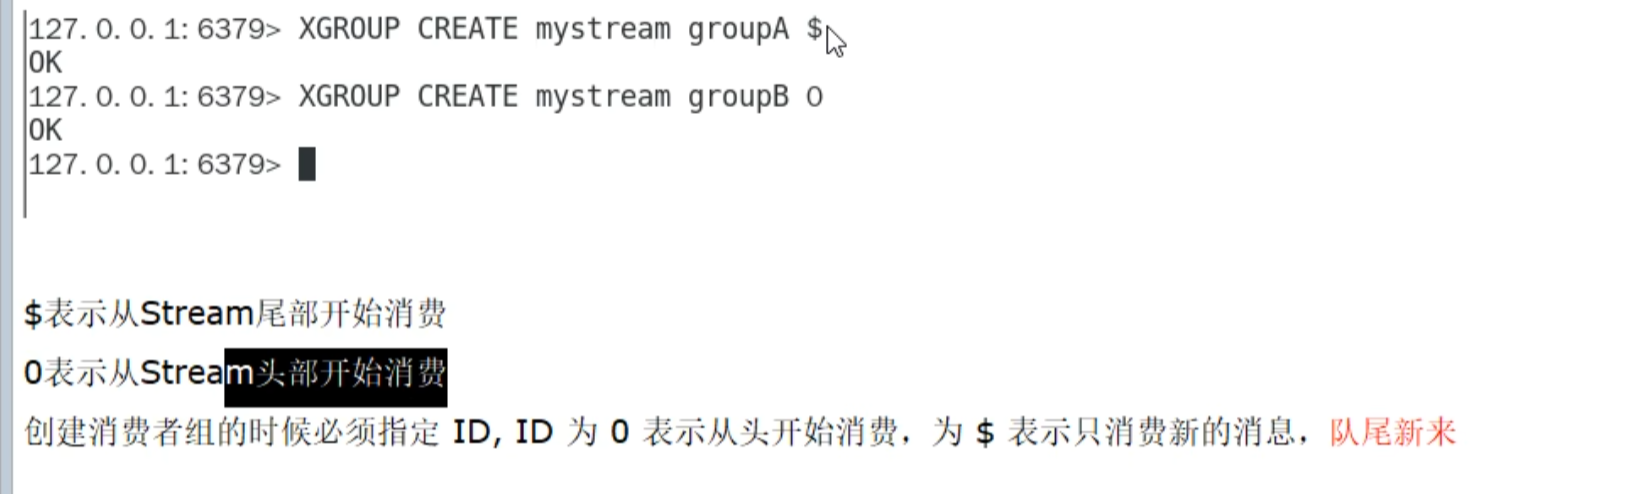
xgroup 佇列名 組名
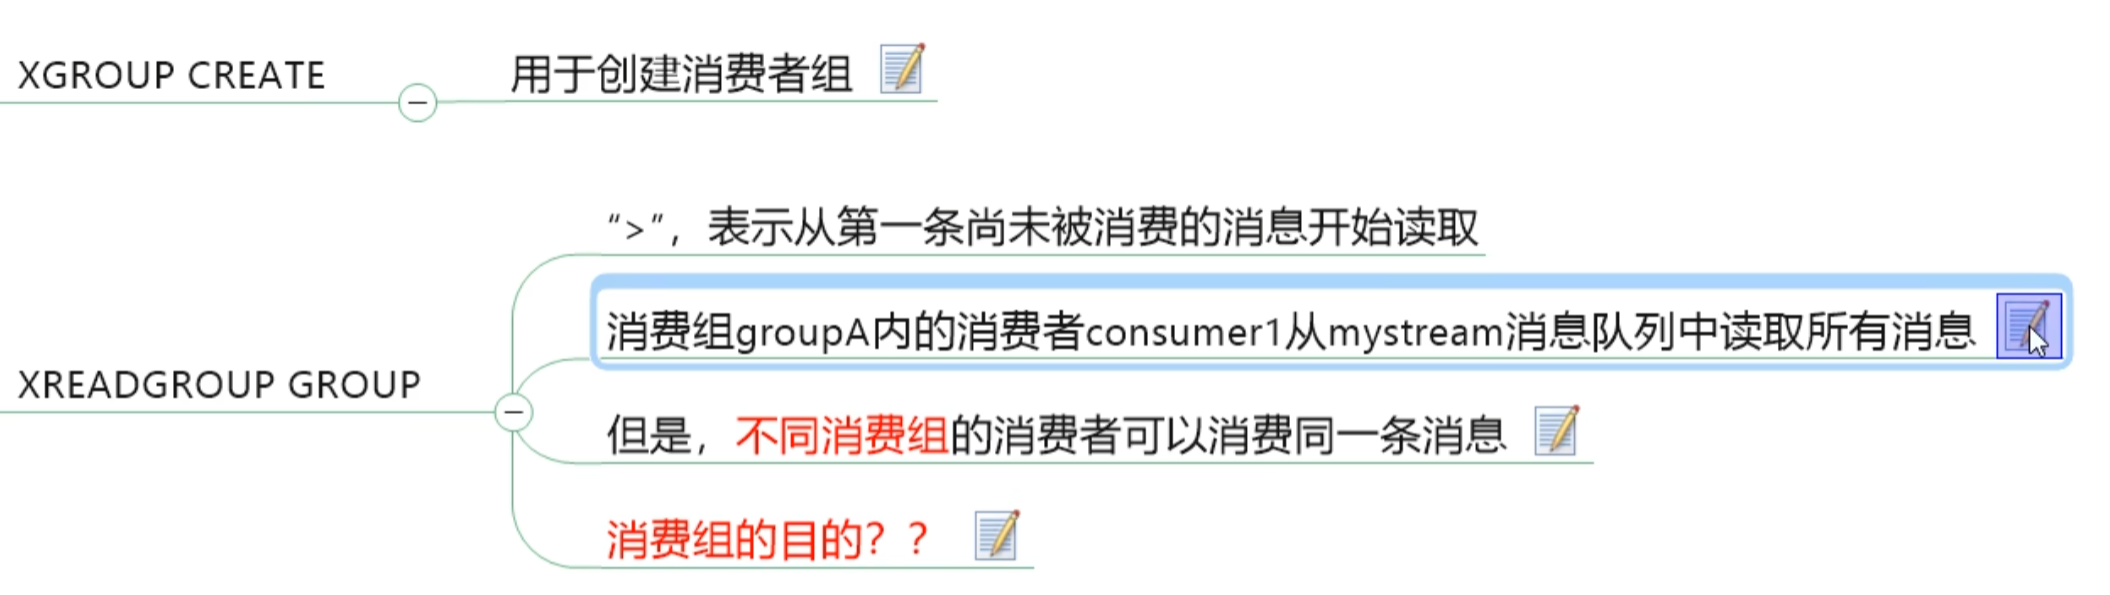
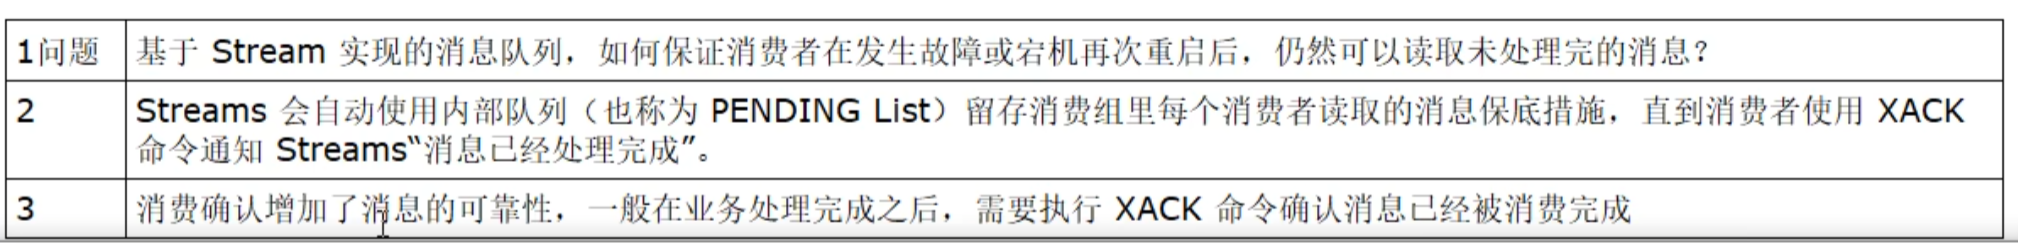
XREADGROUP GROUP 組名 消費名 STREAMS 佇列名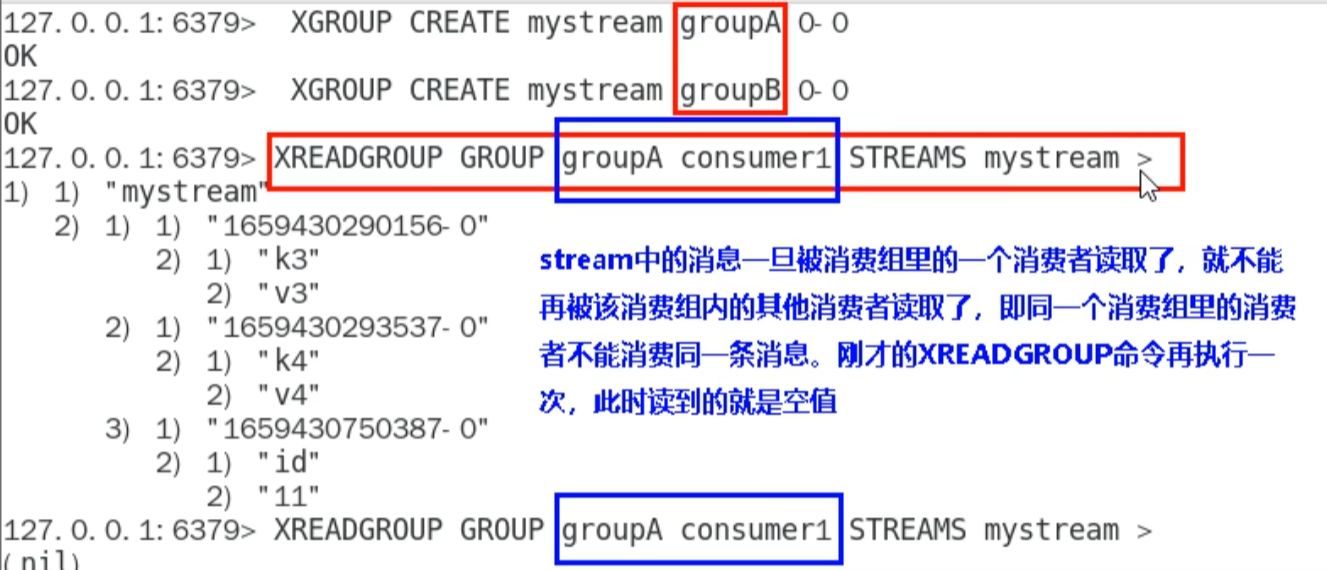 因為游標已經從頭走到尾了,即使同組也不能讀
但是不同組可以讀
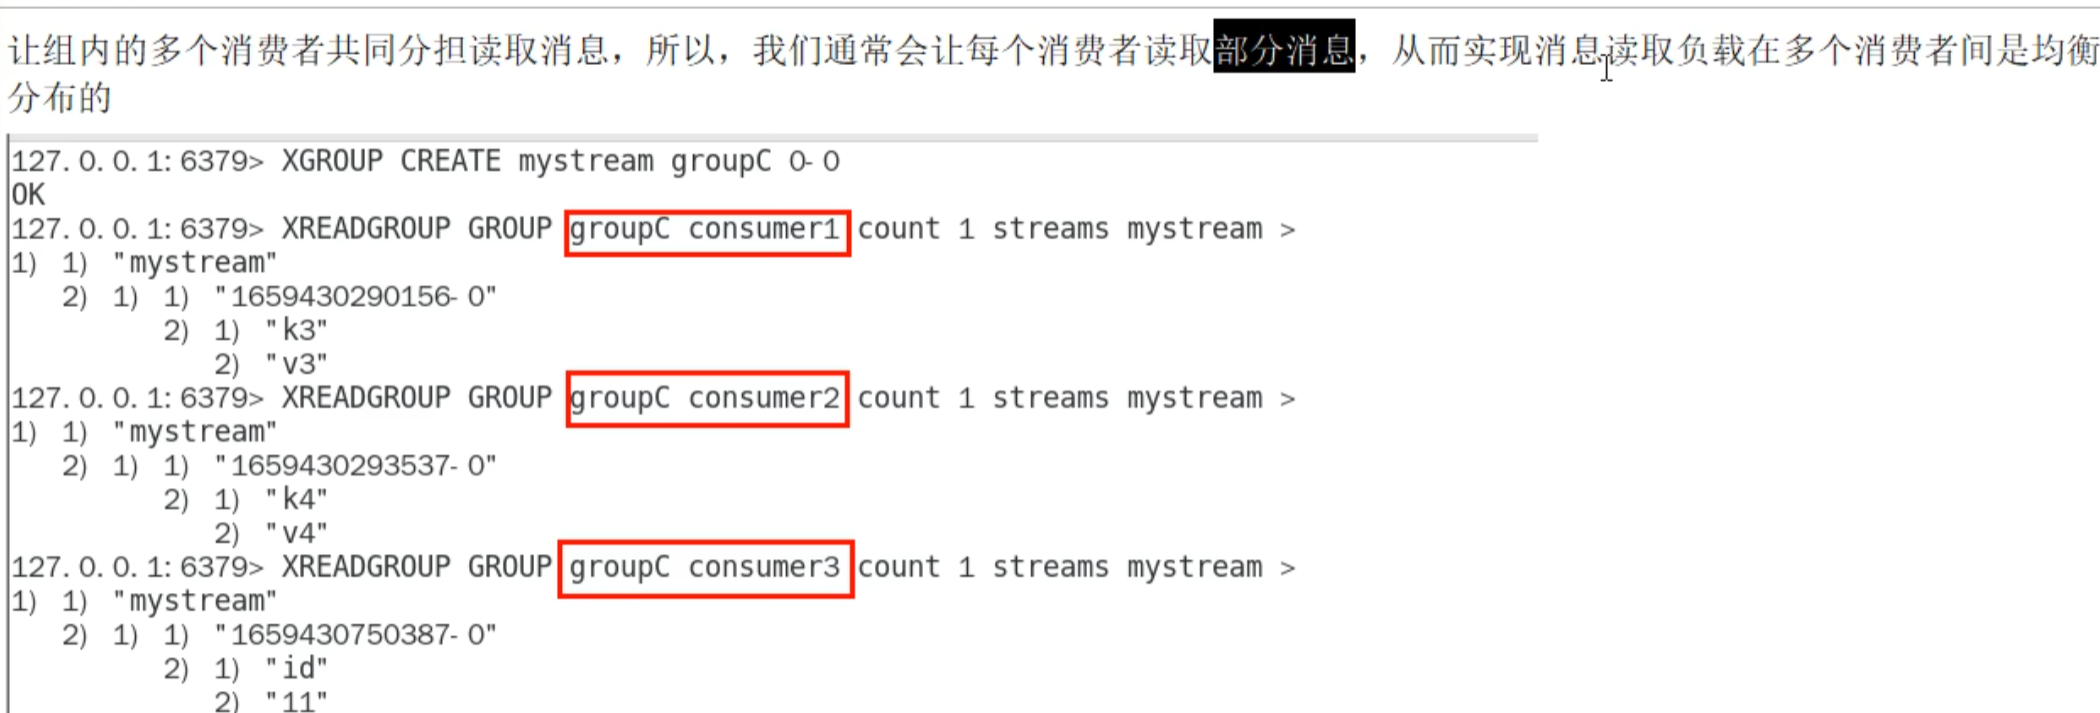
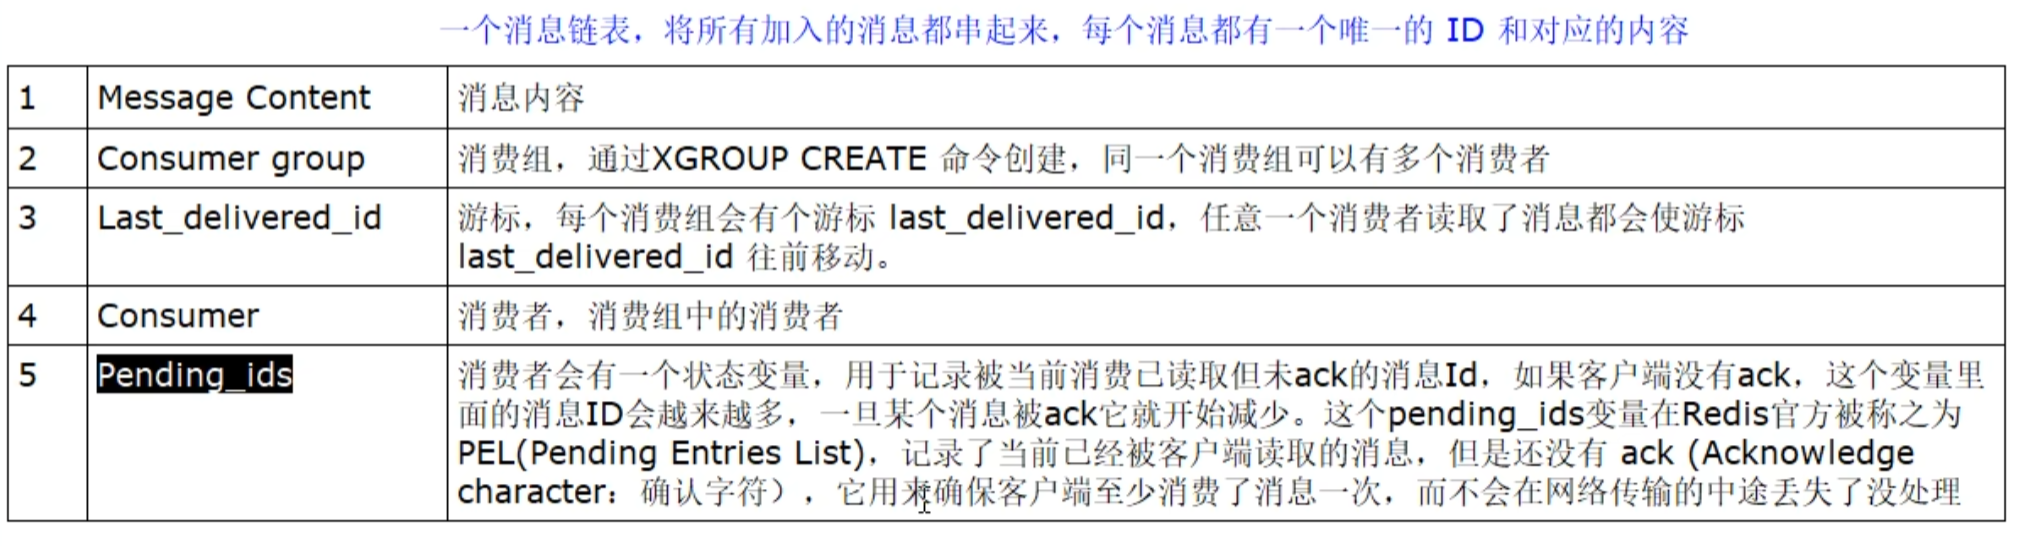
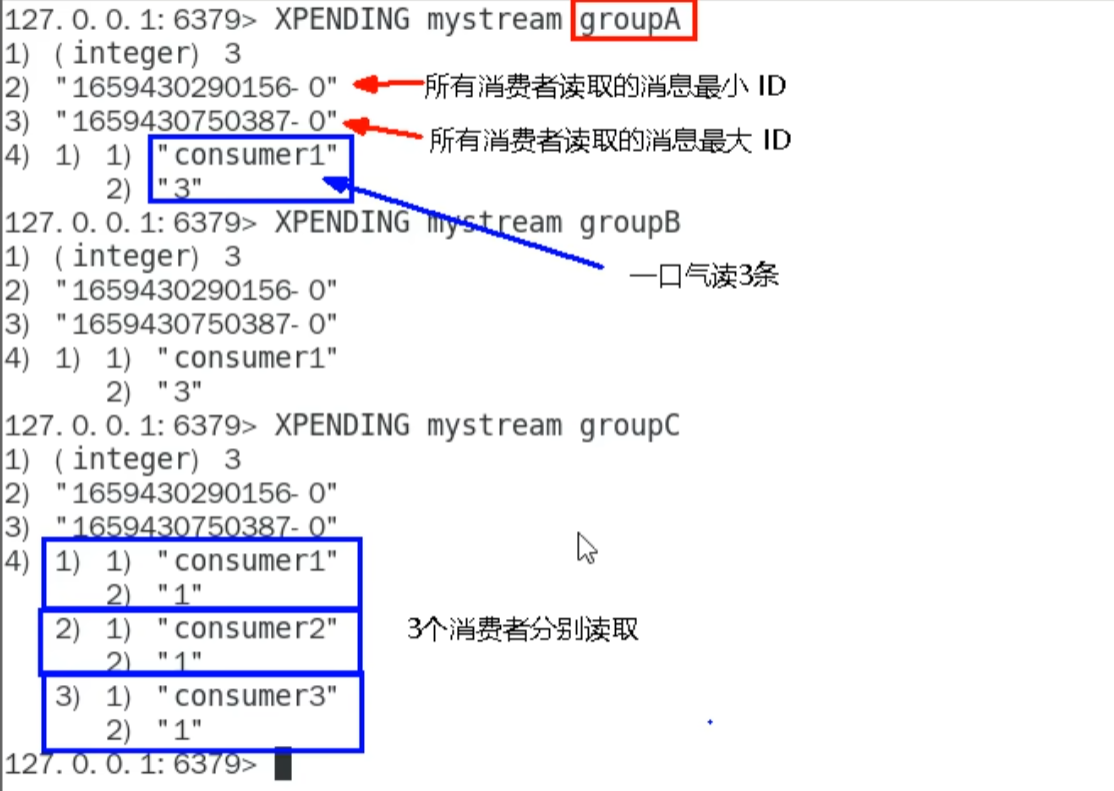
xpending queue name group name查詢每個消費群組內所有消費者
xpending queue name group name - + count consumer查看某個消費者讀取了哪些資料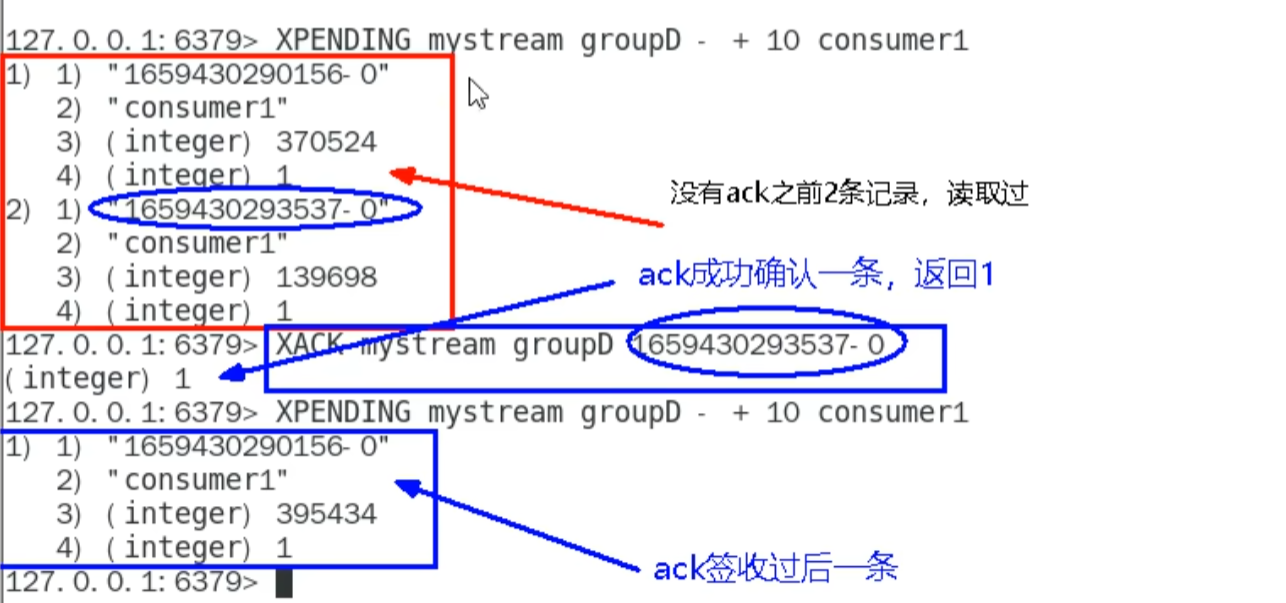 簽收後再查讀取過的資料會只剩沒有簽收的
xinfo stream queue name

redis 位域(bitfield)(了解)
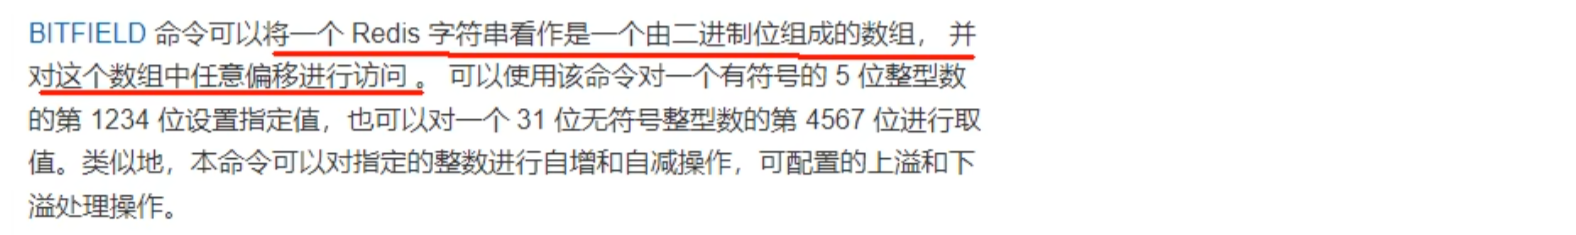
將 redis 字串看作一個由二進位組成的陣列,並能對變長位寬和任意沒有位元組對齊的指定整數位域進行定址和修改
透過 bitfield 指令可以一次性操作多個bit field(指的是連續的多個位元),它會執行一系列操作並回傳一個回應陣列,這個陣列中的元素對應參數列表中的相應執行結果。
說白了就是透過 bitfield 指令我們可以一次性對多個 bit field進行操作。
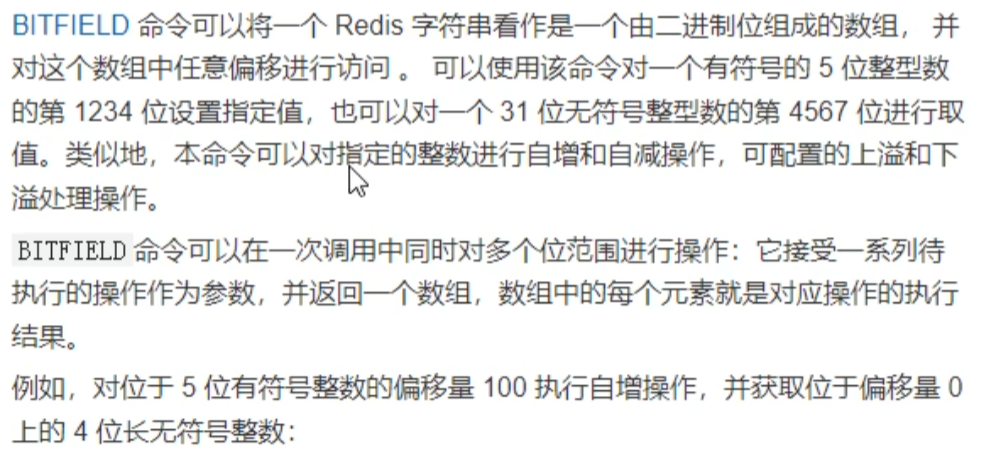
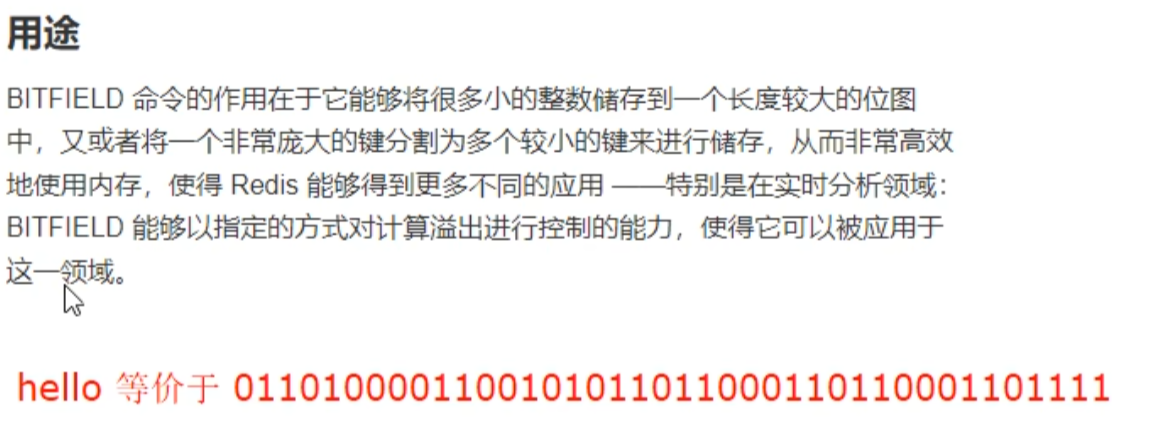

位域修改,溢位控制
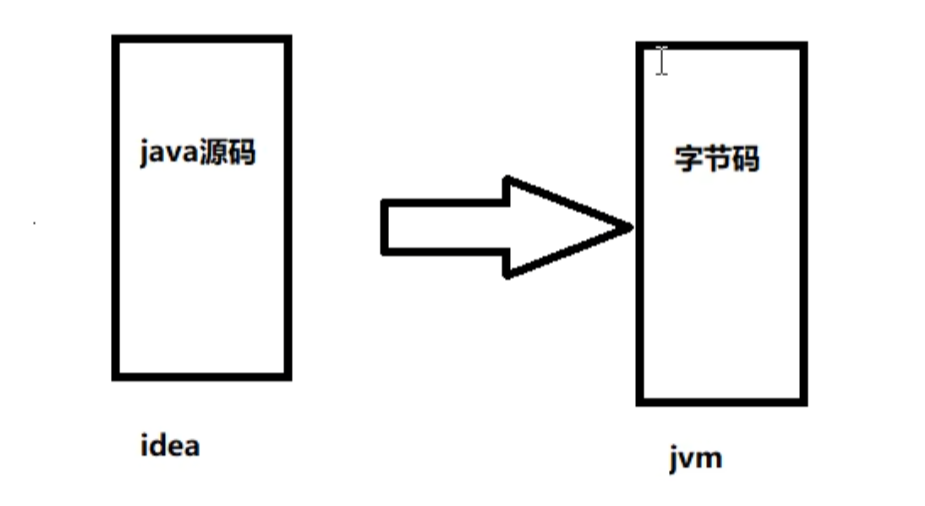
相當於可以改位元組碼
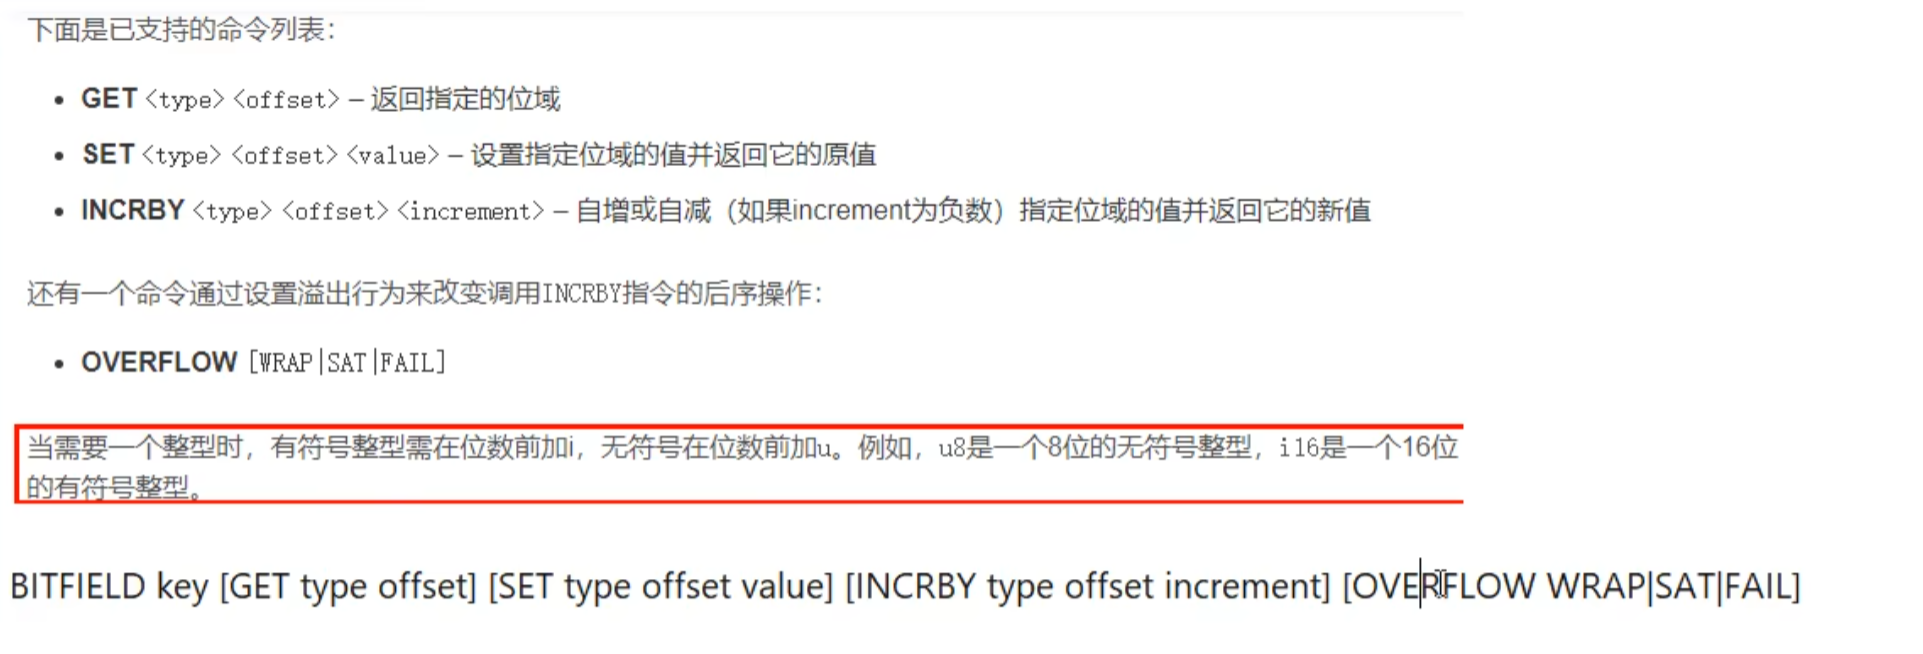
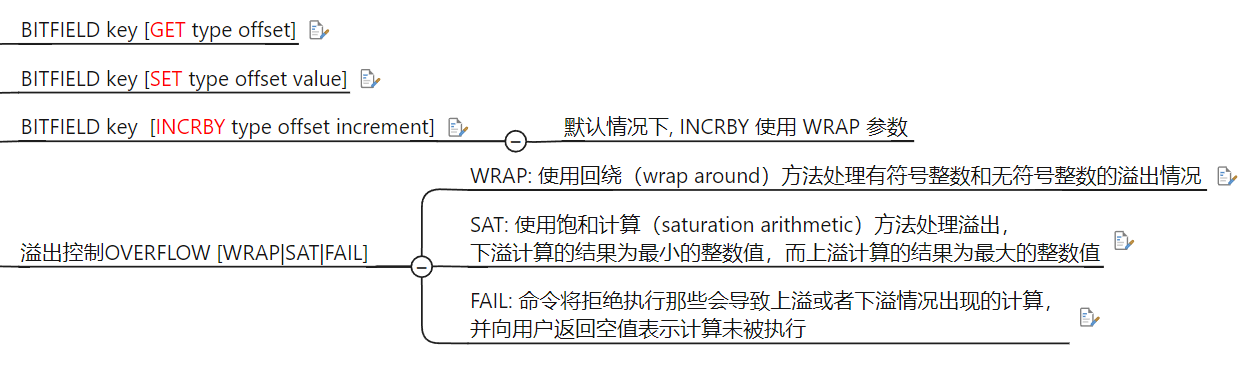
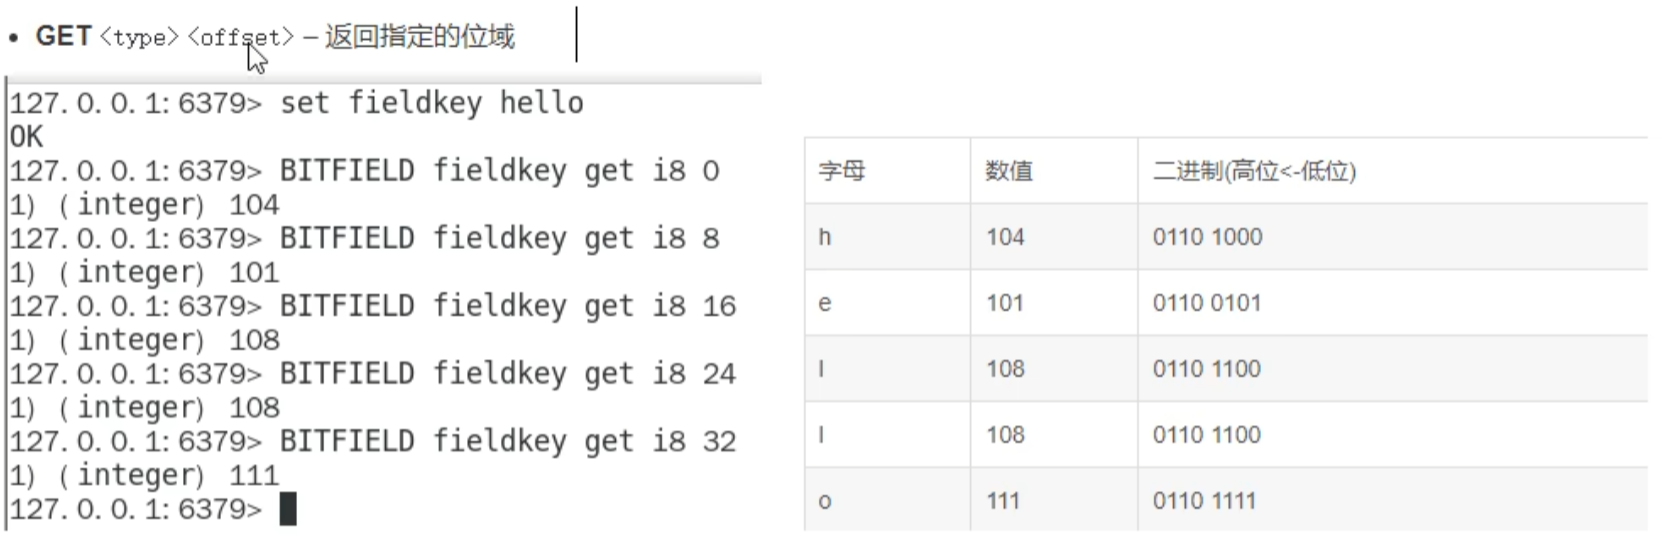
 -128 到 127 超過則溢位
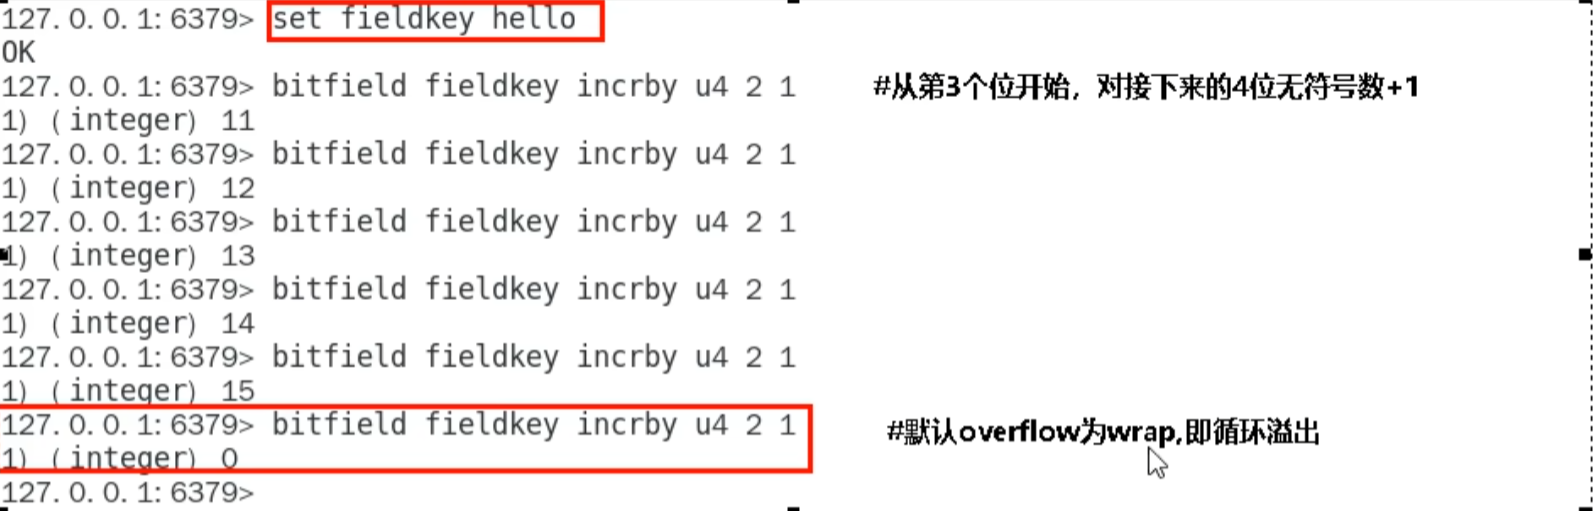
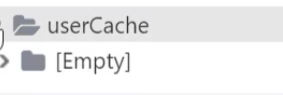 兩個冒號就會有 empty
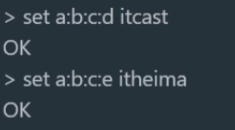
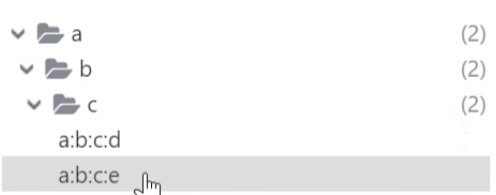
redis 持久化
Persistence refers to the writing of data to durable storage
- 透過 RDB 快照檔案
(dump.rab)還原,將磁碟的快照還原到記憶體 - 透過 AOF 記錄的指令進行還原
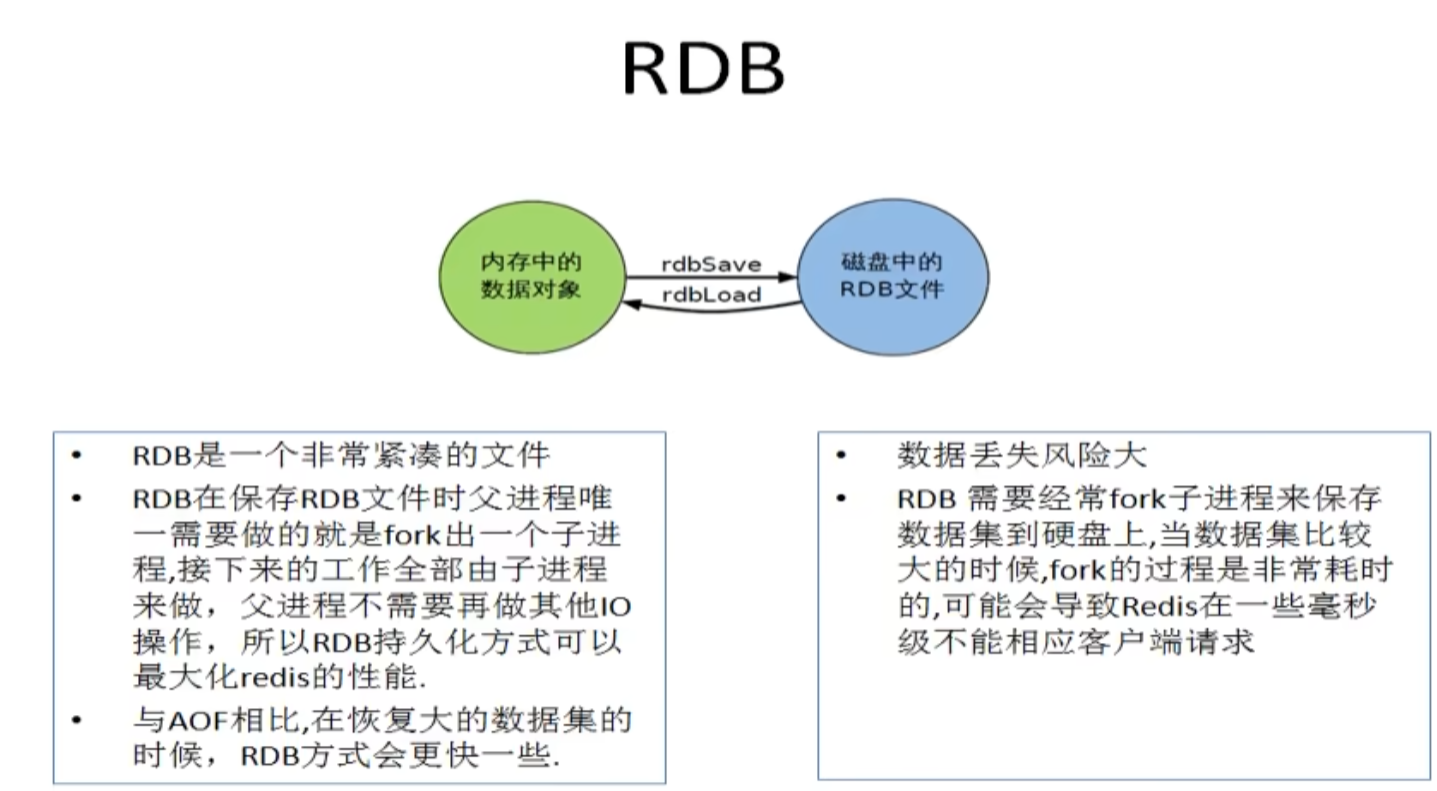
RDB
啟用: save time num 在 time 內觸發 num 次就生效
停用: save "" 或 redis-cli config set save ""(non persistent) 依舊可以手動 save/bgsave 產生 RDB
路徑修改
檔案名稱修改:設定檔搜尋
dump.設定檔搜尋
config get dir取得目錄遇到的問題:需要
dumpfiles資料夾權限更改
SAVE 阻塞,其他指令都會無法處理,線上禁止使用
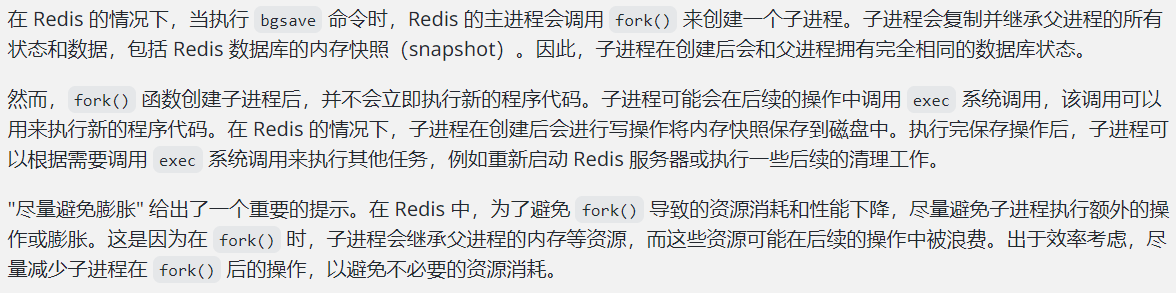
BGSAVEfork 一個子行程進行複製持久化,主行程可以同時修改資料
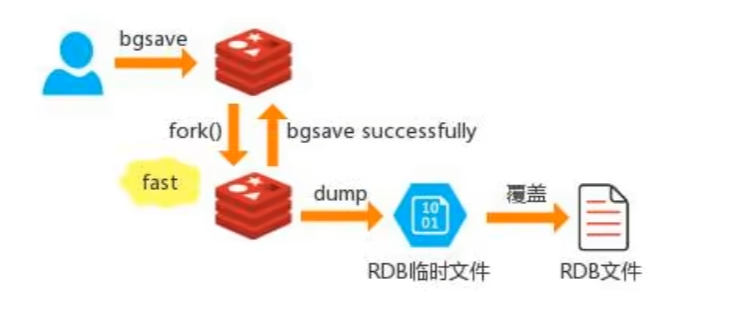
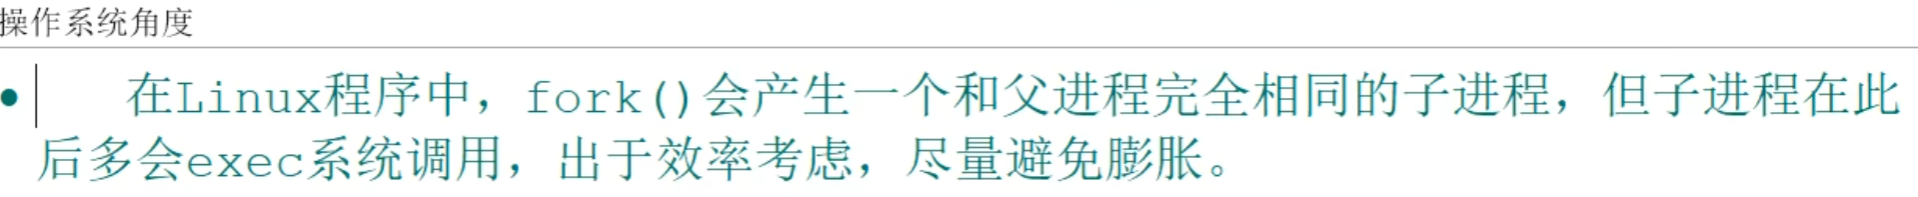
fork()
fork() 函式會建立一個完全和父行程相同的子行程,包括程式碼、資料和開啟的檔案描述符等。
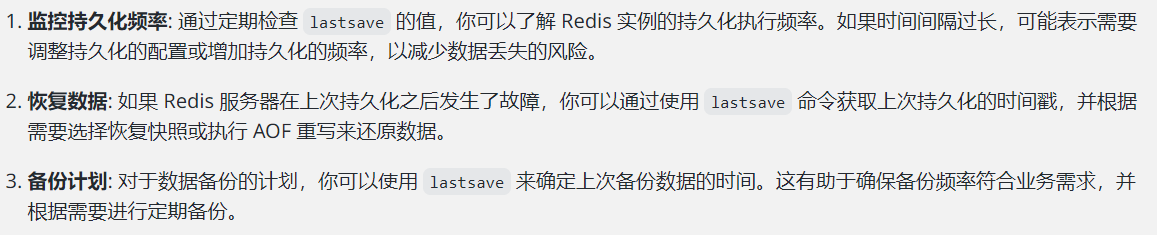
lastsave date -d
lastsave用於取得最近一次成功執行持久化操作(快照或 AOF)的時間戳。它可以告訴你上次完成持久化的時間,對於監控和管理 Redis 實例非常有用
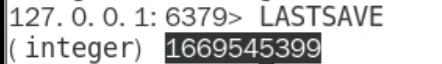
date -d @16695455399

RDB 優缺點
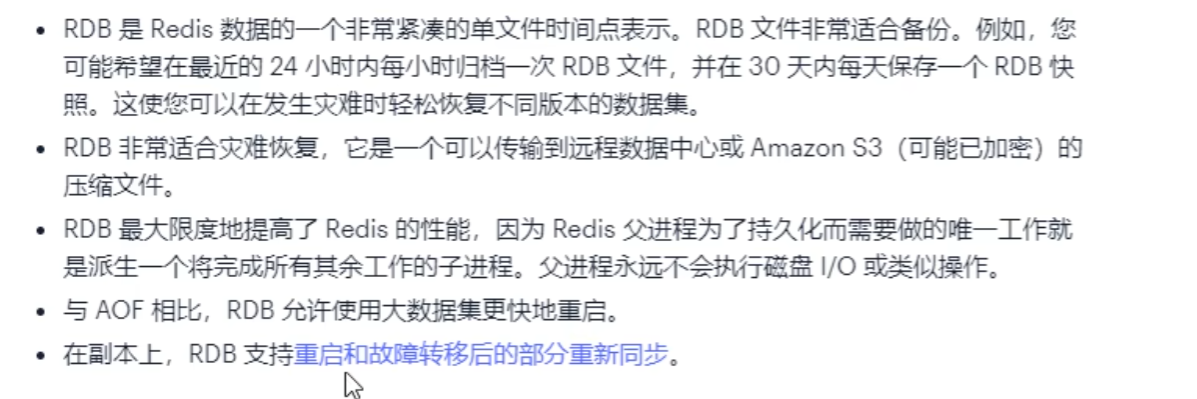
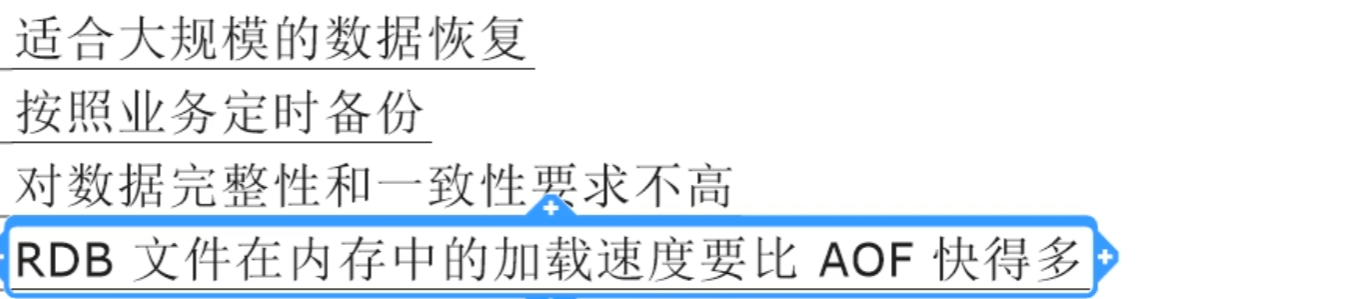
- 適合大規模資料還原
- 比 AOF 快
- 定時備份
- RDB 缺點
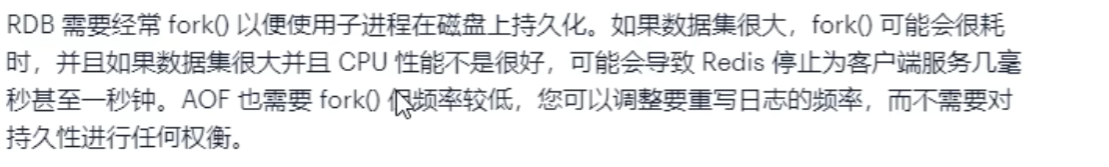
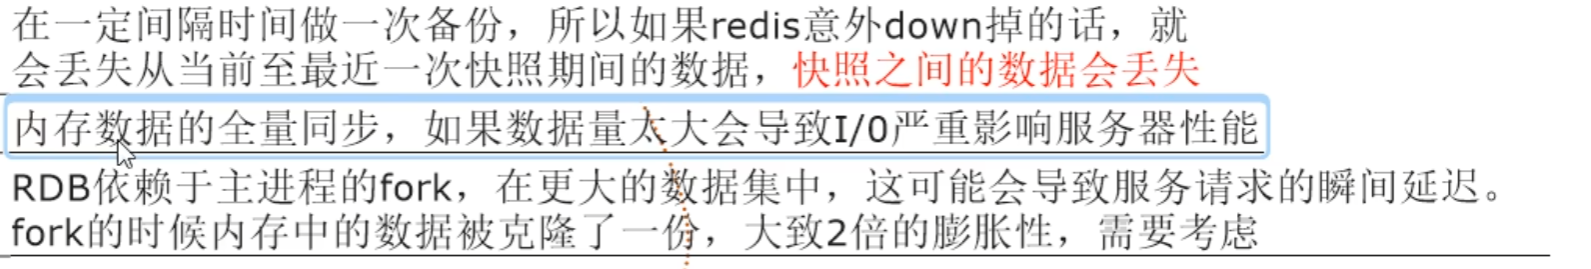
- 在沒有觸發達到儲存條件時發生意外的資料會遺失
- fork() 可能消耗效能大
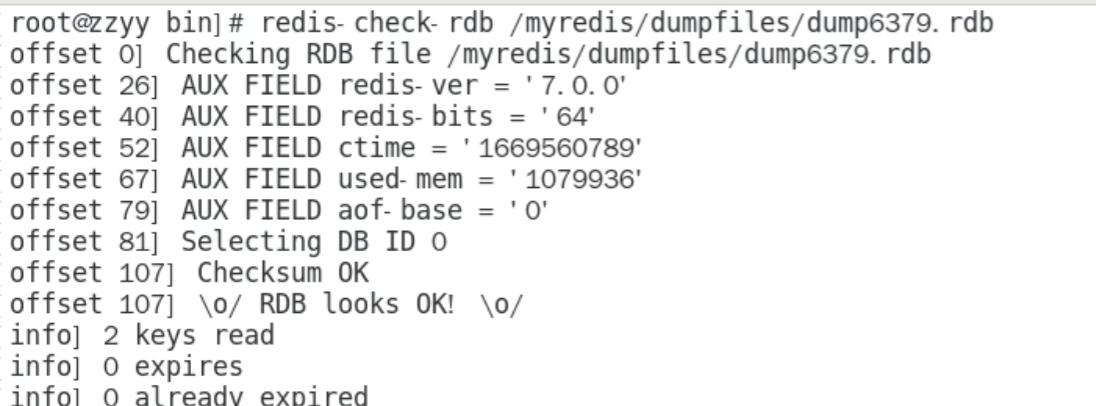
修復
check -rdb /myredis/dumpfiles/dump6379.rdb
 寫到一半斷電導致破損了
最佳化設定
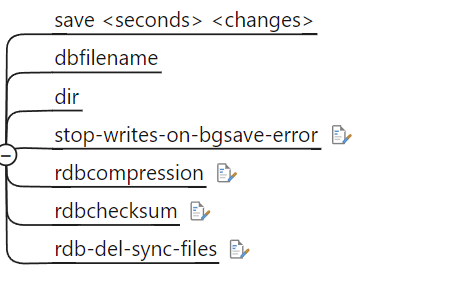
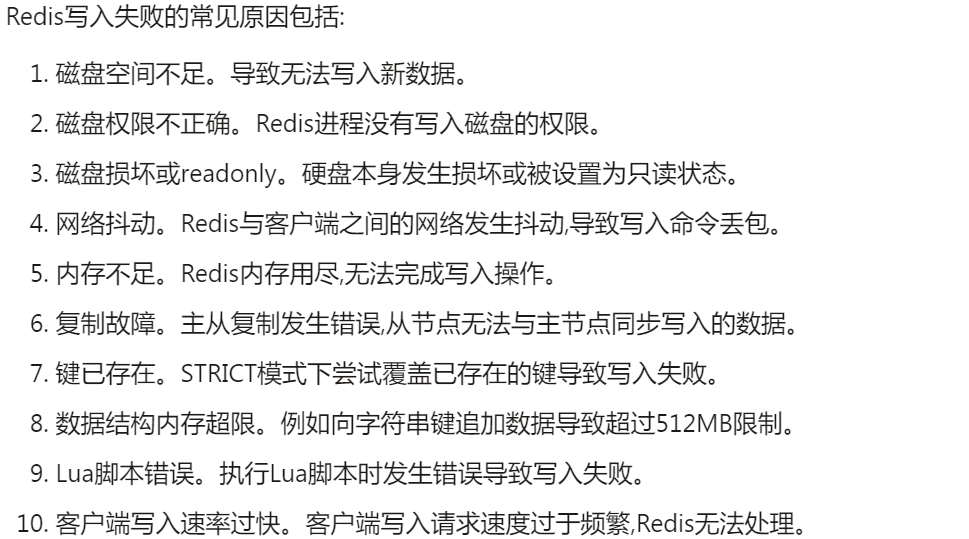
stop-writes-on-bgsave-error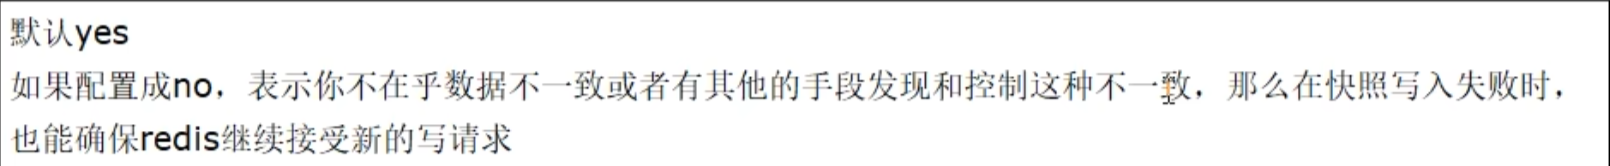
yes:如果在bgsave過程中,發生寫入錯誤,Redis將停止接收任何請求,直到bgsave完成為止no:即使在bgsave過程中發生寫入錯誤,Redis也會繼續接收請求並嘗試寫入
rdbcopression壓縮變小,消耗一點cpu
rdbchecksum 安全與一致性 建議 yes

rdb-del-sync-files 不用管

AOF
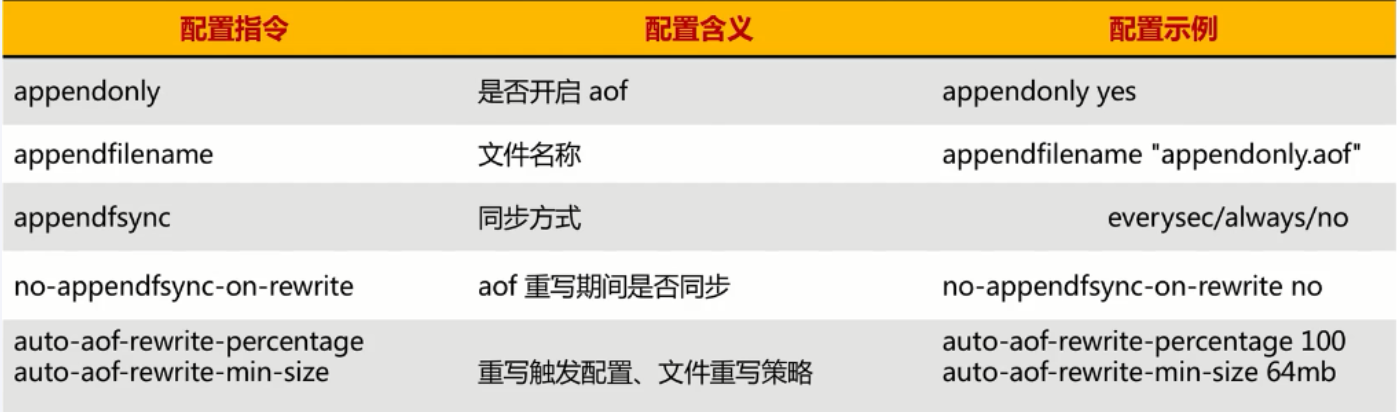
appendonly yes
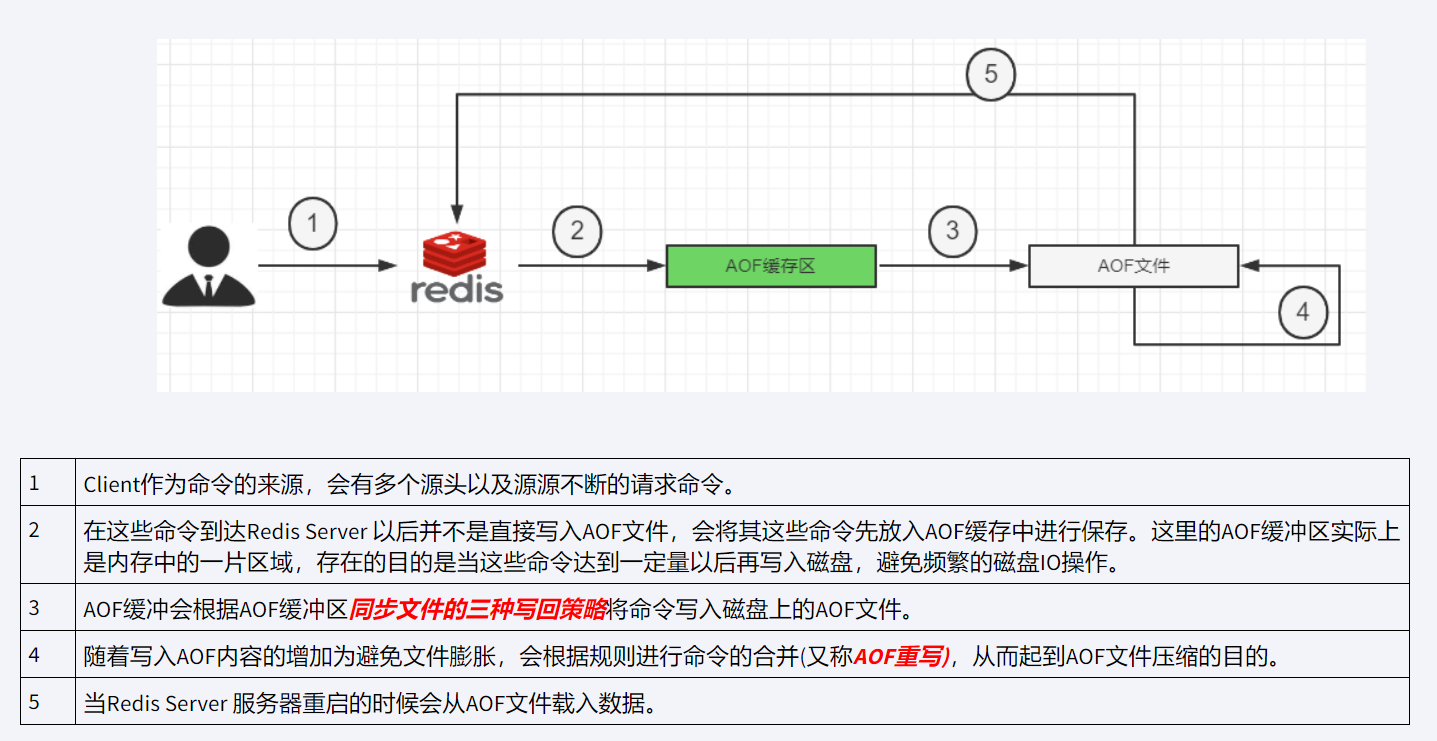
三種寫回策略
appendsync everysec
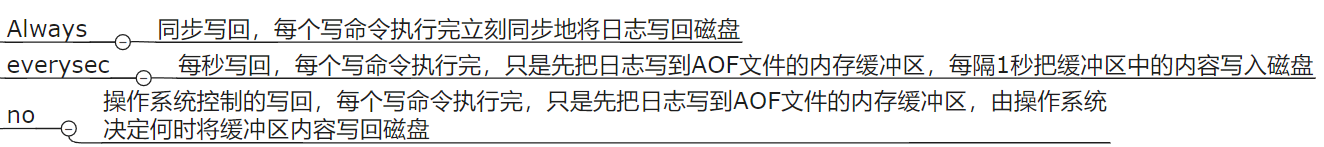 一般選
everysec, always 會導致 IO 太多,效能下降
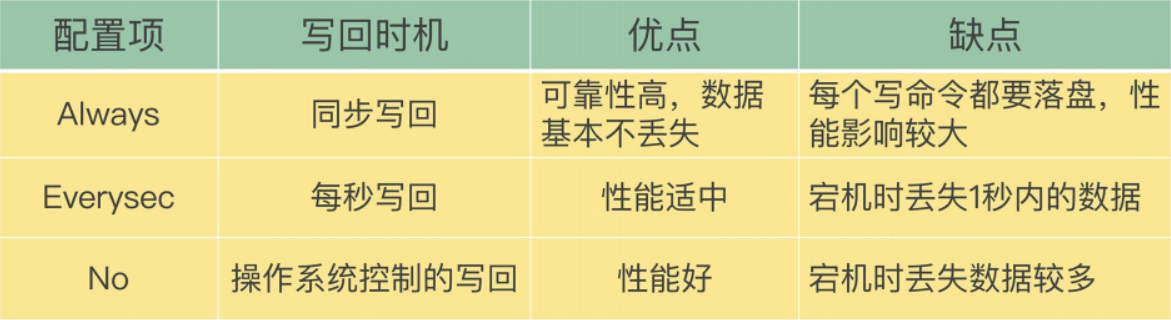 no 則取決於
linux 核心刷新資料的設定,通常 30 秒
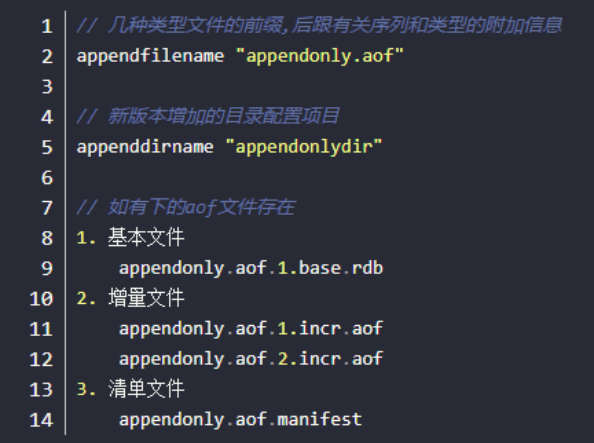
儲存規則
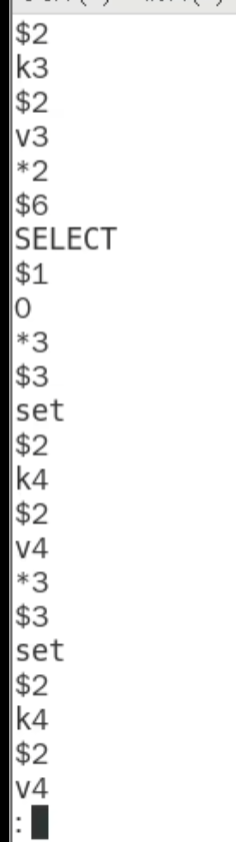
incr 檔案內容
修復 redis-check-aof --fix 檔案名稱
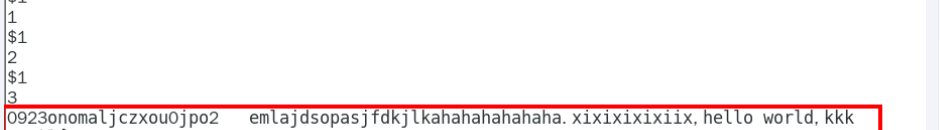
如果只是資料被截斷
redis不會被影響,redis會自動捨棄錯誤的資料,但如果錯誤的資料發生在檔案中,後面的資料也會被捨棄,可能造成資料遺失
人為破壞
incr檔案會連接不上redis
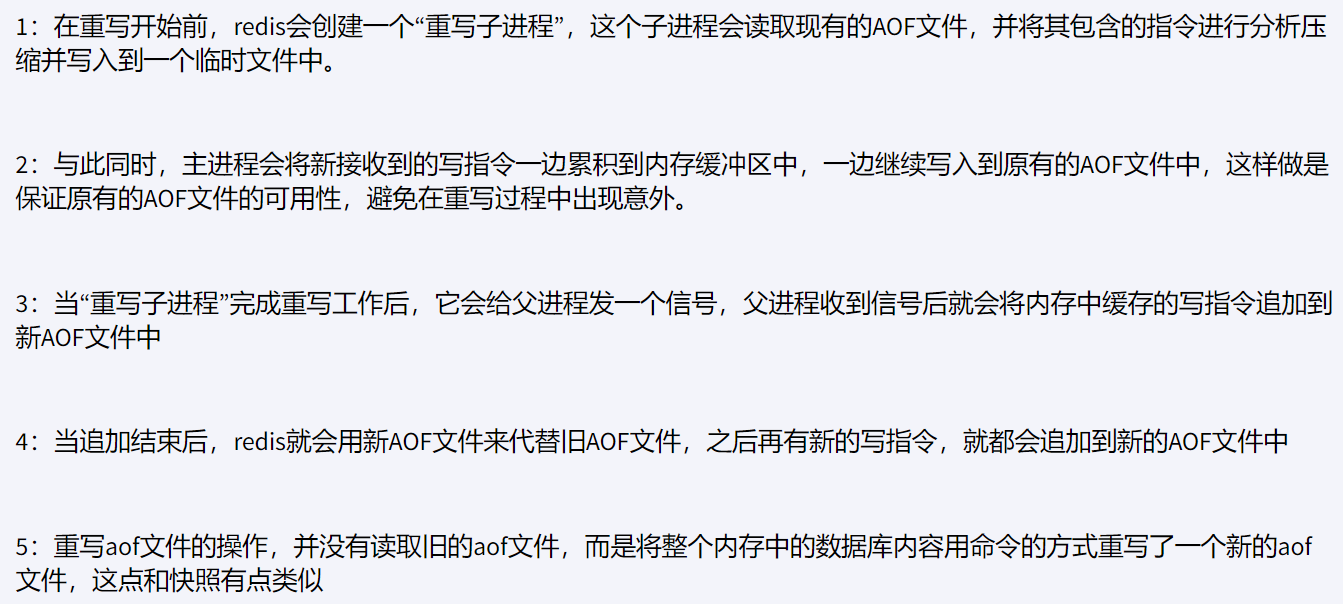
AOF 重寫機制
appendfsync every/always/no
auto- aof- rewrite- percentage 100設定為 100 表示只要目前 AOF 檔案的大小是上一次 AOF 檔案大小的兩倍或更多
auto- aof- rewrite- min- size 1k
incr 檔案達到 1k的兩倍就會重寫
redis 交易
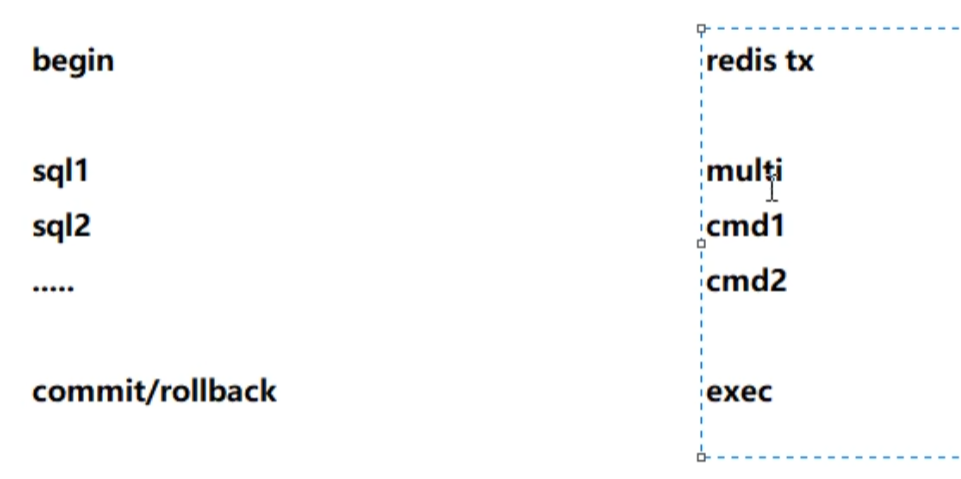
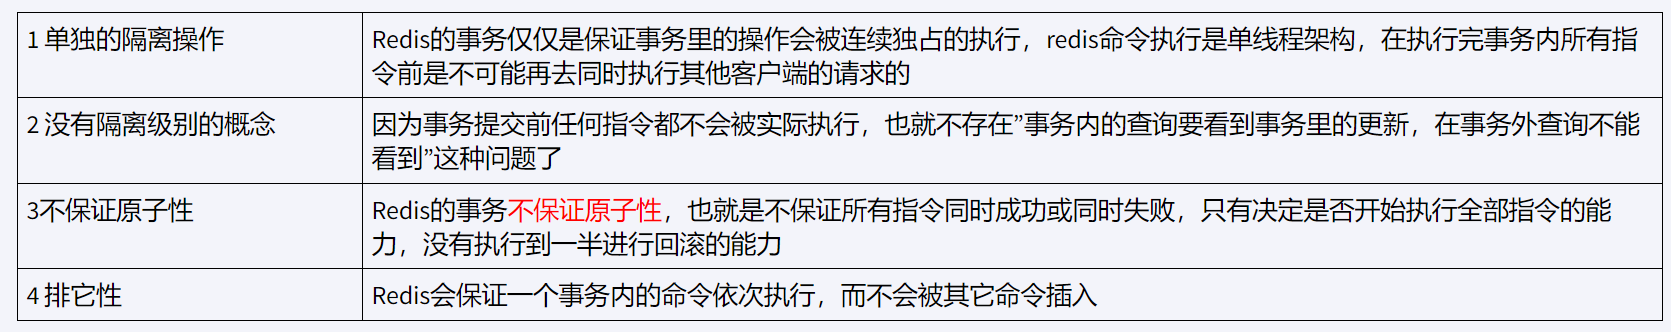
交易的要求:希望一個命令或多條命令能夠合到一起成為一個不可分割、具備原子性、不被干擾打斷、統一執行的批次處理命令

正常執行
multi
exec
放棄交易
multi
discard
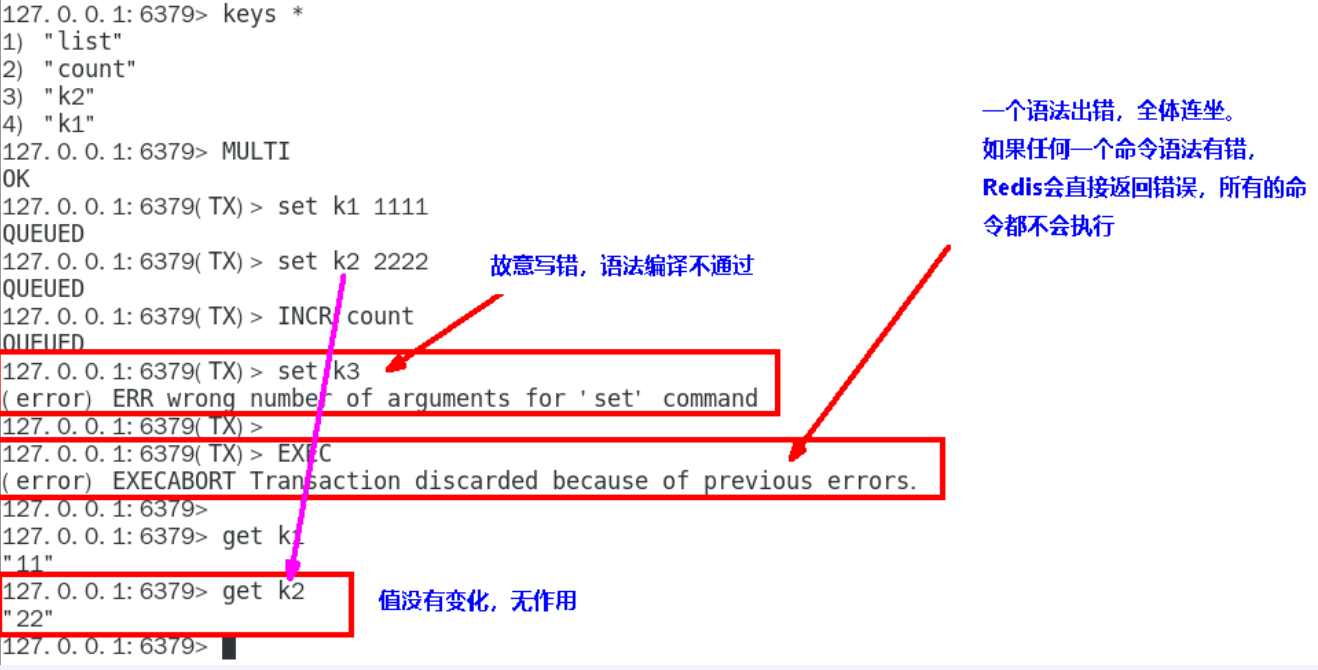
全體連坐
輸入過程中檢查出錯誤,redis 會直接傳回錯誤,任何命令都不會執行
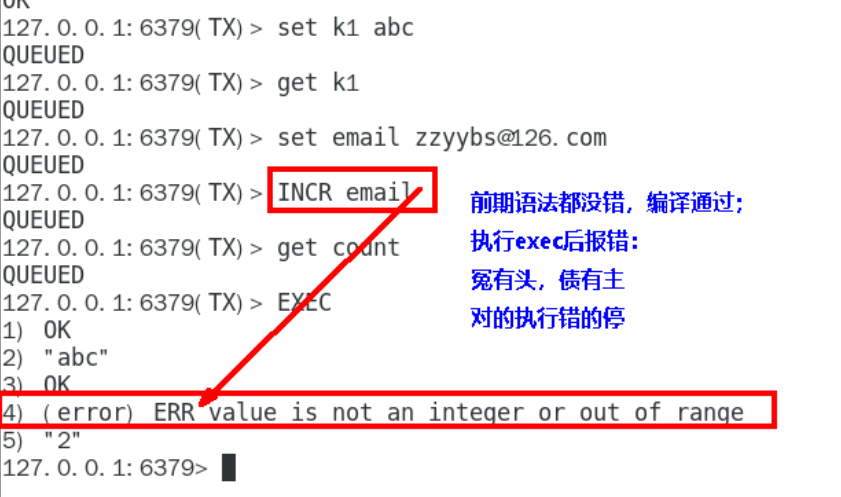
冤頭債主
前期檢查不出的錯誤,執行時才知道,只有出錯的才不會執行

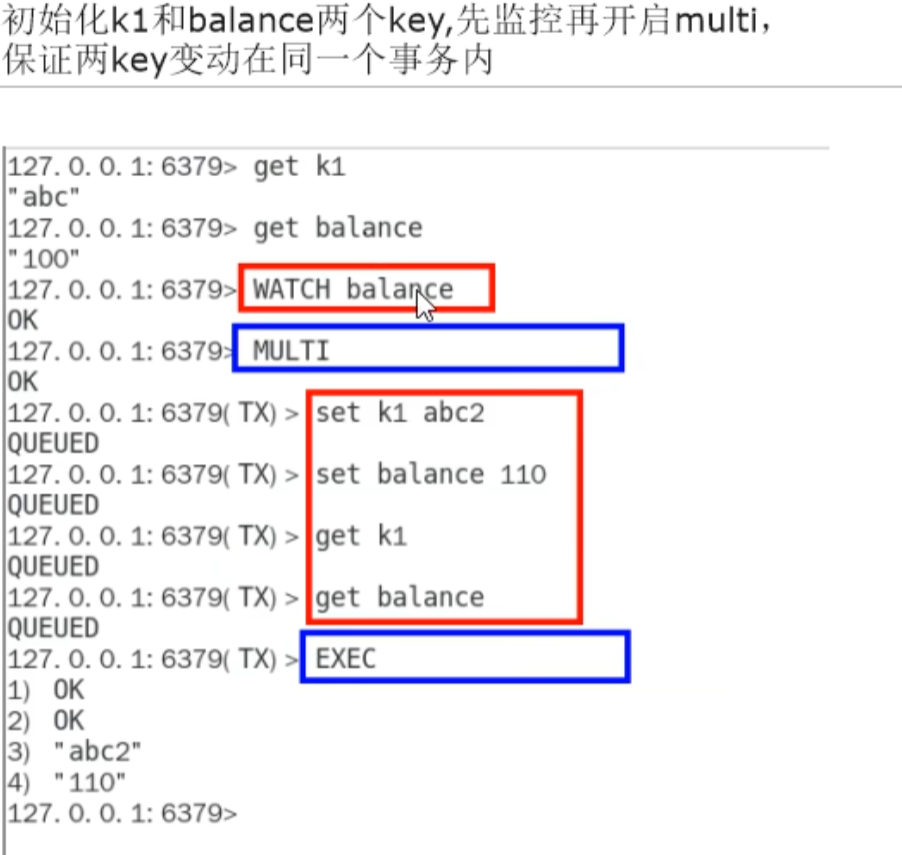
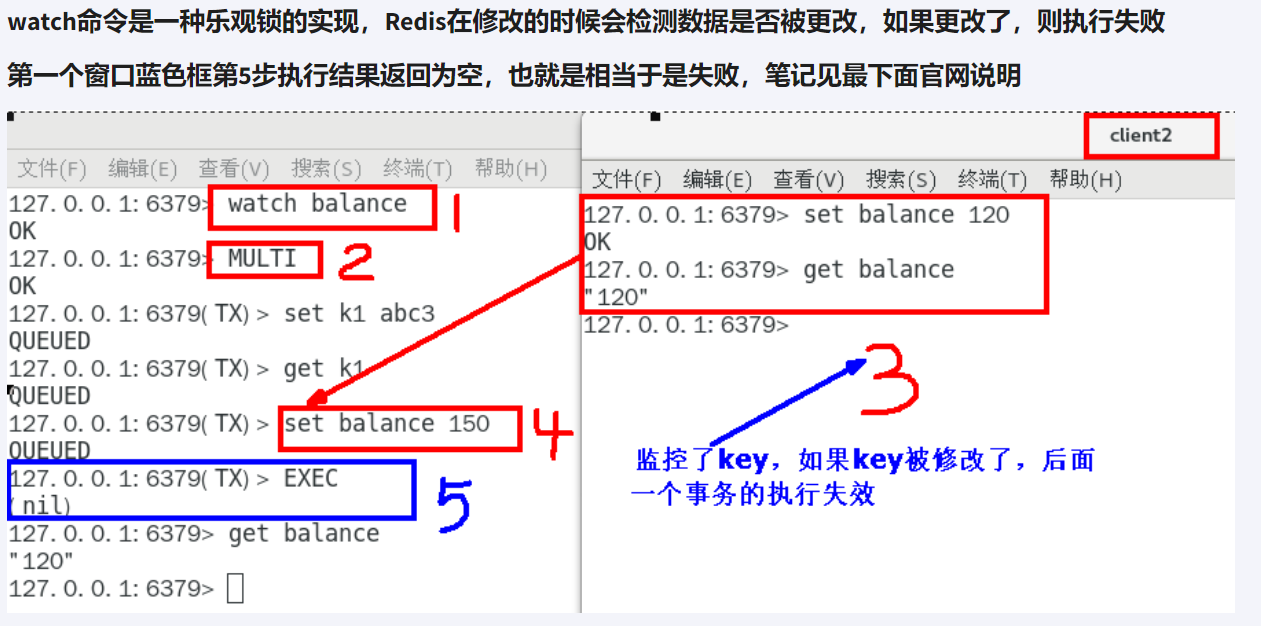
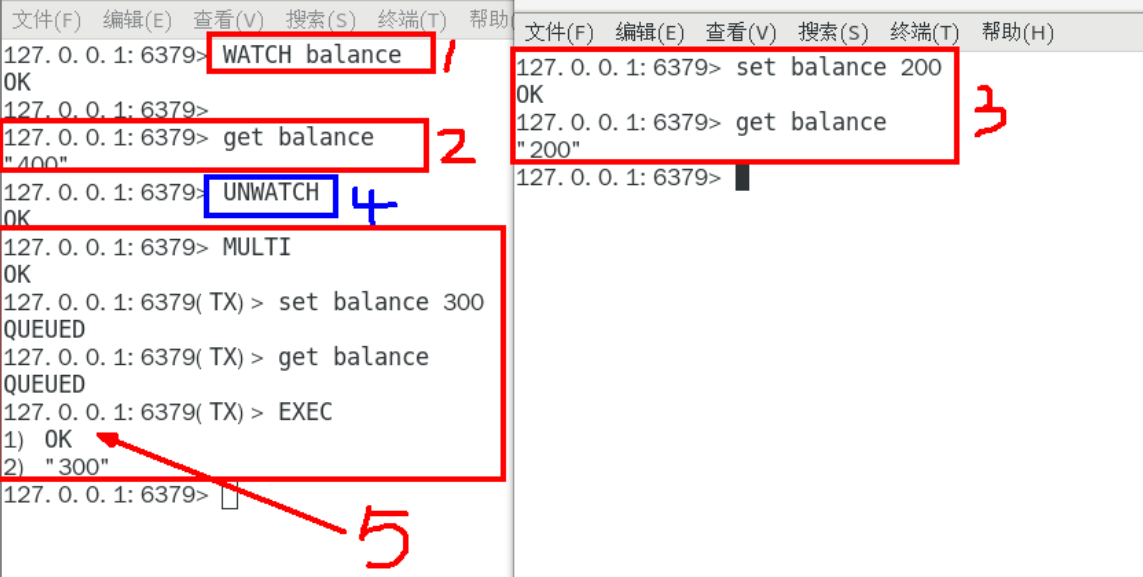
watch 監控
無插隊情況
有插隊情況
Redis 管道
Redis pipelining | Redis 如何最佳化頻繁命令往返造成的效能瓶頸

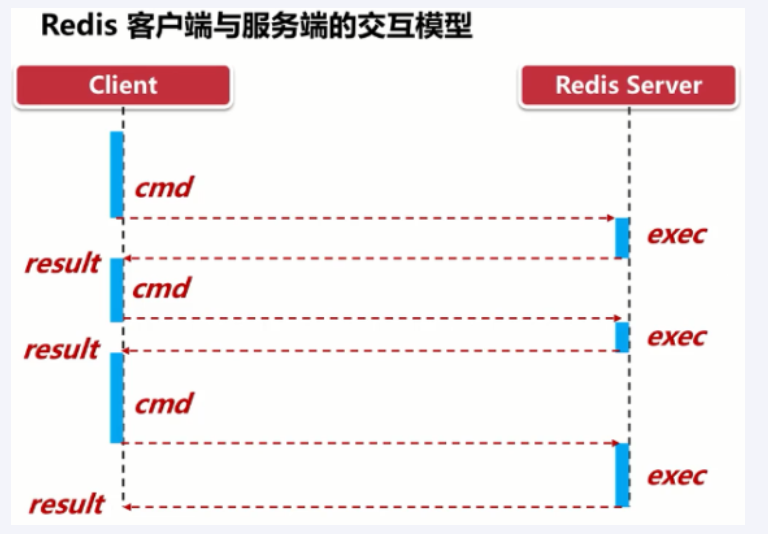
 降低
RTT(Round Trip Time) 對效能的影響
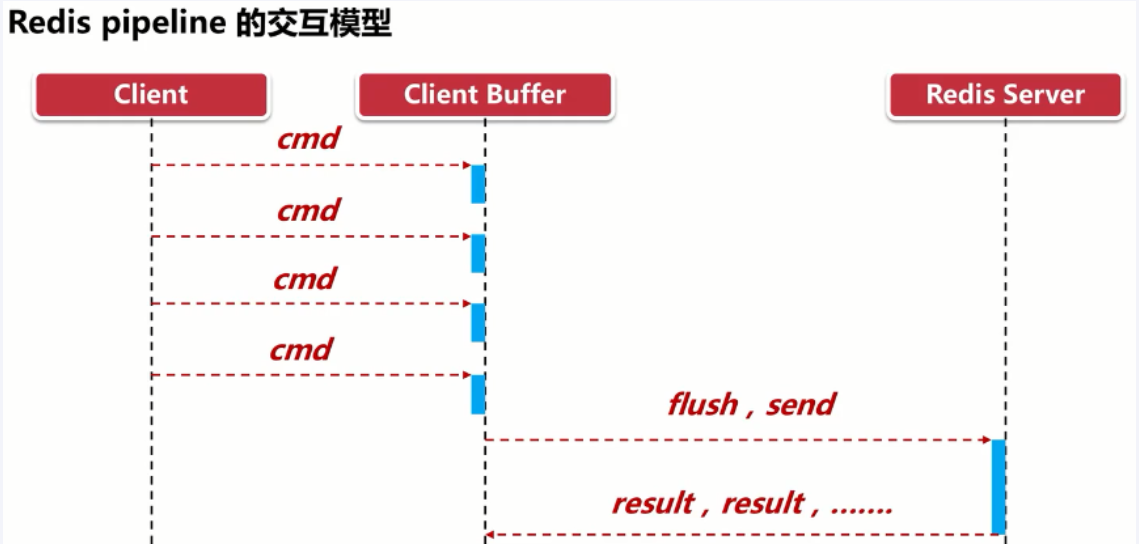
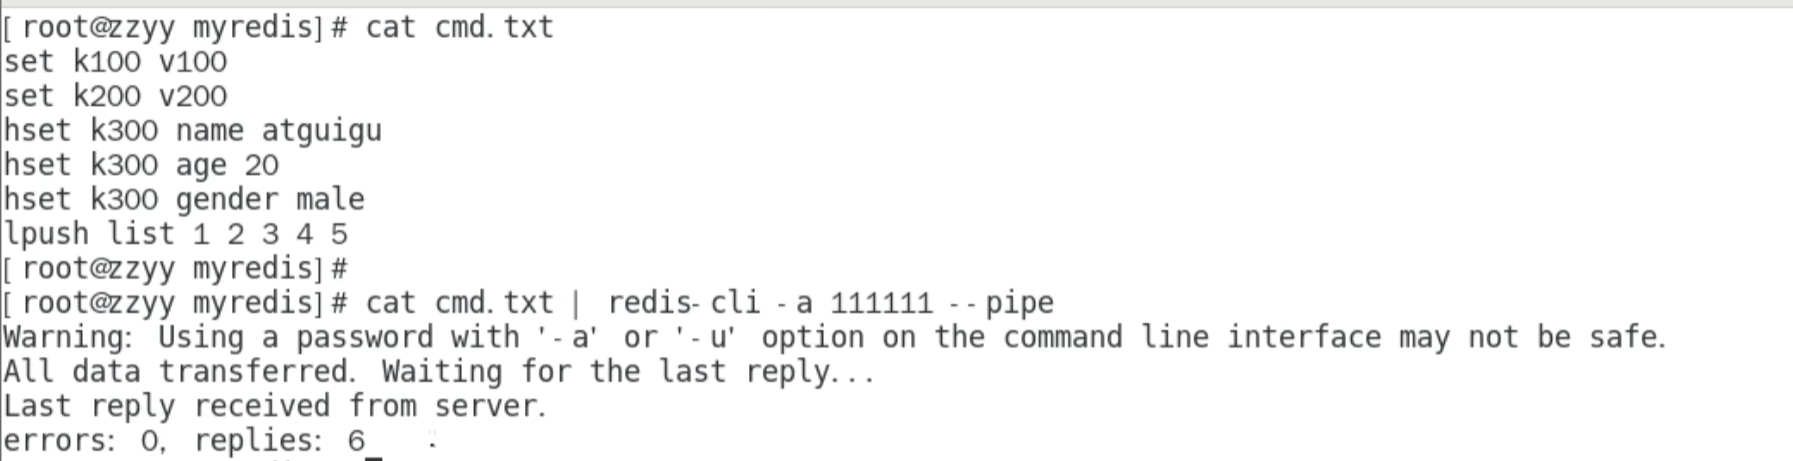
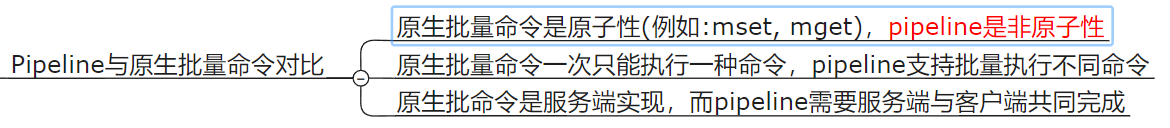 需要
linux 用戶端和 伺服端共同完成


Redis 發布訂閱 (了解)


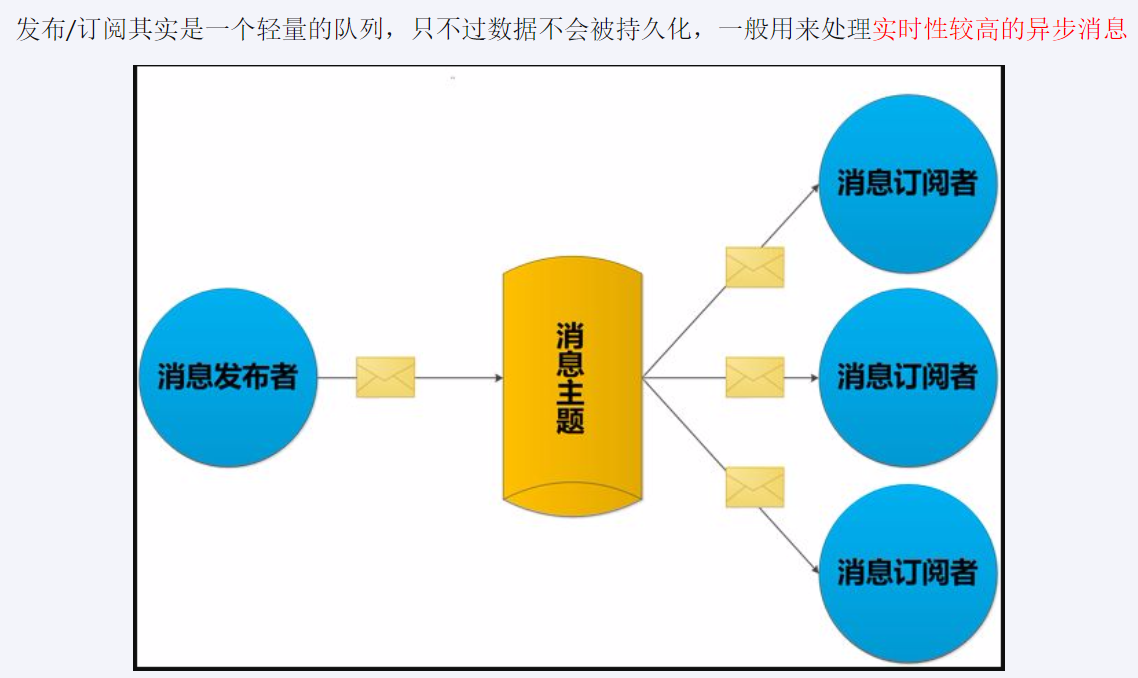
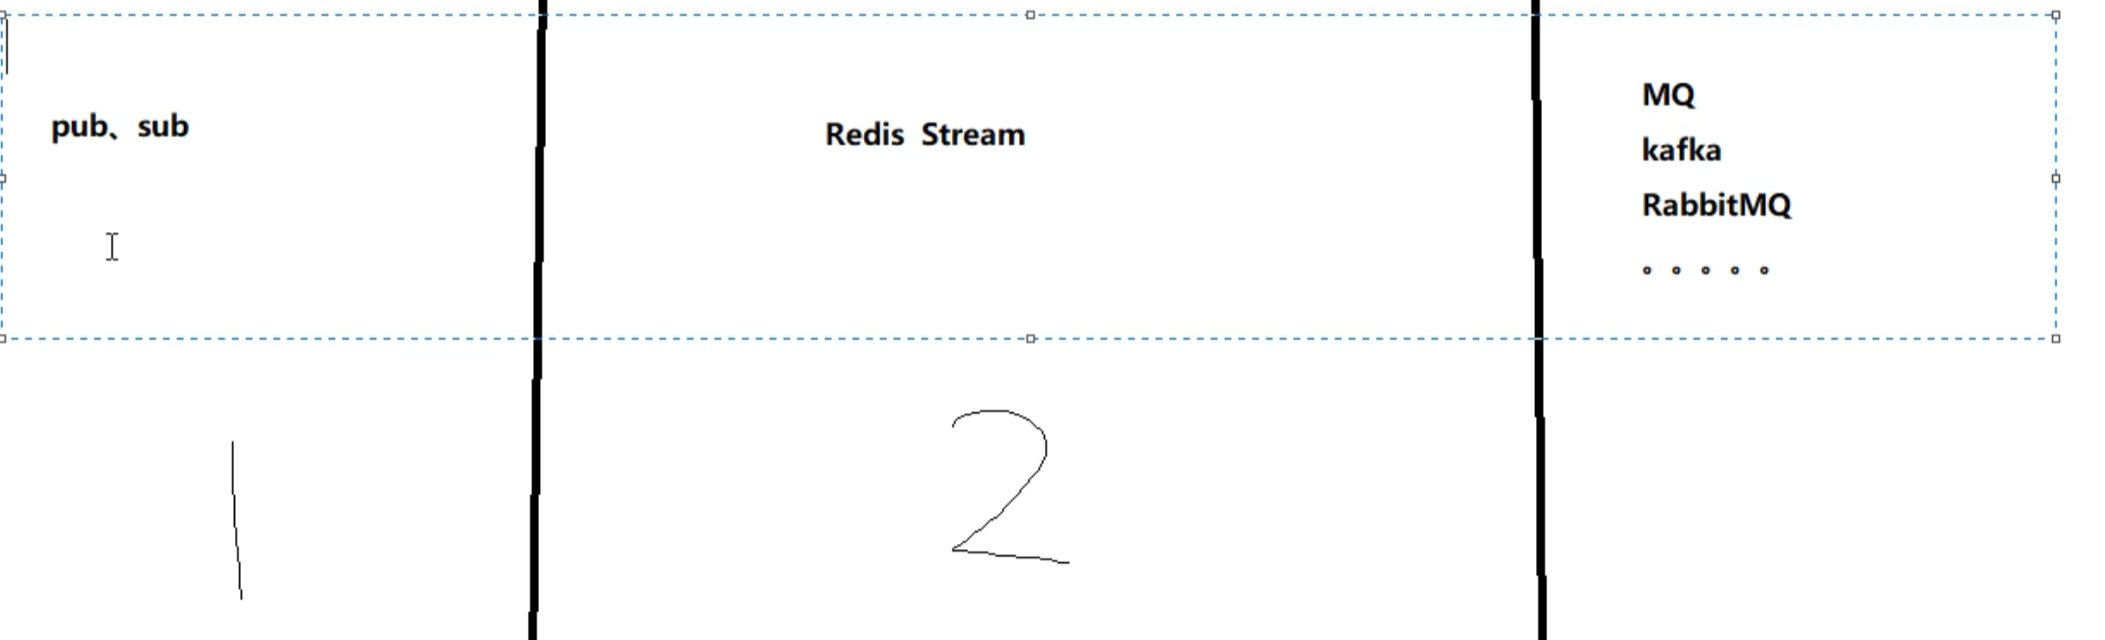 就是
redis 訊息佇列的前身雛形

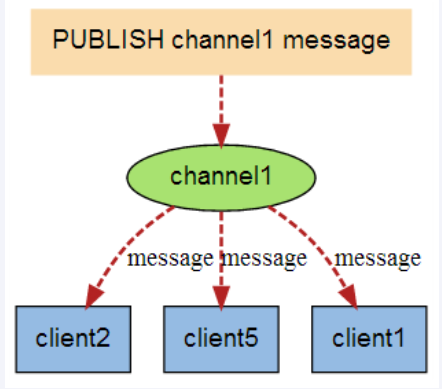
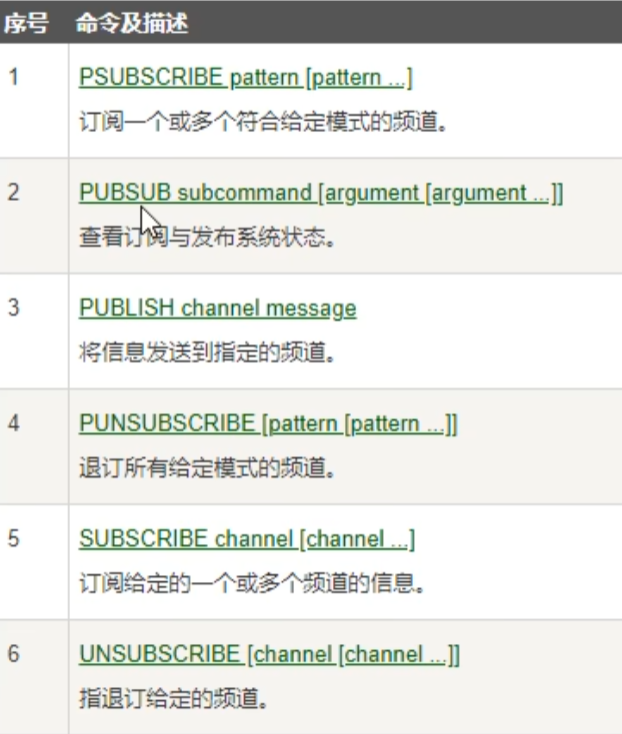
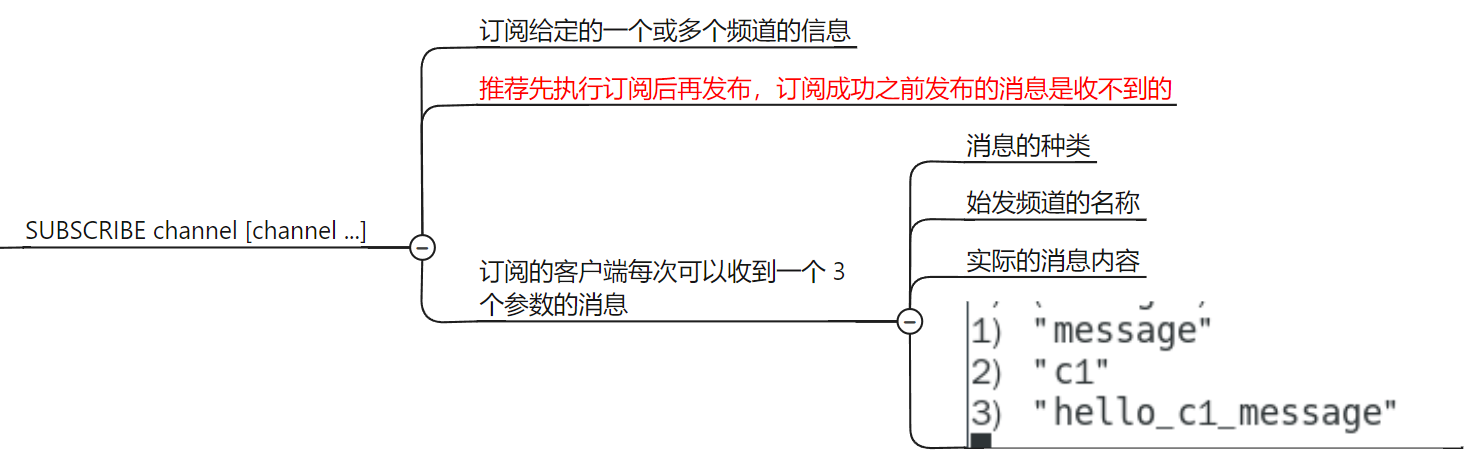
subscribe channel [channel ...]
publish channel message
publish pattern [pattern ...]
pubsub subcommand [argument [argument ...]]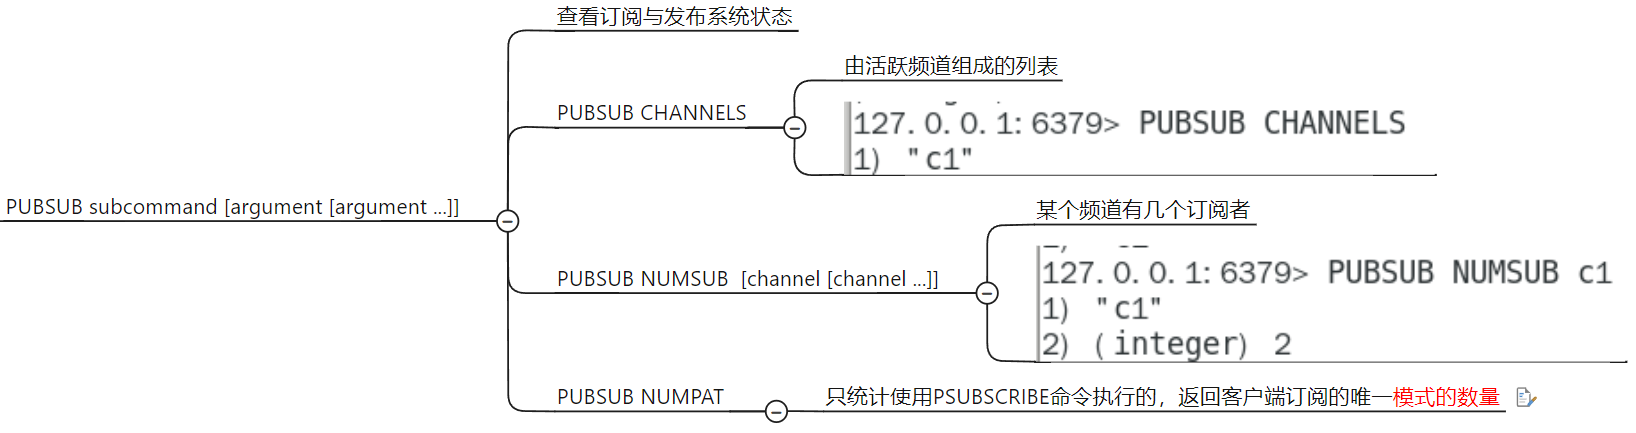
unsubscribe [channel [channel ...]]
Punsubscribe [pattern [pattern ...]]

redis 複製(replica)
主從複製:master 以寫為主,slave 以讀為主 當 master 資料變化時,自動將新的資料非同步同步到其他 slave 資料庫
 設定從庫不設定主庫
設定
---通用部分---
bind 0.0.0.0 # 允許位址
protected-mode: yes #防止Redis實例在未進行任何安全配置(如requirepass/bind)的情況下被外界存取。
daemonize yes               # 允許後台啟動
logfile "/usr/local/redis/redis.log"                # 日誌路徑
dir /opt/software/redis-7.0.3/data                 # RDB檔案存放目錄
appenddirname "appendonlydir"  # AOF檔案會在dir的位置上的appenddirname資料夾保存
appendfilename "appendonly.aof" # AOF檔案名稱
appendonly yes                  # AOF 開啟

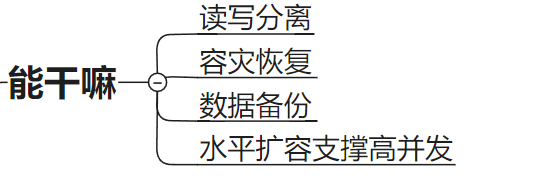
`redis` 主從: 讀寫分離,容災恢復,資料備份,水平擴容支撐高併發

主從:slave依舊可以作為其他slave的master(減少master的壓力)
只有最頂層master可以執行命令,slave會複製之前的也可以複製
主機掛了從機會等待主機上線
中途變更:從機可以隨時修改主機,修改後會自動清除之間的資料,拷貝新master的

缺點:
	掛了需要人工干預
	系統繁忙時,slave導致延遲高

--- Master.conf-----
requirepass xxx #master設定

--- 主從Slave.conf(只需要改從庫配置,無需更改主庫配置)------
# 指定主節點的 IP 和連接埠(推薦)
replicaof 主庫IP 主庫連接埠
# 或者使用舊的方式
slaveof 主庫IP 主庫連接埠
slaveof no one #停止當前資料庫和其他資料庫的同步

masterauth xxx #slave設定

---- 命令列 ----

info replication #查看資訊
slaveof 主庫IP 主庫連接埠  # 手動執行,當前工作階段有效
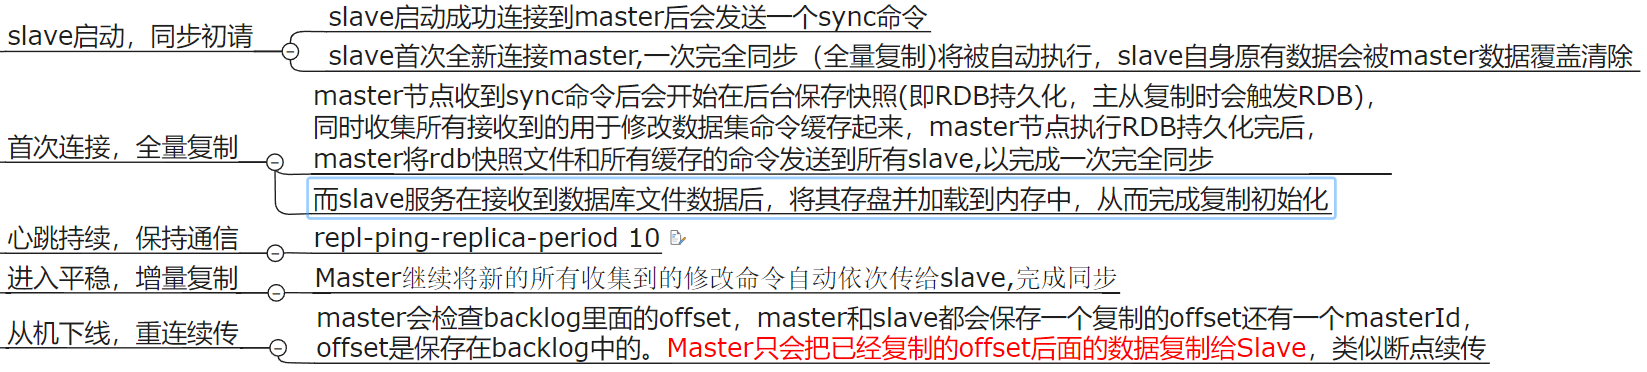
複製原理和工作流程
redis 哨兵sentinel
 無人值守運維 : 將
slave 透過某種機制進行選取,進行主從替換
作用 主從監控: 監控主從 redis 運行 訊息通知: 故障轉移結果發送客戶端 故障轉移: 自動主從切換 配置中心: 透過連接哨兵來獲得當前 Redis 伺服器主節點位址
sentinel.conf 設定檔
在上一章複製配置好的情況下進行配置
sentinel.conf(配置好一个后直接拷贝改动)
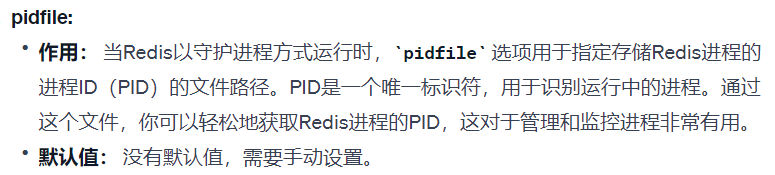
設定檔




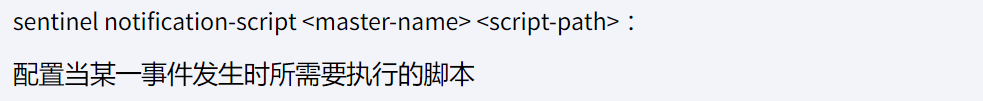

解釋
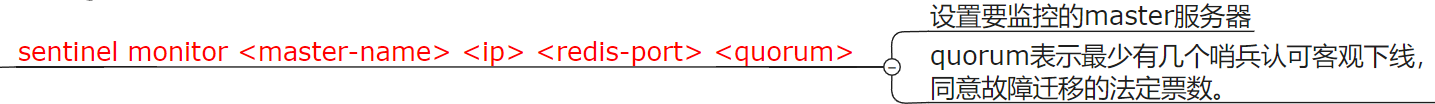
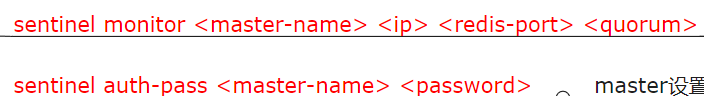
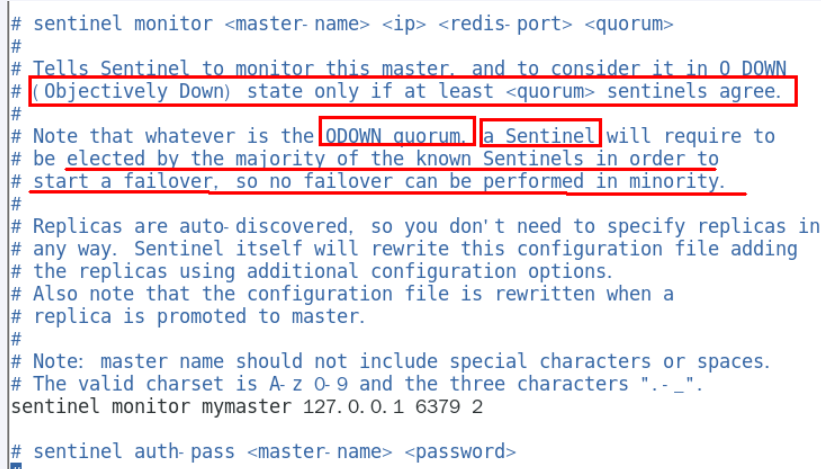
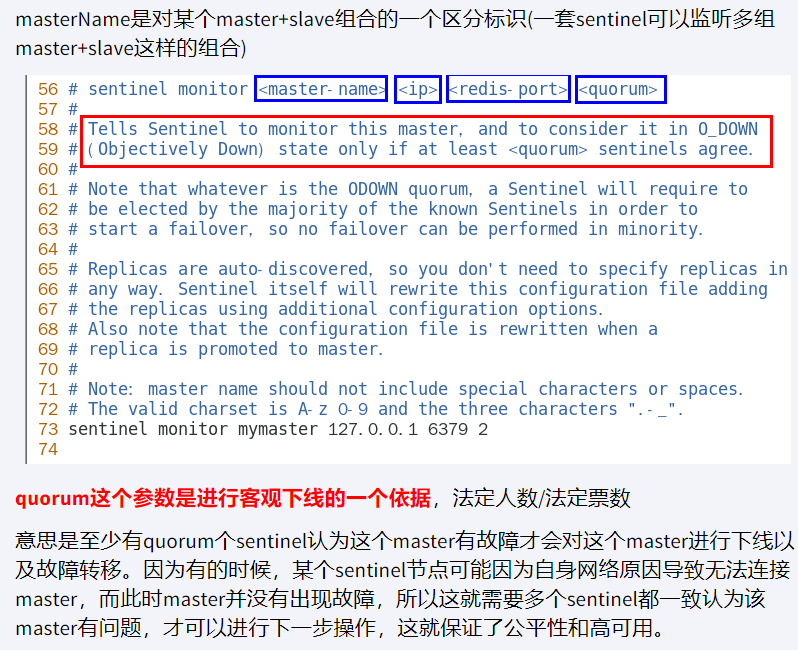
sentinel monitor <master-name> <ip> <redis-port> <quorum>
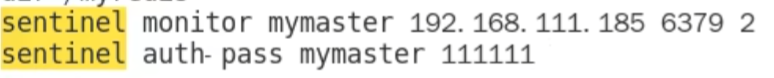
quorum :2,即 2 個哨兵同意即可
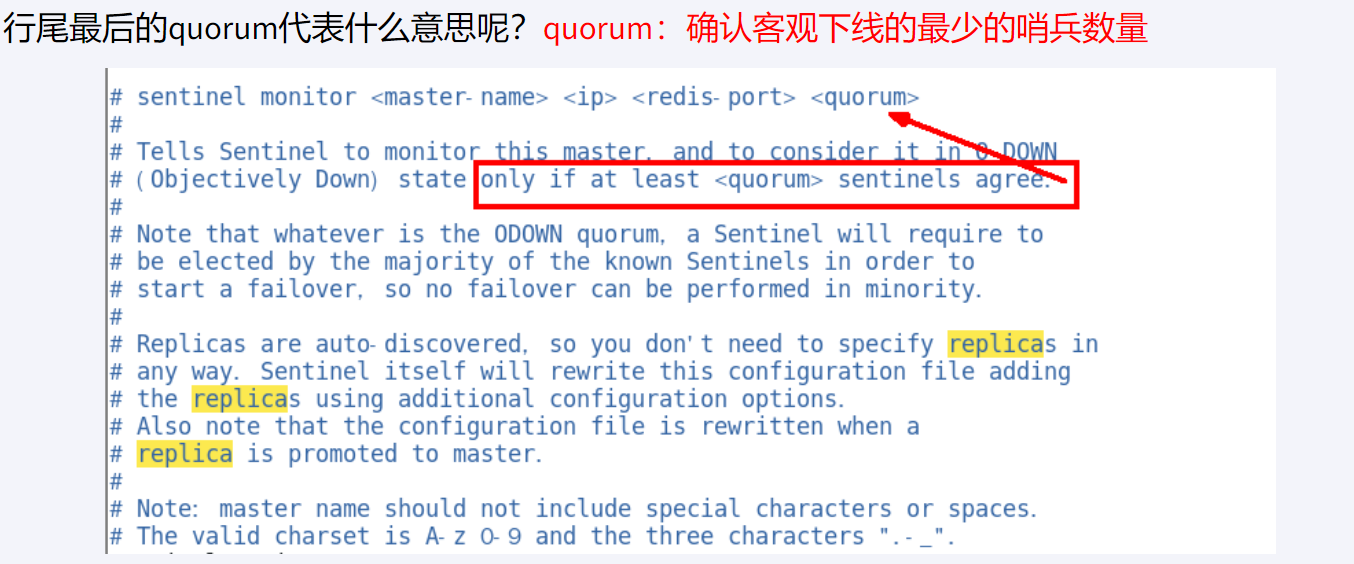
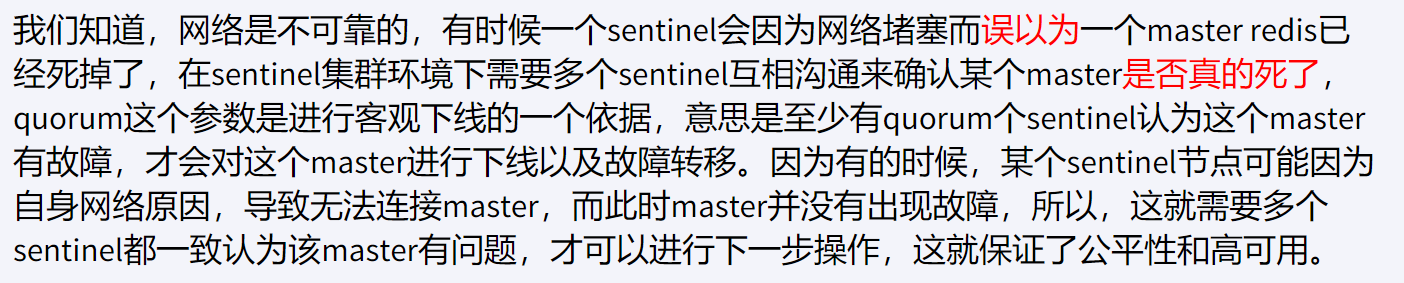 網路壅塞、駭客攻擊、網路波動等等,哨兵之間互相溝通,來判斷是否真的故障了,有時只是某個哨兵自身的問題
sentinel auth-pass <master-name> <password>

啟動叢集
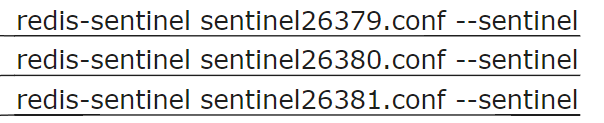
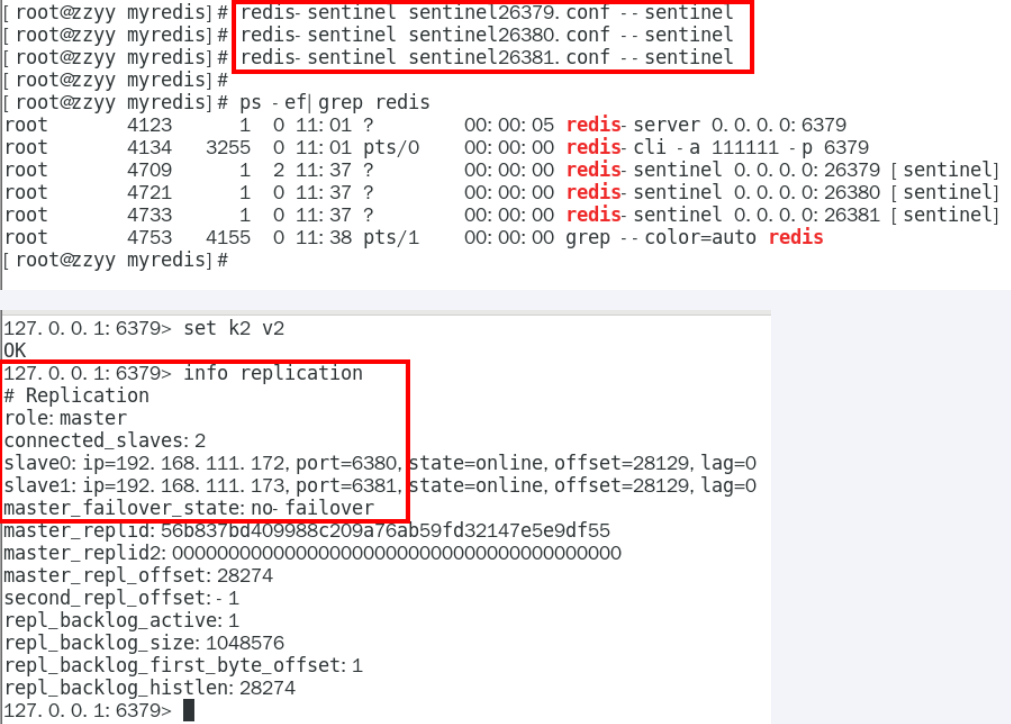
sentinel log
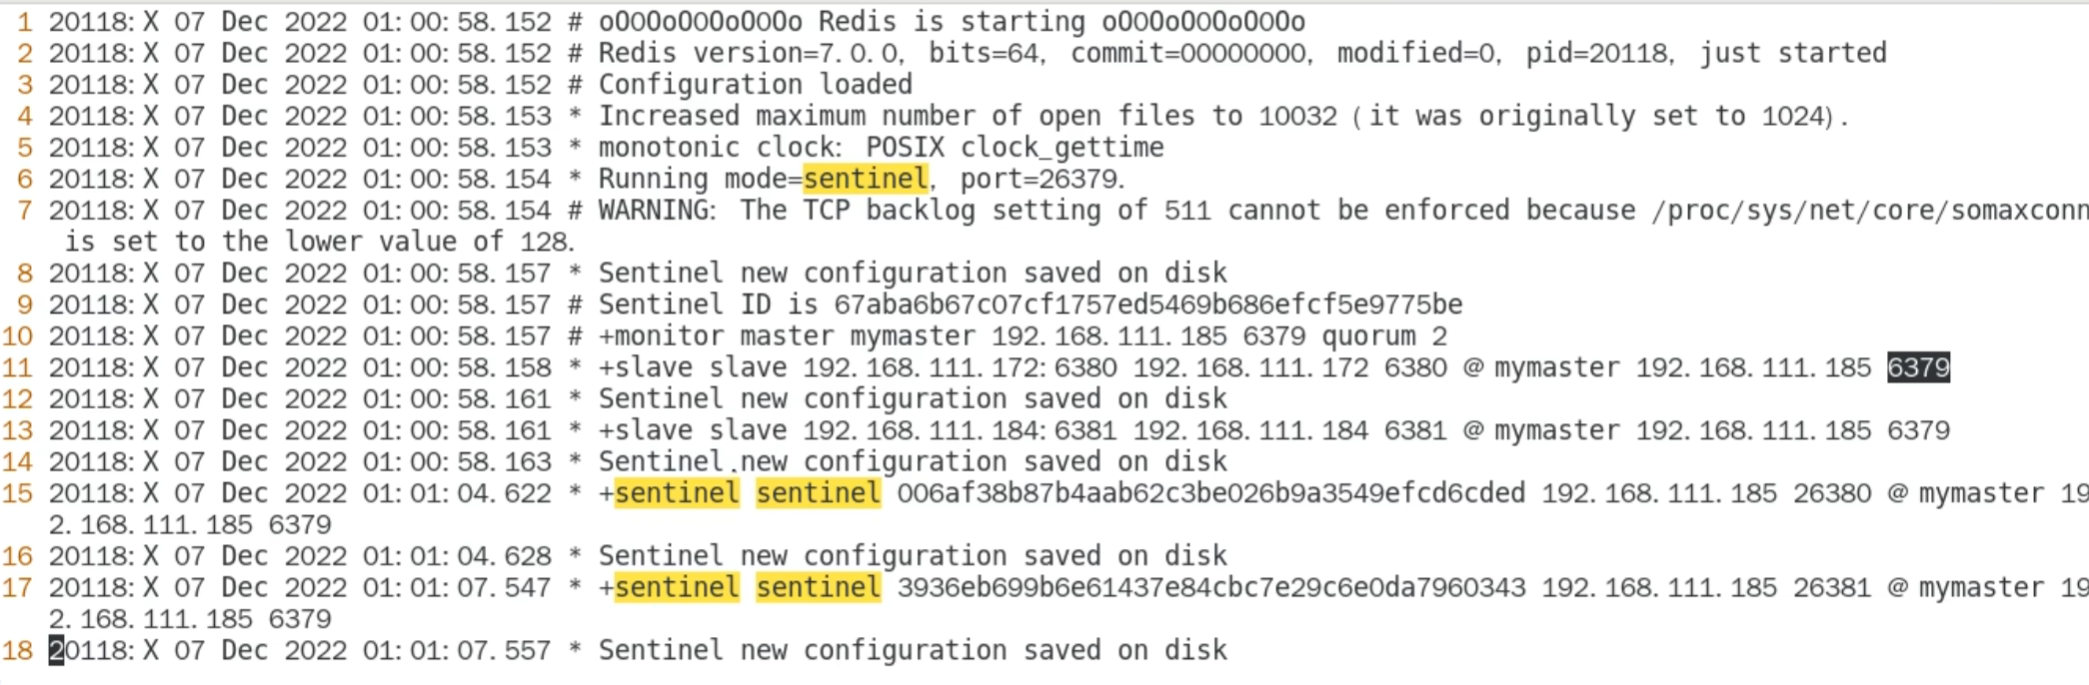
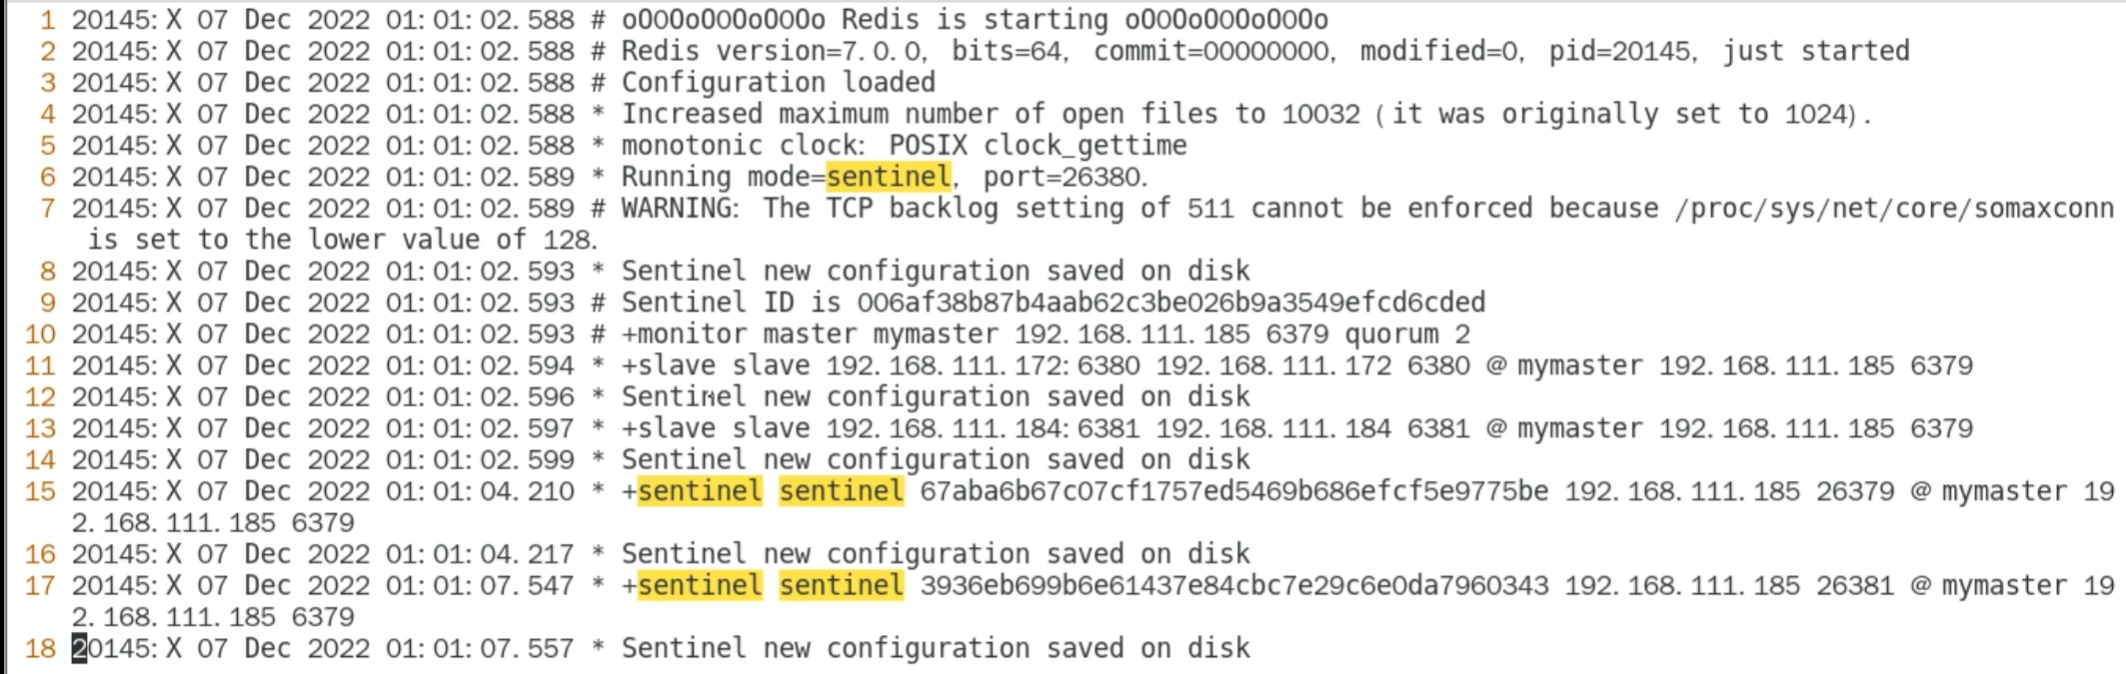
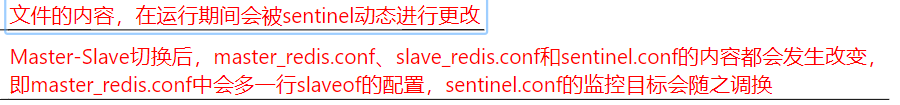
conf 檔案被自動修改
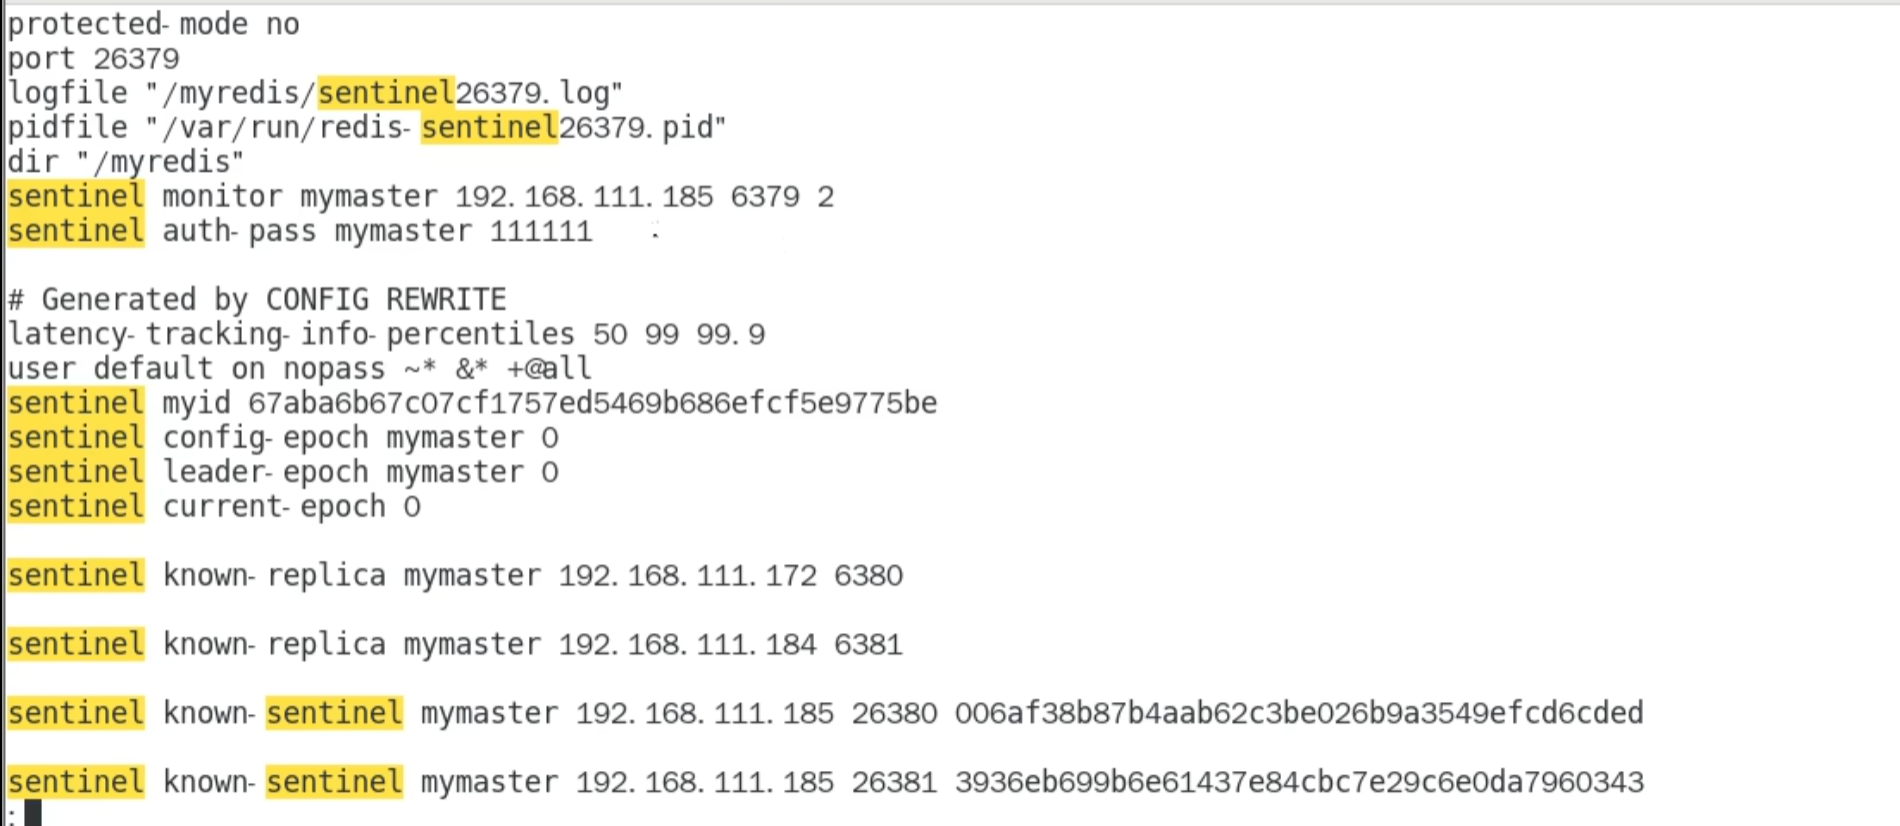
關閉 master 接近 1s ,後台進行了選舉,同時 slave. conf 的檔案也會被修改
被選為主機的 conf 檔案內容被自動刪除
被選為 slave 的自動被修改
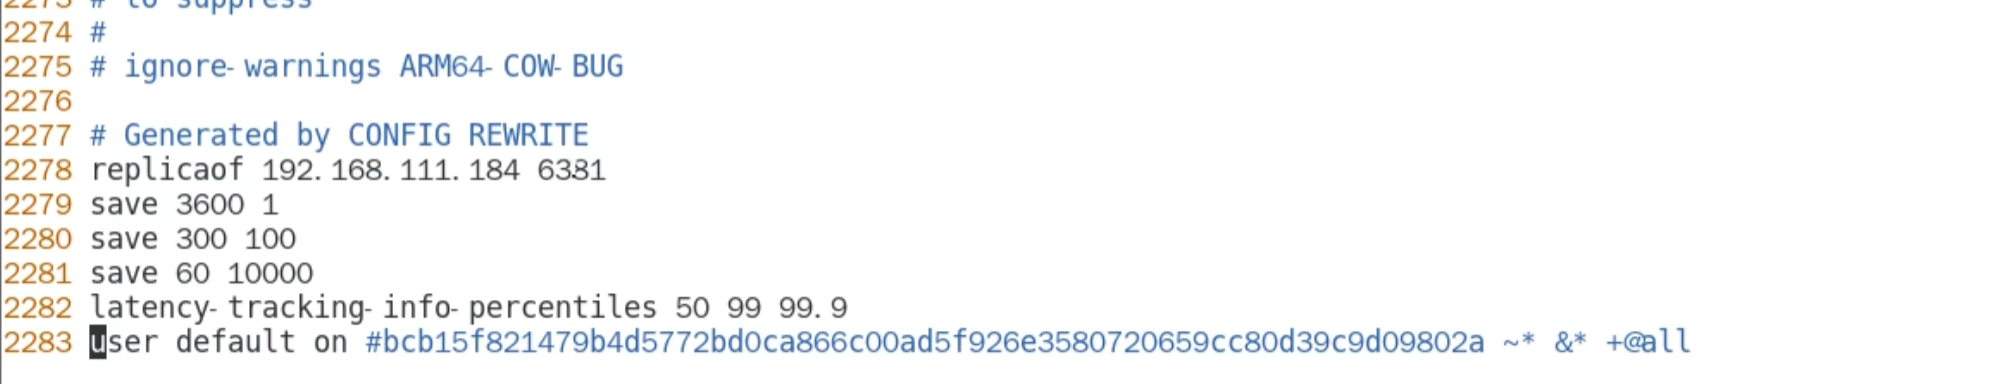

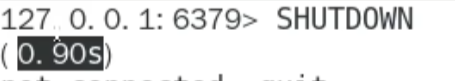
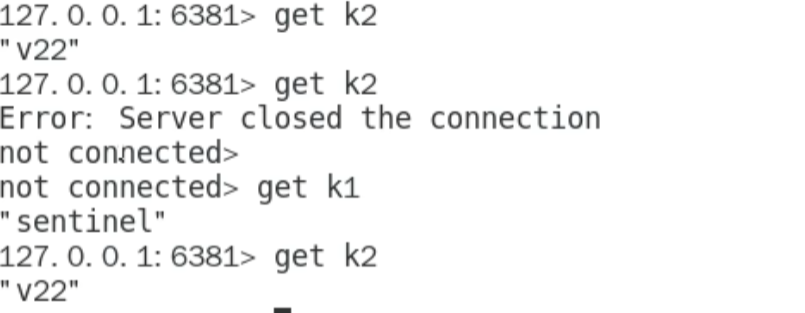
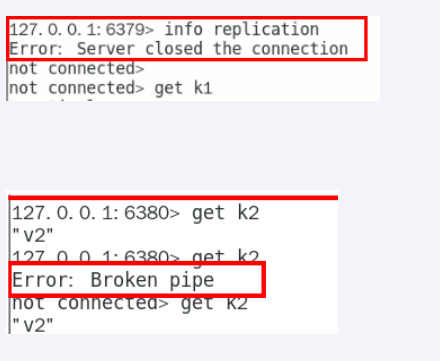
第一次失敗是因為需要進行網路的重新讀取和規劃,告訴你原有的連線被斷開了,可能需要重發一次心跳包,重新續接上去
剩下的兩台slave其中一台會被選為master
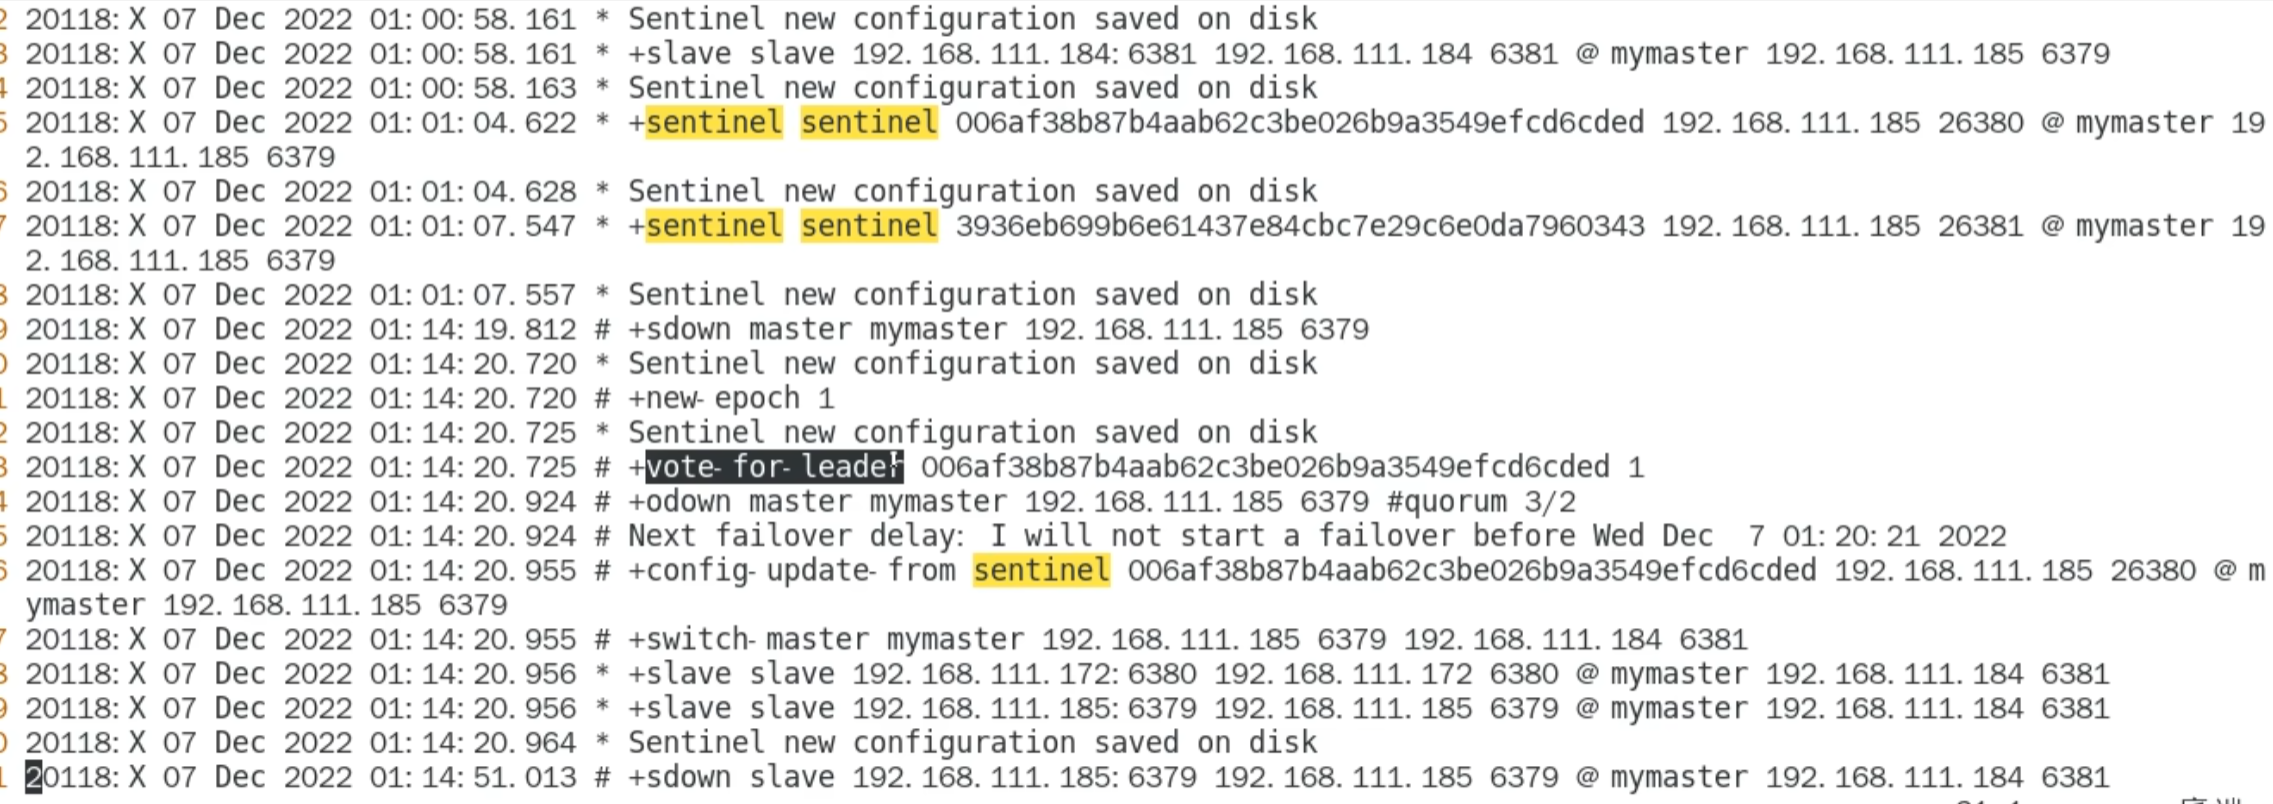
即使之前的 master 回來,也不會成為現在的 master 了
小問題
哨兵的運行流程和選舉原理

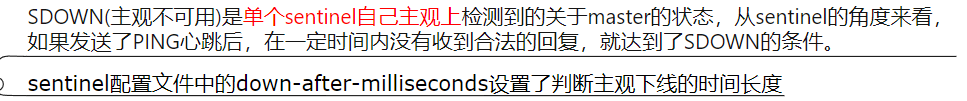
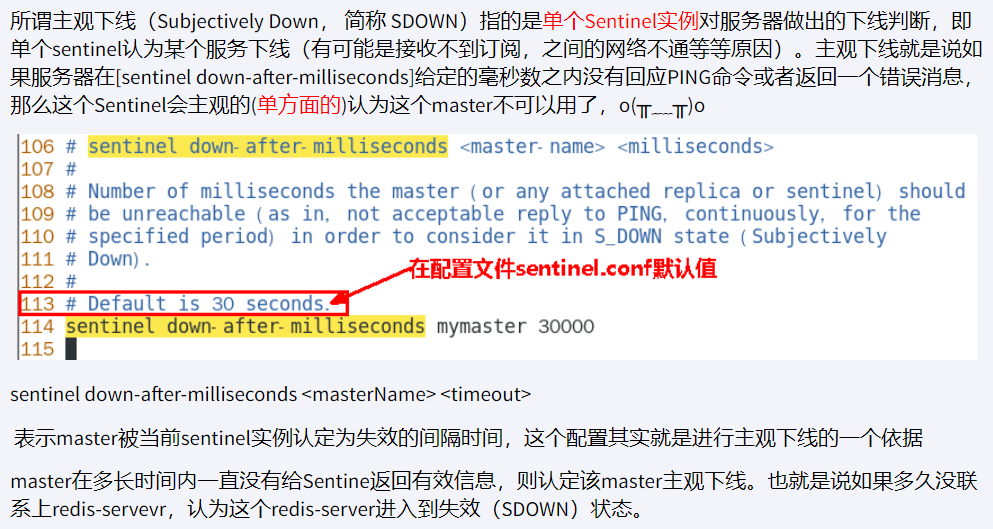
SDown主觀下線(Subjectively Down)
ODown客觀下線 (Objectively Down)
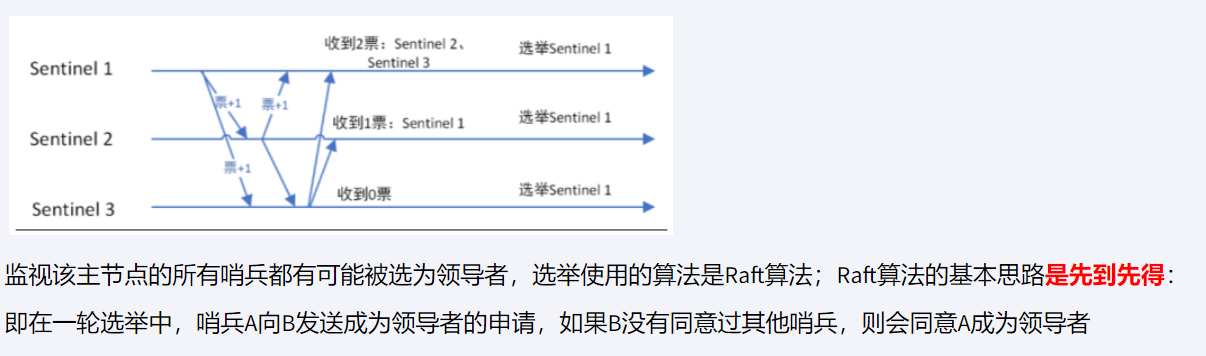
- 選出哨兵
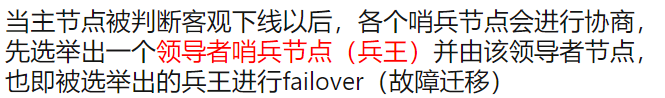
三個中選出一個 leader,這個 leader 選出 master 4. 選舉日誌
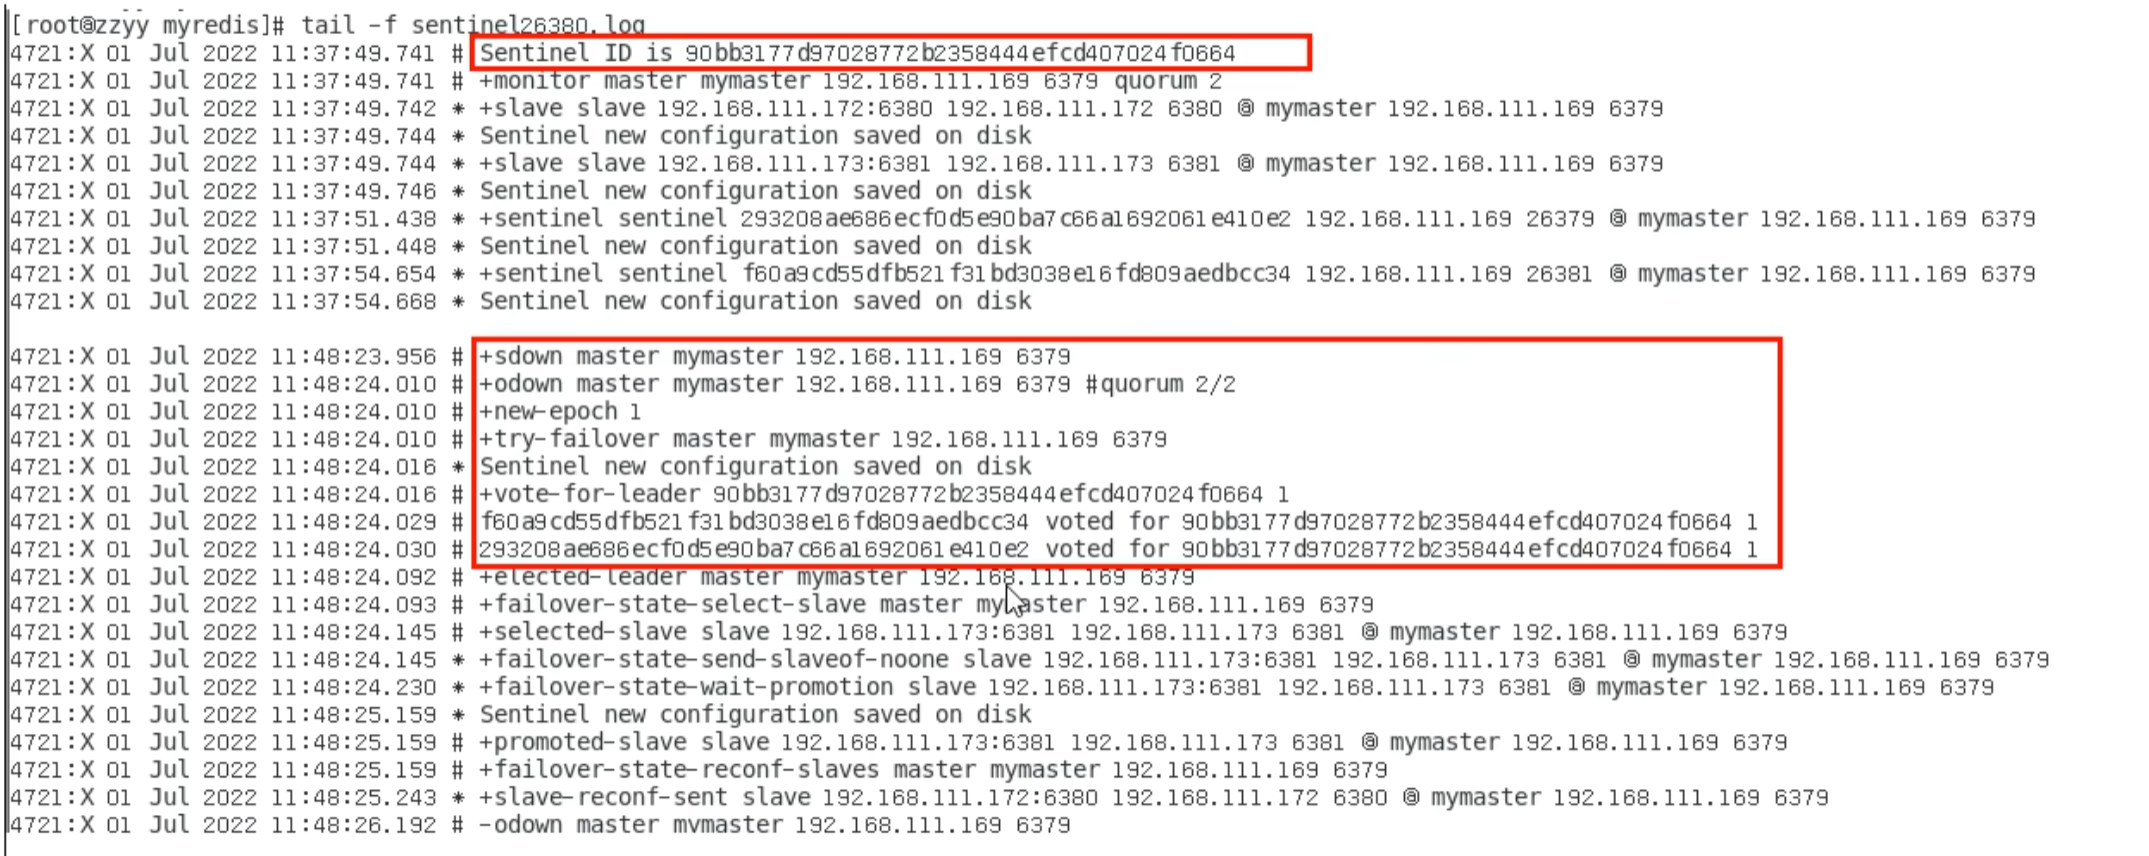
- 選舉 Raft 演算法
- 由哨兵開始推動
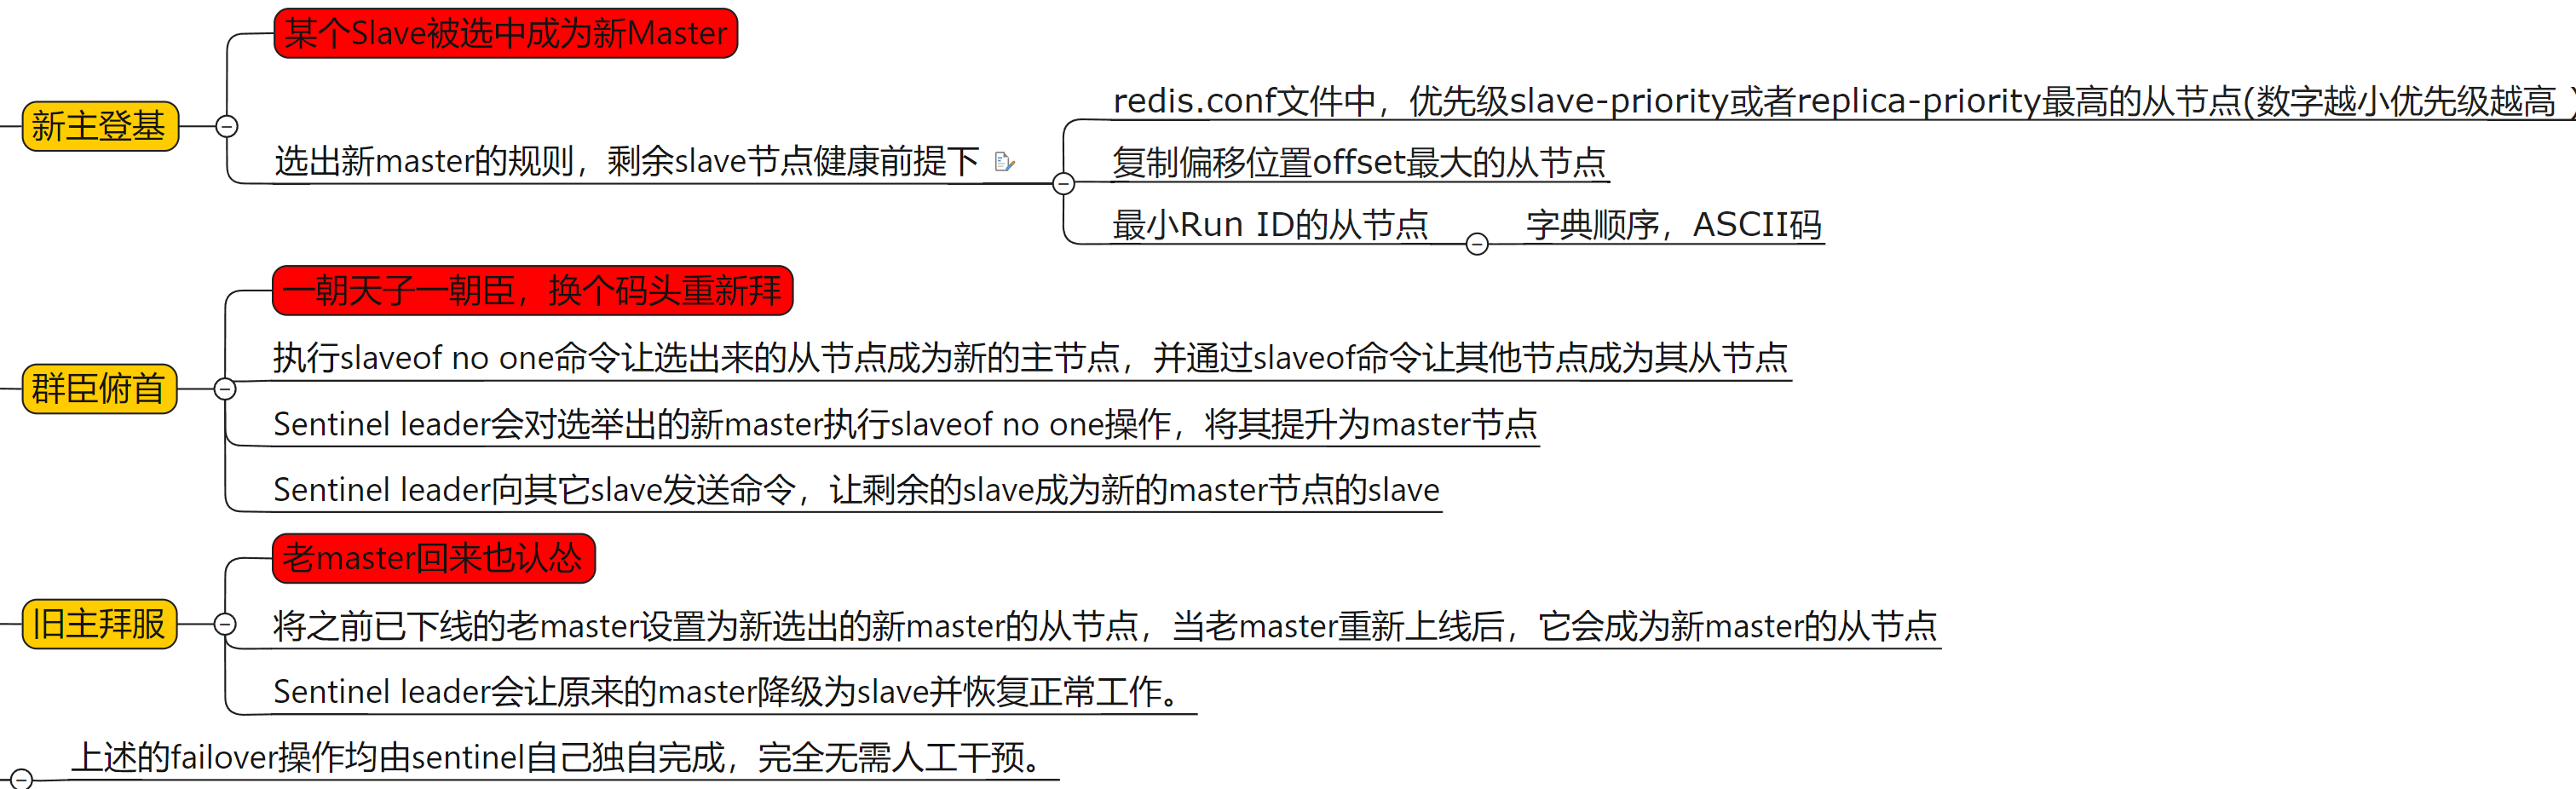
故障切換流程並選出一個新的 master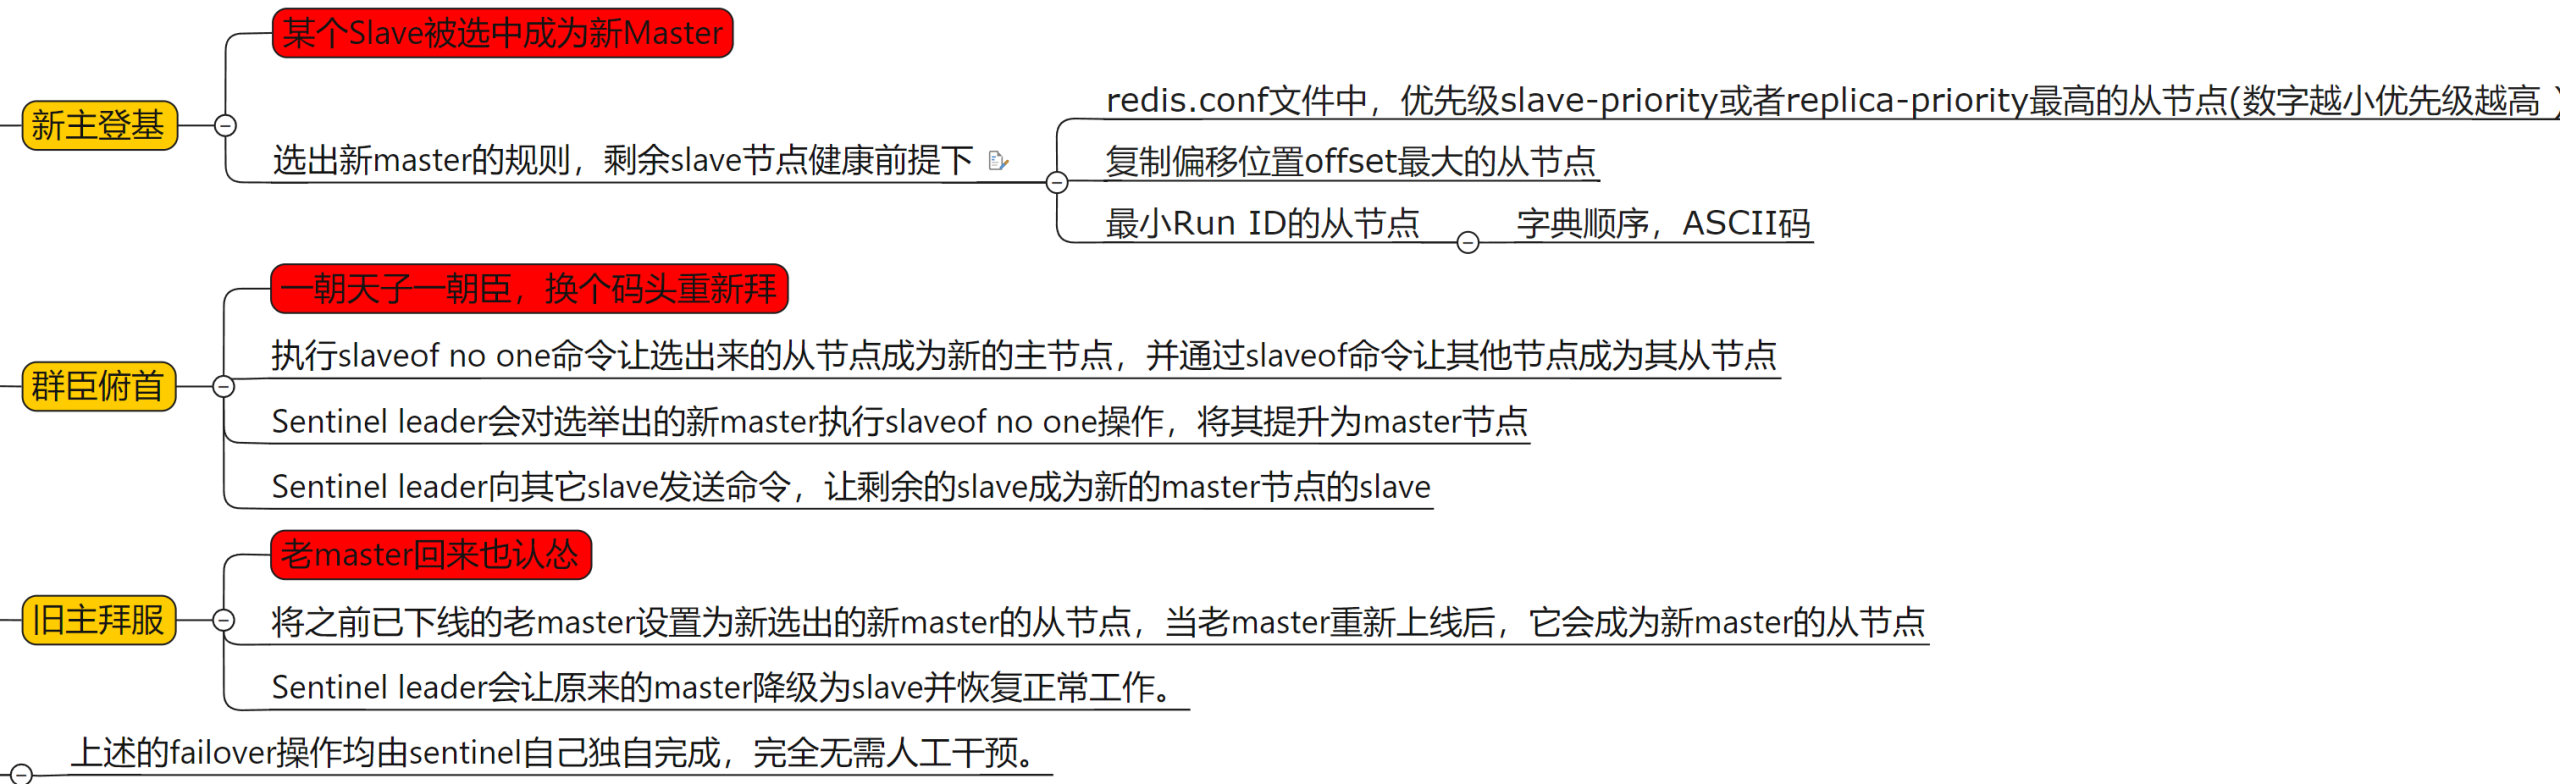
- 選出新
master

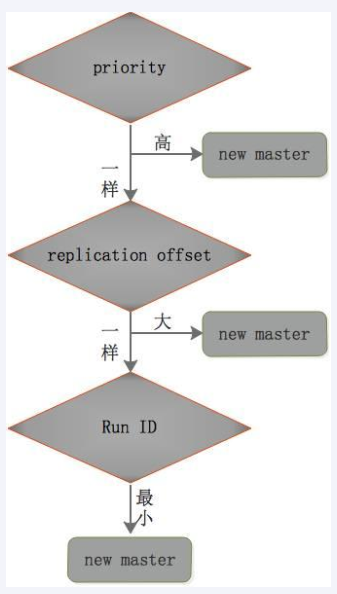
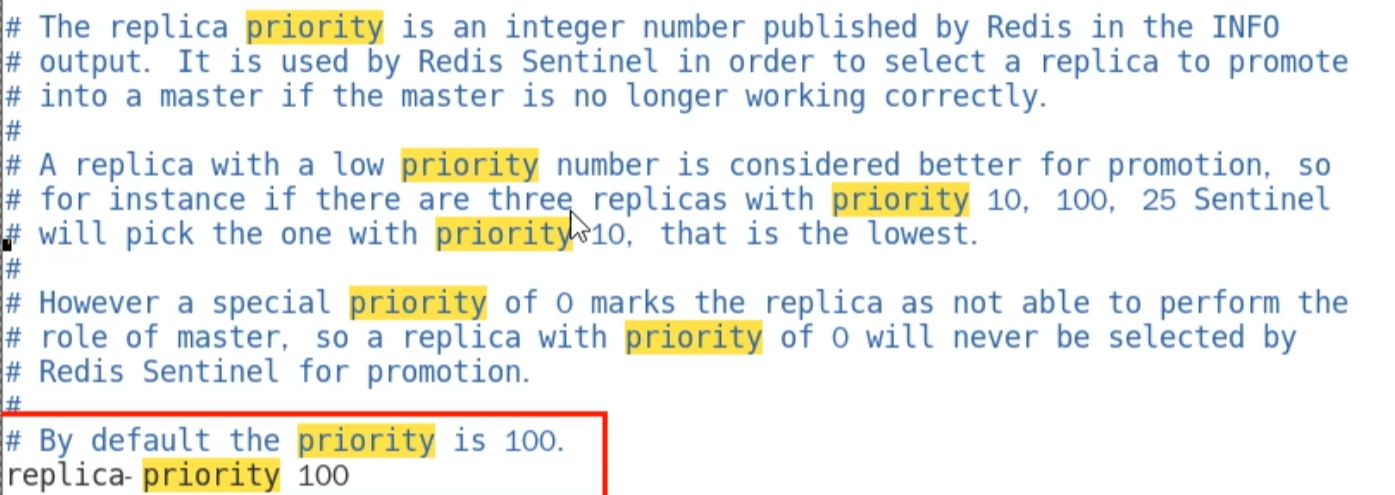 複製偏移量 (
replication offset):由於網路等原因,兩個slave不一定一樣大 2. 產生master,別的變成master的slave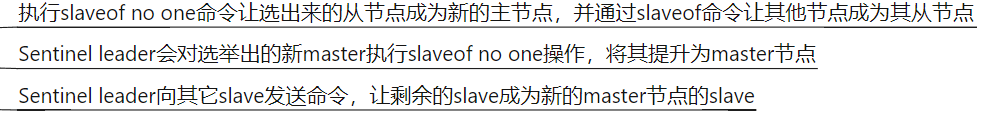 3. 將已下線的老的
master設定為新選出的 master 的從節點

- 選出新
- 由哨兵開始推動
使用建議
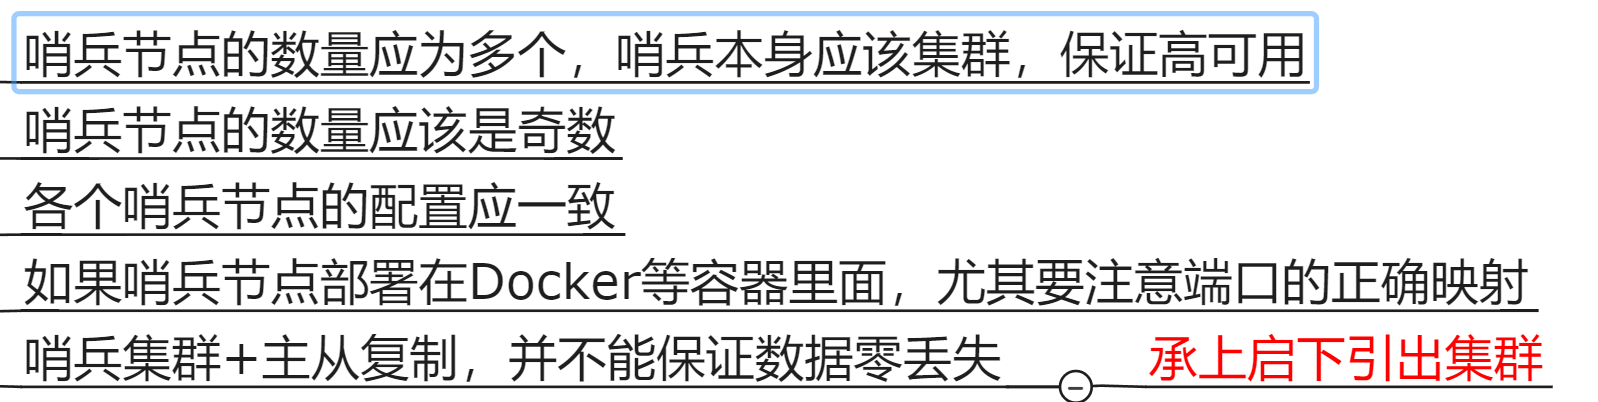
雖然能夠無人值守的故障遷移:但是選舉哨兵 leader 和產生新的 master,少說需要 5-10s,這期間的資料就會遺失
-
redis 叢集 (cluster)
redis-cli -a password -p 6385 -c
-c 進行路由傳遞

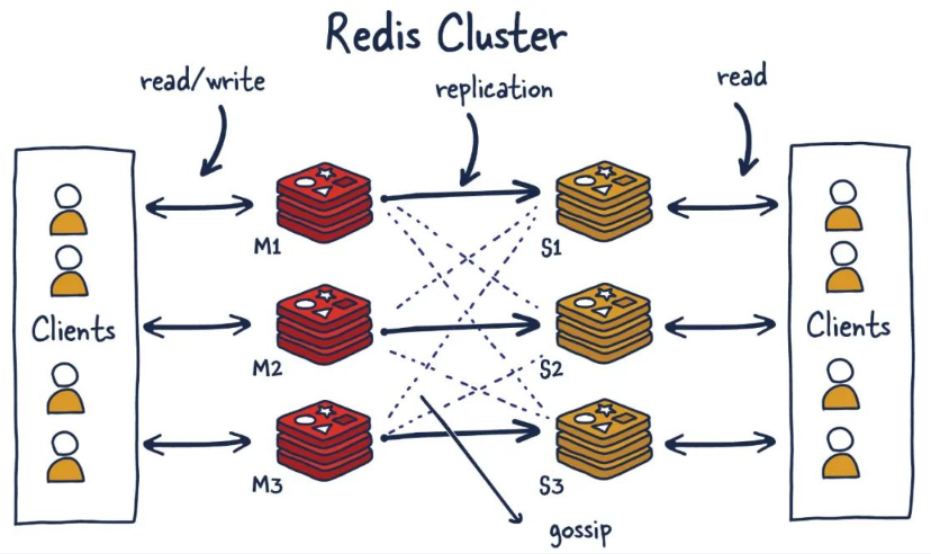
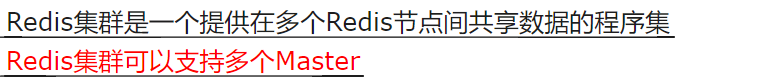
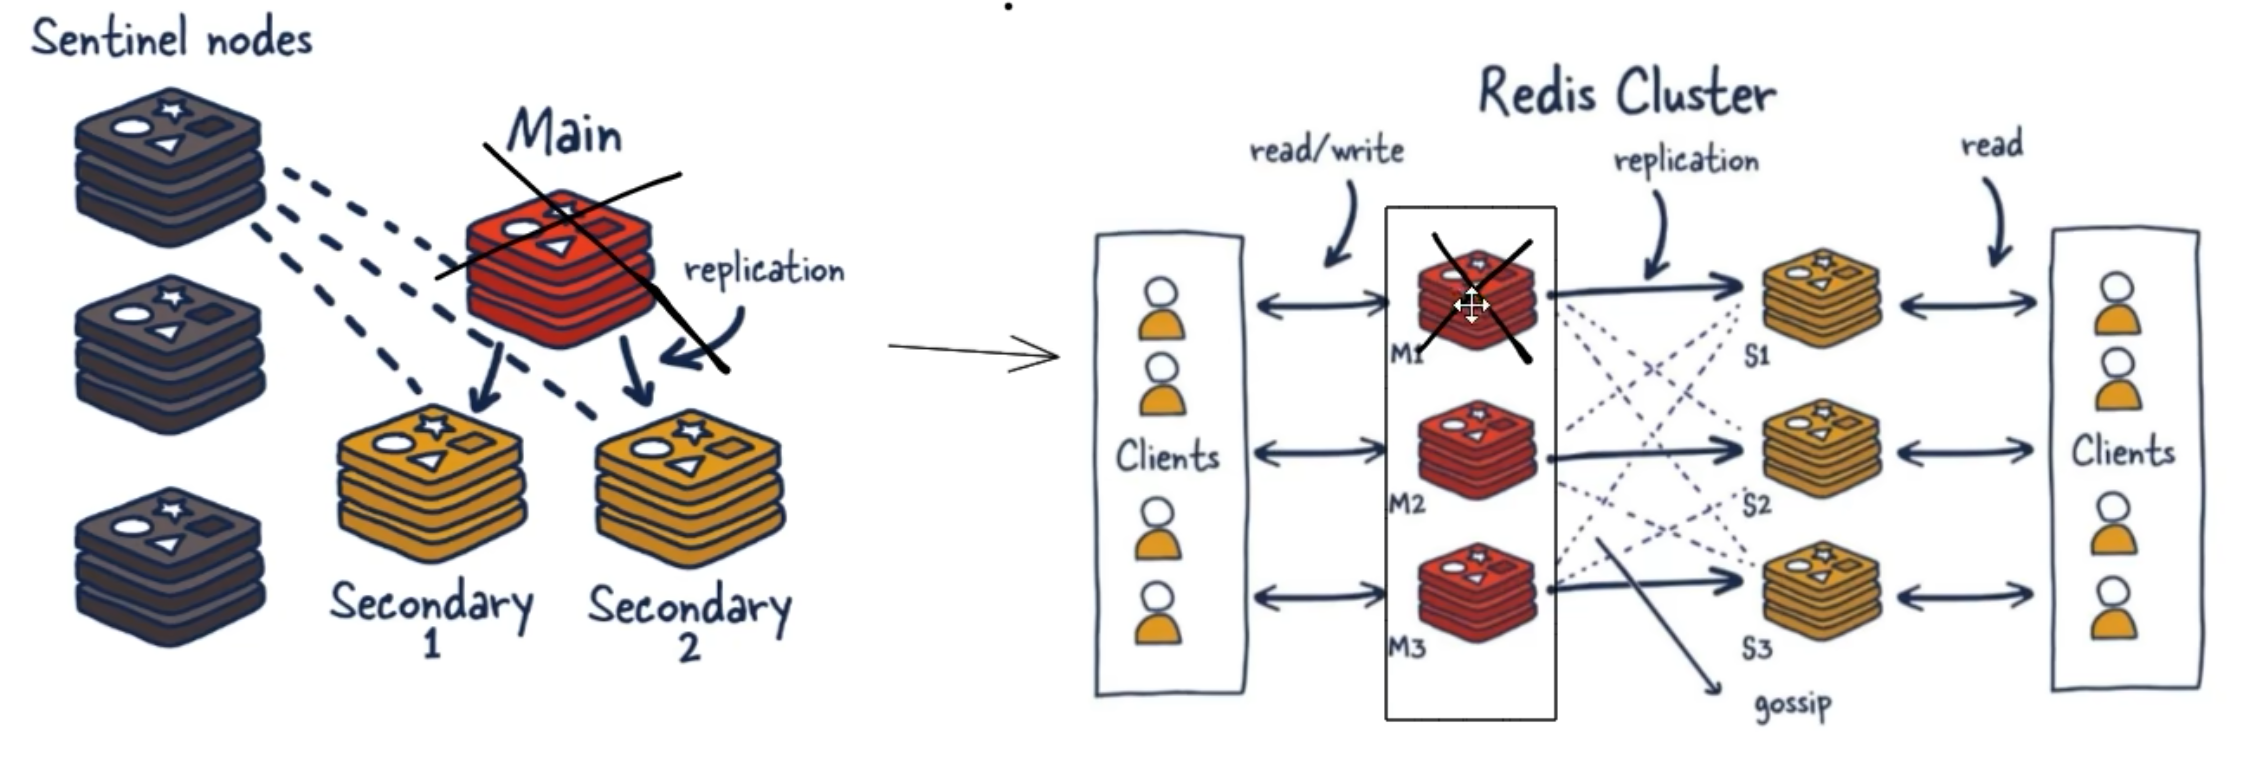 不再需要之前的哨兵
作用
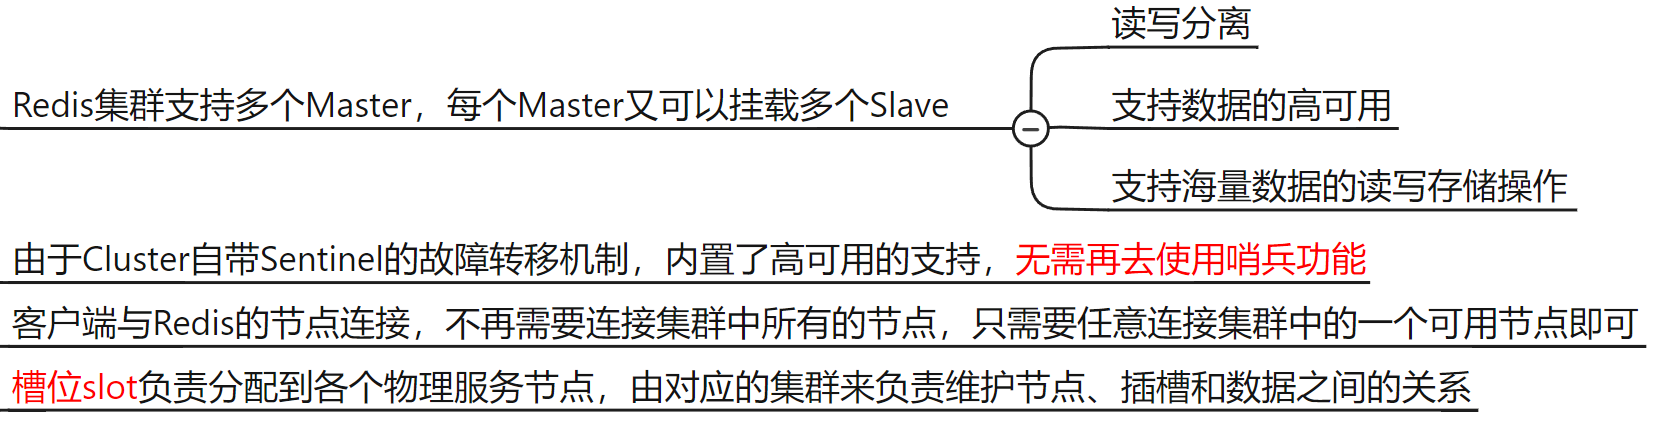
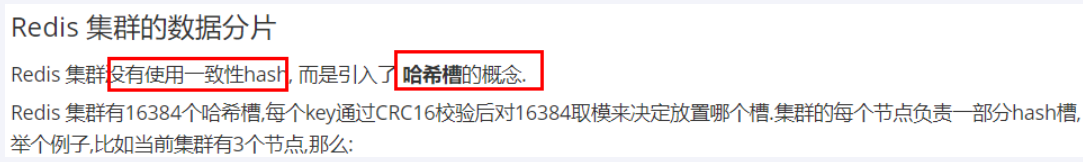
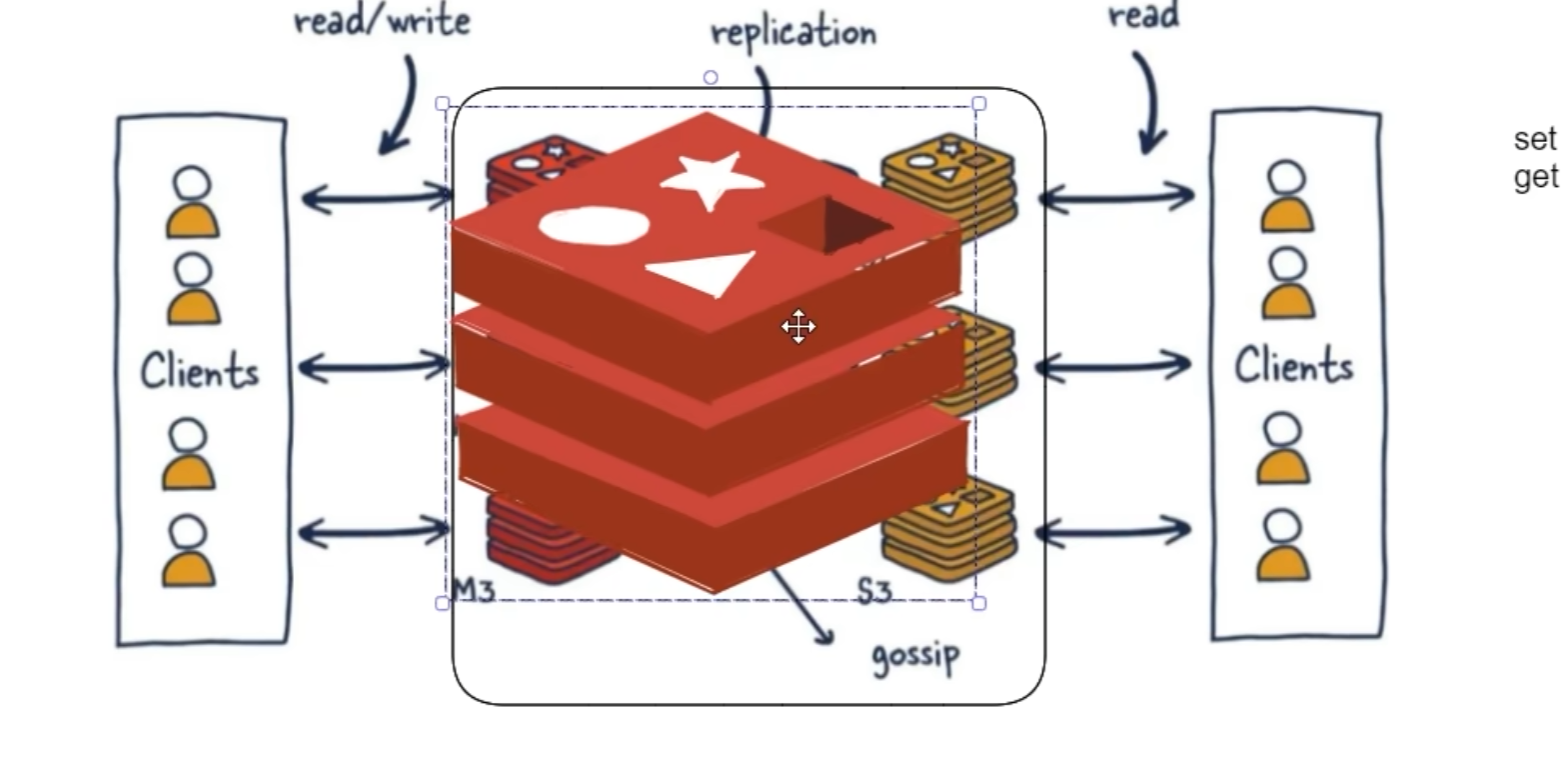
叢集演算法-分片-槽位 slot
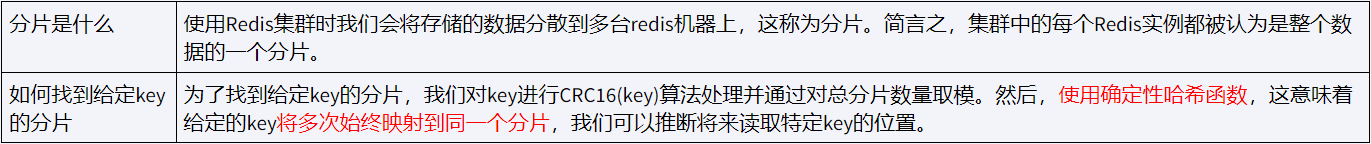
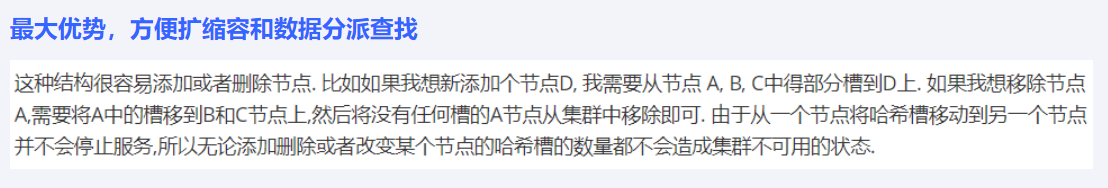
優勢
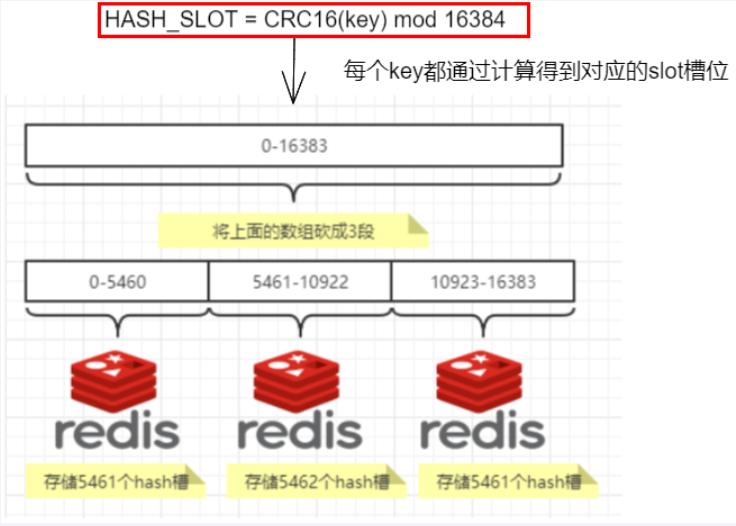 讀寫都是同一個槽位
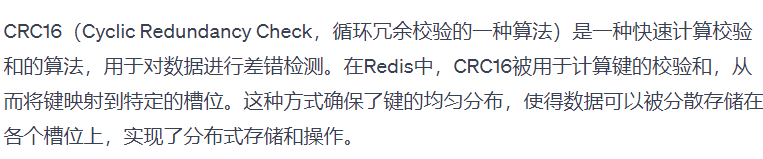
鍵值會用 CRC16 演算法進行校驗和,然後對 16384 取模,得到一個槽位的編號(如 1234 號)
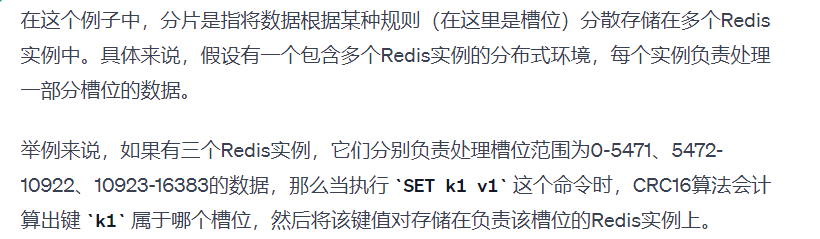
雜湊槽位映射
雜湊取餘分區
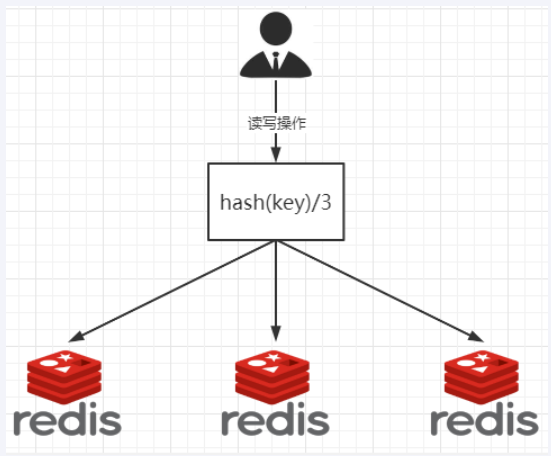
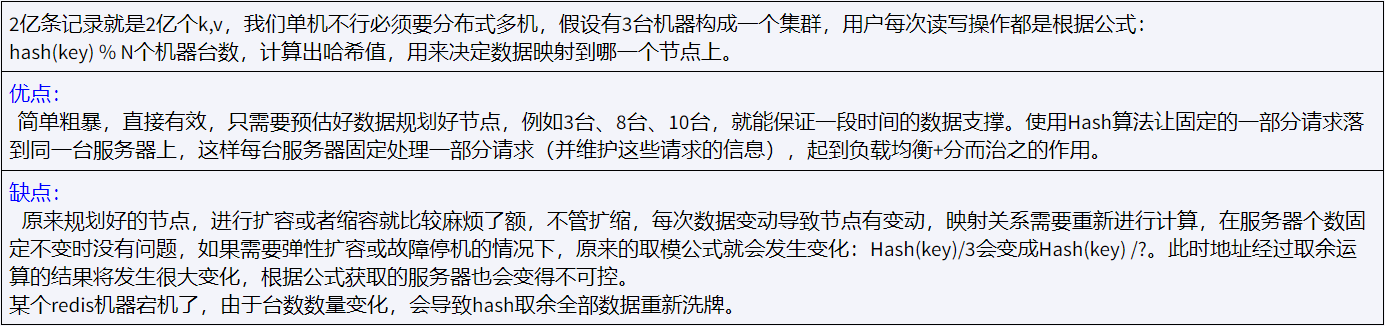
一致性雜湊演算法分區
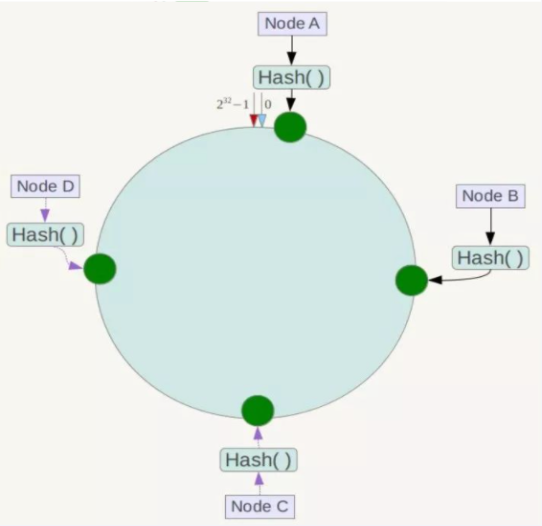
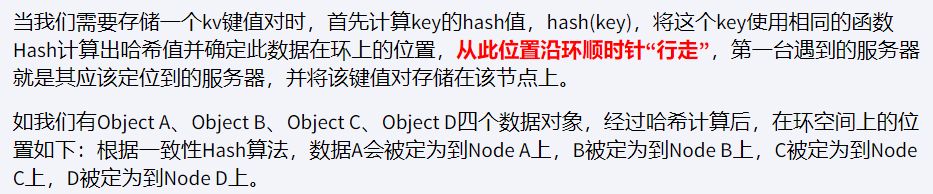
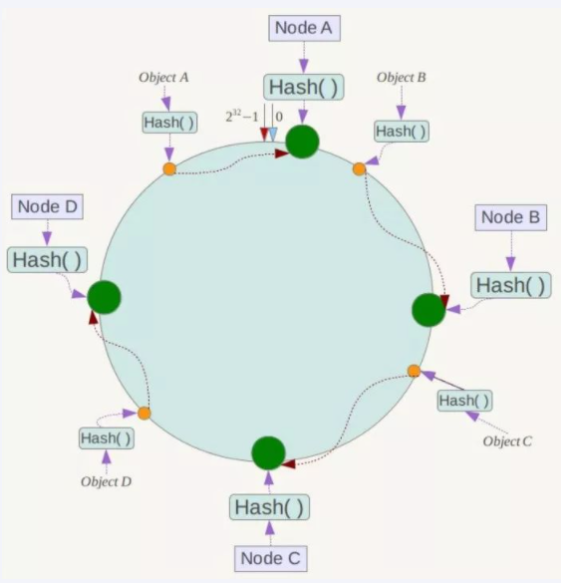
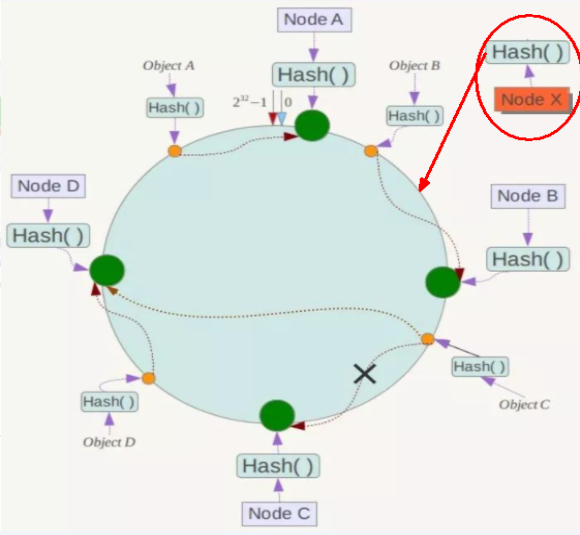
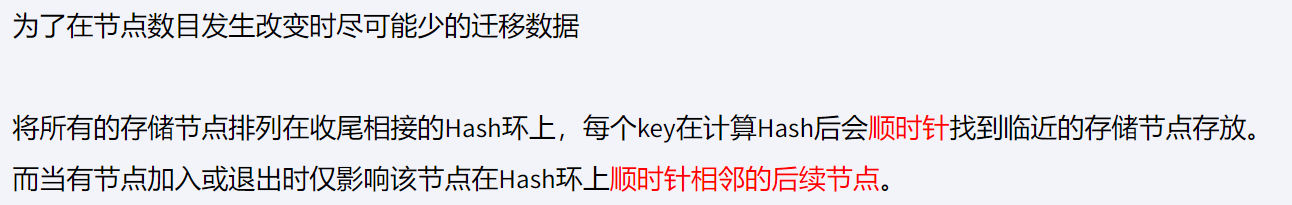
一致性雜湊演算法分區 :所有的 hash 值構成一個全量集,邏輯控制使其首尾相連形成一個閉合空間,所有雜湊值都落到環上,伺服器節點也根據雜湊落到環上,然後值會順時針找到最近的伺服器節點進行儲存
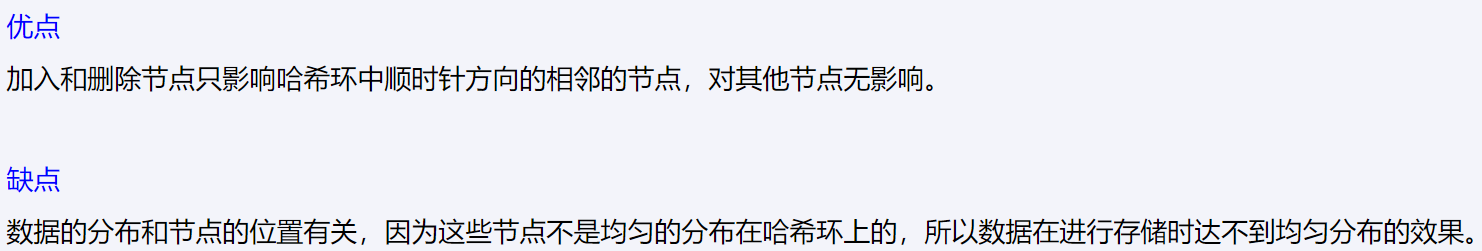
優點 : 容錯性,拓展性
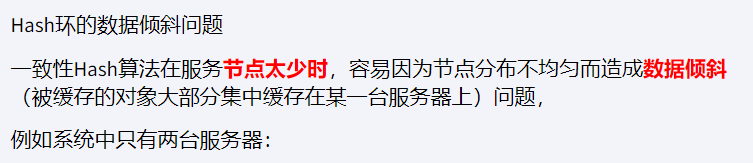
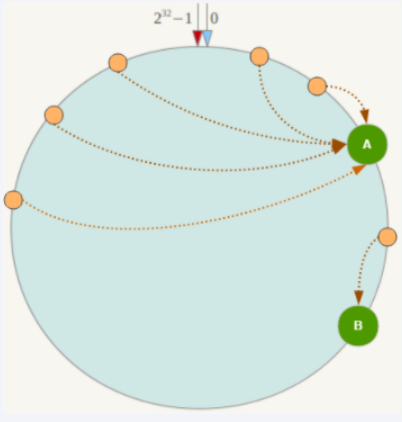
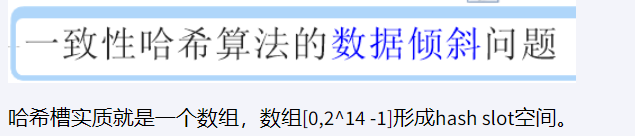
缺點: 伺服器太少時會出現資料傾斜問題
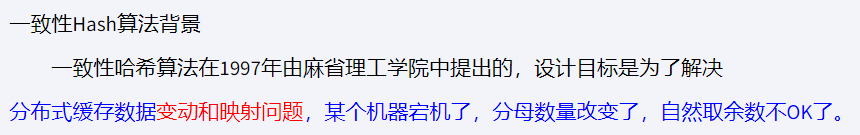 提出一致性 Hash 解決方案,目的是當伺服器個數發生變化時,盡量減少影響客戶端到伺服器的映射關係
演算法構建一致性雜湊環
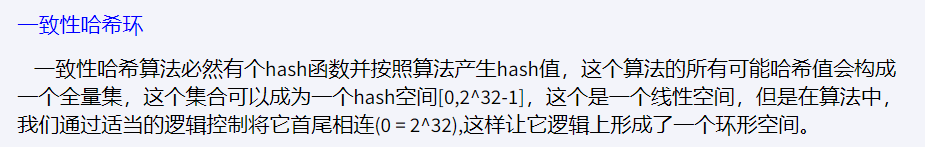
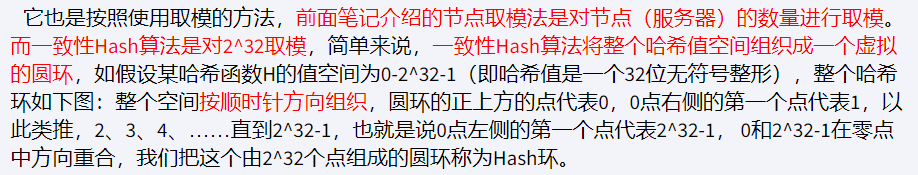
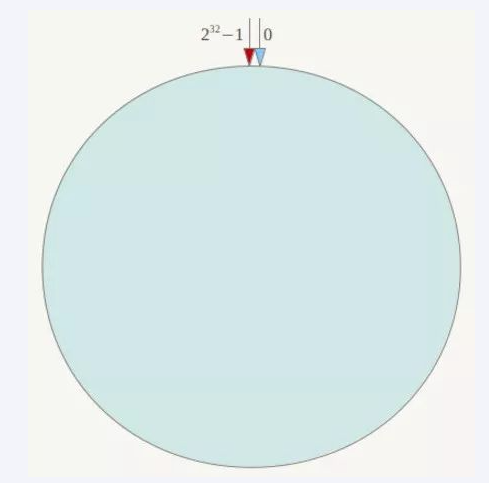
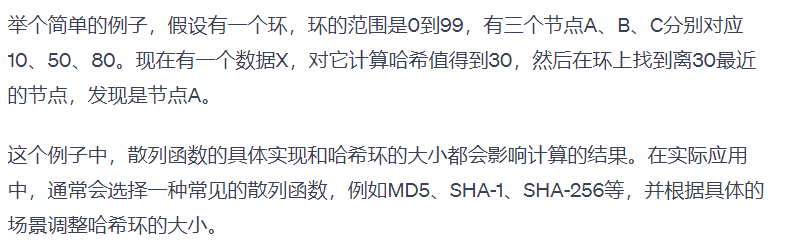
redis伺服器 IP 節點映射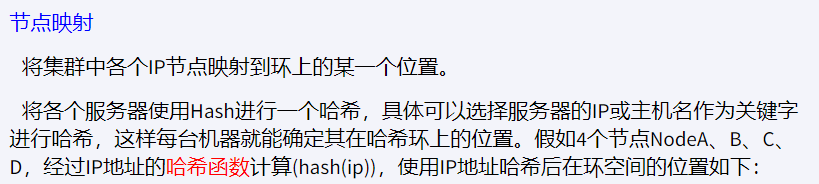
key落到伺服器的落鍵規則
優點
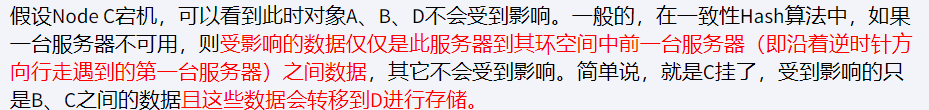
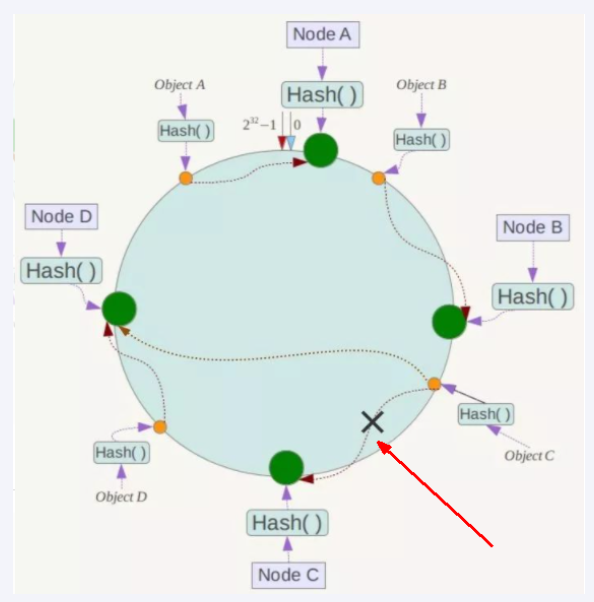
容錯性
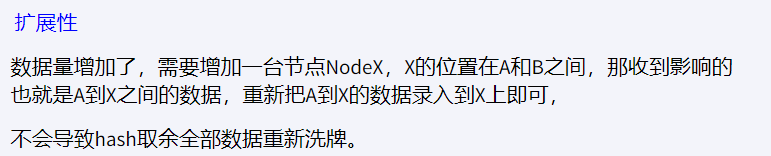
拓展性
缺點
雜湊槽分區
雜湊槽分區
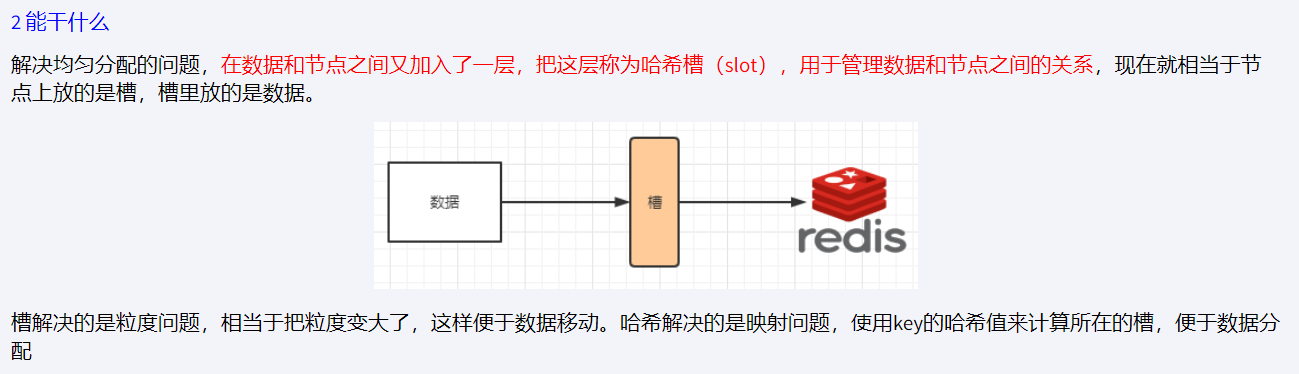
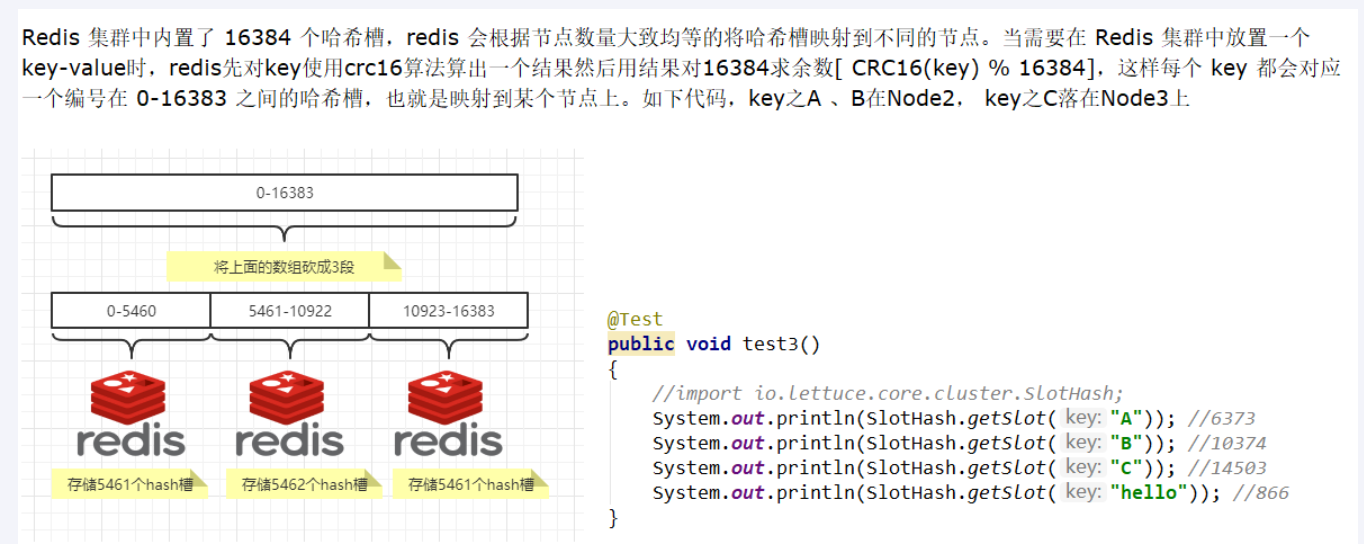
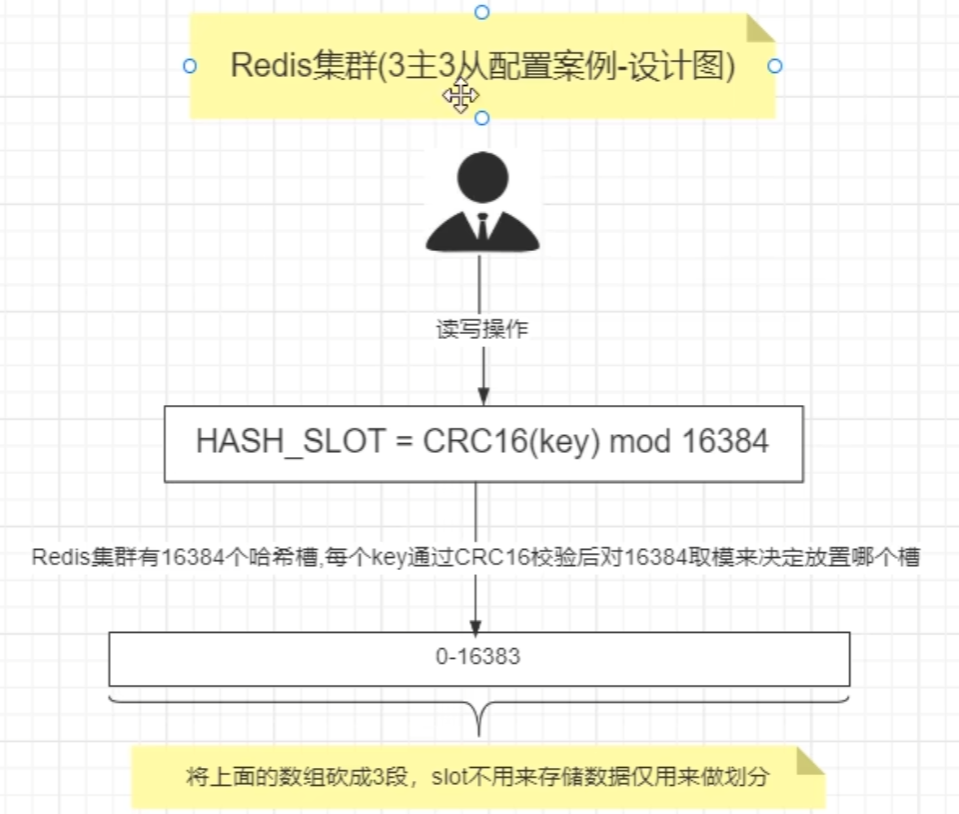
雜湊槽分區 : 在 資料 和 節點 中加了一層 雜湊槽 (16384),來管理 資料和節點間的關係, 槽 解決了粒度問題,雜湊 解決了映射問題,
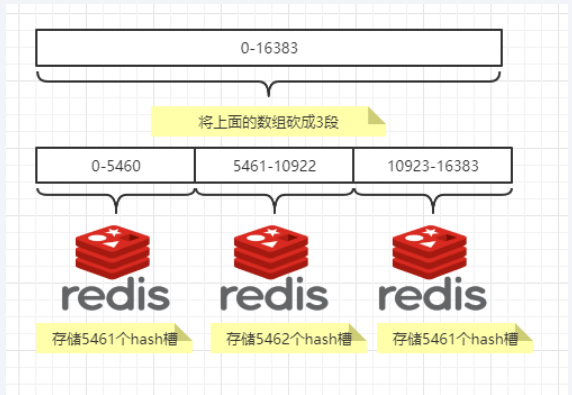
redis 會將大致相等的雜湊槽分別映射到不同節點上
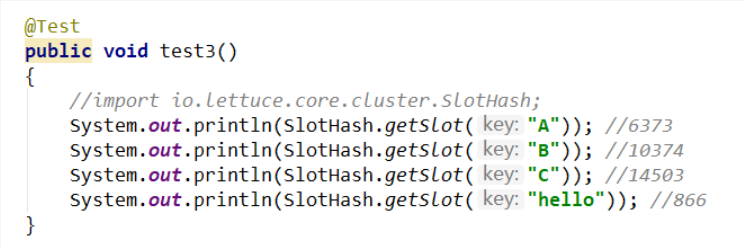
雜湊值對 16384 取模,餘數是幾落到對應的槽裡
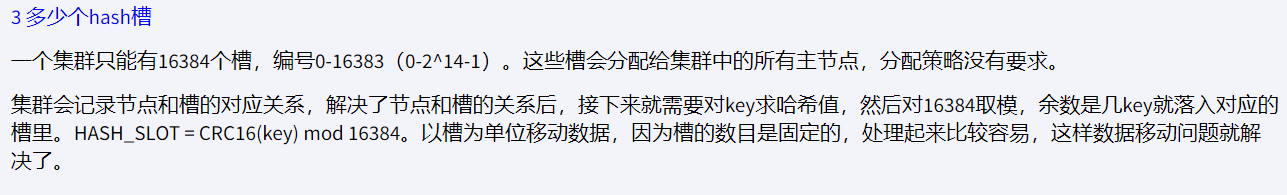
HASH_SLOT= CRC16(key) mod 16384
- 雜湊值計算
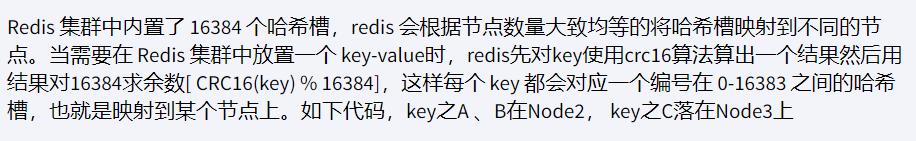
為何 redis 叢集最大槽數是 16384 個
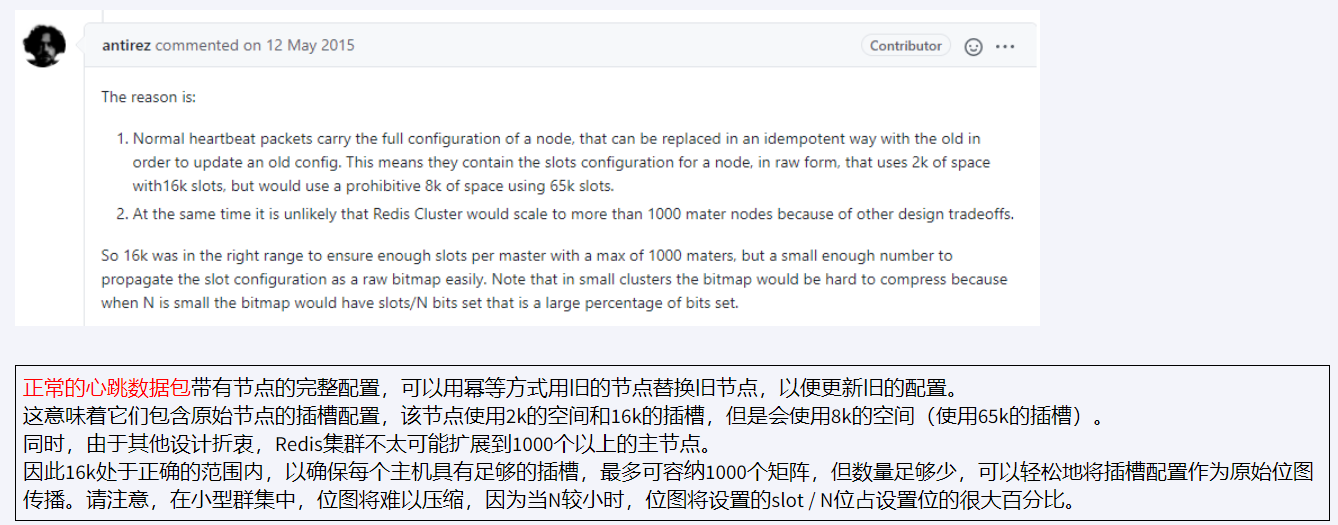
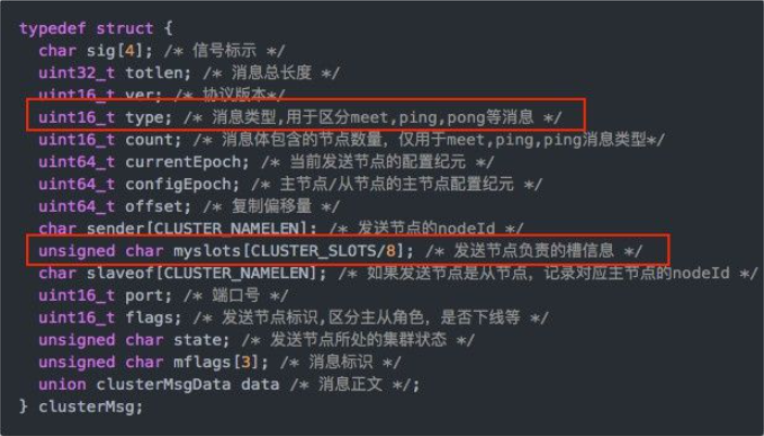
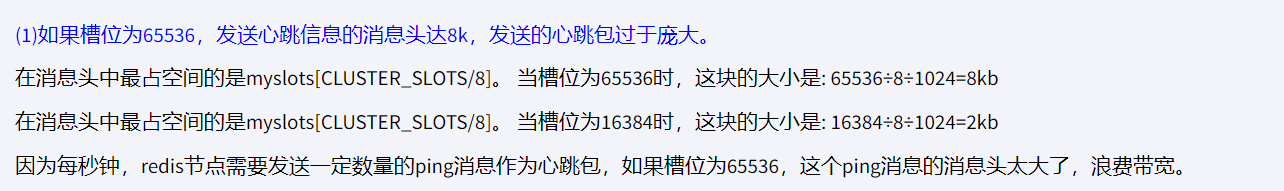


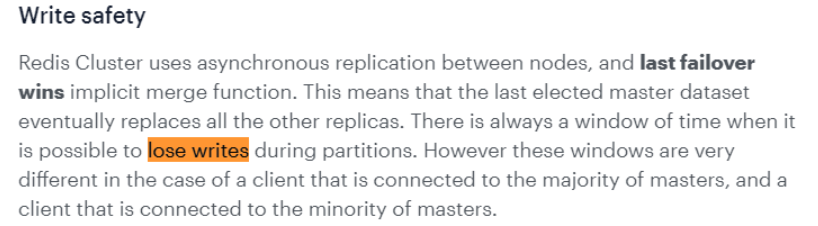
redis 叢集不保證強一致性,在特定條件下,redis 叢集可能會丟掉一些被系統收到的寫入請求命令
叢集環境搭建步驟
三主三從 redis 叢集配置
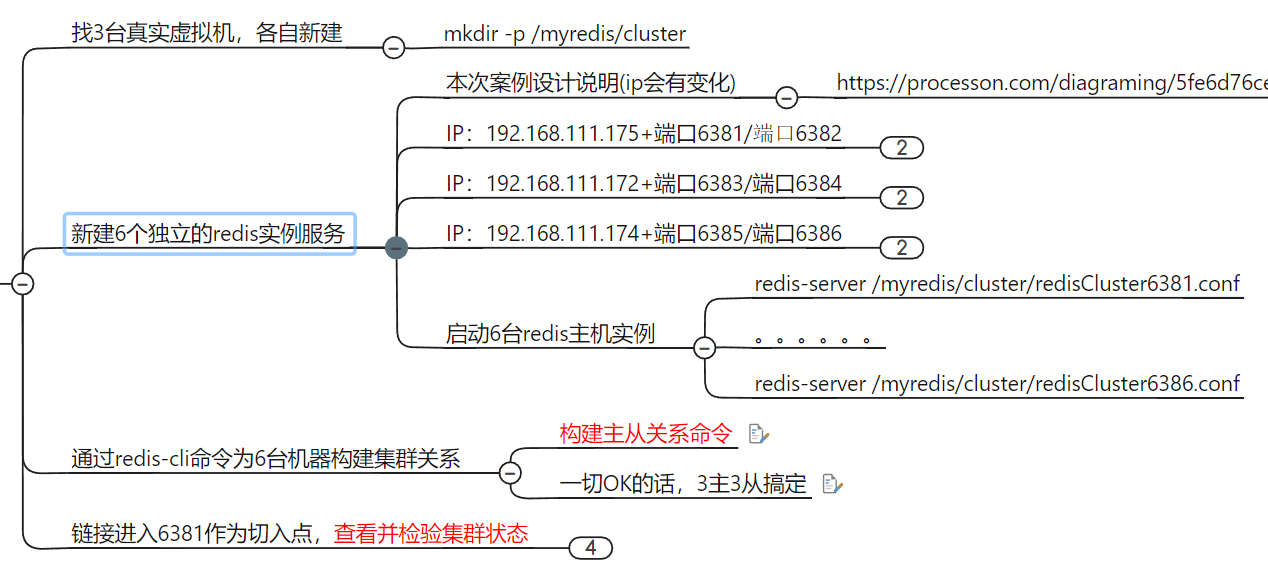
1. 新建6個配置目錄 mkdis -p /myredis/cluster
2. 配置6個設定檔
3. 構建主從關係
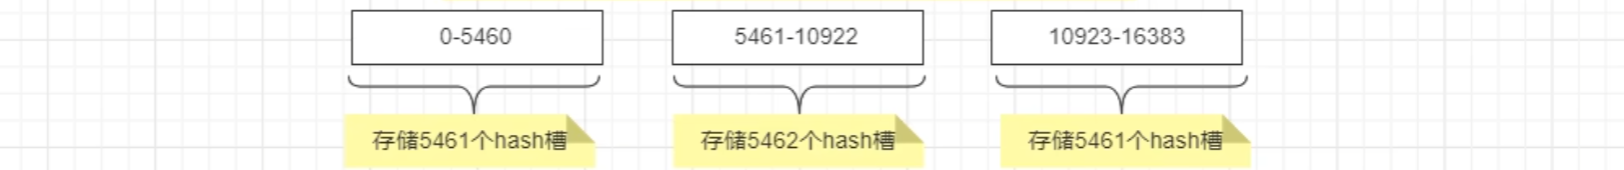
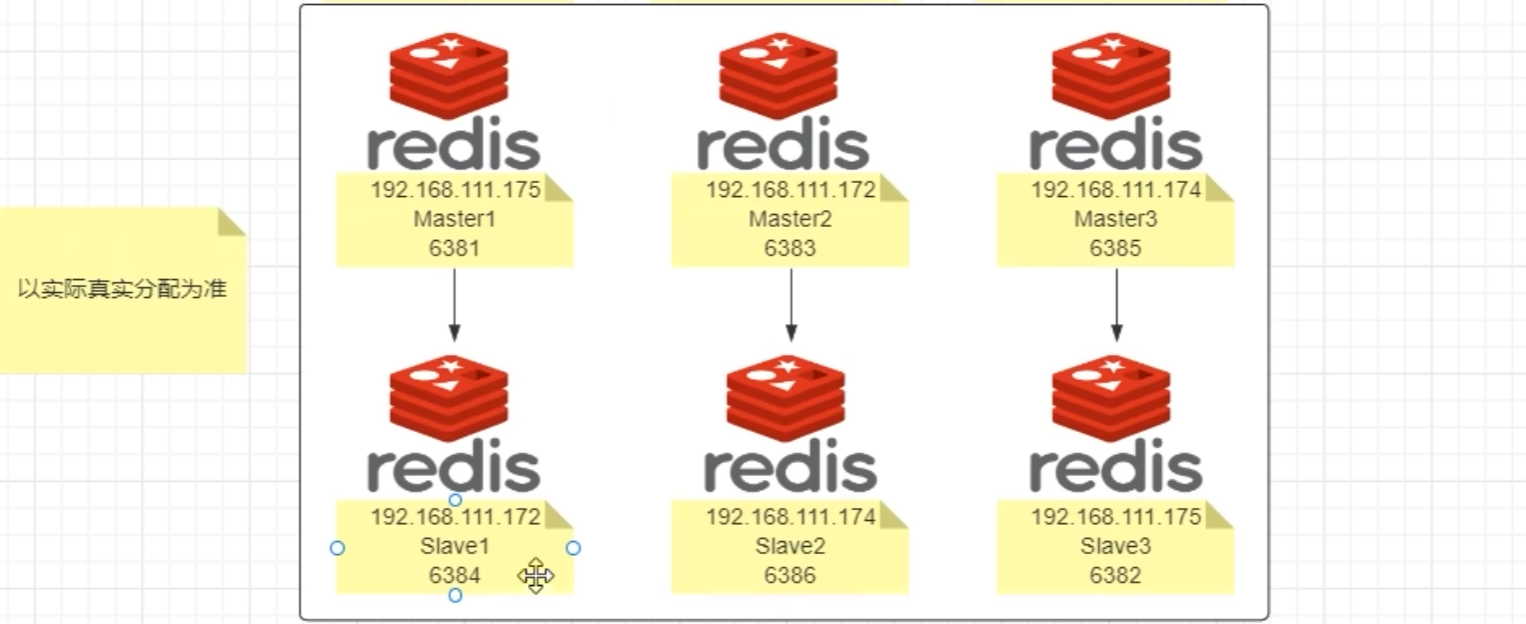 不一定按照寫的分配, 以實際分配為準
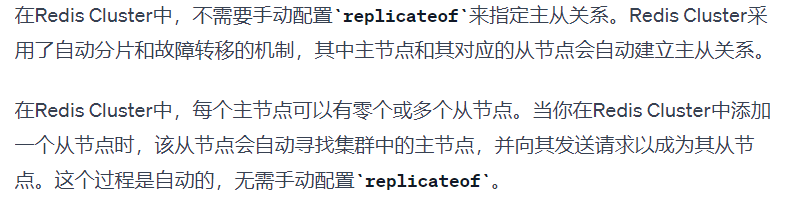 主,從的設定檔完全一樣,如下(影片 6 台設定檔全部都是下面內容)
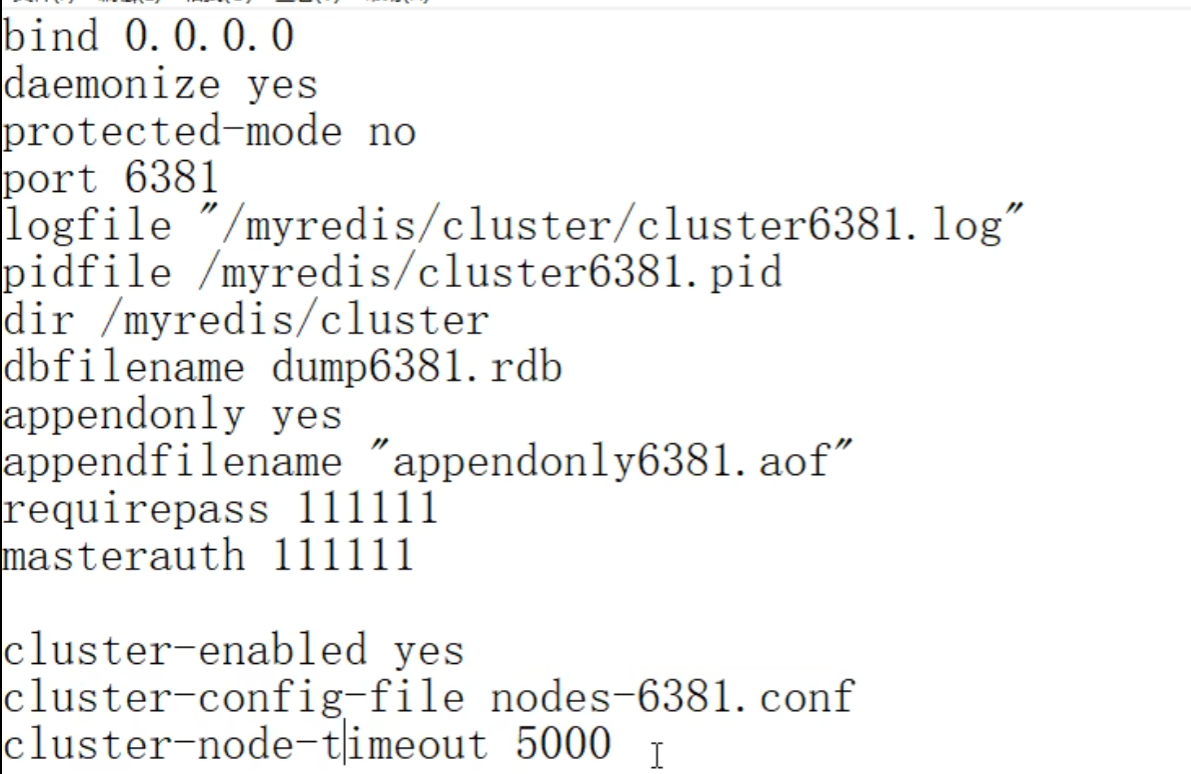
5000ms = 5s
3.構建主從關係
不一定按照寫的分配, 以實際分配為準
redis-cli -a password --cluster create --cluster-replicas x
ip1:port1 ip2:port2 ip3:port3 ip4:port4 ip5:port5 ip6:port6


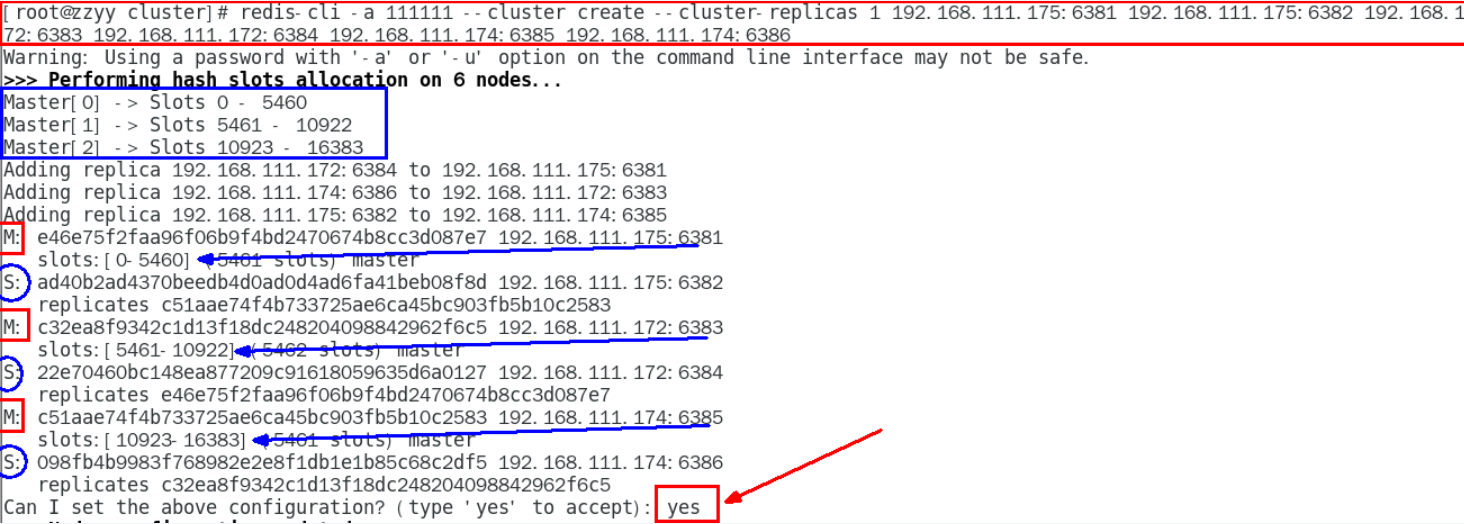
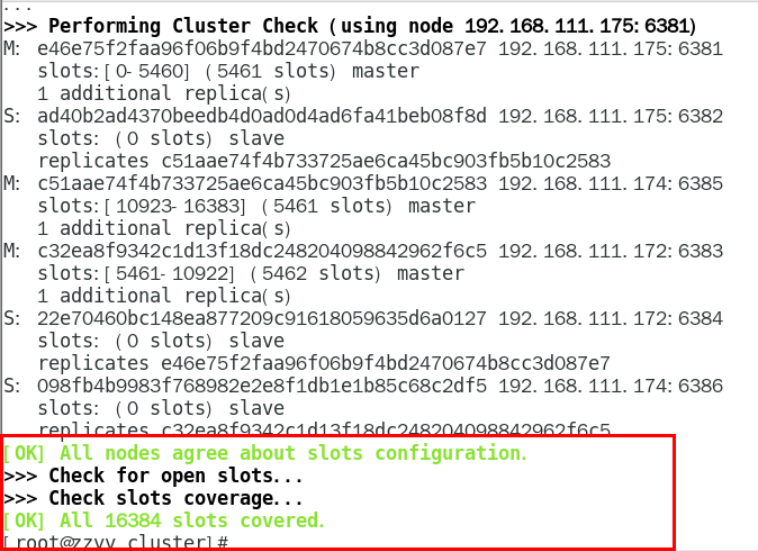
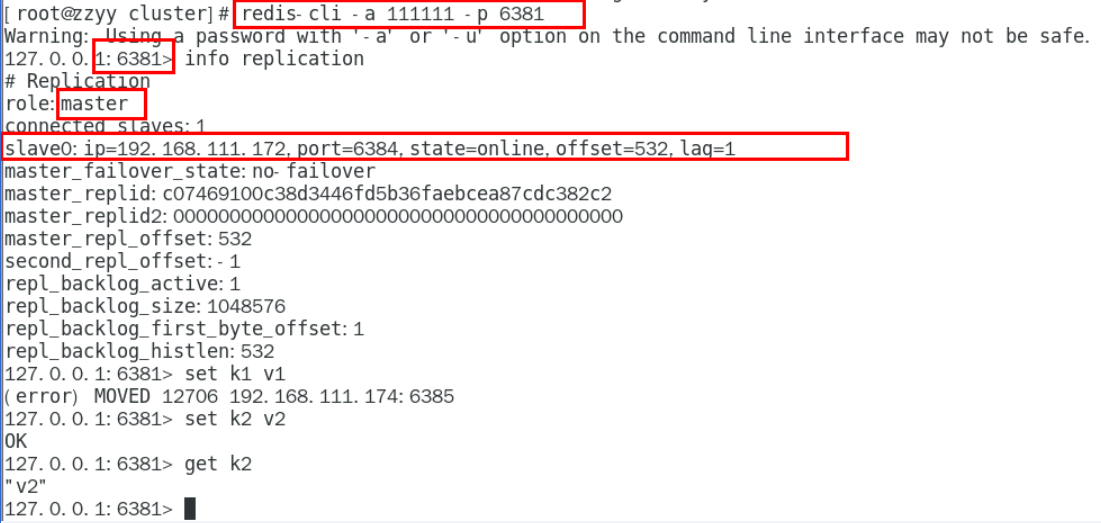
以 6381 為切入點,查看並檢驗叢集關係
info replication
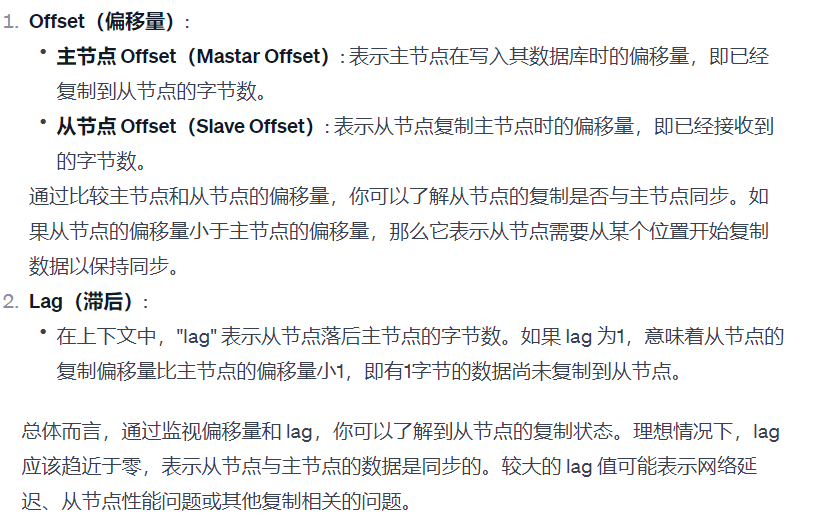
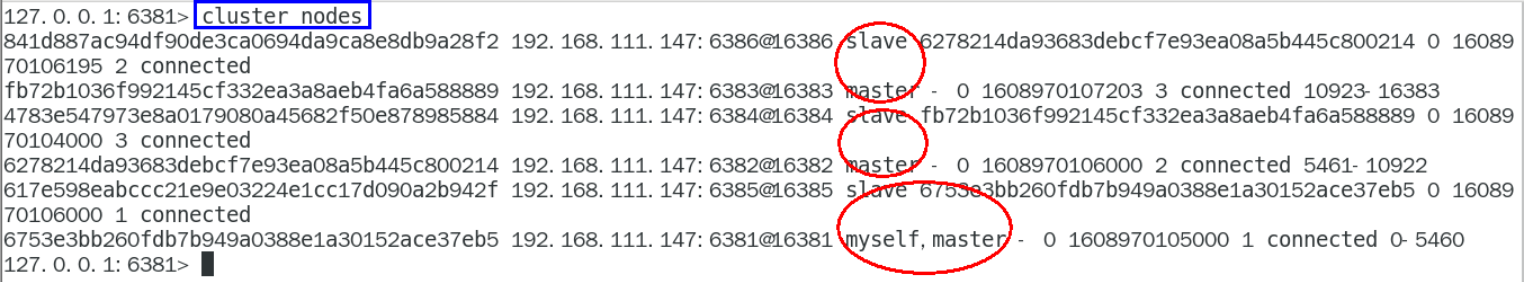
cluster nodes
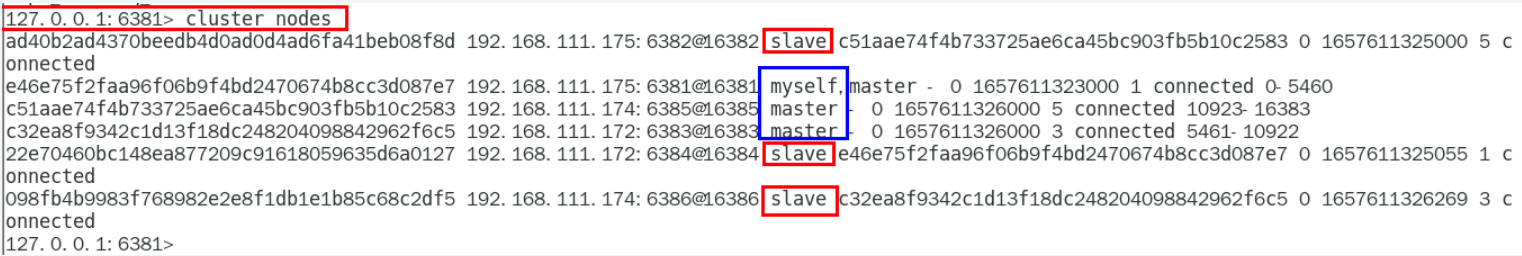
三主三從 redis 叢集讀寫
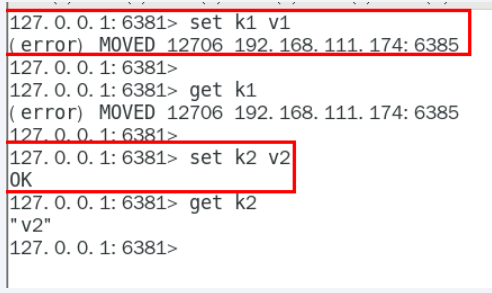
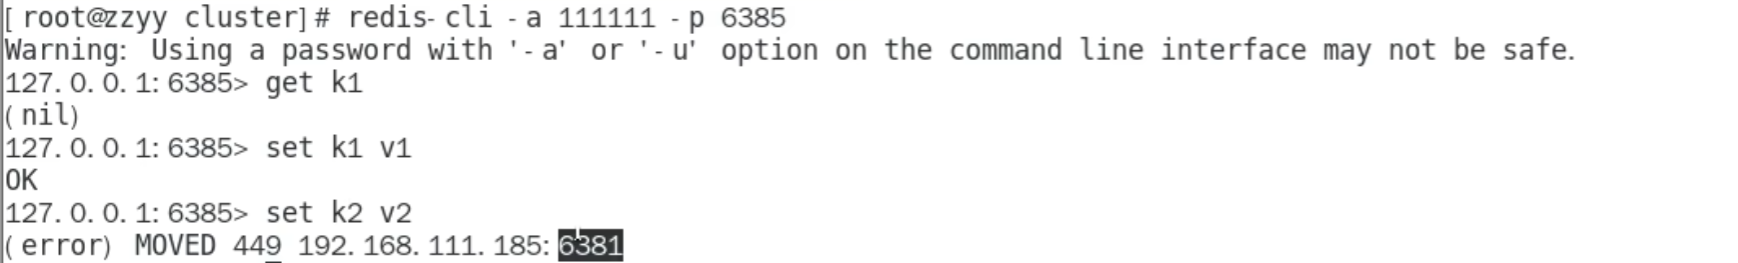 由於槽位的限制,不再是想怎麼存就怎麼存,需要路由到位
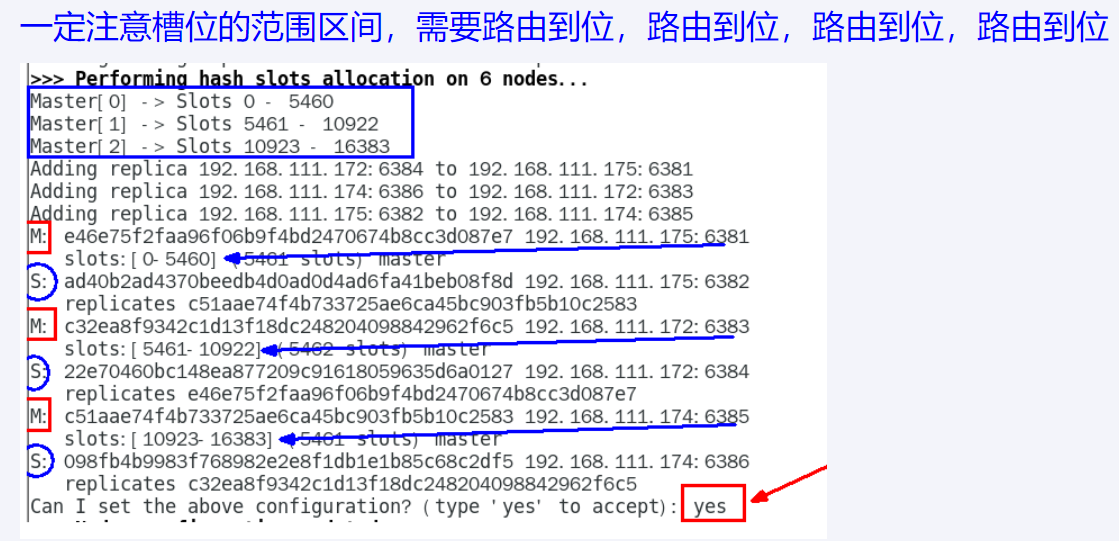
 內部由於有 CRC16 和重定向演算法
k1 被重定向到另一個槽位
連接叢集需要加 c, 這樣連接的是大redis
redis-cli -a password -p 6385 -c
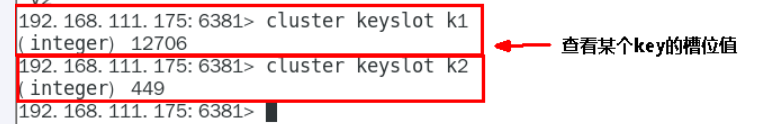
cluster keyslot 鍵
查看某個 key 的槽位值
主從容錯切換遷移案例
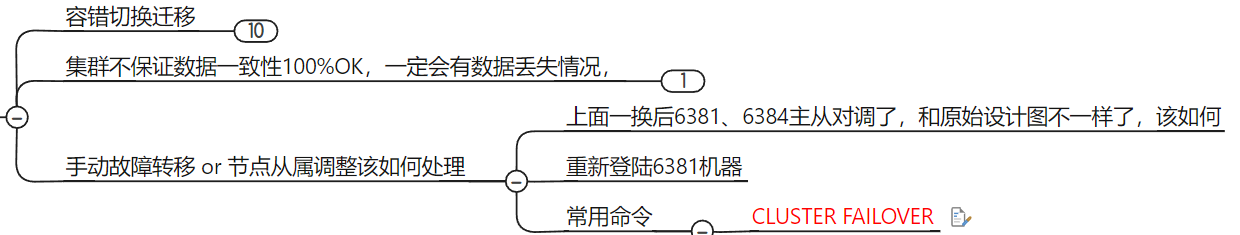
master 掛後 slave 會自動上位,即使之前 master 重新回歸,也會變成slave
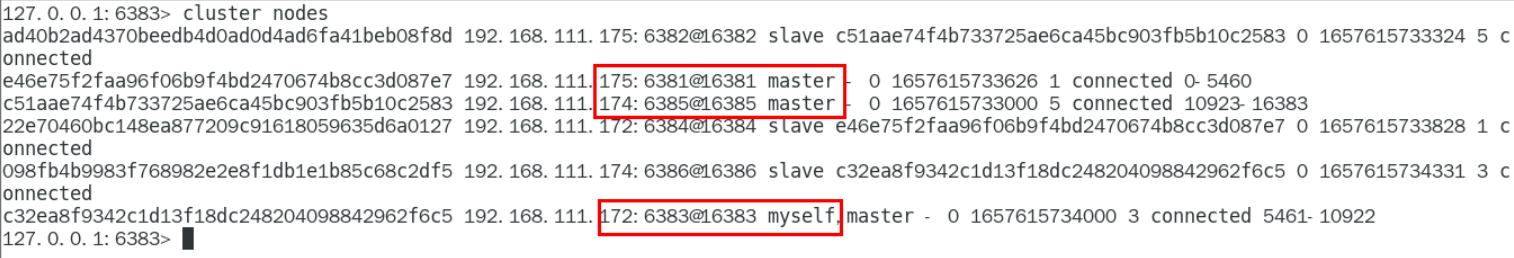
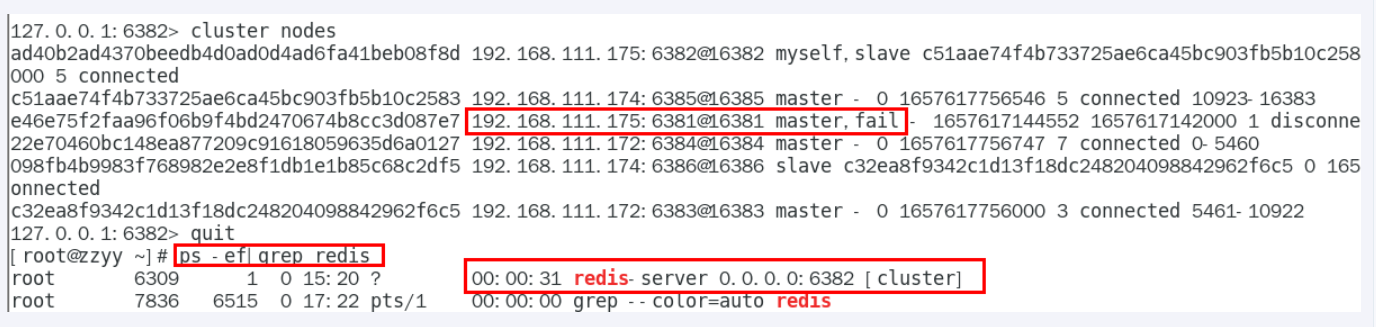 恢復後變成slave
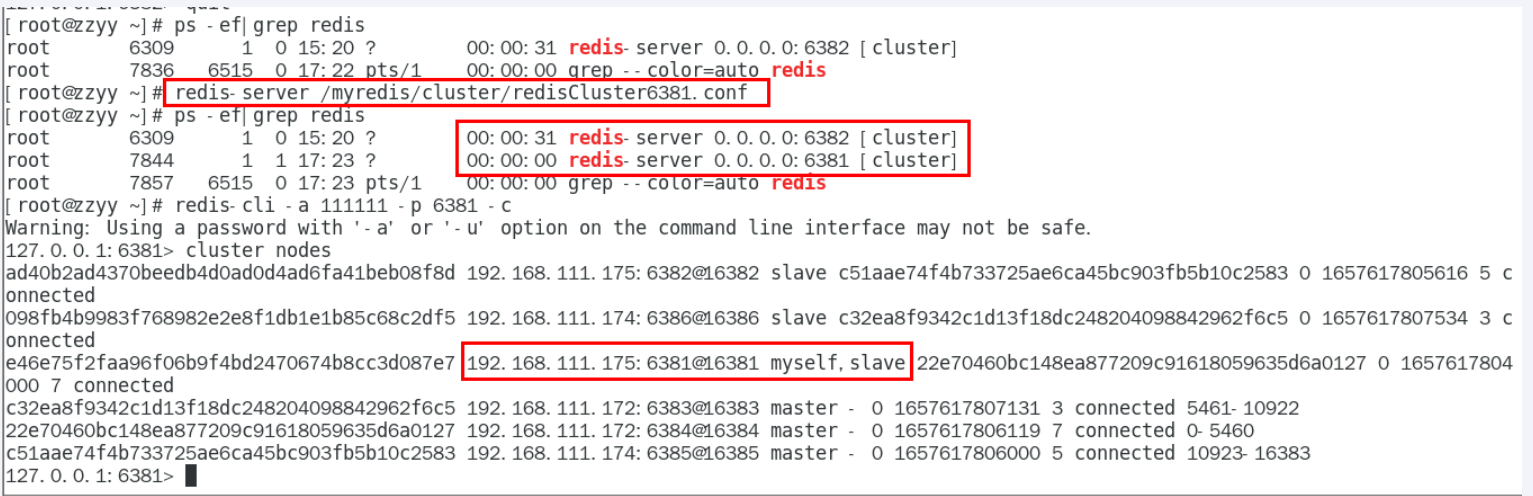
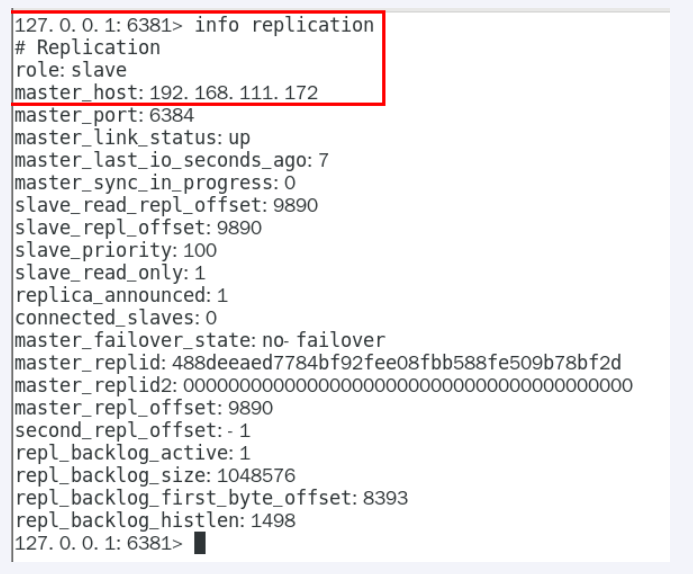
手動故障轉移 or 節點從屬調整
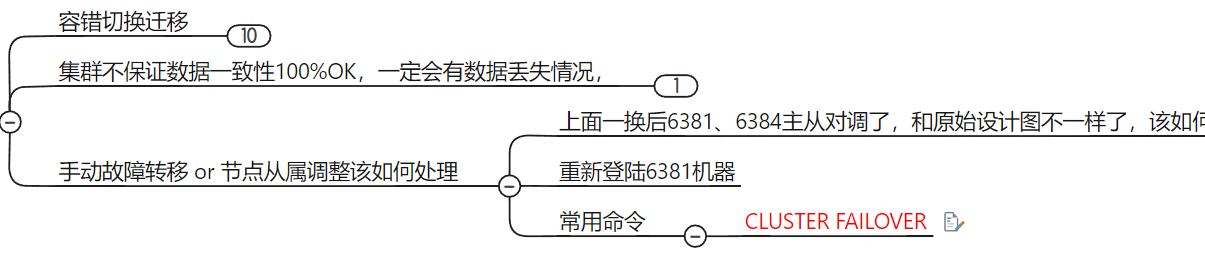
CLUSTER NODES
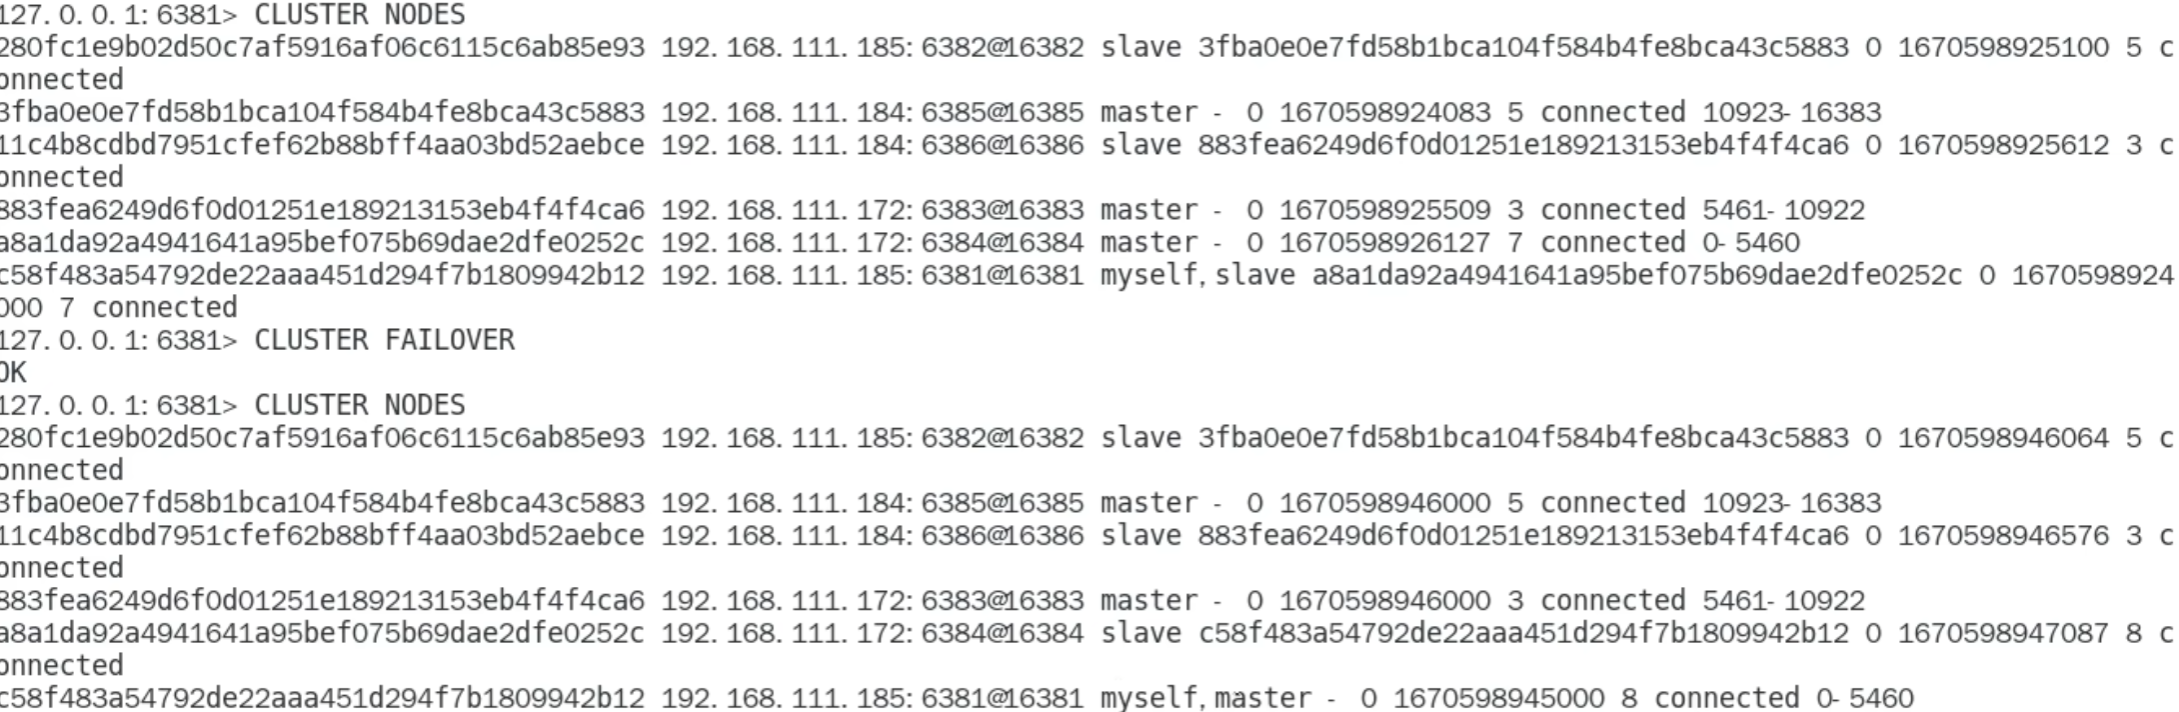 將之前的 master 恢復後還變成 master
主從擴容案例
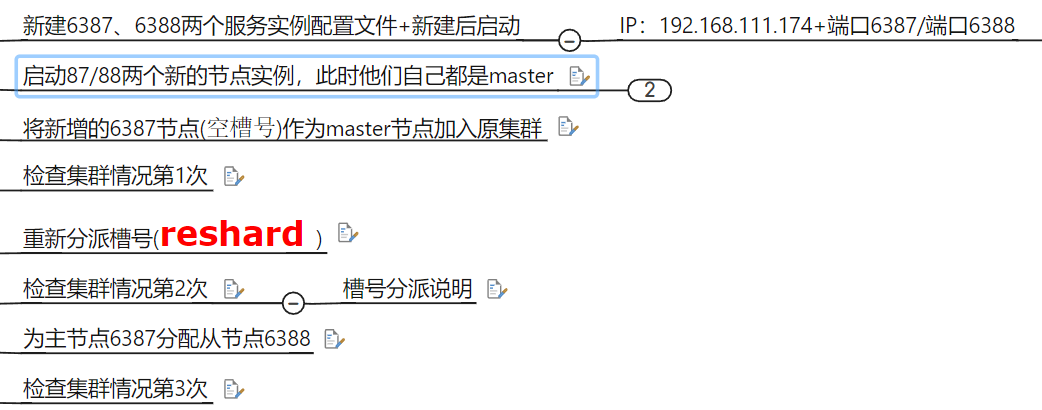
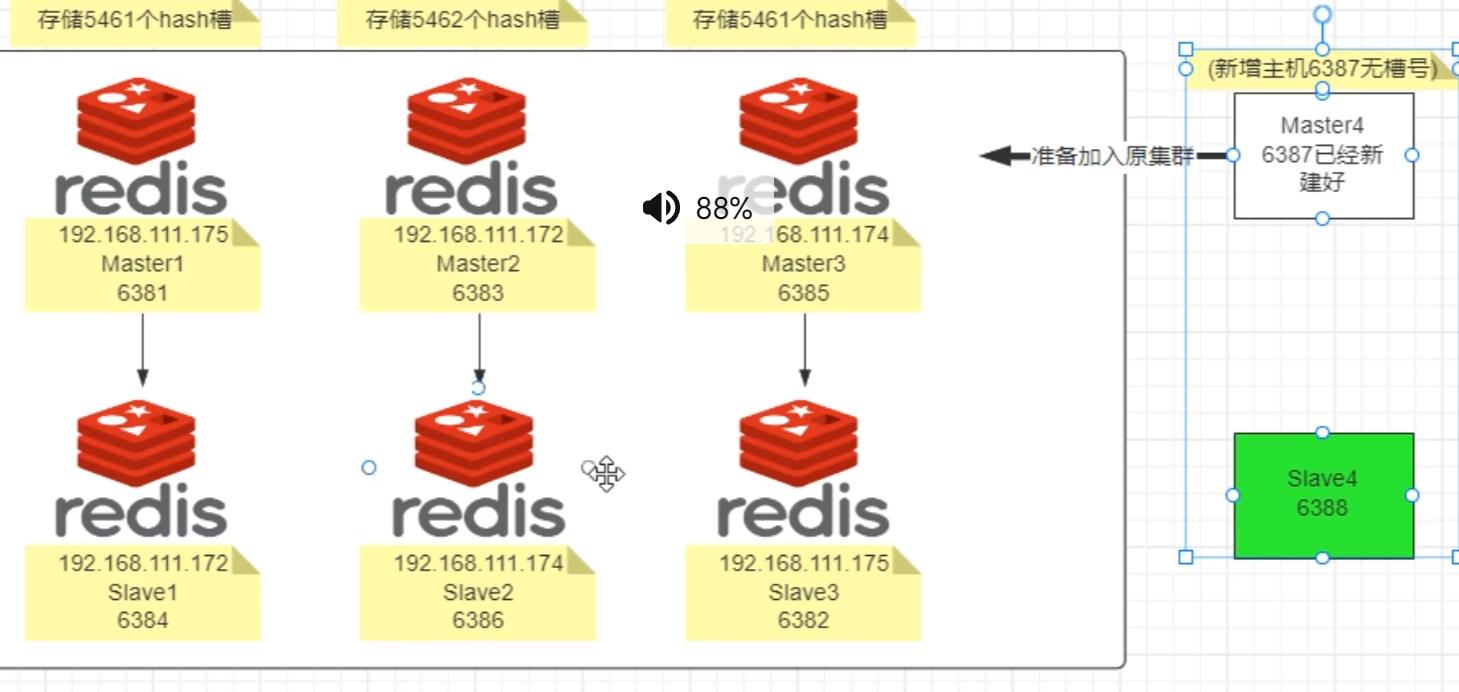
新增
redis-cli -a password --cluster add-node ip1:port1 ip:portip1:port1是新加的位址ip:port是已有的位址 加入後不會被分配槽號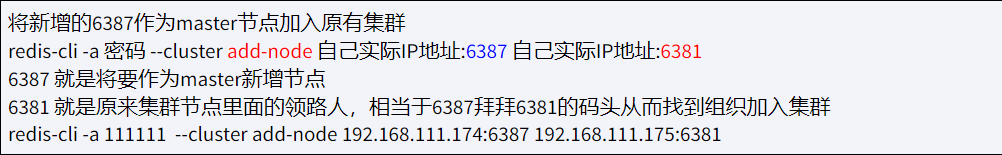
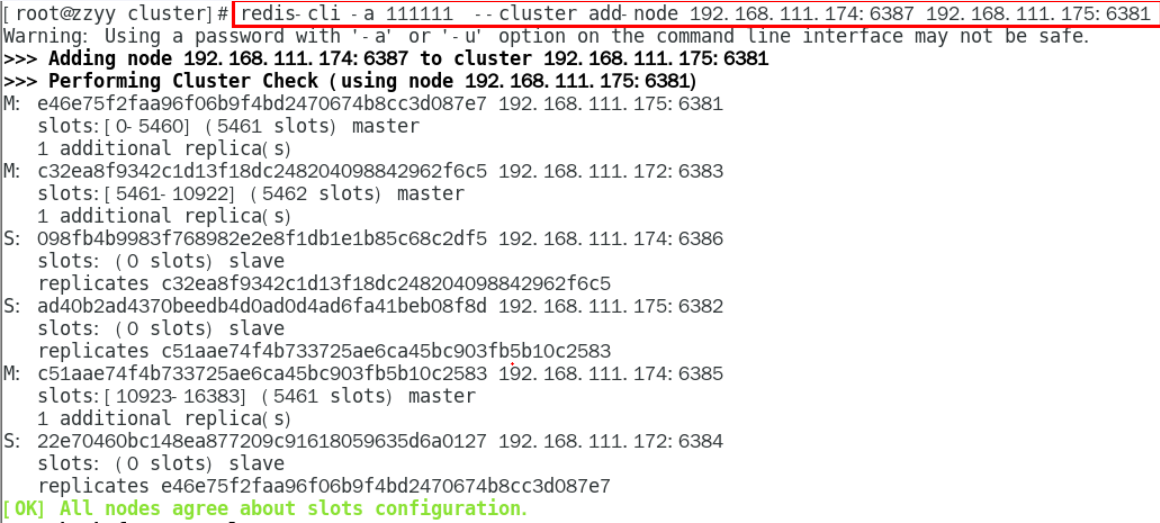
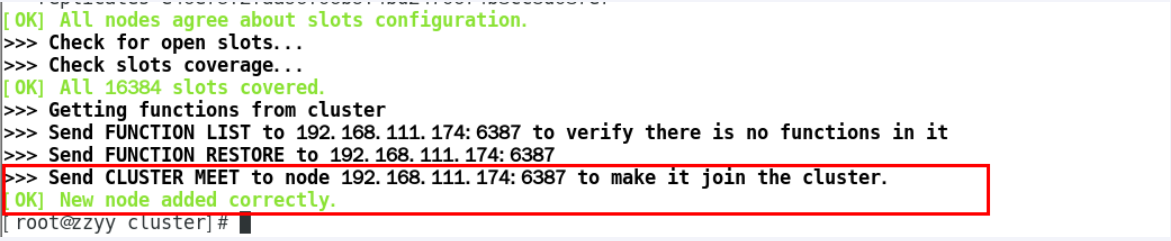
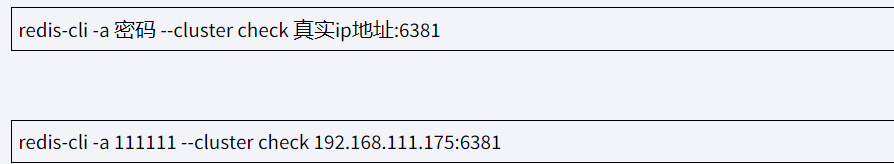
檢查
 加入後不會被分配槽號
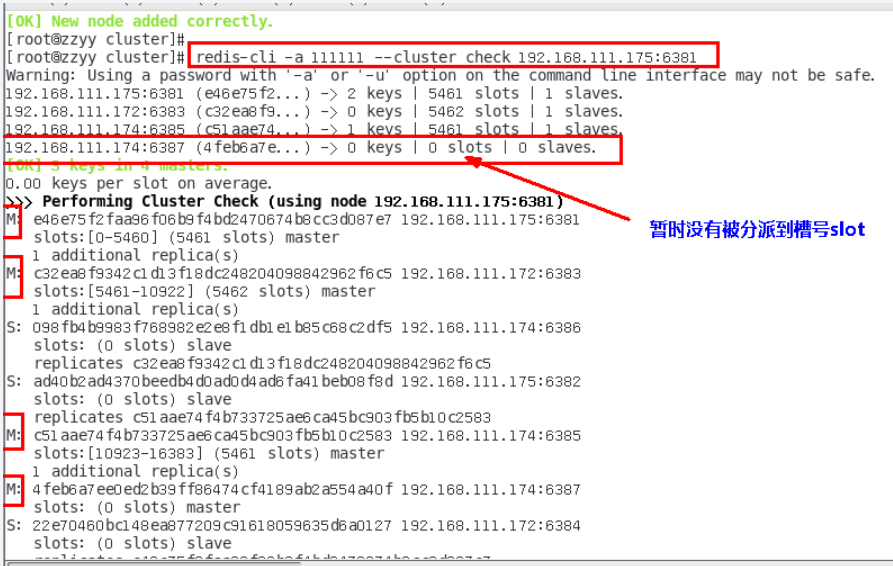
重新分配槽號 (
reshard)
redis-cli -a psw --cluster reshard ip:port
 填
16384/4=4096
 填新的
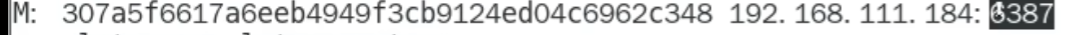
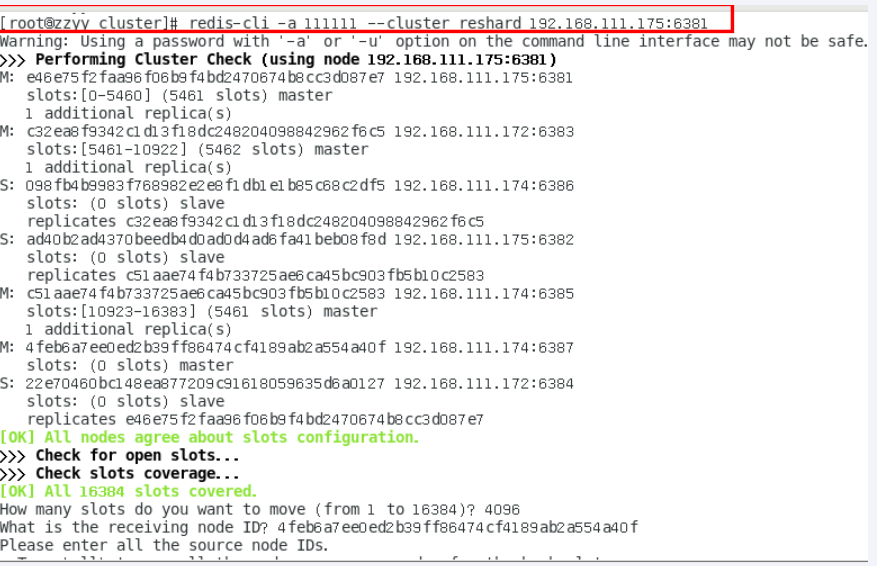
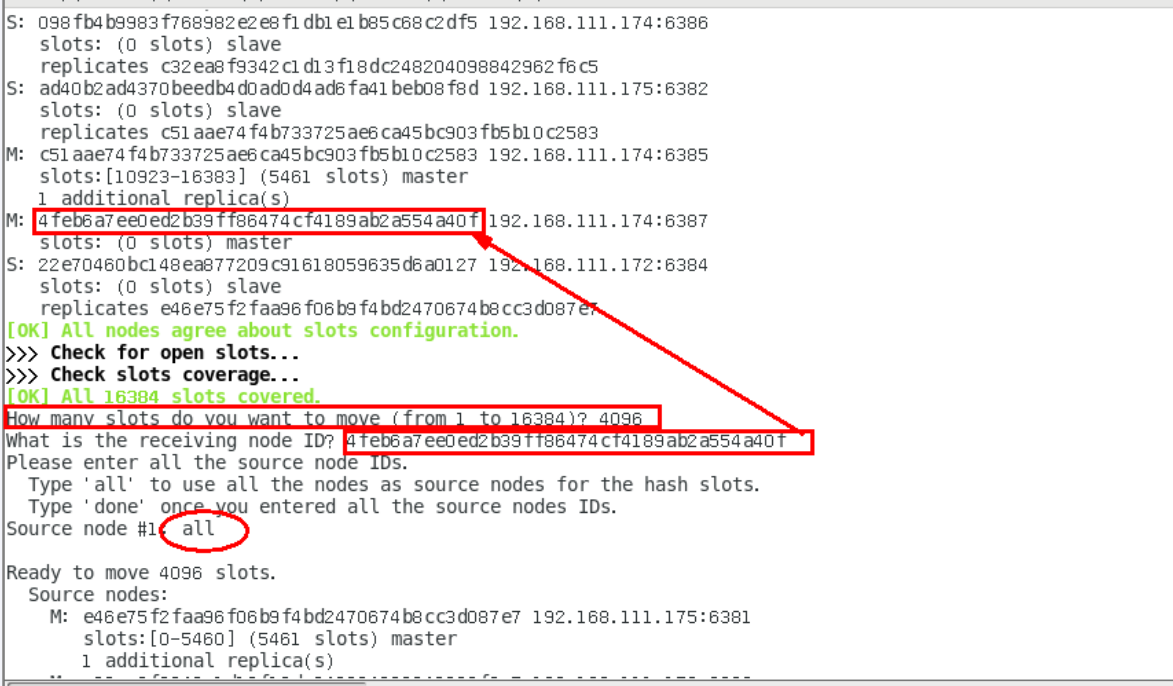
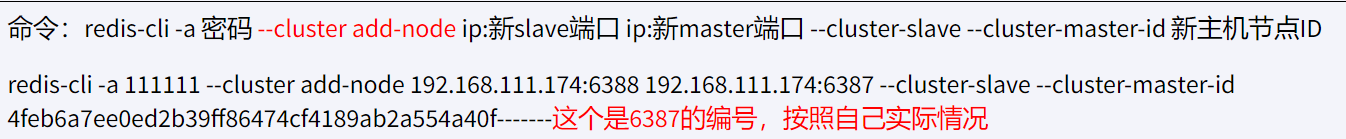
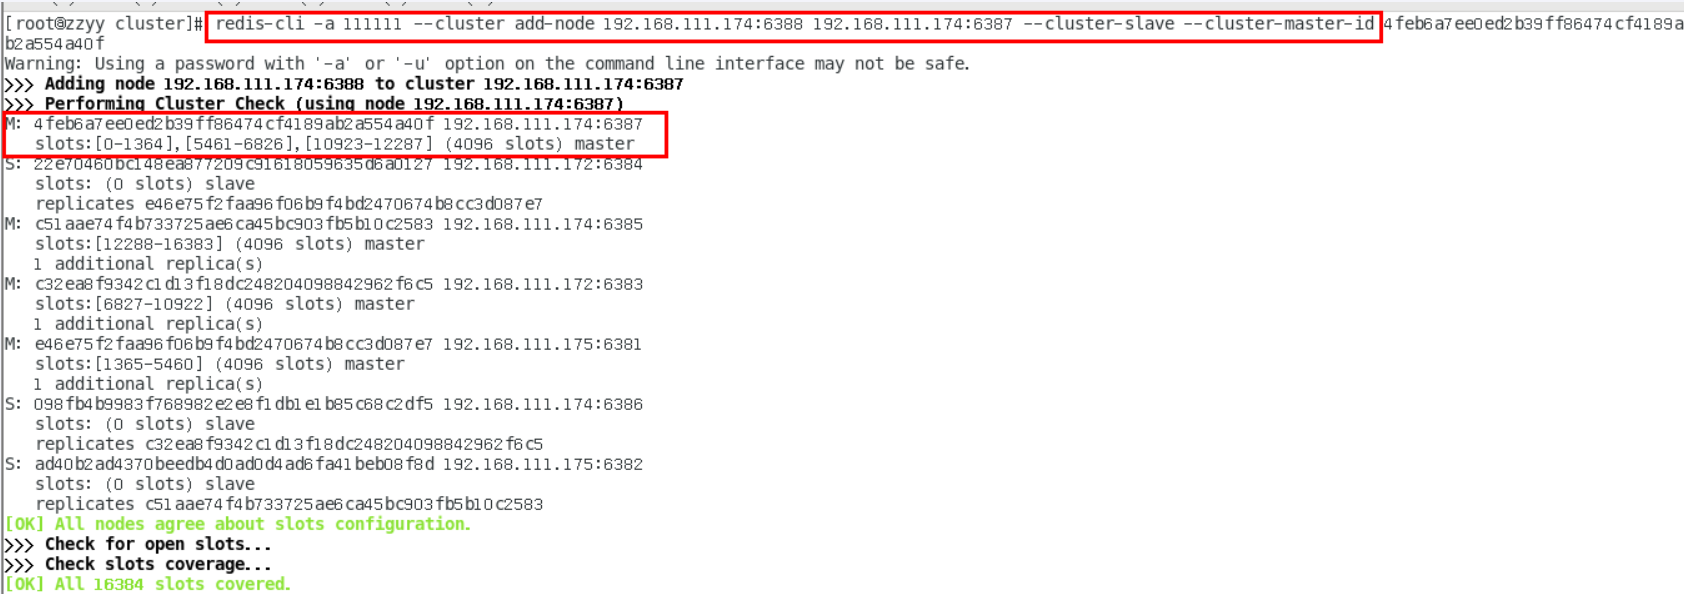
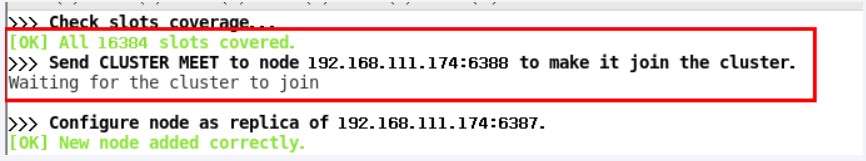
分配好了槽位,目前還沒有掛 slave
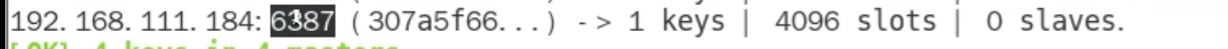


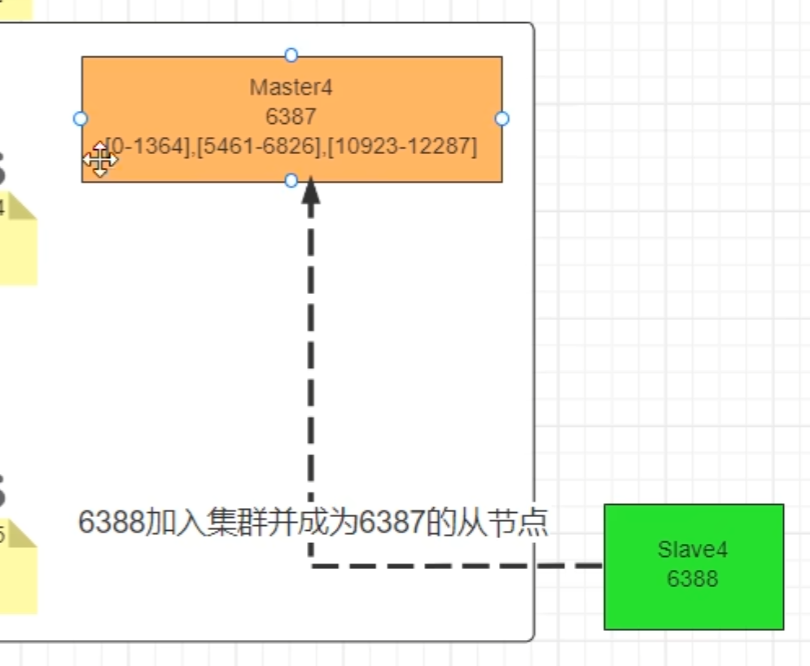
主從縮容案例
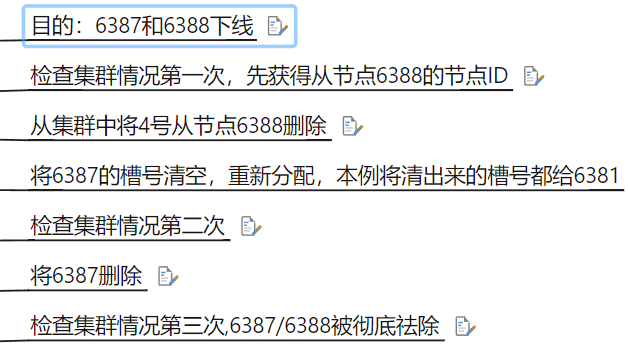
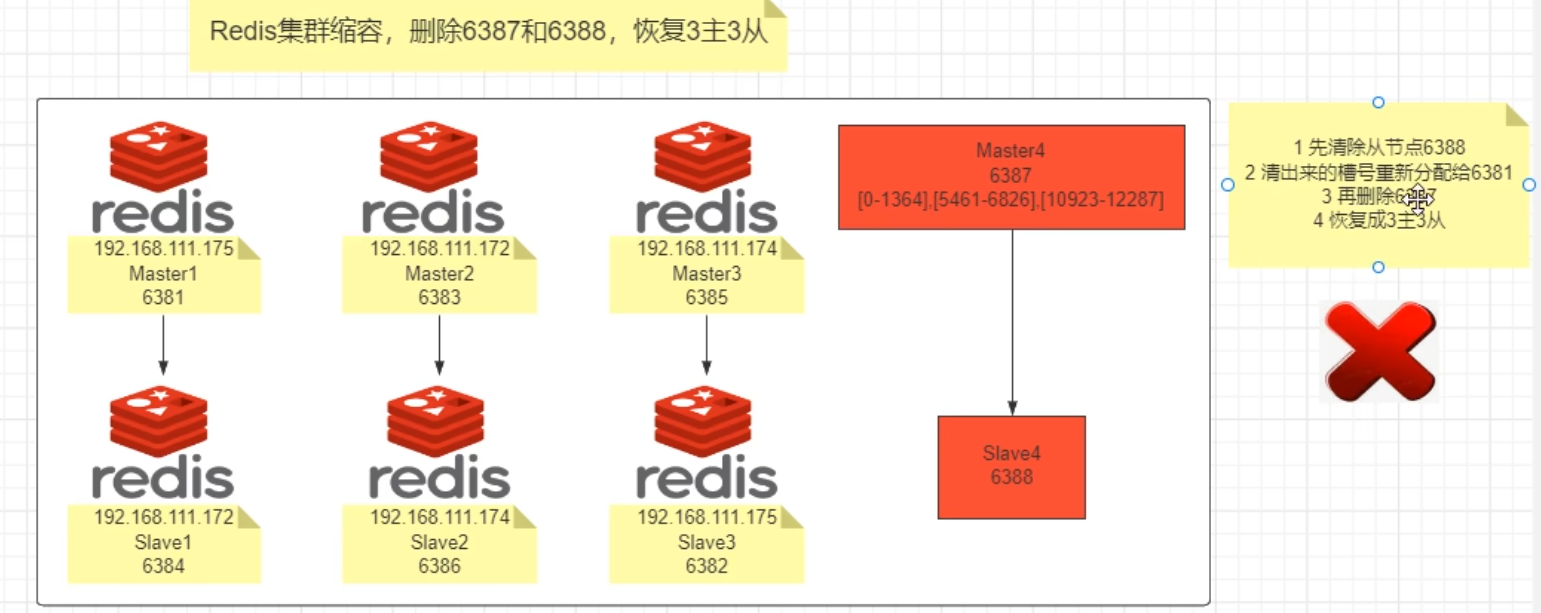
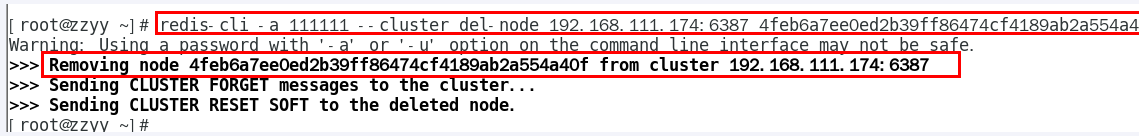
redis-cli -a psw --cluster del-node ip:port ID
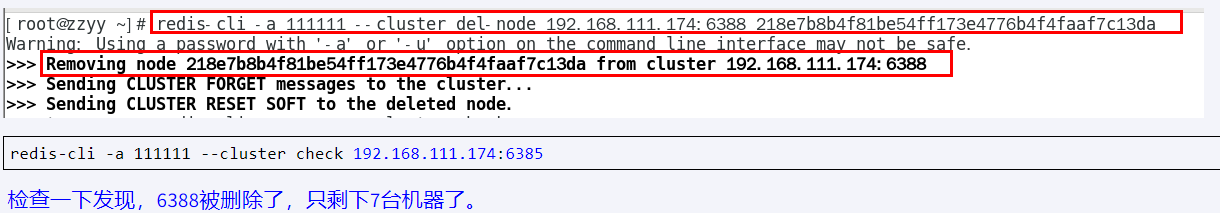
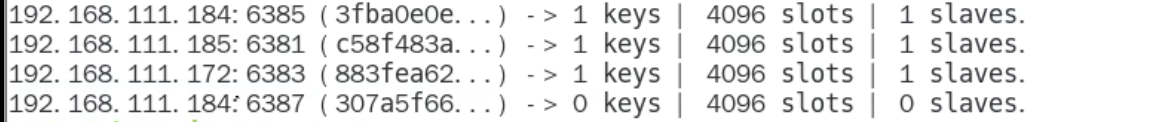 slave 被成功刪除,接下來將 6387 的槽號清空,重新分配 (本例群不還給了 6381)
redis-cli -a psw --cluster reshard ip:6381
然後輸入 4096
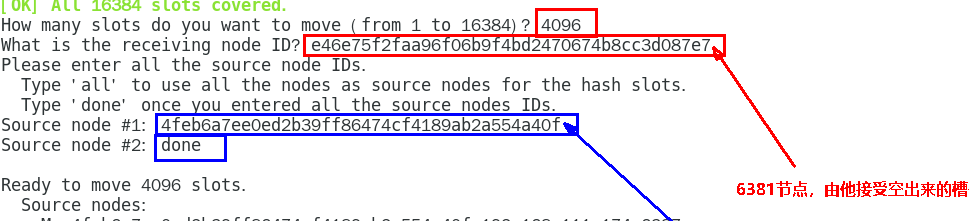
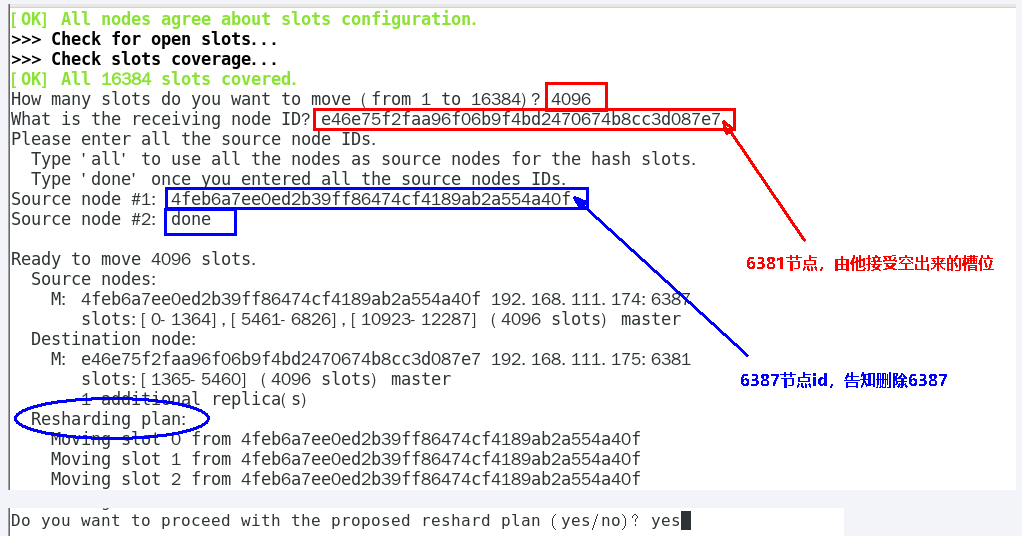
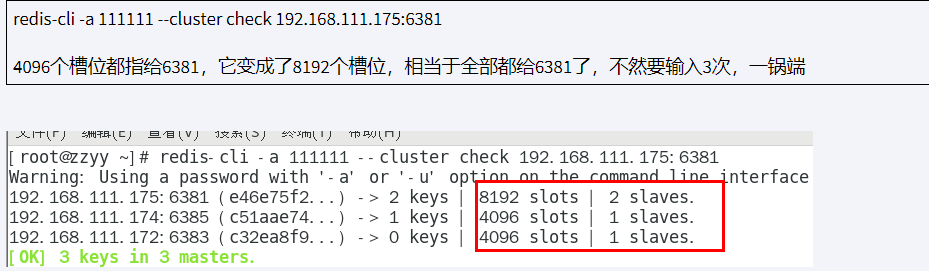 不需要兩個
slave , 之後將 6387 刪除
redis-cli -a psw --cluster del-node ip:port ID
叢集常用操作命令和 CRC16 演算法分析

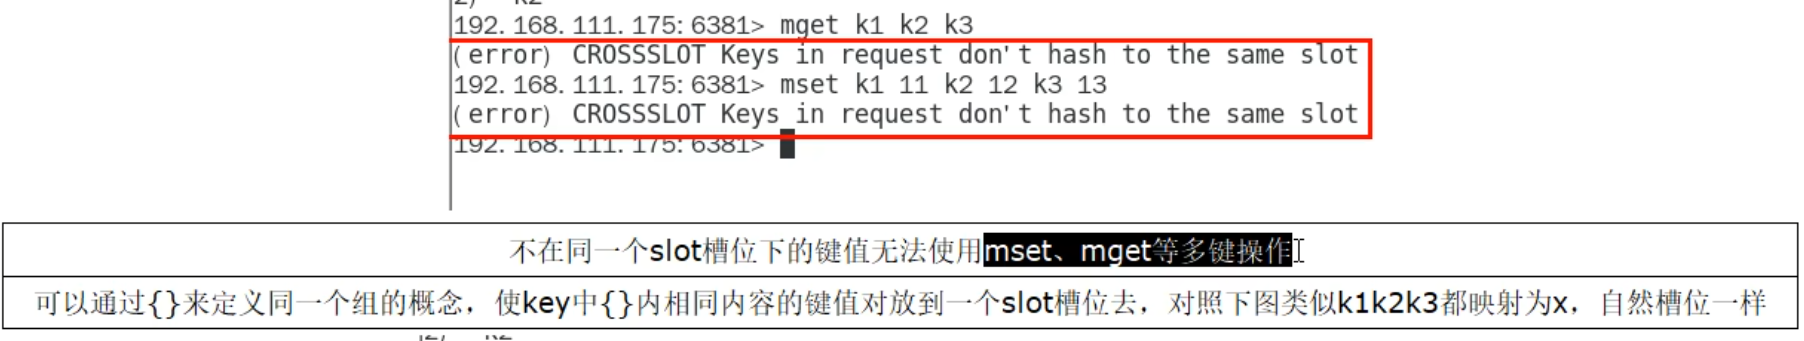
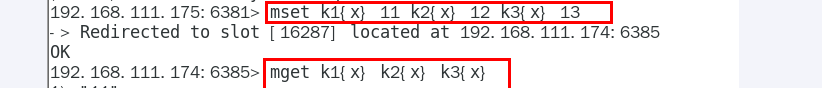
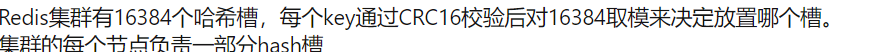
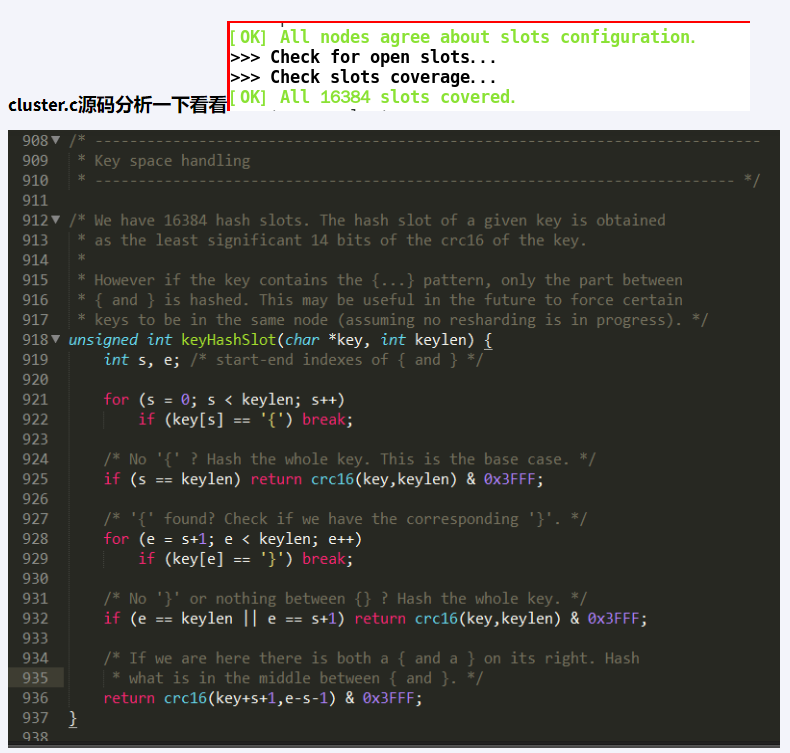
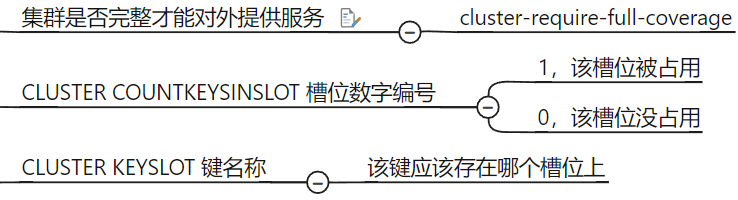
cluster keyslot key
cluster countkeysinslot 12707
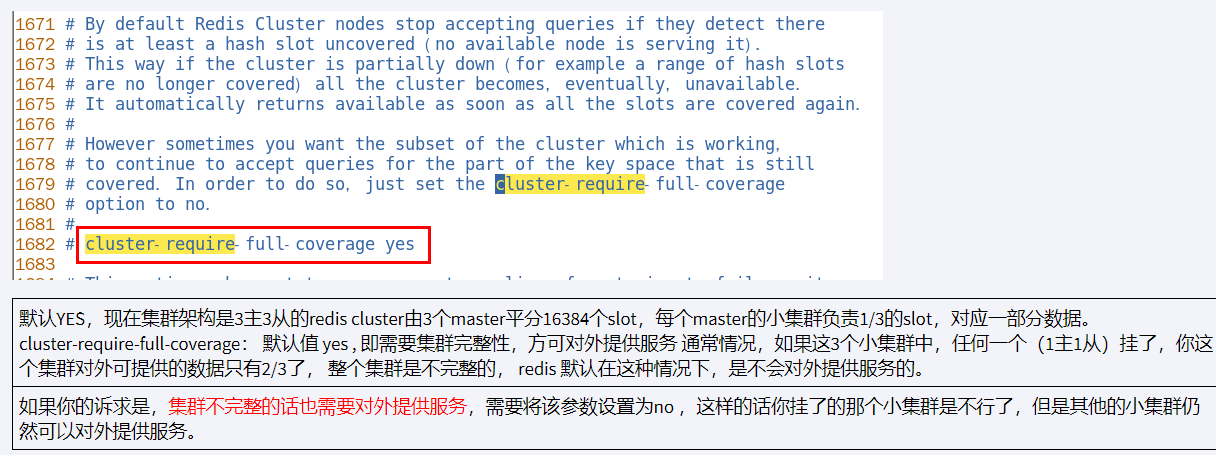
Spring 使用 Redis
Redis 的 Java 客戶端很多,常用的幾種:
Jedis
Lettuce
Spring Data Redis
Spring Data Redis 是 Spring 的一部分, 對 Redis 底層開發套件進行了高度封裝。
在 Spring 專案中, 可以使用 Spring Data Redis 來簡化操作
RedisTemplate
連線時注意 :
auth 是客戶端的後續認證命令
password 是伺服器端的連線認證設定
yaml
server.port=7777

spring.application.name=redis7_study

# ========================logging=====================
logging.level.root=info
logging.level.com.atguigu.redis7=info
logging.pattern.console=%d{yyyy-MM-dd HH:mm:ss.SSS} [%thread] %-5level %logger- %msg%n

logging.file.name=D:/Users/XCJY/Desktop/qianduan
logging.pattern.file=%d{yyyy-MM-dd HH:mm:ss.SSS} [%thread] %-5level %logger- %msg%n

# ========================swagger=====================
spring.swagger2.enabled=true
#在springboot2.6.X結合swagger2.9.X會提示documentationPluginsBootstrapper空指標異常,
#原因是在springboot2.6.X中將SpringMVC預設路徑比對策略從AntPathMatcher更改為PathPatternParser,
# 導致出錯,解決辦法是matching-strategy切換回之前ant_path_matcher
spring.mvc.pathmatch.matching-strategy=ant_path_matcher

# ========================redis單機=====================
spring.redis.database=0
# 修改為自己真實IP
spring.redis.host=192.168.111.185
spring.redis.port=6379
spring.redis.auth=111111
spring.redis.lettuce.pool.max-active=8
spring.redis.lettuce.pool.max-wait=-1ms
spring.redis.lettuce.pool.max-idle=8
spring.redis.lettuce.pool.min-idle=0
lettuceConnectionFactory 適合高併發
RedisConfig
@Configuration
public class RedisConfig
{
    /**
     * redis序列化的工具設定類,下面這個請一定開啟設定
     * 127.0.0.1:6379> keys *
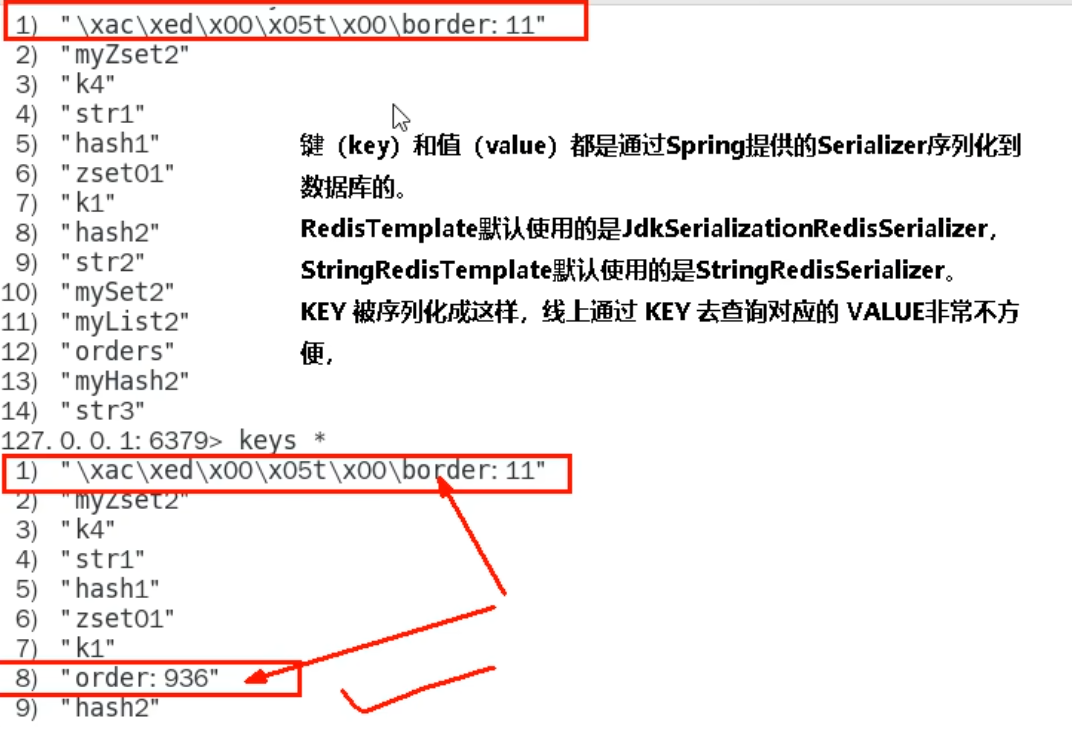
     * 1) "ord:102"  序列化過
     * 2) "\xac\xed\x00\x05t\x00\aord:102"   野生,沒有序列化過
     * this.redisTemplate.opsForValue(); //提供了操作string類型的所有方法
     * this.redisTemplate.opsForList(); // 提供了操作list類型的所有方法
     * this.redisTemplate.opsForSet(); //提供了操作set的所有方法
     * this.redisTemplate.opsForHash(); //提供了操作hash表的所有方法
     * this.redisTemplate.opsForZSet(); //提供了操作zset的所有方法
     * @param lettuceConnectionFactory
     * @return
     */
    @Bean
    public RedisTemplate<String, Object> redisTemplate(LettuceConnectionFactory lettuceConnectionFactory)
    {
        //開始建立redis範本物件...
        RedisTemplate<String,Object> redisTemplate = new RedisTemplate<>();
        //設定redis的連線工廠物件
       redisTemplate.setConnectionFactory(lettuceConnectionFactory);
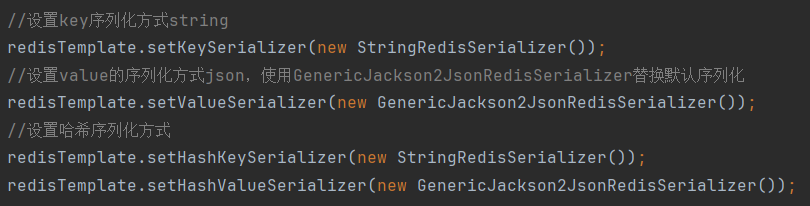
        //設置key序列化方式string
        redisTemplate.setKeySerializer(new StringRedisSerializer());
        //設置value的序列化方式json,使用GenericJackson2JsonRedisSerializer替換預設序列化
        redisTemplate.setValueSerializer(new GenericJackson2JsonRedisSerializer());
        //設定雜湊序列化方式
        redisTemplate.setHashKeySerializer(new StringRedisSerializer());
        redisTemplate.setHashValueSerializer(new GenericJackson2JsonRedisSerializer());
		//RedisTemplate 的所有屬性設定完成後,進行一些初始化操作
        redisTemplate.afterPropertiesSet();

        return redisTemplate;
    }
}
SwaggerConfig
@Configuration
@EnableSwagger2
public class SwaggerConfig
{
    @Value("${spring.swagger2.enabled}")
    private Boolean enabled;

    @Bean
    public Docket createRestApi() {
        return new Docket(DocumentationType.SWAGGER_2)
                .apiInfo(apiInfo())
                .enable(enabled)
                .select()
                .apis(RequestHandlerSelectors.basePackage("com.atguigu.redis7")) //你自己的package
                .paths(PathSelectors.any())
                .build();
    }
    public ApiInfo apiInfo() {
        return new ApiInfoBuilder()
                .title("springboot利用swagger2构建api接口文档 "+"\t"+ DateTimeFormatter.ofPattern("yyyy-MM-dd").format(LocalDateTime.now()))
                .description("springboot+redis整合,有问题给管理员阳哥邮件:zzyybs@126.com")
                .version("1.0")
                .termsOfServiceUrl("https://www.atguigu.com/")
                .build();
    }
}
RedisTemplate 操作類
Spring 提供的 Redis 資料結構的操作類
ValueOperations類,提供Redis String API操作ListOperations類,提供Redis List API操作SetOperations類,提供Redis Set API操作ZSetOperations類,提供Redis ZSet(Sorted Set) API操作GeoOperations類,提供Redis Geo API操作
序列化問題
//ThreadLocalRandom.current(): 取得與目前執行緒綁定的執行緒本地隨機數產生器
//.nextInt(1000): 產生一個0到999之間的隨機整數
//+1: 將產生的隨機整數加1,使範圍變為1到1000
int keyId= ThreadLocalRandom.current().nextInt(1000)+1;
String serialNO= UUID.randomUUID().toString();
將 redisTemplate 預設使用的``
想讓 linux 客戶端檢視中文 --raw
否則會是亂碼

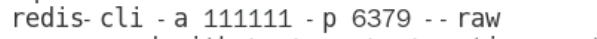
原因
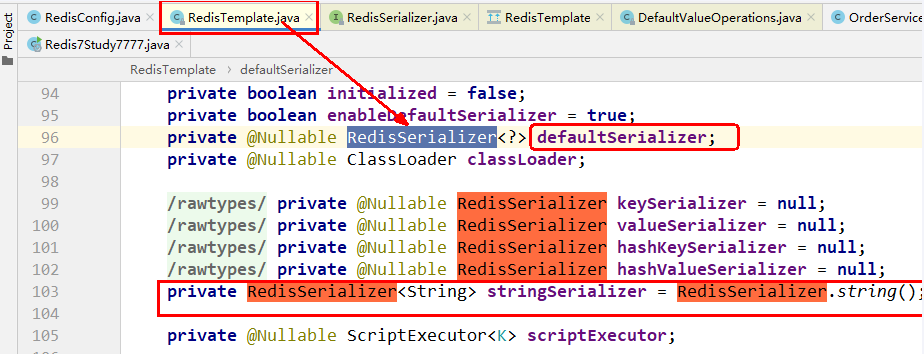
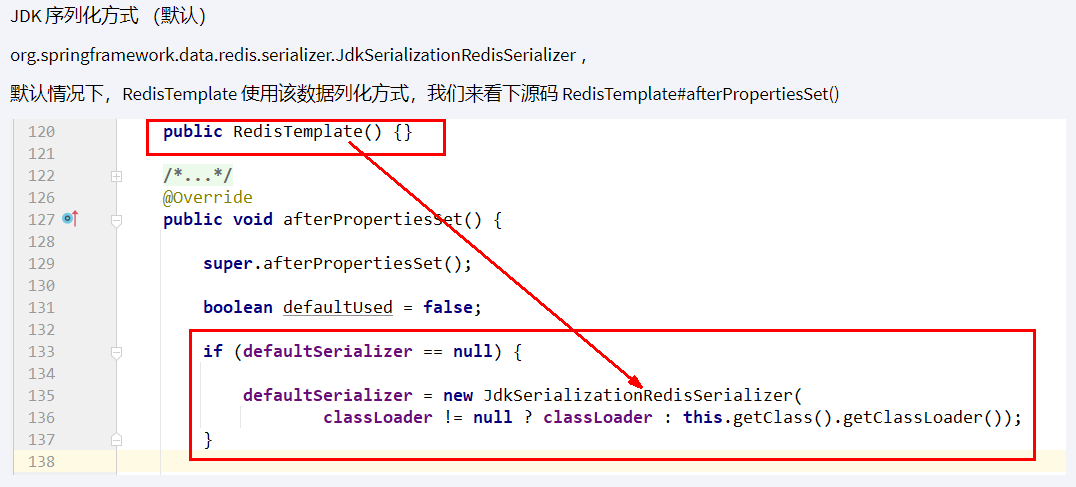 預設是 JDK 序列化方式,會導致亂碼,透過手動指定來取代預設的
連線叢集
連線叢集設定
spring.redis.password=111111
# 取得失敗 最大重定向次數
spring.redis.cluster.max-redirects=3
spring.redis.lettuce.pool.max-active=8
spring.redis.lettuce.pool.max-wait=-1ms
spring.redis.lettuce.pool.max-idle=8
spring.redis.lettuce.pool.min-idle=0

#支援叢集拓撲動態感應重新整理,自適應拓撲重新整理是否使用所有可用的更新,預設false關閉,不新增master掛後spring不知道
spring.redis.lettuce.cluster.refresh.adaptive=true

#定時重新整理
spring.redis.lettuce.cluster.refresh.period=2000
spring.redis.cluster.nodes=192.168.111.175:6381,192.168.111.175:6382,192.168.111.172:6383,192.168.111.172:6384,192.168.111.174:6385,192.168.111.174:6386
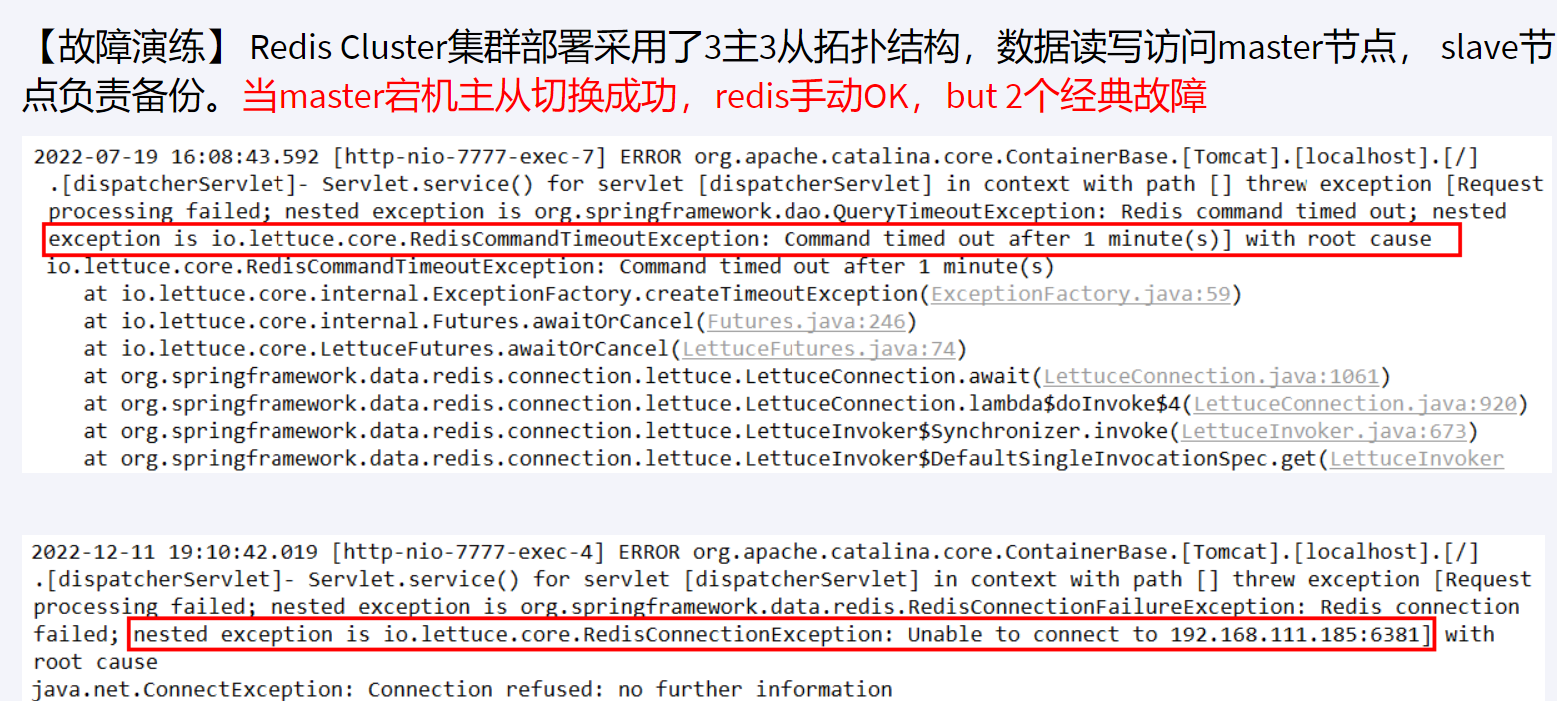
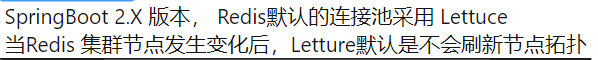
解決方案
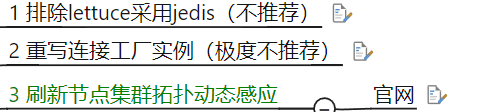
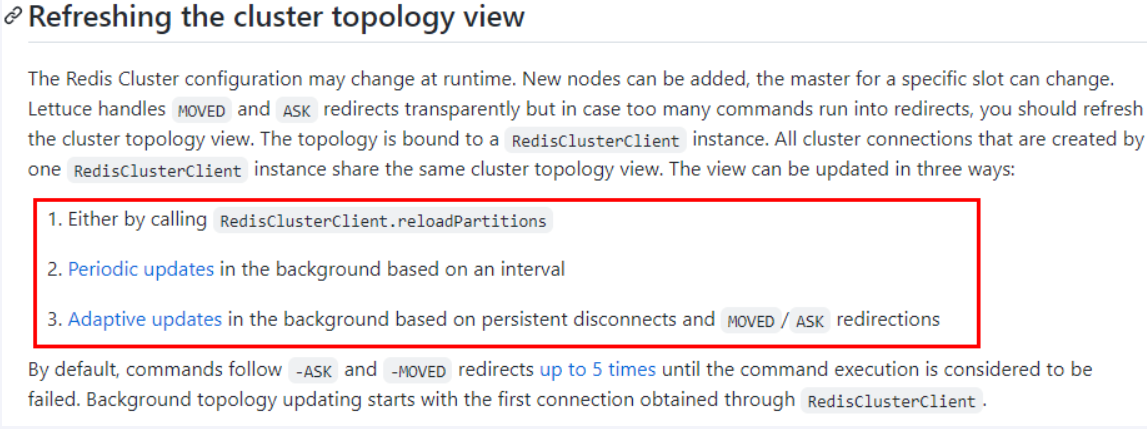
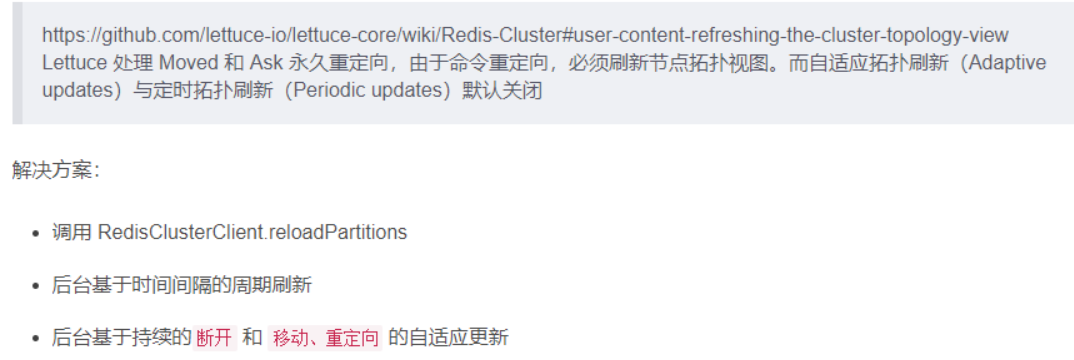
#支援叢集拓撲動態感應重新整理,自適應拓撲重新整理是否使用所有可用的更新,預設false關閉,不新增master掛後spring不知道
spring.redis.lettuce.cluster.refresh.adaptive=true

#定時重新整理
spring.redis.lettuce.cluster.refresh.period=2000
資料
- 起步思維: 官網
- 排除故障思維 : 日誌