MySQL 查詢的書寫與執行順序
基礎
書寫順序
執行除了 select 是第一個, 其餘順序是一樣的
執行順序: select 再 Having 後執行 (執行順序也為聯合索引宣告循序) ^ib46t0
執行順序則是由 MySQL 查詢最佳化工具根據查詢計畫決定的,這可能包括選擇最佳的索引、最佳化連接順序、以及其他一些最佳化策略
SELECT階段 (可以聚合函數)(可以別名)FROM階段 (JOIN ON).(執行先ON後JOIN)(可以起別名)(執行順序第一)WHERE階段 (效率高)(不能聚合函數)(不能起別名,可以用之前起的別名)(能寫在 where 不寫在 having)GROUP BY階段HAVING階段 (效率低) 可以使用分組資料 (可以聚合函數)(無需和 where 成對出現)ORDER BY階段ASC升冪/DESC降冪排序欄位未必是select中的 (可以起別名) (預設升冪) (消耗資源,減少使用)LIMIT X,Y;X 位移偏移量, Y 條目數, 查詢第 X 條資料開始後的 Y 條資料
LIKE : 模糊查詢,可以在 JOIN ON / WHERE / HAVING
% : 代表不確定個數的字元 (0 個,1 個,或多個)
mysql自帶的核心資料庫,使用者帳戶和權限資訊information_schema維護的所有其他資料庫的資訊 (如表的索引約束)performance_schema監控 Mysql 服務的各類效能指標 (如鎖的資訊)sys自帶的資料庫,透過檢視表的形式把performance_schema和information_schema結合起來
DESC [表/欄位]

匯入現有的表 (`mysql` 命令列) : source d:\mysqldb.sql


- 進入/切換資料庫
USE database_name;

- SHOW : 通常用於顯示多個變數或狀態,可以一次查看所有相關資訊。
- - 通常不區分全域和會話,直接顯示目前上下文中的變數。

SHOW DATABASES:顯示所有資料庫的清單
SHOW TABLES:顯示目前資料庫中的所有表
SHOW TABLE STATUS LIKE '表':查看對應表狀況
SHOW COLUMNS FROM table_name:顯示指定表的欄資訊
SHOW CREATE TABLE table_name:顯示建立指定表的 SQL 語句
SHOW STATUS:顯示伺服器狀態資訊。
SHOW PROFILES:顯示最近執行的查詢的效能分析資訊。可以用於對比多個查詢的效能,適合深入分析。
SHOW ENGINES:顯示支援的儲存引擎及其狀態。
SHOW VARIABLES:顯示系統變數及其目前值。
	查看頁大小
 	show variables like '%innodb_page_size%'
SHOW INDEX FROM table_name:顯示該表的索引


- @@ 前綴 : 可以針對特定變數進行查詢,方便取得單一變數的值。
- - 可以用來查詢全域變數和會話變數,支援使用 `global` 或 `session` 前綴。
@@ 前綴變數是 MySQL 伺服器的內部狀態變數,它們不由任何具體的資料庫表存儲,而是由伺服器進程在記憶體中直接管理。 它們代表了 MySQL 伺服器的配置、狀態和執行時參數,通過 SELECT @@variable_name 可以直接訪問這些值。 這些值是伺服器即時狀態的反應,而不是靜態存儲在資料庫中的資料。

SELECT @@global.variable_name;:查詢全局變數。
SELECT @@session.variable_name;:查詢當前會話的變數。
SELECT @@max_connections;查詢最大連接數。
SELECT @@connections;   查詢總連接數
SELECT @@version;:獲取當前MySQL版本。
SELECT @@datadir;:獲取資料目錄路徑
SELECT @@innodb_buffer_pool_size;   查詢InnoDB緩衝池大小
SELECT @@thread_count;  查詢當前執行緒數
SELECT @@query_cache_size;  查詢查詢快取的大小
select @@optimizer_switch

SELECT DATABASE();
SELECT USER();
SELECT UUID();  返回一個唯一識別碼

SELECT * FROM INFORMATION_SCHEMA.table_constraints WHERE TABLE_NAME = '表名称'; 表約束情況
SELECT * FROM INFORMATION_SCHEMA.STATISTICS WHERE TABLE_NAME = '表名称'; 表索引情況
SHOW TABLE STATUS LIKE 'countries';表約束情況,沒有那麼詳細


不用時要關閉,消耗效能
![[assets/Mysql面試/file-20240904192510469.png]]
- 查看預設行格式

select @@innodb_default_row_format;
或
show table status like'表';

- 指定行格式
Create Table 表名 ROW_FORMAT=行格式
Alter Table  表名 ROW_FORMAT=行格式

![[assets/Mysql高級/image-20231208101341686.png|500]]

SHOW PROFILES:顯示最近執行的查詢的效能分析資訊。包括查詢的執行時間、鎖定時間等。它提供了更詳細的效能資料,幫助開發者識別效能瓶頸

> 某個環節時間長則可考慮優化
show profile for query 7;
show profile cpu,block io for query 6;

![[assets/Mysql高級/image-20231120172201970.png|600]]


SHOW STATUS:顯示伺服器狀態資訊

> 上次查找開銷,反映了查詢的複雜度和資源消耗
SHOW STATUS LIKE 'last_query_cost';


我們可以通過

select * from performance_.schema.data_locks\G;
這條語句,查看事務執行SQL過程中加了什麼鎖。

- 如果 LOCK_MODE 為 `X`,說明是 next-key Lock.
- 如果 LOCK_MODE 為 `X, REC_NOT_GAP`,This indicates a record lock.
- 如果 LOCK_MODE 為 `X, GAP`,This indicates a gap lock.
DDL 新增刪除修改
Mysql/Mysql优化#索引的创建使用
創建表
CREATE TABLE [IF NOT EXISTS] 表名(
欄位1, 資料類型 [約束條件] [預設值],
欄位2, 資料類型 [約束條件] [預設值],
欄位3, 資料型別 [限制條件] [預設值],
[資料表限制條件]
[constraint 自訂限制名稱] unique key(欄位名稱)
[CONSTRAINT <外鍵限制名稱>] FOREIGN KEY(從資料表的某個欄位) references 主資料表名稱(被參考欄位)
);

刪除資料表
DROP TABLE [IF EXISTS] 資料表1 [, 資料表2, …, 資料表n];

重新命名資料表
RENAME TABLE 資料表名稱 TO 新資料表名稱;

複製資料表結構
CREATE TABLE 新資料表名稱 LIKE 舊資料表名稱;

複製資料表資料
INSERT INTO 新資料表名稱 SELECT * FROM 旧表名;

清空資料表
TRUNCATE TABLE 資料表名稱;

修改資料表中欄位

新增 ALTER TABLE 資料表名稱 ADD 欄位名稱 欄位型別 [FIRST|AFTER 欄位名稱] [限制名稱]

修改(很少用, 對預設值的修改只影響今後對資料表的修改)
ALTER TABLE 資料表名稱 MODIFY 欄位名稱 欄位型別 [DEFAULT 預設值] [FIRST|AFTER 欄位名稱]
[限制條件];

ALTER TABLE 資料表名稱 CHANGE 欄位名稱 新欄位名稱 新資料型別;

刪除 ALTER TABLE 資料表名稱 DROP 欄位

刪除限制
ALTER TABLE 資料表名稱 DROP PRIMARY KEY;
刪除唯一限制 ALTER TABLE 資料表名稱 DROP INDEX 限制名稱;
刪除外鍵 ALTER TABLE 資料表名稱 DROP FOREIGN KEY 限制名稱;


索引

在宣告有主鍵限制, 唯一性限制, 外鍵限制的欄位上, 會自動新增相關的索引

建立索引

CREATE TABLE table_name [col_name data_type]
[UNIQUE | FULLTEXT | SPATIAL] [INDEX | KEY] [index_name] (col_name [length]) [ASC | DESC]

![[assets/Mysql進階/image-20231208205801757.png]]

新增索引

()必須帶

ALTER TABLE table_name ADD [UNIQUE | FULLTEXT | SPATIAL] [INDEX | KEY]
[index_name] (col_name[length],...) [ASC | DESC]


在 MySQL 中,`CREATE INDEX` 被對應到一個 `ALTER TABLE` 陳述式上


CREATE INDEX Index name ON Table name (Column name);
CREATE [UNIQUE | FULLTEXT | SPATIAL] INDEX index_name
ON table_name (col_name[length],...) [ASC | DESC]

Delete
DROP INDEX Index name ON Table name;
ALTER TABLE table_name DROP INDEX index_name;


`AUTO_INCREMENT` The affected column must have either a unique constraint or a primary key constraint, so it cannot be deleted
If a column used as an index is deleted, that index is also deleted
![[assets/Mysql Advanced/image-20231208221009925.png]]
Mysql8.0 Supports creating descending indexes


Toggle index visibility
ALTER TABLE tablename ALTER INDEX index_name INVISIBLE; #Switch to a hidden index
ALTER TABLE tablename ALTER INDEX index_name VISIBLE; #Switch to a visible index
DML insert, delete, update
- Insert(Using a single `INSERT` statement to insert multiple rows of records usually performs better than using multiple single row `INSERT` statements)

INSERT INTO table_name(column1 [, column2, …, columnn])
VALUES
(value1 [,value2, …, valuen]),
(value1 [,value2, …, valuen]),
……
(value1 [,value2, …, valuen]);

Insert data from one table into another table.

INSERT INTO Target table name
(tar_column1 [, tar_column2, …, tar_columnn])
SELECT
(src_column1 [, src_column2, …, src_columnn])
FROM Source table name
[WHERE condition]

Update, you must use where

UPDATE table_name
SET column1=value1, column2=value2, … , column=valuen
[WHERE condition]
#Use WHERE The clause specifies the data that needs to be updated,If omitted WHERE clause, then all data in the table will be updated.


Delete(Must where
DELETE FROM table_name [WHERE <condition>];


START TRANSACTION;
COMMIT;
ROLLBACK;
Logical architecture
Introduction
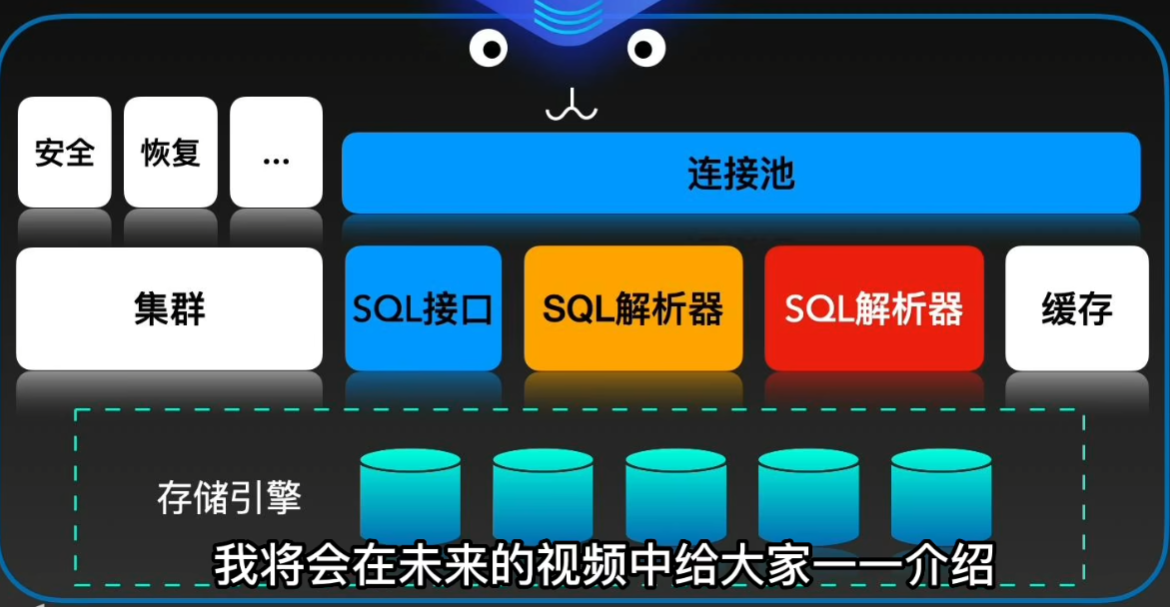
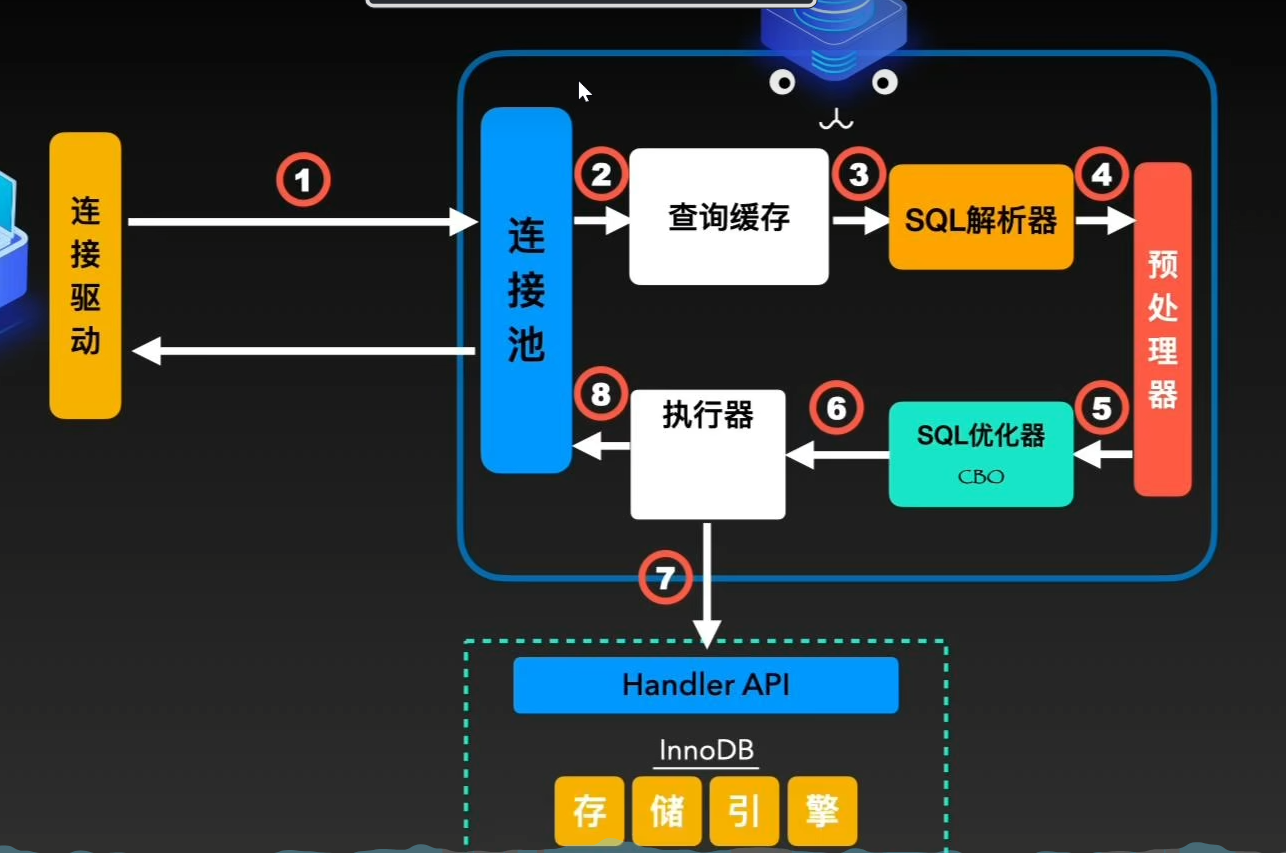
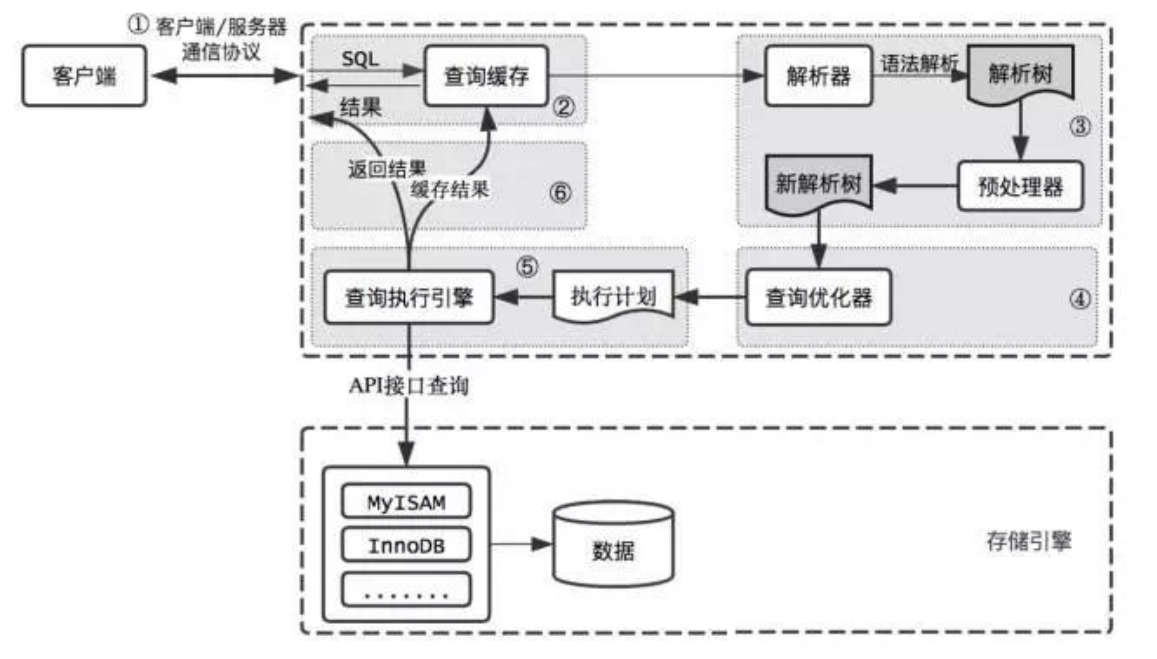
Connection layer: TCP connection to MySQL, performs identity authentication and permission retrievalService layer:SQL interfaceSQL execution first performsLexical analysis(keywords, identifiers, constants, operators, etc.), thenSyntax analysis: Determines whether the input SQL statement satisfies MySQL syntax based on the lexical analysis resultParserThe parser takes the tokens generated by lexical analysis and parses them according to SQL syntax rules to build an abstract syntax treeOptimizerThe query optimizer calculates the IO cost and CPU cost corresponding to the SQL, generates an execution plan for the SQL, determines the execution path, and reorganizesSQLCache&BufferExecution path
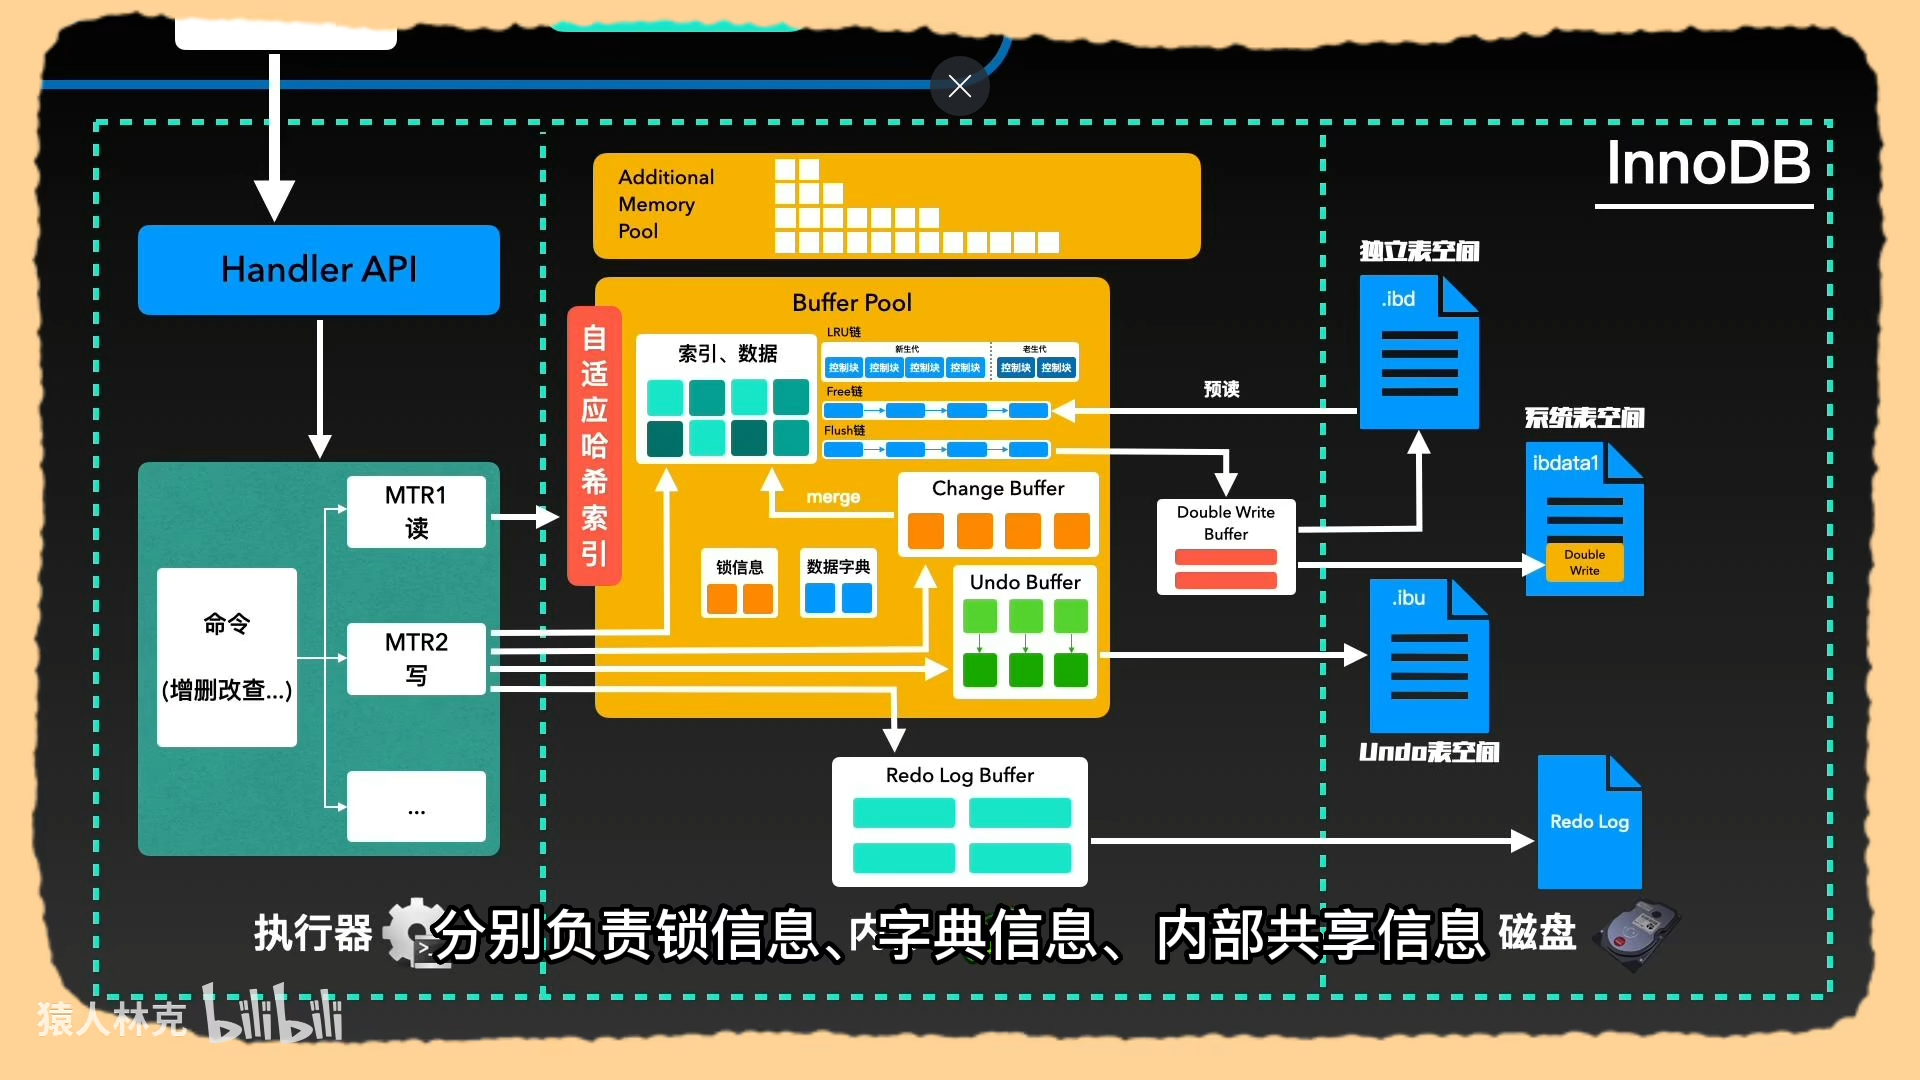
Engine layer: Truly responsible forMysqlstorage and retrieval of data in it, performing operations on the underlying data of the physical server, all logical processing and read write operations only handle operationsbuffer poll, records the old value intoUndo LoginStorage layer
Database buffer pool buffer poll
InnoDB The buffer pool includes data pages, index pages, insert buffer, lock information, adaptive index Hash and data dictionary information, etc. The buffer pool size is limited, and based on Location×Frequency, it prioritizes caching for high frequency items
When InnoD B it finds that certain queries frequently access specific data pages, it creates hash indexes for these data pages in memory.
Buffer pool operation
View/Set the size of the buffer pool

show variables like 'innodb_buffer_pool_size';
set global innodb_buffer_pool_size = 268435456;

View how many Buffer Pool Instances
show variables like 'innodb_buffer_pool_instances';

預設一個,設定為多個則平分上面設定的快取池大
需要快取池至少1g以上設定多個才有效

高併發多個可能更好
[server]
innodb_buffer_pool_instances = 2
快取池 (屬於記憶體): 資料的修改會在快取池中進行 非快取池的記憶體部分: 表結構、索引資訊等中繼資料儲存, 資料庫連線的狀態和變數資訊, 臨時表
查詢資料 先查快取池,沒有則查磁碟,然後載入到快取池 (如果還沒有刷回)
更新資料 先查快取池,沒有則查磁碟,然後載入到快取池並修改更新,修改後的資料頁會被標記為 髒頁 (表示這部分資料在記憶體中已被修改,但尚未寫回到磁碟)
- 髒頁在後續的
某個時刻會被刷回到磁碟。刷回的時機可能包括:(如果此時宕機將會永久更新)
- 緩衝池達到一定的閾值(如髒頁數量超過一定比例)。
- 事務提交時,
MySQL會將相關的髒頁刷回磁碟,以確保資料的持久性。 - 定期的後台任務(如定時刷新)會將髒頁寫回磁碟。
刷寫的過程是透過將髒頁的內容寫入磁碟,確保資料在實體儲存中保持一致性和持久性。
JOIN
為了取得另一個表中和當前表相關的資料,設計出了 JOIN
LEFT/RIGHT 就是保留一張表 A的資訊和另一張表 B資訊中符合 ON 條件的,不符合條件的,A 中也會有 B 表的欄位,但是為 NULL
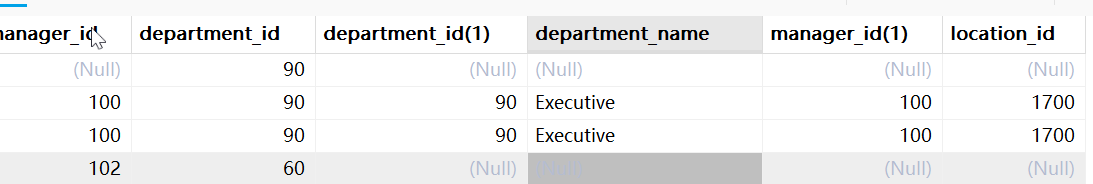
JOIN就是兩張表合併,按照 ON 條件保留另一張表的資料
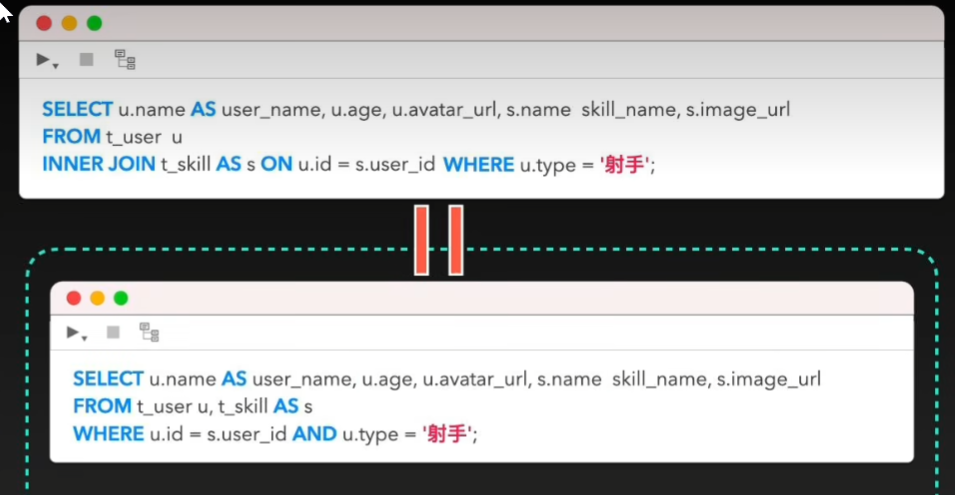 最佳化工具會把上面的轉換為下面的
內連接(INNER JOIN)(JOIN) ON xxx;JOIN 表 USING(欄位);: 同內連接, 使用欄位和類型相同的情況可以使用,無需再寫ON後的條件, 會自動去除USING(列名)的欄位名Nature JOIN;相當於內連接,無需寫任何條件,會自動設定欄位相等的部分為條件, 會自動去除重複欄位名左連接(LEFT JOIN xxx ON xxx);: 保留左邊表獨有資料保留,和右邊表交叉中符合條件的資料全外連接FULL OUTER JOIN(mysql不支援), 採用UNION AL交叉連接CROSS JOIN(笛卡爾積)假設table1有 3 行,table2有 4 行,結果集將包含 3 交叉連接不需要條件,所有的行都會被組合。UNION ALL但UNION會去重導致效率低, 一般不推薦用JOIN ... USING是為了簡化欄位的展示,去除重複欄位,而不影響結果集的行數。UNION和UNION ALL則是操作結果集的行,前者對兩個表的相同欄位的結果集去重,後者保留所有行。
資料類型
Mysql基础#数据类型
char: 255, 固定,可能比 varchar 快 50%
varchar : 65532 ,時間換空間
任何欄位如果為非負數,必須是 UNSIGNED
數類型為 DECIMAL,禁止使用 FLOAT 和 DOUBLE
- 【強制】如果儲存的字串長度幾乎相等,使用 CHAR 定長字串類型。
- 【強制】
VARCHAR是可變長字串,不預先分配儲存空間,長度不要超過5000。如果儲存長度大於此值,定義欄位類型為TEXT,獨立出來一張表,用主鍵來對應,避免影響其它欄位索引效率。-阿里巴巴《Java開發手冊》
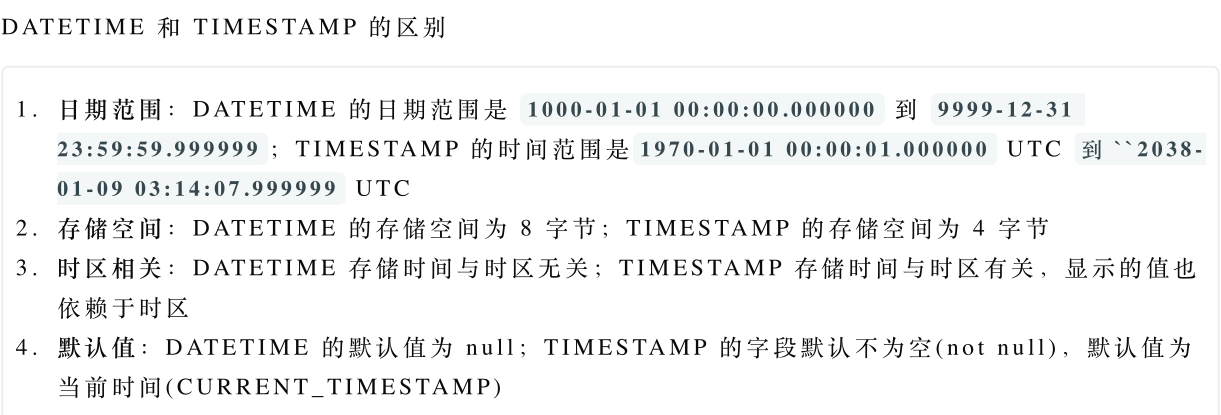
DATETIME和TIMESTAMP的異同
儲存時間格式相同,都可以儲存微秒,但是 timestamp 範圍到 2038 年
儲存表情
預設的 utf8mb3 改為utf8mb4
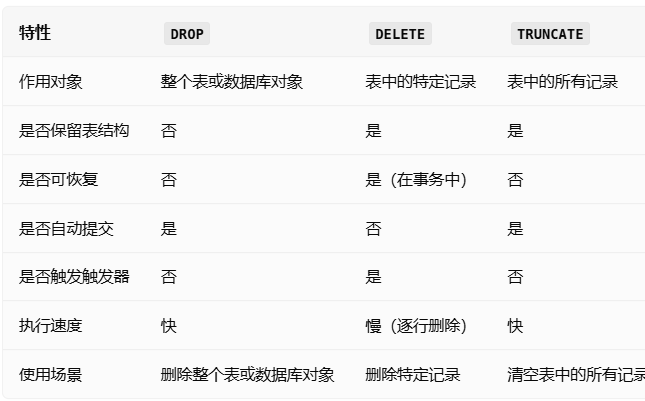
delete、drop 與 truncate 的區別
DELETE : DML 刪除特定記錄,支援交易,可恢復。
- 功能:用於從表中刪除特定的記錄。
- 語法:
DELETE FROM table_name WHERE condition; - 效果:
- 僅刪除符合條件的記錄。
- 可以使用
WHERE子句來限制刪除的範圍。 - 支援
交易,允許回滾操作(在支援交易的儲存引擎中,如 InnoDB)。 - 刪除操作會在日誌中記錄每一行的刪除,適合細粒度控制。
- 使用場景:當需要刪除部分資料而保留其他資料時使用。
DROP:DDL 刪除速度快, 刪除整個表或資料庫,無法恢復。
- 功能:用於刪除整個表、檢視或資料庫。
- 語法:
DROP TABLE table_name; - 效果:
- 刪除整個表及其結構和資料。
- 不能恢復,所有相關的
約束和索引也會被刪除。
- 使用場景:當需要完全移除一個表或資料庫時使用,且不再需要任何資料或結構。
TRUNCATE:DDL 快速清空表中的所有記錄,保留表結構,通常不可恢復。
- 功能:用於快速刪除表中的所有記錄。
- 語法:
TRUNCATE TABLE table_name; - 效果:
- 刪除表中的所有記錄,但保留表結構。
- 不支援
WHERE子句,不能選擇性刪除。 - 通常比
DELETE快,因為它不會逐行記錄刪除,而是直接釋放資料頁。 - 在某些情況下,
TRUNCATE可能不會觸發DELETE觸發器。 - 不能在交易中回滾(在大多數情況下)。
- 使用場景:當需要快速清空表中的所有資料而不關心逐行刪除的細節時使用。
金錢
定點數 : decimal(x,y) x 代表位數,y 代表小數點後的數
count (*),count (1),count (列名)
count(*) 不忽略 Null
count(1) 不忽略 Null
count(列名) 忽略 Null
count (主键)>count (1)>count(列名)>count (*)
如果只有一個欄位, count(*) 最快
Mysql/Mysql 進階 > 10 11 2 COUNT 與 COUNT 具體欄位 效率
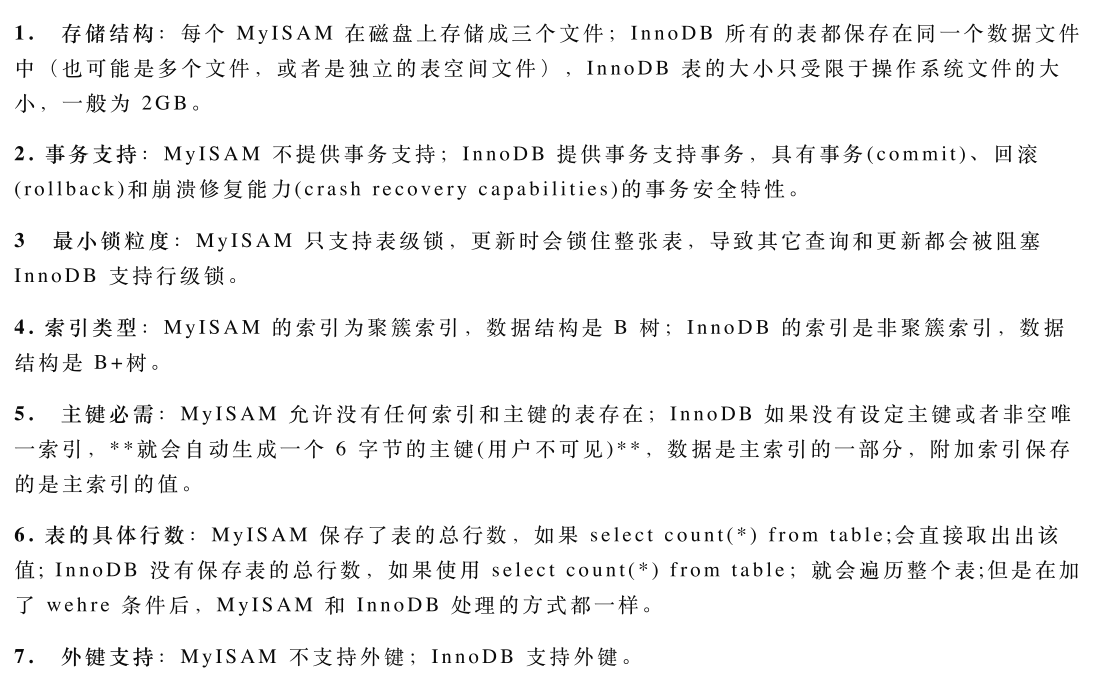
引擎對比
頁結構
快取池載入頁的三種方式
- 記憶體讀取
- 隨機讀取
- 順序讀取 Mysql内部结构#^vep6gv
為了避免隨機讀取,設計了區
頁 (16 kb)(I/O和磁碟互動的最小單位) 葉子節點頁/非葉子節點頁 (目錄頁) 也就是一次最少讀取 16kb 到記憶體中
--> 區(最多1MB=64個連續頁×16kb)(最少兩個區[葉子/非葉子])(避免頁物理位置不同導致隨機IO)``碎片區:最少兩個區2M,浪費空間,後來引出了碎片區,不獨立屬於任何一個段
--> 段(葉子節點區/非葉子節點區)(同類型的區被稱為段)(資料段, 索引段, 回滾段)
雖然 MySQL 的 InnoDB 儲存引擎在設計上傾向於將資料頁物理上連續儲存以最佳化效能,但由於資料的動態性、刪除、更新等操作,實際儲存中可能會出現不連續的情況。因此,物理連續性並不是絕對保證的。
- 索引分配空間
就不再按照頁, 而是區, 資料量大可能分配很多個連續的區 (不能保證全部頁是連續的,但是能保證一個區中的頁物理上連續,避免了隨機 IO, 區之間不一定連續,採用雙向鏈結串列連接)
頁內部結構
- 資料頁
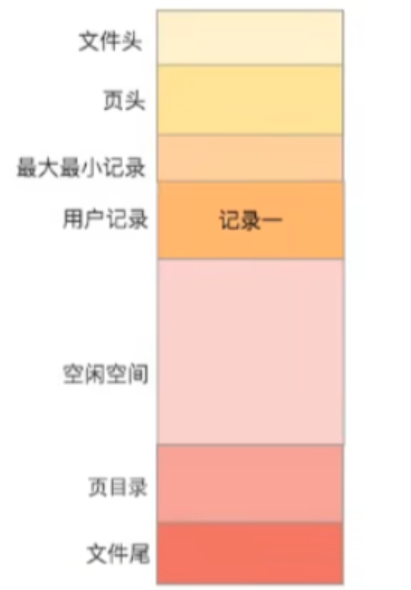
資料頁分為
檔案頭File Header (頁號/上下頁號,頁類型, 校驗和[發現異常進行回滾])
檔案尾File Trailer (校驗和,發現異常進行回滾,尾部的校驗和可以提供額外的保護)
頁頭Page Header (比如本頁儲存了多少條資料, 第一條記錄的位址等)(頁目錄的槽數量)
本頁最大最小記錄 Infimum小+Supremum大
使用者記錄 (每條記錄之間由單鏈結串列連接) 按照指定的行格式進行儲存 Mysql内部结构#COMPACT 行格式
空閒空間 會從空閒空間申請到 使用者記錄
頁目錄 (一個頁內有很多資料,為了快速查到資料,頁內也需要頁目錄) 將 4-8 個一組,每組只取出一個最大 (第一組取最小)
user record:InnoDB 行格式: Compact , Redundant, Dynamic, Compressed
Compact row format: 插入的每一條記錄都有一個变长字段的长度列表null 值列表(whether the value of each column in the record isnull)(1 represents yesNULL,0 represents noNULL)record header information:delete_maskrecords whether this record is deleted, 0 not deleted 1 represents deleted (records marked as garbage form a so called garbage linked list, called reusable space, and new data may overwrite the space of deleted records)min_rec_maskwhether it is the smallest record among non leaf nodes (B+the smallest record in the non leaf nodes of each level of the tree will add this mark, marked as 1)heap_nothe position of this record in the pagen_ownedthe last record of each group in the page directory has this value, represents how many pieces of data are in this grouprecord_typerecord type 0 represents a normal record,1 directory entry,2 represents the minimum record,3 represents the maximum record (whether it is maximum or minimum is based on the primary key, or one that is defined by yourself)next_recordthe byte offset of the next record
隐藏列Mysql internal structure#hidden columnsrow_id/transaction_id/roll_point頁與頁之間 :雙向鏈表,便於跨頁的遍歷。
頁內記錄 (行格式) 之間 :單向鏈表,便於在同一頁內的記錄遍歷。
頁目錄 Mysql内部结构#页目录 頁目錄存儲
slot, 每組最大的值
因為頁內記錄是單鏈表,需要遍歷,插入,刪除效率高,但檢索效率低,因此專門做了頁目錄來用二分法快速查找一個頁中的資料
| 操作 | 單向鏈表 (Singly Linked List) | 雙向鏈表 (Doubly Linked List) | 說明 |
|---|---|---|---|
| 遍歷 | O (n) (單向) | O (n) (雙向) | 單鏈表只能從頭遍歷;雙向鏈表可以從頭或尾遍歷。 |
| 插入 (已知位置後) | O (1) | O (1) | 找到插入位置後,操作本身時間複雜度為 O (1)。 |
| 插入 (已知位置前) | O (n) (需要查找前驅) | O (1) | 單鏈表需要在插入位置前尋找前驅節點,雙向鏈表可以直接訪問前驅節點。 |
| 刪除 (已知位置節點) | O (n) (需要查找前驅) | O (1) | 單鏈表需要在刪除節點前尋找前驅節點,雙向鏈表可以直接訪問前驅節點。 |
| 檢索 (查找特定值) | O (n) | O (n) | 都需要線性搜索,逐個比較節點的值。 |
| 記憶體佔用 | 較低 | 較高 | 雙向鏈結串列需要額外的指標儲存前驅節點,因此記憶體占用更大。 |
| 實作複雜度 | 簡單 | 複雜 | 雙向鏈結串列需要維護更多的指標,程式碼實作較為複雜。 |
假如一個頁有 1000 筆記錄,內部也要有頁目錄,而且 1000 筆全部拿來做頁目錄太大,將 4-8 個一組,每組只取出一個最大 (第一組取最小),每組取出的一個放到一個槽位 slot 中,只需要最多 250 個槽位,然後再對所有槽位進行二分法
第一個槽位 (最小記錄): 對應一筆記錄 (只有一筆通常用於確保在查找時有一個有效的起始點。其存在是為了方便範圍查詢和順序遍歷, 結構最佳化目的) 中間的槽位 (最大記錄): 均對應 4-8 筆記錄 最後的槽位 (最大記錄): 對應 1-8 筆記錄
insert into table (x,x,x) VALUES (x,x,x)  where
update table set x=x x=x x=x  where
delete FROM table where xxx
索引
功能分類: 主鍵/普通/唯一性/單列/多列/全文
索引就是表的資料結構, B+樹資料結構,Navicat 看到的資料就是透過存取叢集索引也就是 B+樹結構看到的
為了幫助 mysql 高效取得資料的資料結構
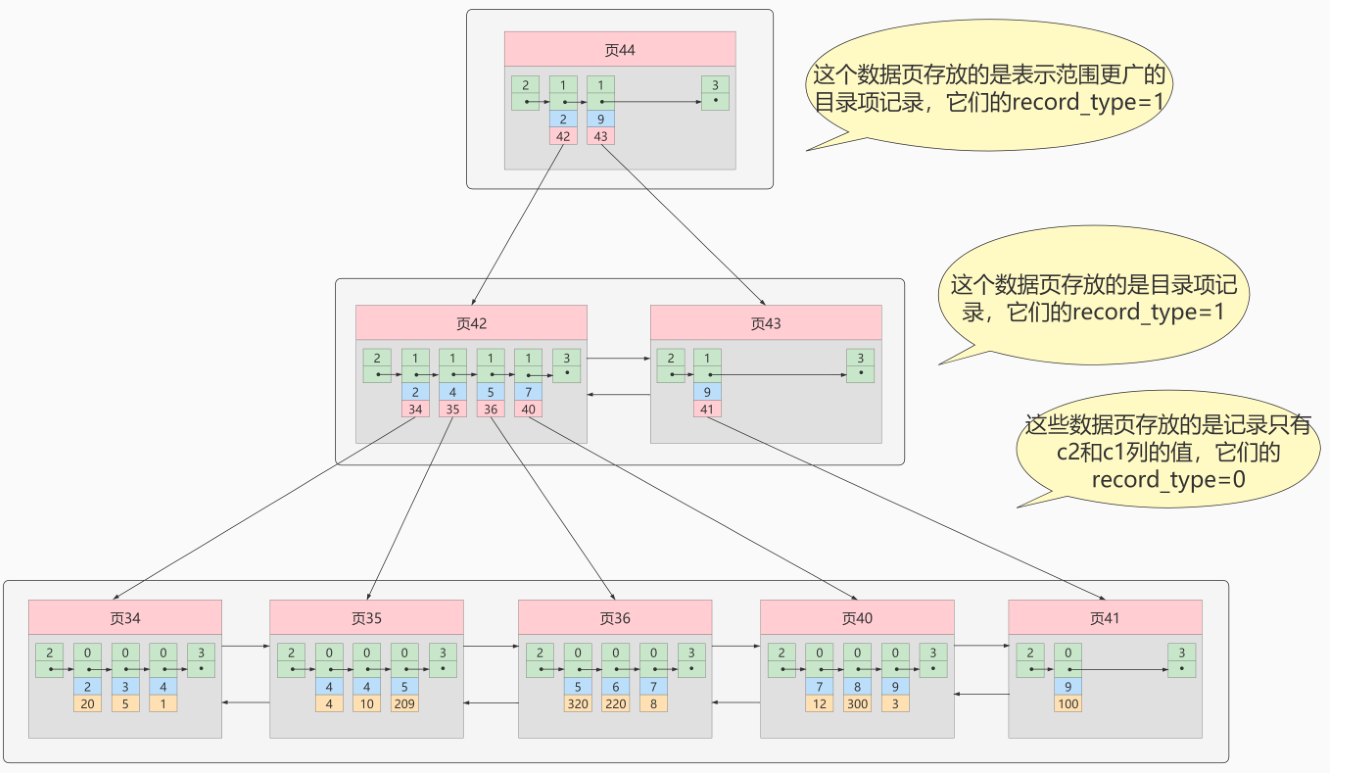
InnoDB 索引的三次迭代成 B+tree, 就是對目錄頁結構進行了增加
索引是在 storage engine 中實作的,儲存引擎可以定義表的 maximum index count 和 index length
使用索引的地方
select後需要的資料first where then group by then having then order by finally limit的位置
index advantages : 降低 IO/保證資料庫每一行資料的唯一性/減少查詢中分組和排序的時間
index disadvantages : 建立和維護索引消耗時間/索引占用磁碟空間/降低更新表的速度, 一個表上建立的索引越多,占用越多的儲存空間,增刪改的效能就越差/索引個數一般不能超過六個, 超過時表資料更改的同時,索引也會進行調整和最佳化,造成負擔,最佳化器會選擇實際的索引,多個索引時,會增加 sql 最佳化器產生執行計畫的時間,降低查詢效能
Mysql/Mysql進階 > 叢集索引 索引即資料 資料即索引
clustered index/primary key index``index is data/data is index每個表都有一個叢集索引,包含表中所有資料,也就是說表自身構成了叢集索引
clustered index 並不是單獨的索引類型,預設是按照 primary key 建構,如果沒有定義主鍵,自動將 unique 欄位作為主鍵,如果還沒有,會系統自動提供一個隱藏的欄位 Mysql/Mysql內部結構 > 隱藏欄來建構索引,所有的使用者記錄都在叢集索引的葉子節點
(secondary index)non clustered index/composite index聯合索引順序要滿足sql執行順序才能利用上 先where再group by再having再order by最後limit叢集索引與非叢集索引的比較 從 CRUD 來看 叢集索引在新增與修改時效能較差:新增與修改可能導致資料重新排序,影響效能,尤其是在大量資料插入時。叢集索引是依照主鍵,也就是真實的實體排序來儲存,而非叢集索引則是依照某個欄位排序,例如
update在 C3 時,叢集索引需要修改,而非叢集索引可能沒有儲存這個欄位,因此不需要修改
非叢集索引不會影響資料的實體儲存順序,插入與更新操作相對較快。可以依照不同的查詢需求建立不同的非叢集索引,以最佳化特定查詢。
Mysql8 支援建立遞減索引,支援隱藏索引 (有時建立索引需要消耗大量系統資源,有時需要測試有無索引的差異,直接刪除後可能又需要建立並消耗大量資源,因此支援隱藏索引)
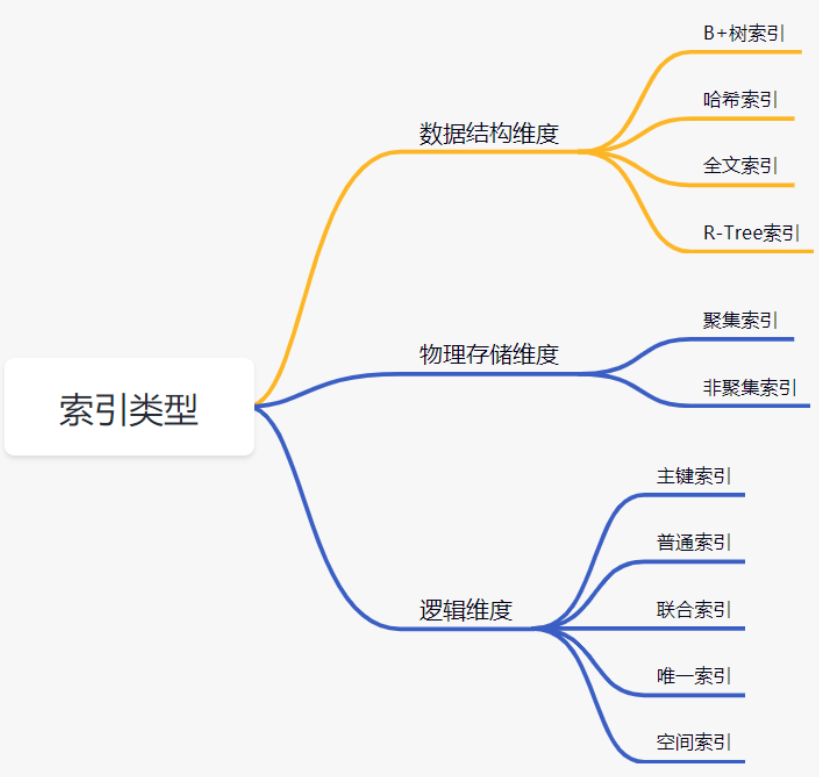
適合建立索引: UPDATE、DELETE 的 WHERE 條件欄位Group By 的/ DISTINCT 欄位,多表 JOIN 的連接欄位 limit 欄位,資料型別較小的 (節省空間),字串前綴 (前綴索引) (一部分),最左前綴 (最頻繁的放到左側),限制
不適合建立索引 : 重複資料多與 10% 的,用不到 where 的欄位,經常更新的表建立過多索引,無序值,很少使用的,重複定義的,少於 1000 筆資料的
對於 limit ,要避免如 LIMIT 1000, 10; 資料庫也並不知道第 1000 筆資料什麼時候開始 (採用書籤或自連接最佳化)
为什么程序员对这8种SQL的写法零容忍 (09_12_2023 16_30_06) ↗
效能分析工具的使用
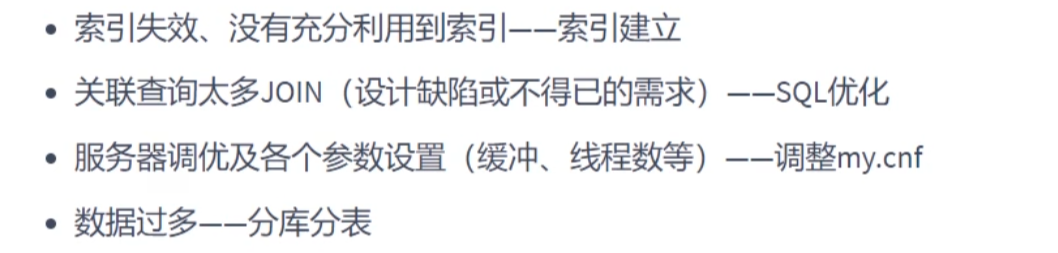
磁碟 IO>記憶體 IO>演算法時間複雜度
索引減少的是磁碟的 IO 次數,比時間複雜度 (在記憶體上) 高上一個級別;假設磁碟互動一次耗時 200 ms,而時間複雜度只耗時 4 ms
SHOW STATUS查看 MySQL 伺服器的狀態與設定。
主要用於監控一些基本效能指標,例如連線數、查詢數、鎖等待等。
上次查找開銷 : SHOW STATUS LIKE 'last_query_cost';
如果是在順序索引上查找,查找頁數的影響小,耗時區別不大,因為順序查找會一次性將頁面載入到緩衝池中
mysqldumpslow針對定位執行緩慢的 SQL (預設 10 秒)
Mysql 或 Mysql 進階 > 慢查詢日誌分析工具: mysqldumpslow
Performance Schema提供對 MySQL 伺服器效能的詳細監控
- 允許收集與分析多種效能指標,例如鎖、等待事件、I 或 O 等。
- 提供即時監控能力,適合長期效能分析與趨勢觀察。
explain用於分析 SQL 查詢的執行計畫EXPLAIN可以查看最佳化器具體的執行計畫是什麼
8.0 之後 explian 引入了樹狀的 explain 輸出FORMAT=tree
EXPLAIN DELETE FROM tabe where XXXX # 並沒有真正刪除,只是查看執行計畫是什麼
Mysql 或 Mysql 進階 > EXPLAIN 各欄位的作用
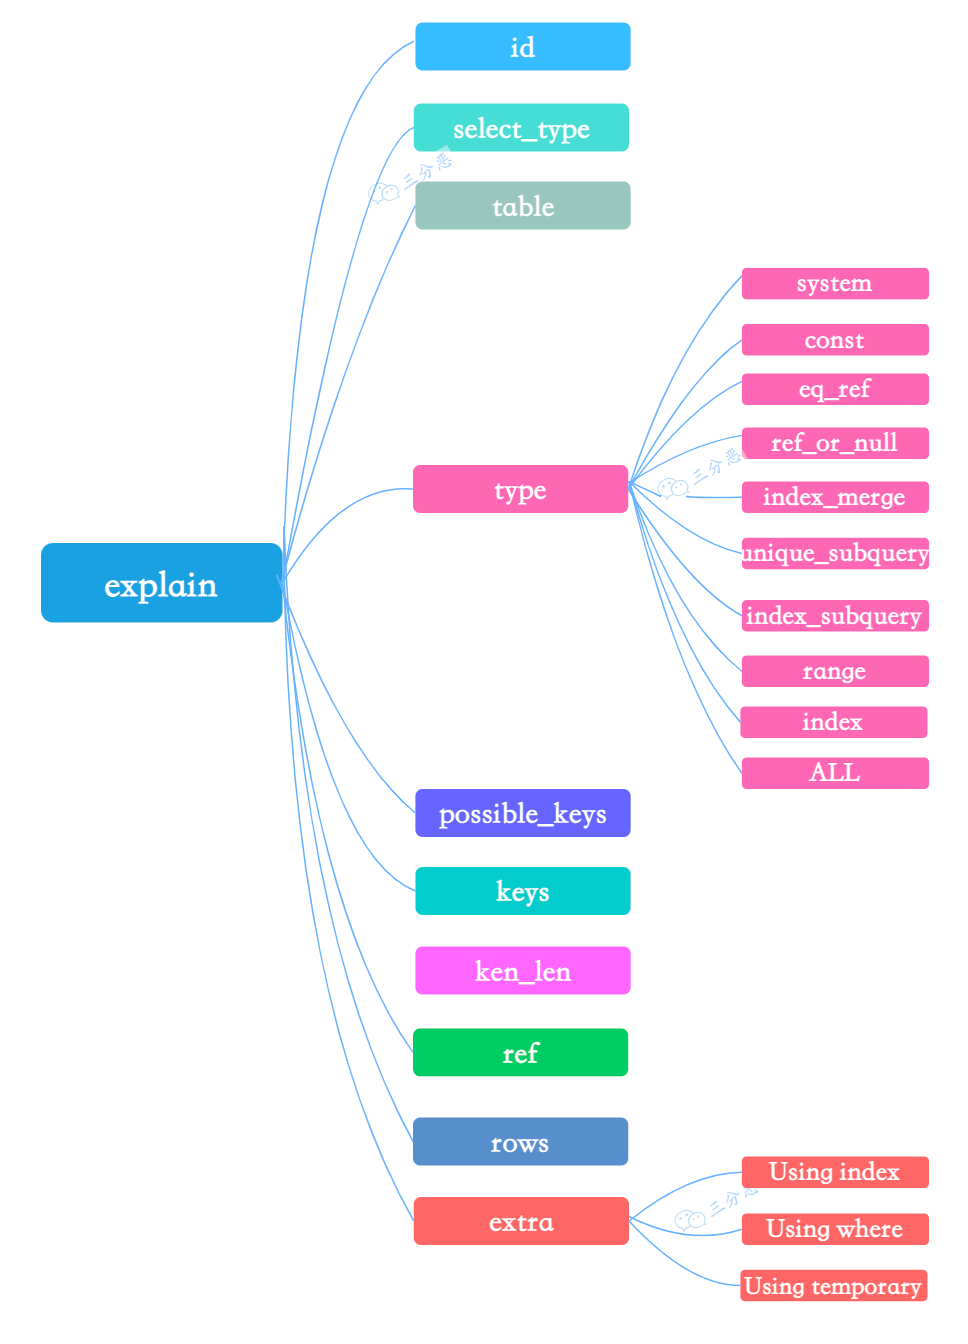
explain 各項
id/select_type/table/type/possible_keys/key/key_len/ref/rows/filtered/Extra
id : 幾個 select 就有幾個 id, 最佳化器會將巢狀重寫為多表連接
select_type : primary,union.subquery 不包含 union 的或子查詢的都算是 simple
type:
system表只有一行,一般是系統表,往往不需要進行磁碟 IO,速度非常快const使用主鍵或唯一索引進行只返回一行的等值匹配eq_ref被驱动表is through the primary key orunique secondary index column equality matchingaccessed by the method ofrefwhen through普通的二级索引列and常量perform等值匹配to query a certain tablefulltextindicates using full text index lookup, suitable for full text search on text fieldsref_or_nullwhen performing equality match query on a normal secondary index, the value of the index column can also beNULLvalueindex_mergeindicates using multiple indexes for query,MySQL merges the results of multiple indexesunique_subqueryoptimization when a subquery returns a unique value, usually used for IN subquery.index_subquerysimilar tounique_subquery,but the subquery may return multiple rows.rangeonly retrieves rows of a given range, using索引to retrieve. Inwhereused in statementbettween...and、<、>、<=、inand other condition queriestypeall arerangeindexindicates full index scan, although compared to full table scan (ALL)faster, but still not the best choice, usually used when using the last condition of a composite index,index,this indicatesMySQLdid indeed scan the index, but it does not mean the query effectively used the index. It still counts as index failureALTER TABLE `countries` ADD INDEX (country_id,region_id,country_name); Explain SELECT * FROM countries WHERE country_name equals Canada;ALLthe least efficient full table scan system > const > eq_ref > ref > range > index > ALLpossible_keyscolumn: indexes that may be used, but are not necessarily actually usedkeythe index actually used. If it isNULL, then no index was used.key_lenMySQLthe index length decided to be used (in bytes), the index length actually used, convenient for checkingwhether the index is fully utilized, compared to its own value such asvarcharrange ofthe larger the value the better, mainly for composite indexes, has certain reference significance, when a table has multiple indexes available,key_lenthe field can help identify which index is most effective, whether the index is fully utilized
 EXPLAIN SELECT * FROM s1 WHERE key_part1 = 'a';#  KEY_len=303
 EXPLAIN SELECT * FROM s1 WHERE key_part1 = 'a' AND key_part2 = 'b'; #  KEY_len=606
 EXPLAIN SELECT * FROM s1 WHERE key_part1 = 'a' AND key_part2 = 'b' AND key_part3 = 'c'; # KEY_len=909
refcolumn: the source of values used for comparison with the index columnrowsestimated number of records that need to be readthe smaller the value the betterfilteredthe percentage of remaining records after a table is filtered by search conditions, determines the number of times the driven table must execute,rowsmultiplied byfilteredget the number of satisfied recordsExtraadditional information about query executionUsing index``covering indexuse wherenormalwhereof using indexwhereno hint, isNullWHEREcondition is alwaysfalsetype will hintimpossible WHEREusing MRR(disabled by default)for secondary index range queries, first cache and sort the query results of the secondary index, then uniformly go back to the clustered index for table lookup
index covering: the desired data can be queried without going back to the table, the leaf nodes happen to have these two pieces of data, that is, select the data in is exactly in the index
ALL the earlier the more efficient, the last three are the least efficient
index failure
index failure means the query failed to effectively use the index, causing performance degradation
type is Index 就算是index failure
clustered index : 物理儲存按照索引排序
nonclustered index : 物理儲存不按照索引排序
MySQL 與 MySQL 進階 > 索引失效案例
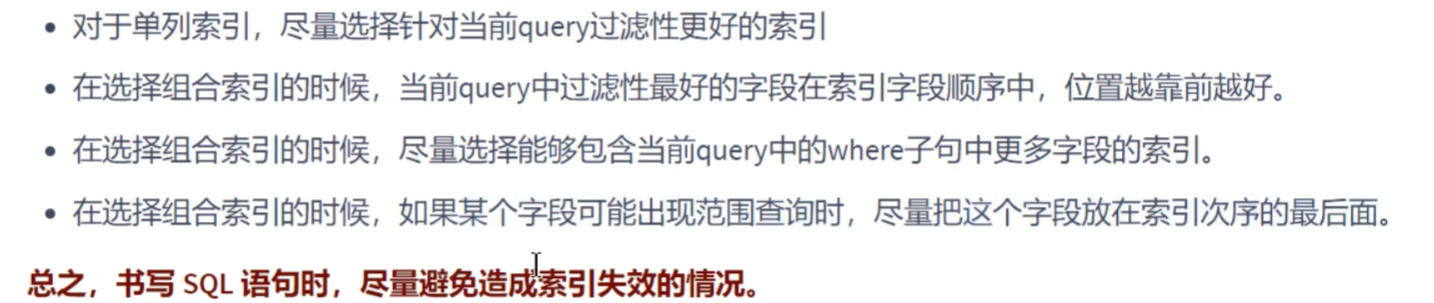
(+,-,!=)和function(mysql也不知道是什麼函式,會將資料一筆一筆取出,進行函式操作)最左前綴原則
type conversion(自動或手動) (可能會導致資料庫系統無法使用索引,從而導致全表掃描, 行鎖升級為間隙或臨鍵鎖,導致卡住)聯合索引中使用範圍的欄位,該右邊的欄位索引失效 (並列
and, 或where後的Order by)(右邊的欄位不能繼續使用上索引),但是宣告範圍的欄位本身可以使用索引,如果範圍欄位比較影響效能,就考慮使用範圍,sacrifice其他欄位的索引,有時範圍上建立索引能大大減少資料量,盡可能讓使用索引的過濾掉更多資料 (and 左右順序最佳化工具可以最佳化,但索引順序是固定的)(或者將宣告範圍的欄位設定為聯合索引的最後一個欄位,則就都能用上索引了)
 宣告範圍的是聯合索引最後一個欄位
以萬用字元
%開頭的索引失效,嚴禁left/full fuzzyOR前後 存在非索引 的欄, 索引失效, 必須左右兩個都有索引ascending and descending要想使用索引需要保持一致left/right join關聯查詢的field encoding format不一樣,連接田間的字符編碼格式不一樣,可能導致索引失效, 資料庫和表的字符集統一使用utf8mb4,統一字符集轉換產生的亂碼,不同的character set進行比較前需要進行conversion會造成索引失效is not null(possible)是不等於某個值 , 導致索引失效 (回表次數太多,資料量太大,成本太高,最佳化工具會強制執行全表),is null可以使用索引 , 最好設計式將欄位設定為not null條件約束資料量小,最佳化工具會選擇不用索引
Mysql 最佳化工具估計使用全表掃描要比使用索引快 , 則不使用索引
and 左右的語句順序不會影響聯合索引,最佳化工具會自動對語句進行排序
Order BY 中的欄位如果進行升序或者降序,需要所有欄位保持一致才能用上索引
有時不會全部索引都用,最佳化工具最佳化可能會覺得沒必要使用第二個索引
另外,SQL 語句是否使用索引,跟資料庫版本,資料量,資料選擇度都有關係
##### `Join` optimization

`simple/index/block/ Nested-Loop join`
[[Mysql optimization#index optimization and query optimization]]

sometimes outer joins are changed to inner joins by the optimizer

for inner joins

if there are no indexes at all: (small result set drives large result set)
if only one index is added, The table containing the indexed field is treated as the`被驱动表`
If all have indexes, The optimizer decides by itself who acts as the driving table, It chooses the one with less data as the driving table, The one with more data acts as the large table, Automatic selection has low cost (Small table drives large table)

`simple/index/block/ Nested-Loop join`

`simple` : Driven table (Non driving table) Loaded into memory, the driving table takes out one row of data, and after traversing the non driving table it is cleared, so it must be reloaded next time
`index` : On the driven table `有` Index, the driving table compares against the index, then goes back to the table to get the data, When both tables have indexes it is also index
`block` : Driving table`没有`When indexing, Load some data of the driving table at once, so the driven table does not need to be cleared after being loaded once, compared with simple Saves a large amount of resources

Which join algorithm is used specifically depends on the query execution plan and the decision of the optimizer


##### Subquery optimization (Temporary table)

Avoid using subqueries, because `mysql` It will create `临时表` To complete the subquery, and after the query completes these tables are dropped , Consumes excessive `CPU` And `IO` Resources, and the created temporary table does not have any index

Through `Join` A query can replace a subquery, does not need to create a temporary table, and with an index, Is much faster than a subquery


#####  `Order By` Sort optimization

[[Mysql Advanced#Sort optimization|Mysql/Mysql Advanced > Sort optimization]]

`Extra` In `Using index/Using FileSort`

`Using index` Does not sort, Uses an index, and the index already guarantees order
`Using FileSort` Sorts in memory, Requires additional disk IO And sorting processing time, Usage CPU High, it is not necessarily the slowest, in the case it is faster than `using where` Fast

On `WHERE` Using an index is to avoid a full table scan
On `Order BY` Using an index is to avoid `FileSort` Sorting,`Index` Sorting is more efficient

The amount of data is too small `Group By` It will not use an index, Or only uses part of a composite index


`UsingFileSort` It is not necessarily the slowest, if `where` After filtering, the amount of data is very small, it may be faster than ` index` Even faster

`Order BY` If the fields in`升序`Or`降序`,All fields need to stay consistent to use the index, if the sorted data rows exceed the length set by this parameter,`MySQL` It uses a disk based sorting algorithm (for example using a temporary file), otherwise it uses in memory quicksort.


```ad-info
title:Introduction

![[assets/Mysql Advanced/image-20231217164859352.png]]

![[assets/Mysql Advanced/image-20231217165241344.png]]
![[assets/Mysql Advanced/image-20231217165249432.png]]
`name` also used

![[assets/Mysql Advanced/image-20231217165551724.png]]
![[assets/Mysql Advanced/image-20240120172156467.png]]
![[assets/Mysql Advanced/image-20240120172546935.png]]
![[assets/Mysql Advanced/image-20240120172151464.png]]
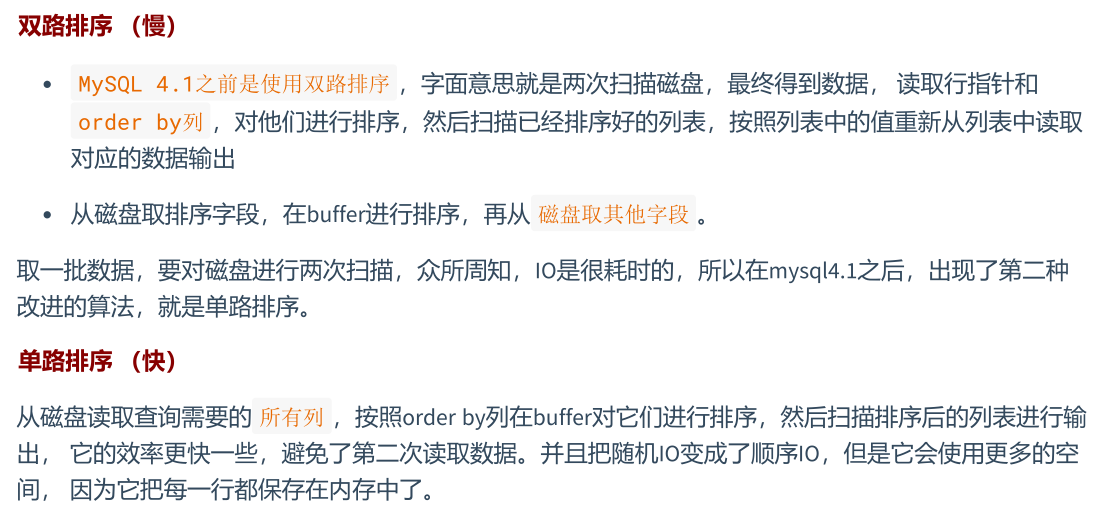
filesort 演算法:雙路排序和單路排序
- 當可用記憶體足夠大以容納所有待排序資料時,MySQL 會使用單路排序。
- 當資料量超出可用記憶體時,MySQL 將採用雙路排序。
GROUP BY 最佳化
group by 使用索引的原則幾乎跟 order by一致,group by 即使沒有where過濾條件用到索引,也可以直接使用索引。
實在無法使用索引時,調整參數,增大 max_length_for_sort_data 和 sort_buffer_size 參數的設定,分別影響排序資料的處理和排序緩衝區的大小。
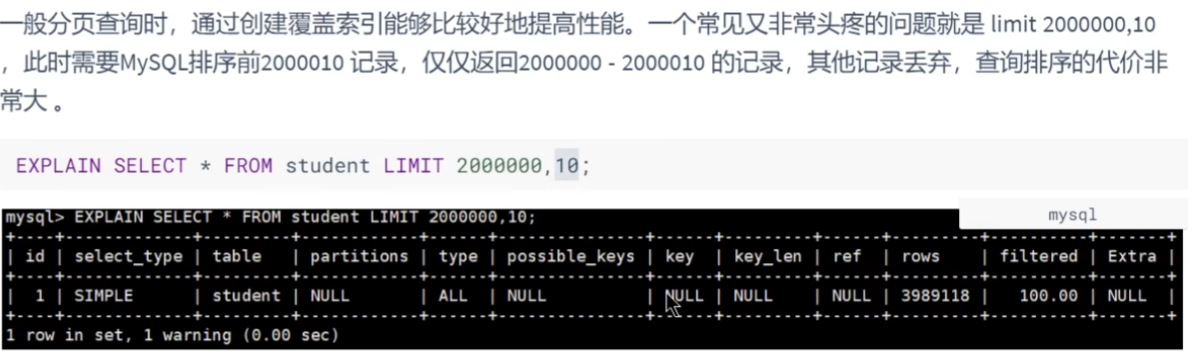
分頁查詢最佳化
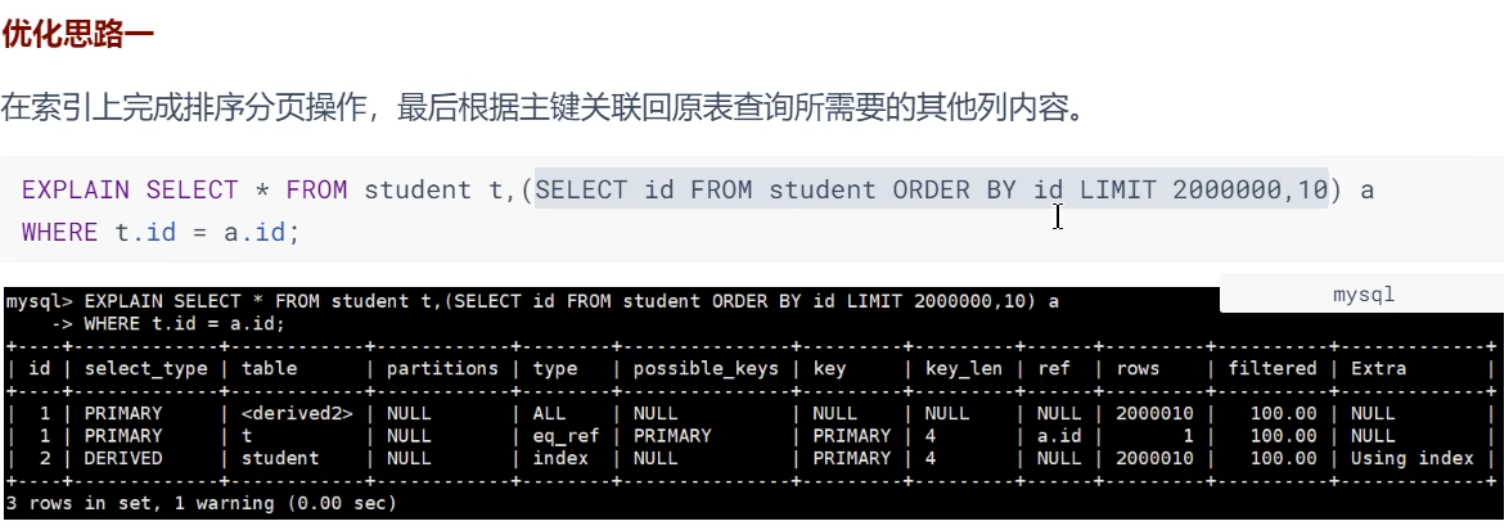
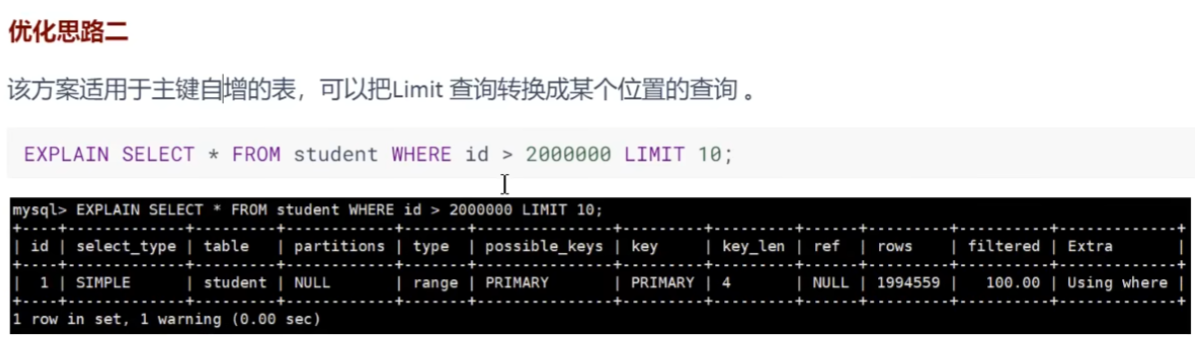
最佳化考慮索引, 將 LIMIT 操作轉化為可以使用上主鍵索引的操作
- 書籤方式最佳化: 使用上一次查詢的位置
- 使用索引
- 先
order by/where減少資料量後再Limit
self join最佳化
換成等值連接


info
往索引上靠
索引覆蓋
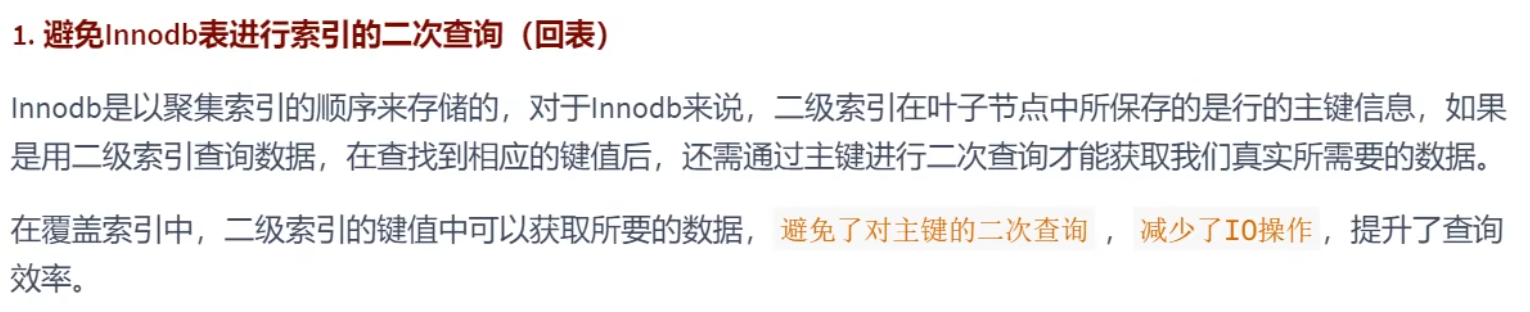
索引覆蓋特指使用非聚簇索引(如輔助索引)來滿足查詢的條件, 索引中包含查詢需要的全部資料

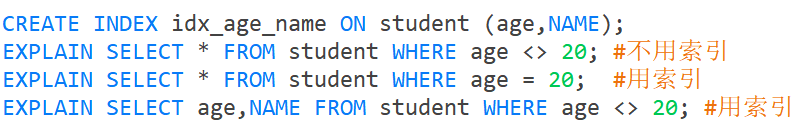
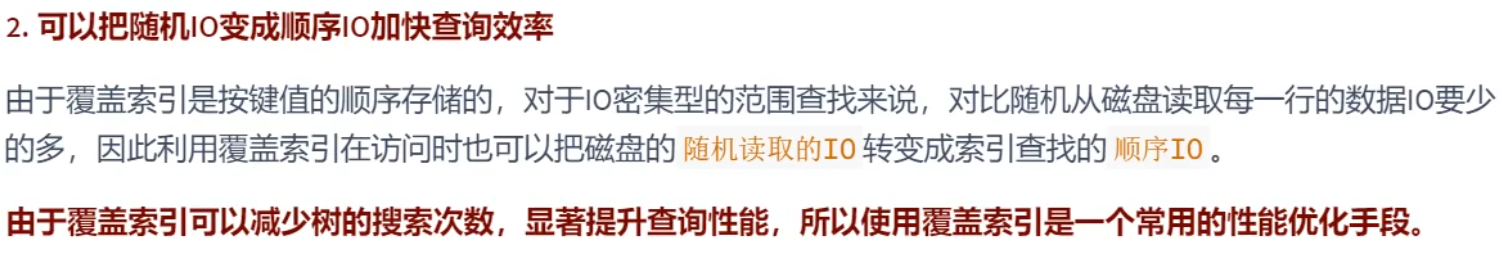
避免回表造成二次查詢,效率降低,把隨機 IO 變成了順序 IO 但需要人員來維護索引欄位
EXPLAIN SELECT * FROM student WHERE age = 20 用上索引但是回表,會快速透過索引找到滿足 age 為 20 的主鍵id,然後再根據主鍵進行回表從聚簇索引查找
優先考慮覆蓋索引 (不需要回表)
利弊
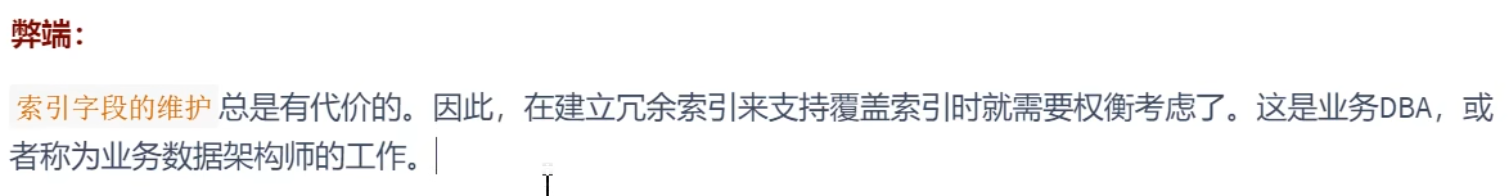
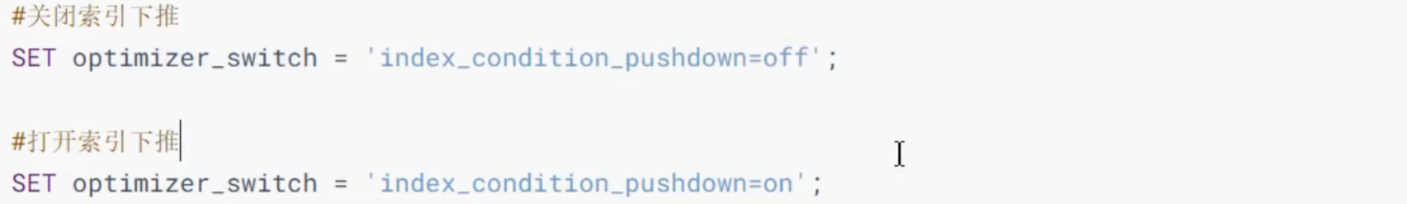
索引下推 (ICP: index condition push)
Extra:Using index condition
兩個查詢條件都是same field時,當另一個索引失效時, 再進行查詢時 , 不再回表,直接用第一個條件查出的資料進行過濾
索引下推
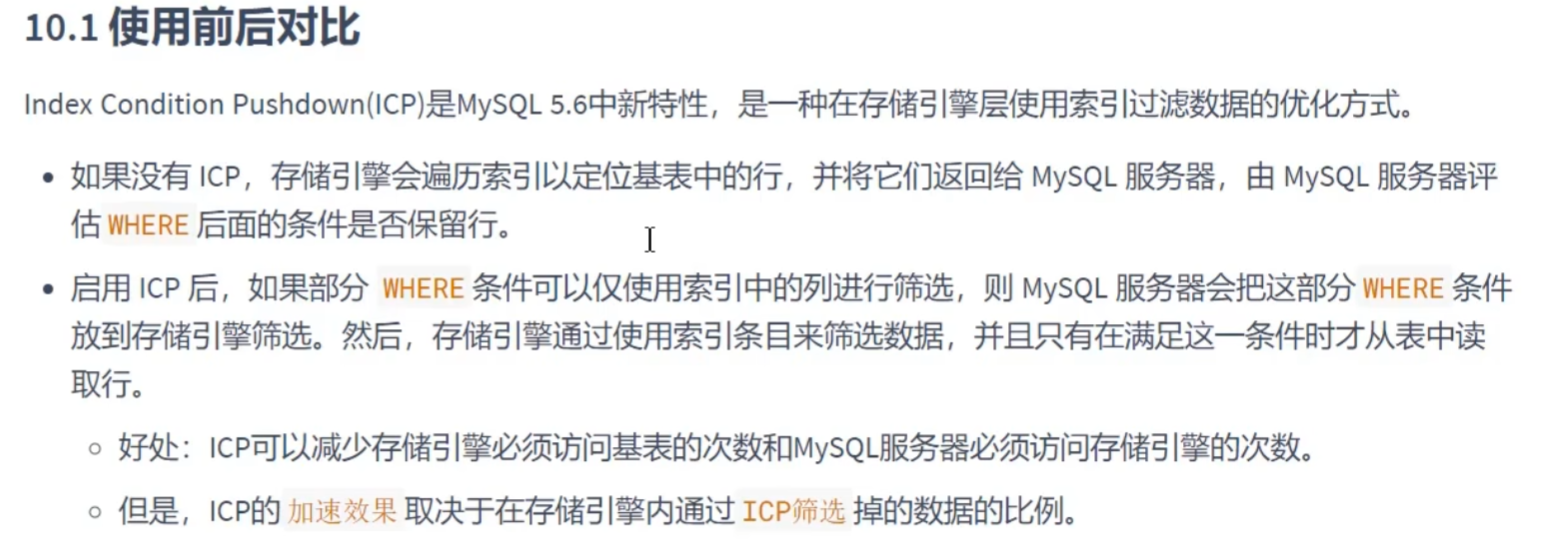
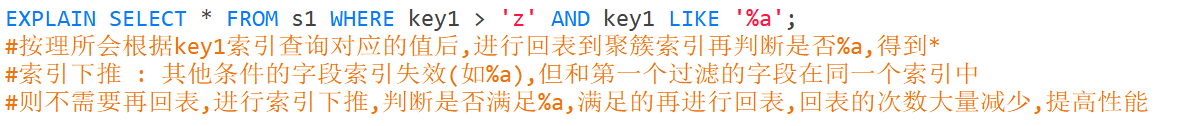
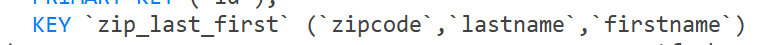
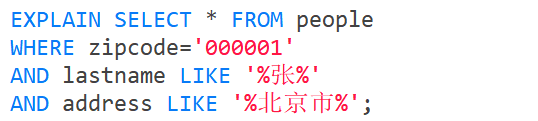
- 索引下推開啟關閉
ICP使用條件
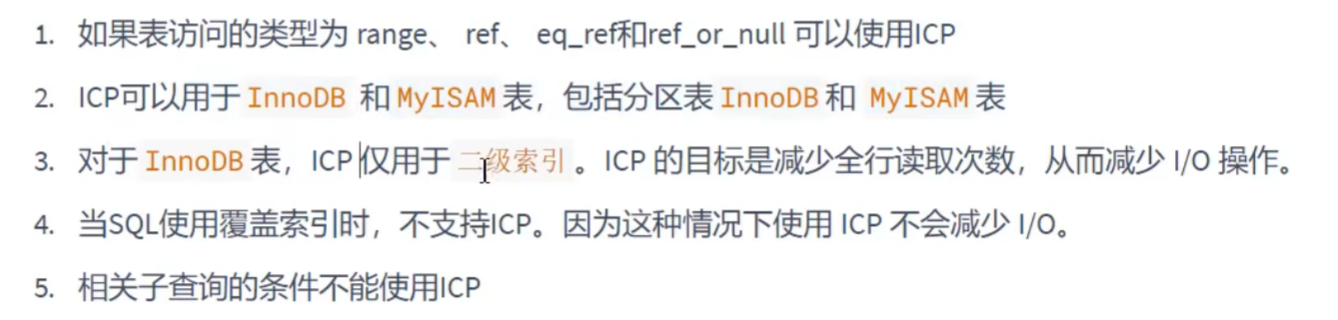 聚簇索引不需要回表不需要回表的都用不了
ICP
其他
Mysql/Mysql進階 > 其他查詢最佳化

EXISTS和IN的區分
in 語句是把外表和內表作 hash 連接,
exists 語句是對外表作 loop 迴圈,上面的 join,迴圈
- 如果查詢的兩個表大小相當,那麼用
in和exists差別不大。 - 如果兩個表中一個較小,一個是大表,則子查詢表大的用
exists, 子查詢表小的用in not in和not exists:not in, 沒有用到索引, 那麼內外表都進行全表掃描,not extsts的子查詢依然能用到表上的索引。所以無論哪個表大,用not exists都比not in要快
索引下推(預設開啟)
SQL 中兩個查詢條件都是 同一個欄位 時,一個查詢條件能用上索引,而另一個查詢條件不能用上索引,另一個不能用上索引的查詢條件, 無需再回表,直接用第一個使用上索的查詢條件的資料

一般索引 vs 唯一索引 change buffer
一般索引 vs 唯一索引 ,兩者在查詢能力上沒有差別,
Change Buffer 是 InnoDB 用於最佳化非唯一索引更新操作的一種機制。它位於共享緩衝區(Buffer Pool)中,用於快取對二級索引頁的變更。
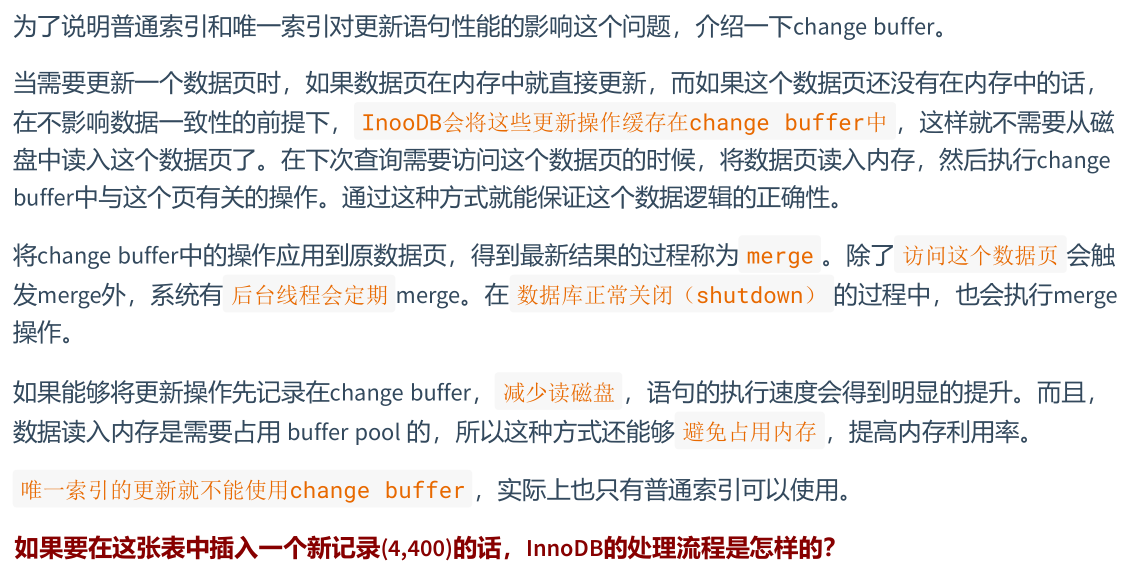
唯一索引 的更新不會使用 change buffer ,一般(二級)索引 : 更新效能 好,可以和 change buffer 來配合使用,對資料量大的表更新最佳化比較明顯,如果在更新後面都馬上伴隨著查詢,就應該給關閉 change buffer,而其他情況下 change buffer 可以提高效能(更新快取操作會快取到 change buffer 中,避免了從磁碟重新讀入)
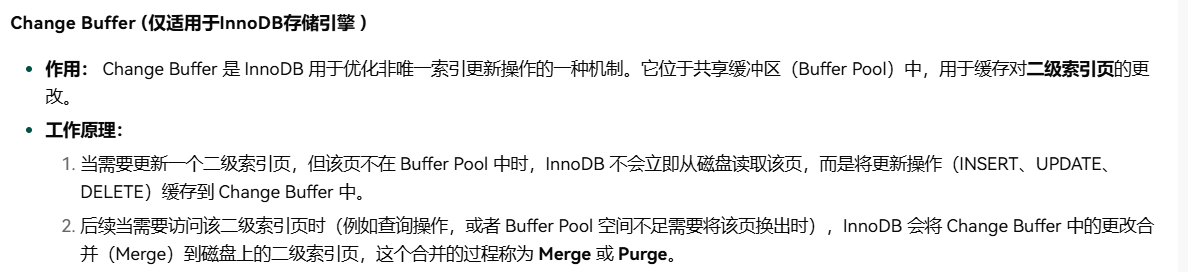
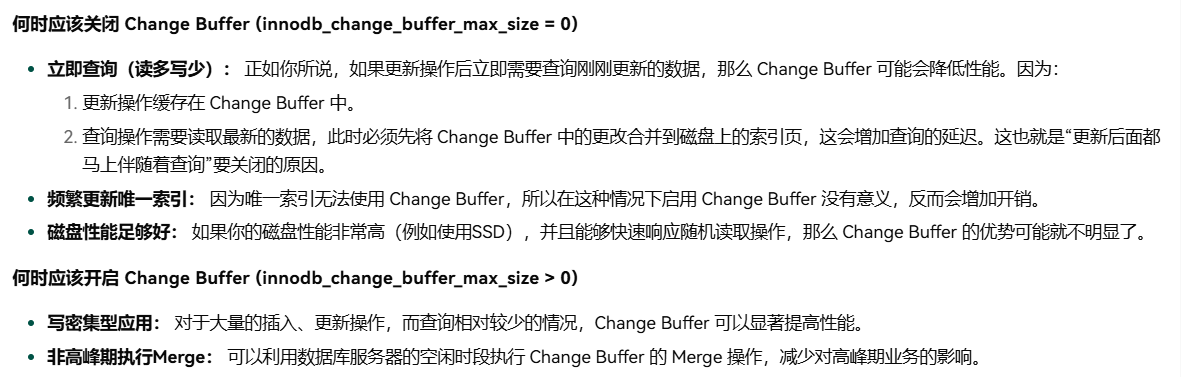
如果主要考慮的是對 的影響,建議,
Change Buffer 是一個記憶體結構,它用於儲存對二級索引的修改(如插入、更新和刪除)而不立即將這些變更寫入磁碟。這樣可以減少對磁碟的 I/O 操作,從而提高效能。
總結 : 經常修改 : 一般索引
一般索引 vs 唯一索引
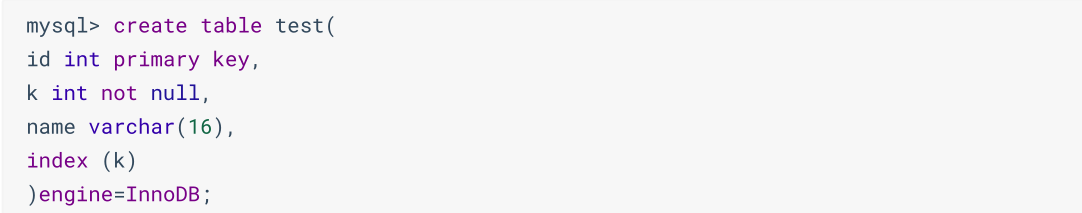
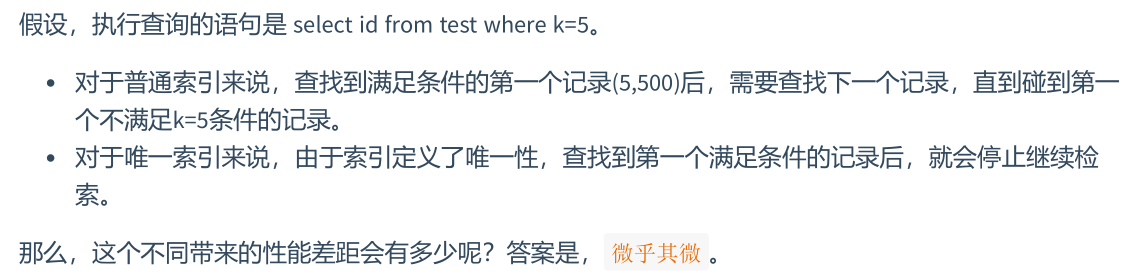
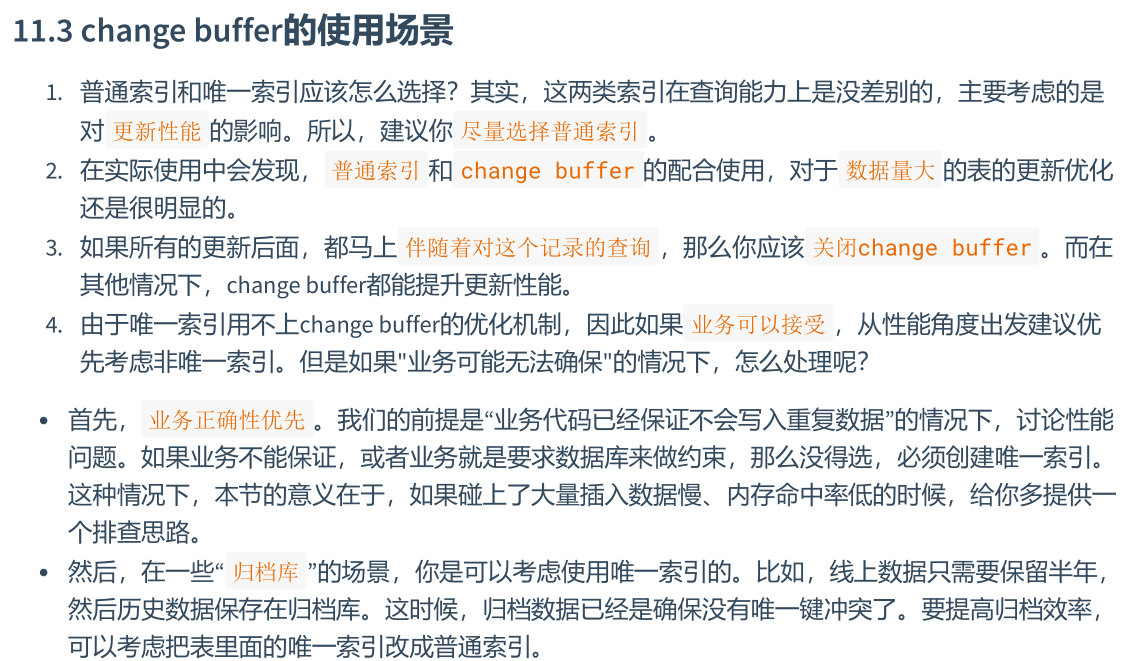
一般索引查找到符合條件的記錄後會繼續查,直到碰到不符合的記錄,對於唯一索引,查到符合記錄的就不會往下繼續查了
change buffer : 當要更新一個資料頁的時候,如果頁在記憶體就直接更新,沒有就會更新到 change buffer 中,避免直接從磁碟讀取資料,在 change buffer 中執行和頁有關的操作,然後系統後台會有執行緒定期 merge,也就是更新到原資料頁中 ,資料庫關閉時也會 merge,透過 change buffer ,語句的執行速度會得到顯著提升,還能透過這種方式避免讀入記憶體佔用 buffer pool
LIMIT 1對最佳化的影響
對於一般索引 : 如果知道結果只有一條,這樣獲取到一條結果就不會繼續進行掃描了, 會加快速度 對於唯一索引 : 沒有區別
commit
commit 可以提高效能
釋放資源 : 回滾段用於恢復資料的資訊/被程式語句獲取的鎖/ redo/undo log buffer 中的空間
淘寶資料庫,主鍵如何設計的?
淘寶資料庫,主鍵如何設計的?
並沒有使用主鍵 ,因為不可靠,不安全 ,效能查 ,互動多,不具有全域唯一性
淘寶訂單 ID = 時間+去重欄位+使用者 ID 後 6 位尾號
Mysql/Mysql高階 > 淘寶資料庫,主鍵如何設計的?
不適合索引時
where 用不到的欄位/資料重複率高,不能快速定位/資料量小的表 (小於 1000),索引建立意義不大/資料經常更新的表/無序欄位/很少使用的索引應刪除/冗餘重複索引
總結
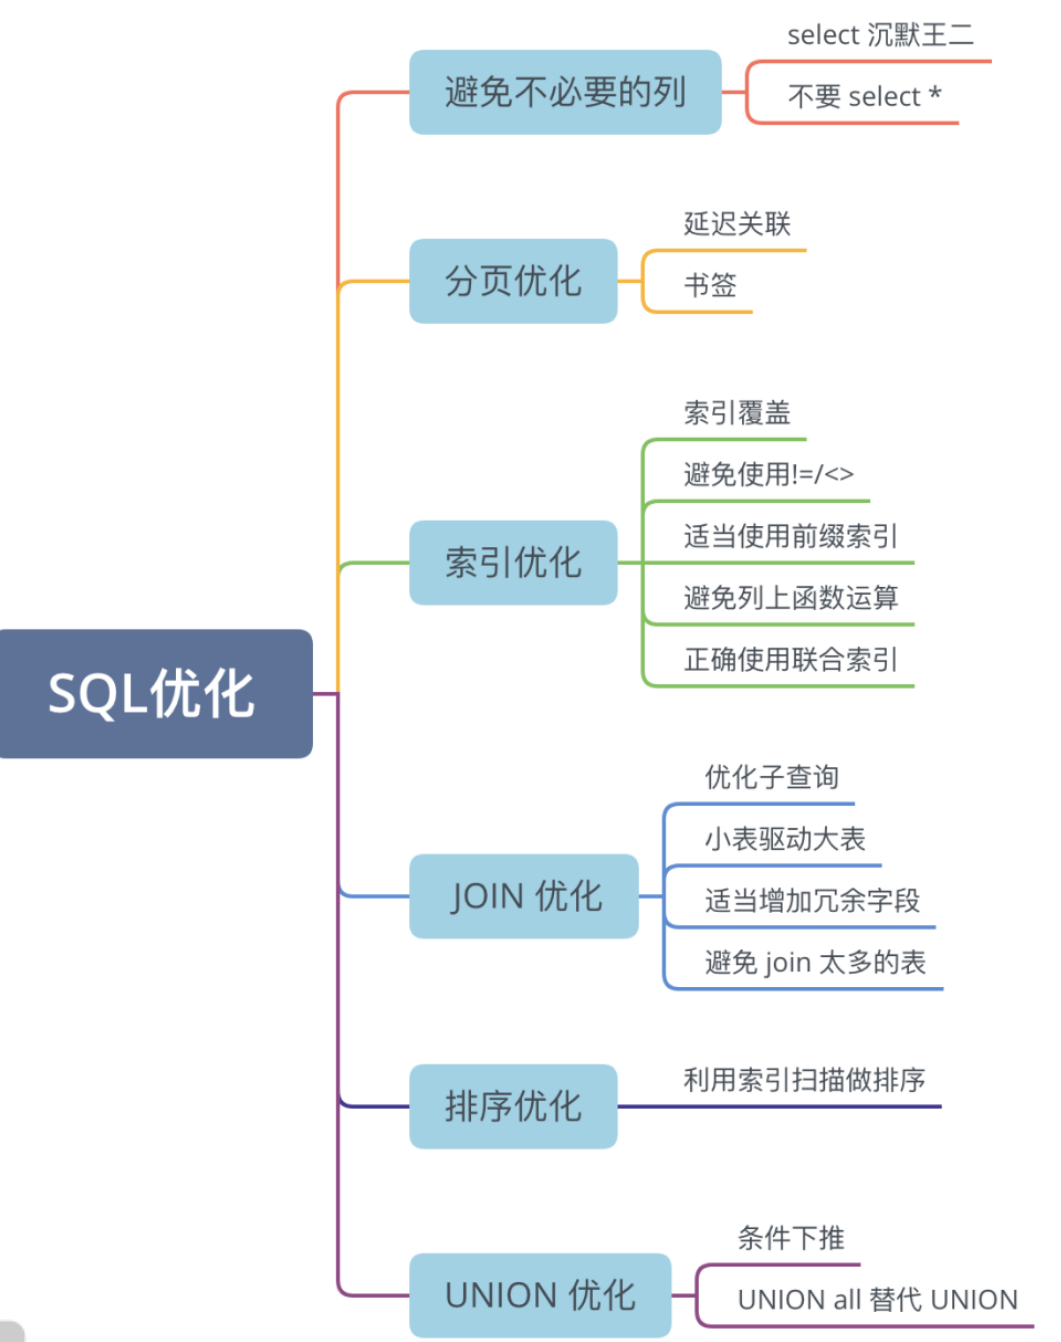
最佳化就是透過 explian 分析目前 sql 語句, 針對 where / join / 排序 / GROUP BY / limit 這些語句分析是否有可最佳化的空間, 查看索引使用情況,使用了多少索引,是否索引覆蓋 (無需回表, 隨機 IO 變成了順序 IO) , 避免索引失效
如果是 join 要看 filtered
索引覆蓋:不用回表就能查到想要的資料
where 效率高於 having ,能寫在 where 限定的條件就不要寫在 having 中了
減少 order by,排序放到程式端去做
含了 order by、group by、distinct 這些查詢的語句,where 條件過濾出來的結果集請保持在1000行以內,否則 SQL 會很慢
有哪些方式優化慢 SQL
慢查詢日誌:開啟 MySQL 的慢查詢日誌,再透過一些工具比如mysqldumpslow去分析對應的
慢查詢日誌,當然現在一般的雲廠商都提供了視覺化的平台。服務監控:可以在業務的基建中加入對慢 SQL 的監控,常見的方案有位元組碼插樁、連線池擴充、ORM框架過程,對服務運行中的慢SQL進行監控和告警。
範式
減少資料冗餘,提高資料完整性和一致性,並使資料庫結構更加清晰。
Mysql高级#范式
第一 : 每個欄位具有原子性,不可拆分
第二 : 滿足第一範式的基礎上,滿足資料表中每一筆資料記錄都是可標識的,所有非主鍵欄位必須完全依賴主鍵,不能只依賴主鍵的一部分,也就是必須要用上所有主鍵欄位才能推導出主鍵,才算第二範式
(姓名, 學號,課程號-->成績) 滿足
(姓名, 學號,課程號,性別-->成績) 不滿足
第三 : 在第二的基礎上,確保每個主鍵欄位都和主鍵直接相關
反正規化 : 一般第一範式遵循,第二第三不遵循,比如專門設計冗餘欄位
什麼時候考慮冗餘欄位 : 這個欄位查詢不可或缺,不需要經常進行修改
ER 模型
表的個數或欄位或聯合主鍵的欄位越少越好 使用主鍵和外鍵越多越好
事物
事物是 一組邏輯的操作單元 ,是資料從一個狀態轉變成另一個狀態
最早起源於金融行業,後來電腦需要資料一致性操作時,自然而然的進行了引用
ACID特性atomic , consistency ,isolation, durable
原子性 (基礎) : 事物狀態全部保持一致,要麼全部提交,要麼全部失敗回滾,不會出現中間狀態,就像一個原子一樣不可分割。 (例如,程式崩潰、死鎖等, UNDO LOG 回滾日誌實現,如果事務中途失敗或被顯式回滾,系統可以透過 UNDO LOG 恢復到事務開始前的狀態。)
一致性 (約束) : 事務執行前後,資料從一個合法性狀態轉變成另一個合法狀態,一致性保證事務的執行不會違反資料庫的完整性約束 (UNDO LOG 回滾日誌實現 UNDO LOG 會確保所有的修改都被撤銷,從而使資料庫返回到事務開始前的一致性狀態)
隔離性isolation (手段): 一個事物的執行過程中不能被其他事物干擾 ( 鎖機制 實現)(隔離級別)
持久性 (目的):事物一旦被提交,對資料庫的資料改變就是永久的 (REDO LOG 重做日誌實現,系統在事務提交後立即崩潰,REDO LOG 也可以用來重做這些操作)
undo 日誌確保了原子和一致性,redo 確保了持久性
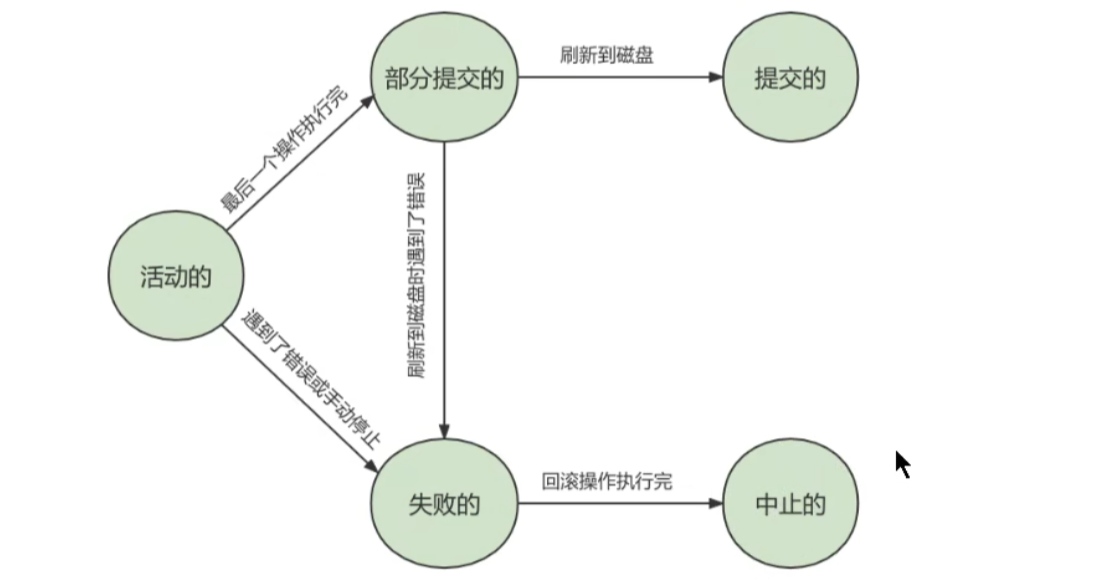
事物的狀態
活躍的/部分提交的 /失敗的/中止的/提交的
Mysql事物併發問題
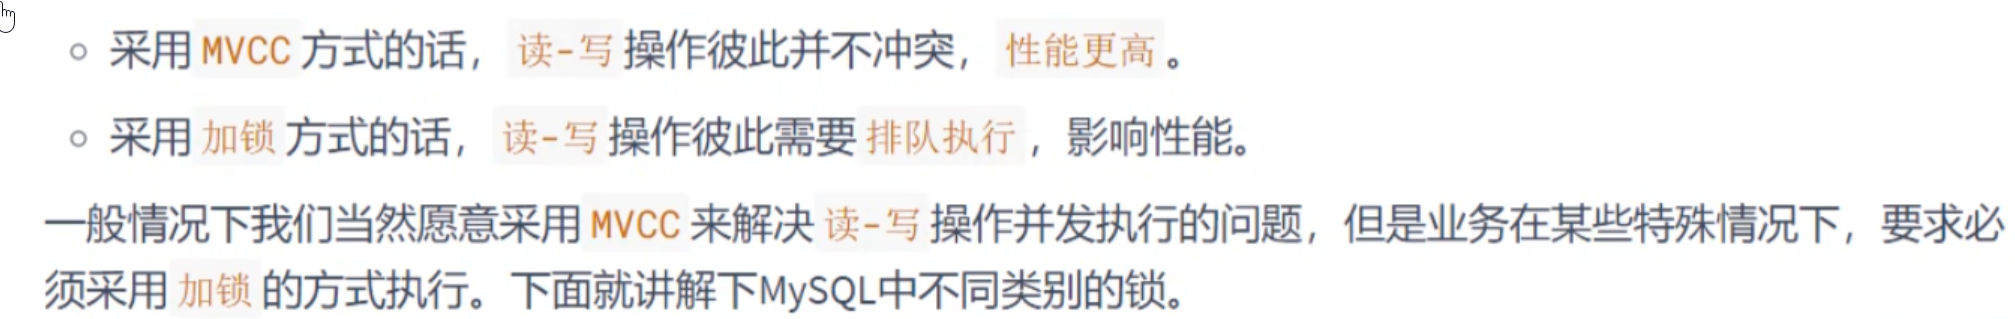
mysql 8.0 預設的隔離級別為 可重複讀
- 可重讀讀隔離級別
寫-寫:寫鎖解決讀-寫:不加鎖, MVCC 快照讀(多版本併發控制),不影響寫,可以同時讀寫,但可能存在資料不一致問題,因此某些業務必須要手動加鎖
在可串行化隔離級別下,大多數情況下不需要手動加鎖,因為資料庫會自動處理。
MVCC 在特定場景下提供了更優的解決方案,這並不意味著讀寫鎖不再有用
- 多版本併發控制
MVCC: 就是生成ReadView來找到歷史版本 (由 undo 日誌 ) , 不同隔離級別控制不同,也就是生成ReadView的時機不同READ COMMITTED: 每次執行SELECT操作時都會生成一個ReadView, 讀也就是select只會看到生成ReadView之前已經提交事物所做的更改 , 之後或者未提交的看不到 ,解決了髒讀REPEATABLE READ: 一個事務在執行過程中只有第一次執行SELECT操作才會生成一個ReadView,在本事物結束前,之後的SELECT操作都複用這個ReadView,這樣也就避免了不可重複讀和幻讀的問題
不能保證獲取資料是最新的, READ COMMITTED 相對 REPEATABLE READ 更新一點
髒寫 > 髒讀 > 不可重複讀 > 幻讀 (都是 隔離性 沒有保證所引發的問題)
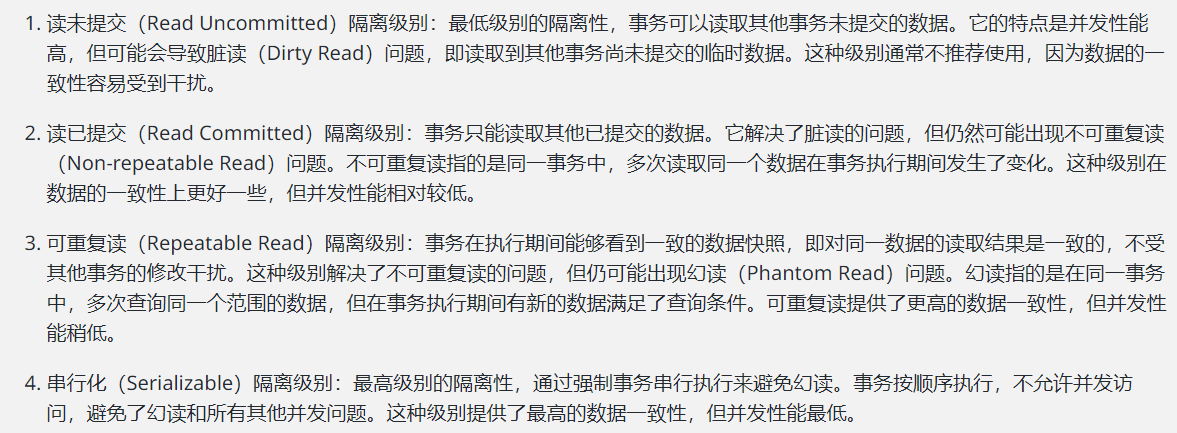
讀未提交>讀已提交>可重複讀>串行化
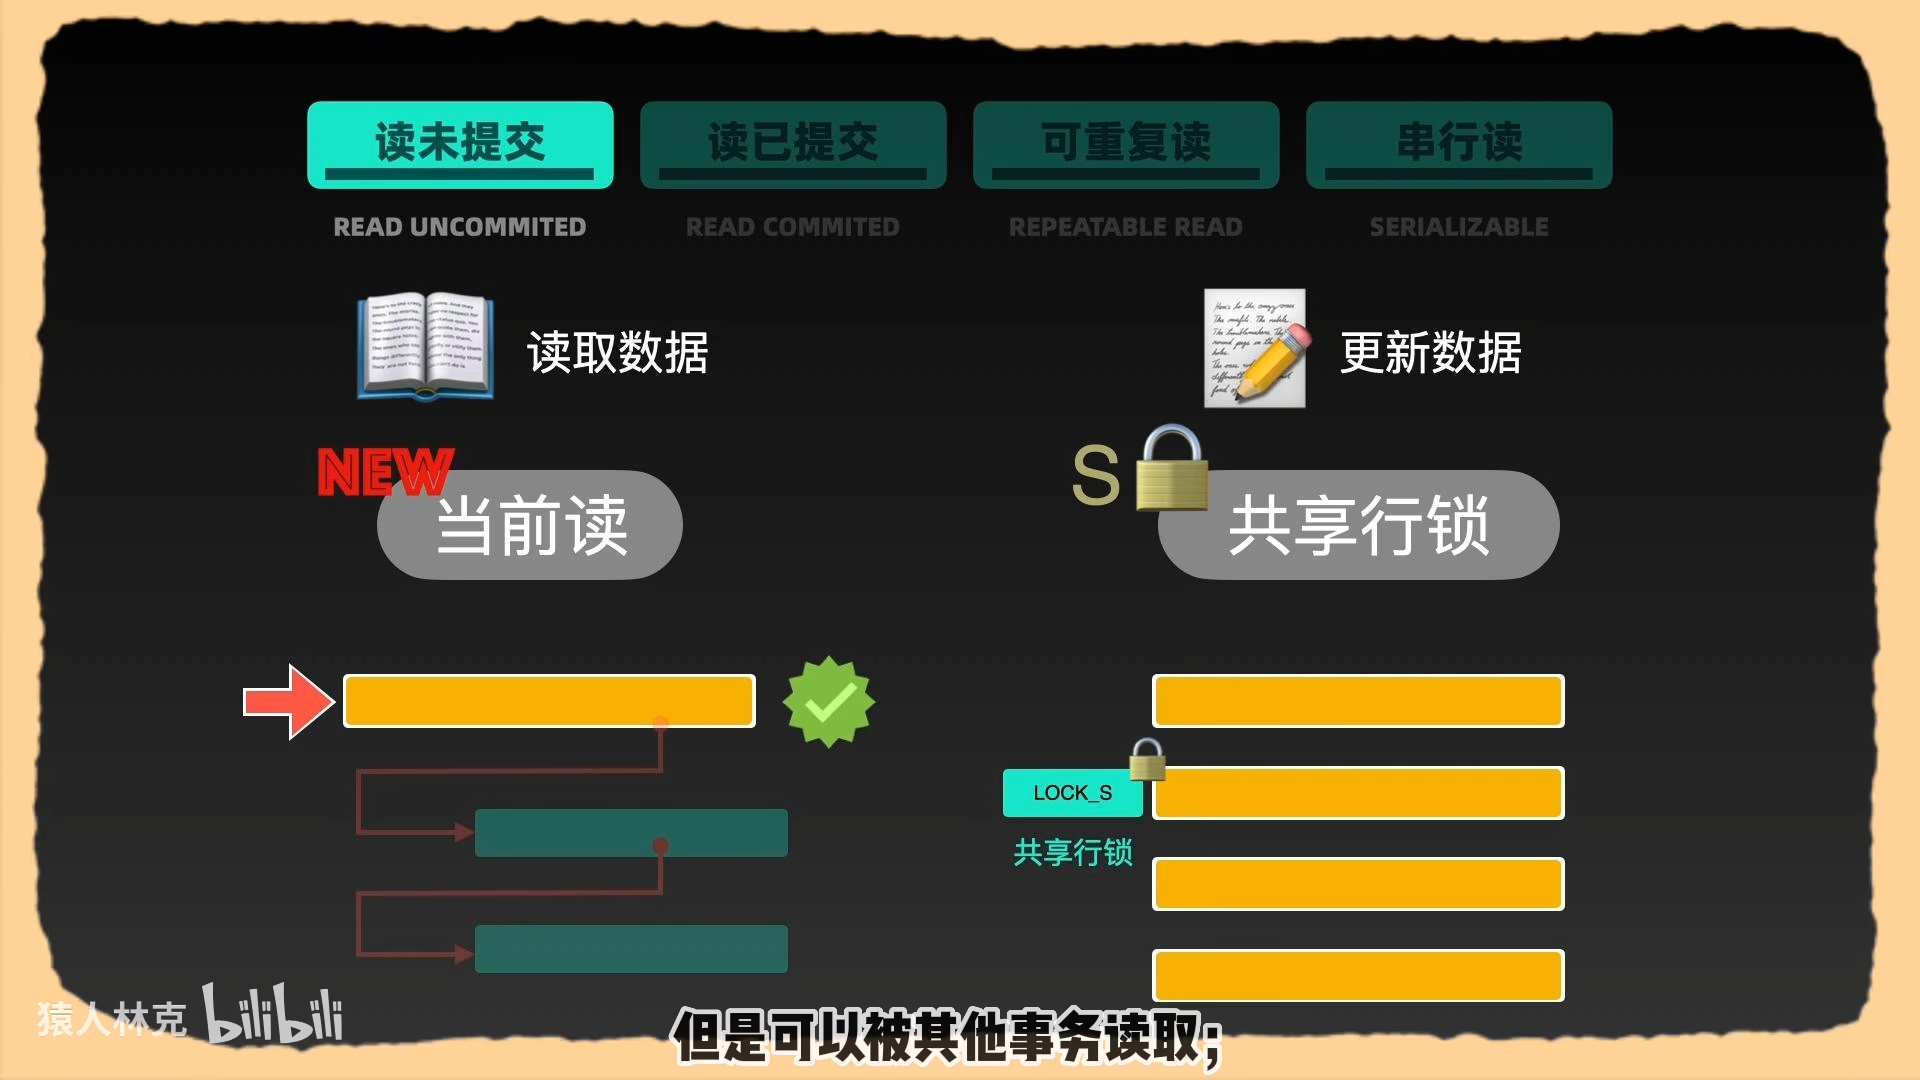
當前讀 是指事務在執行時直接讀取當前資料庫的最新資料版本。它通常需要獲取鎖(如排他鎖或共享鎖),以確保讀取資料時的準確性和一致性。
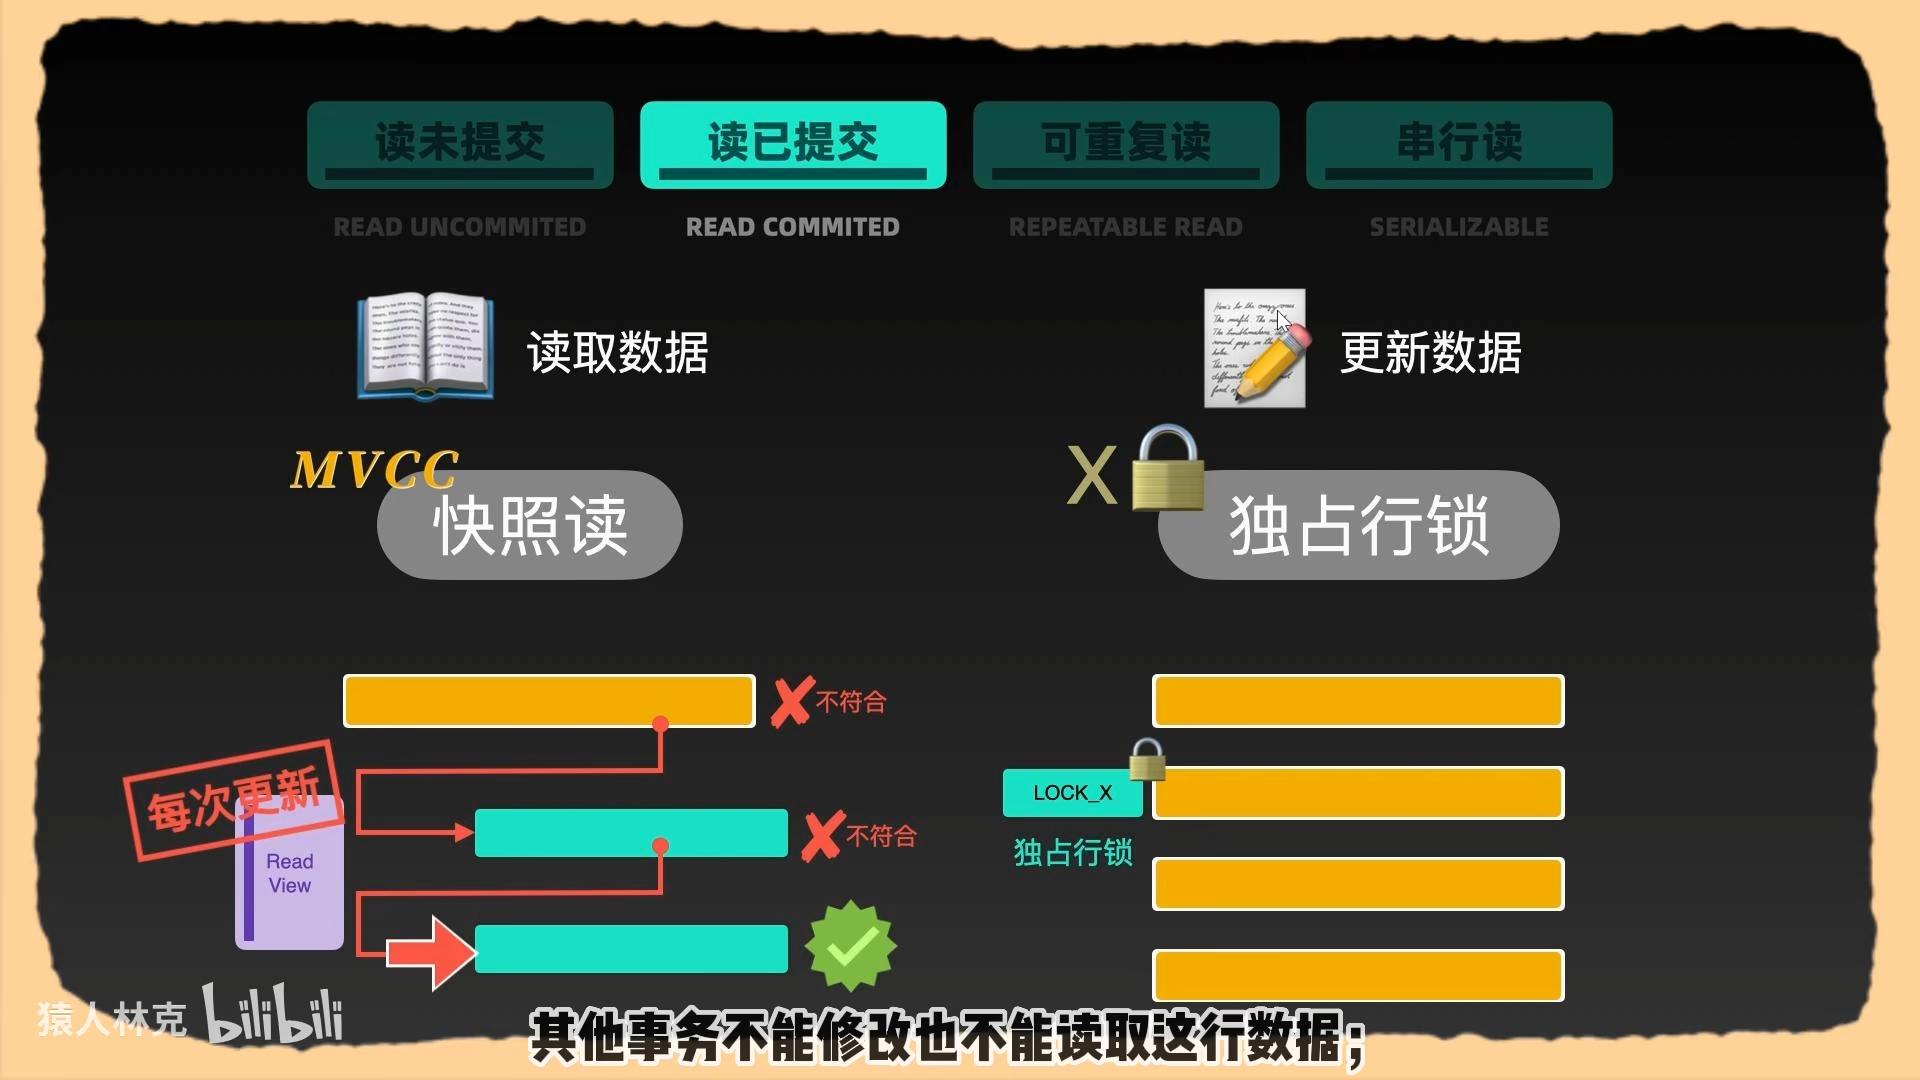
快照讀 是指事務讀取某一時刻的資料版本,而不需要加鎖。它通過 MVCC 機制提供了一個資料的快照,允許事務在不干擾其他事務的情況下讀取資料。
髒寫: 事物 B修改了事物 A 正在修改的資料, 事物 A 回滾導致事物 B 修改失效
解決: 读未提交 ,一個事務在進行讀取操作時可以不獲取任何鎖,因此其他事務仍然可以併發地進行當前讀,會導致髒讀,但是寫會加鎖來避免髒寫
在 "讀未提交" 隔離級別下,事務可以讀取其他未提交事務所做的更改,即使這些更改未在 MVCC 中正式提交。
MVCC 版本:MVCC 的設計是為了管理已提交的資料版本,因此在更高的隔離級別(如 Read Committed, Repeatable Read, Serializable)下,交易會讀取 MVCC 中的已提交版本
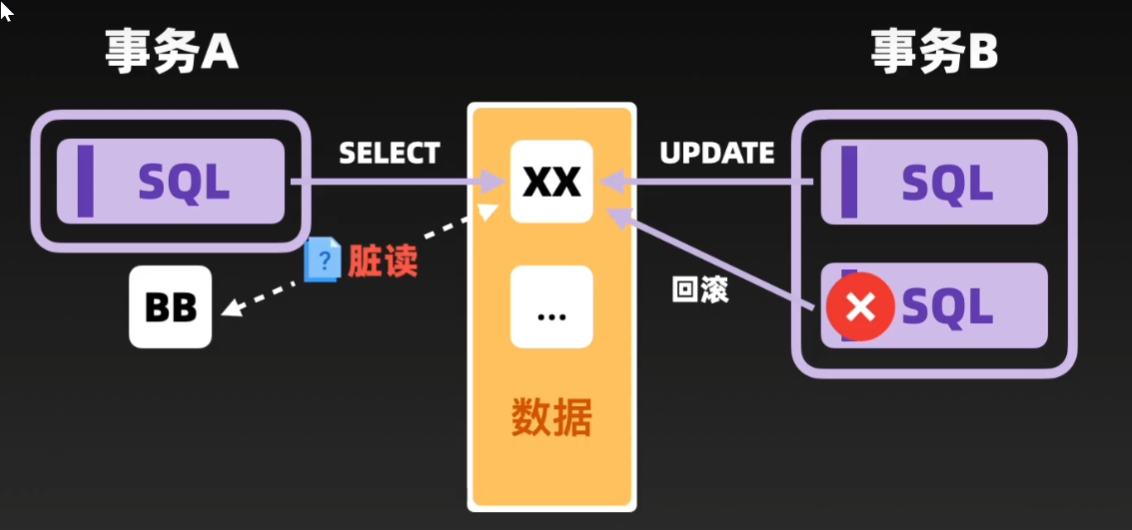
髒讀: 一筆資料, 一個 交易A 修改了資料,還不確定會不會回滾時或者還沒有處理完成資料,另一個 交易B 就存取了該資料 , 此時存取讀到的資料是髒資料 (Dirty Data), 交易A 可能 roolback 導致讀到的資料無效
解决 : 读已提交: 一個交易只能讀到其他交易已經提交的資料,未提交則讀到提交前的資料,而不可重複讀是其他已提交交易的資料也讀不到
mysql落地解决方式:读已提交 每次讀都產生一個 Readview, 這樣只能讀到已提交的快照,不會讀到正在修改的資料,寫的話上寫鎖
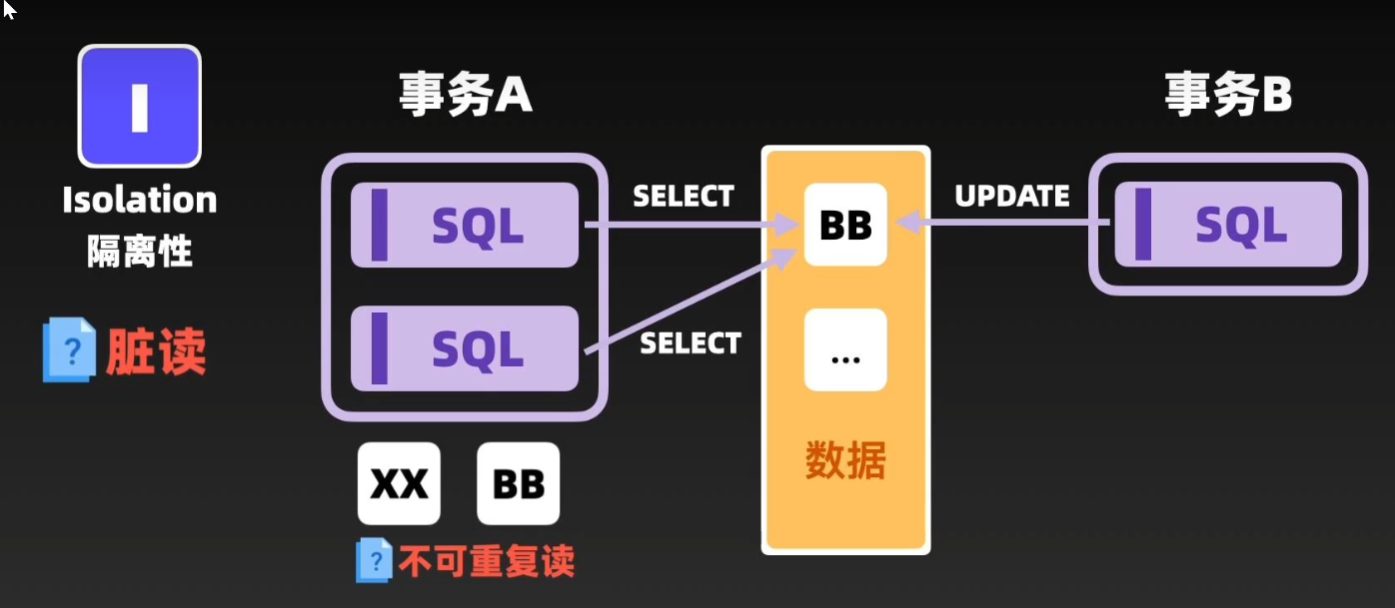
不可重複讀: 一筆資料, 一個交易A多次讀取,另外一個交易B也讀取並修改了這一資料,導致第一個交易 A多次讀取到不同結果
理论解决方式: 可重复读: 在 自己事务过程中 多次讀取的資料是一致的,在自身交易多次讀取過程中都不受到其他交易的影響,另一个事务已经提交了也读取不到(MVCC)/让另一个事务无法修改(锁)
mysql落地解决方式:MVCC、鎖機制可重复读 只在第一次讀取產生一個 Readview, 保證不會讀到其他交易的, 但不能保證資料的時效性,另一個交易可能在讀取中修改,導致資料過時,依舊需要手動取得鎖來處理,避免其他交易的影響,另外配合 临键锁``间隙 避免一部分幻讀
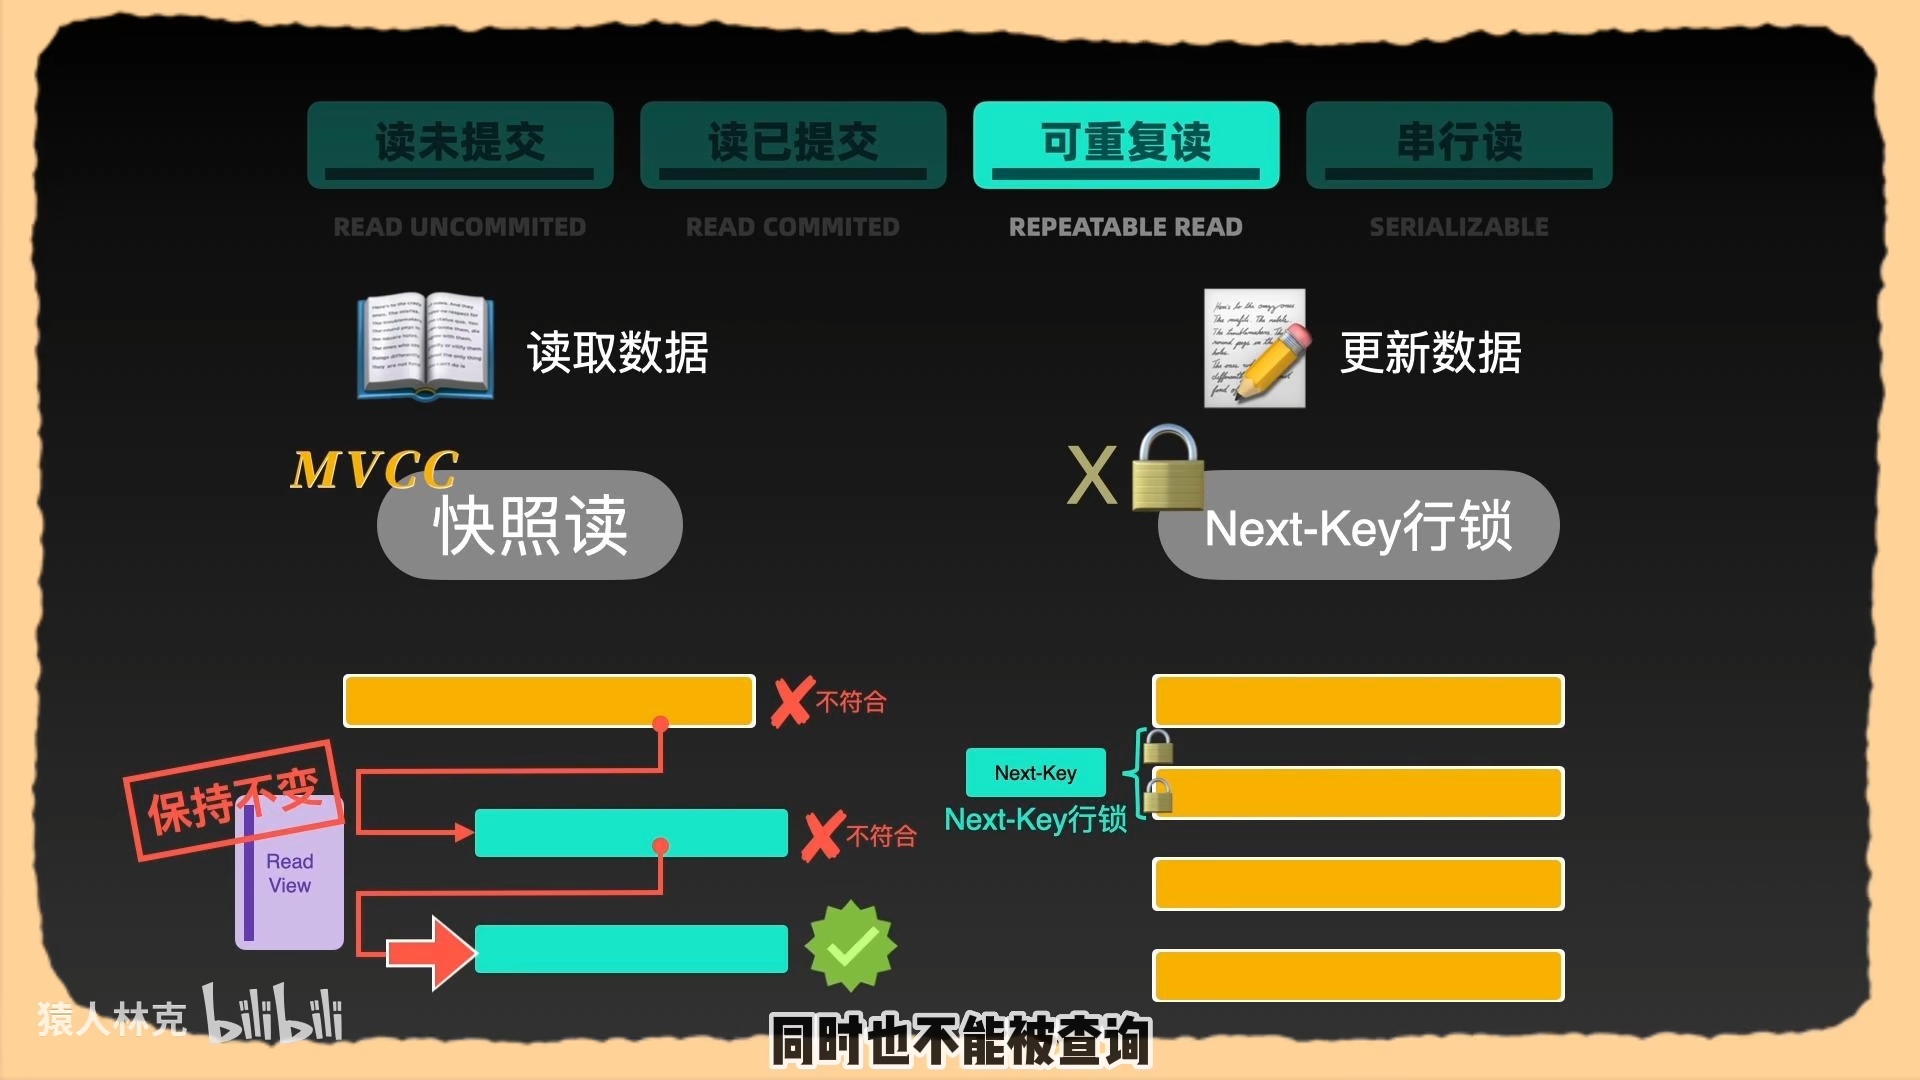
幻讀 : 交易 A 自身讀取一個範圍內的資料後, 另一個交易插入了新資料,造成兩次讀到內容不一致
查詢特定一行, 雖然第二次沒有比第一次 多出 新插入的資料,但插入相同資料會失敗 (如果少了資料叫 不可重复读)
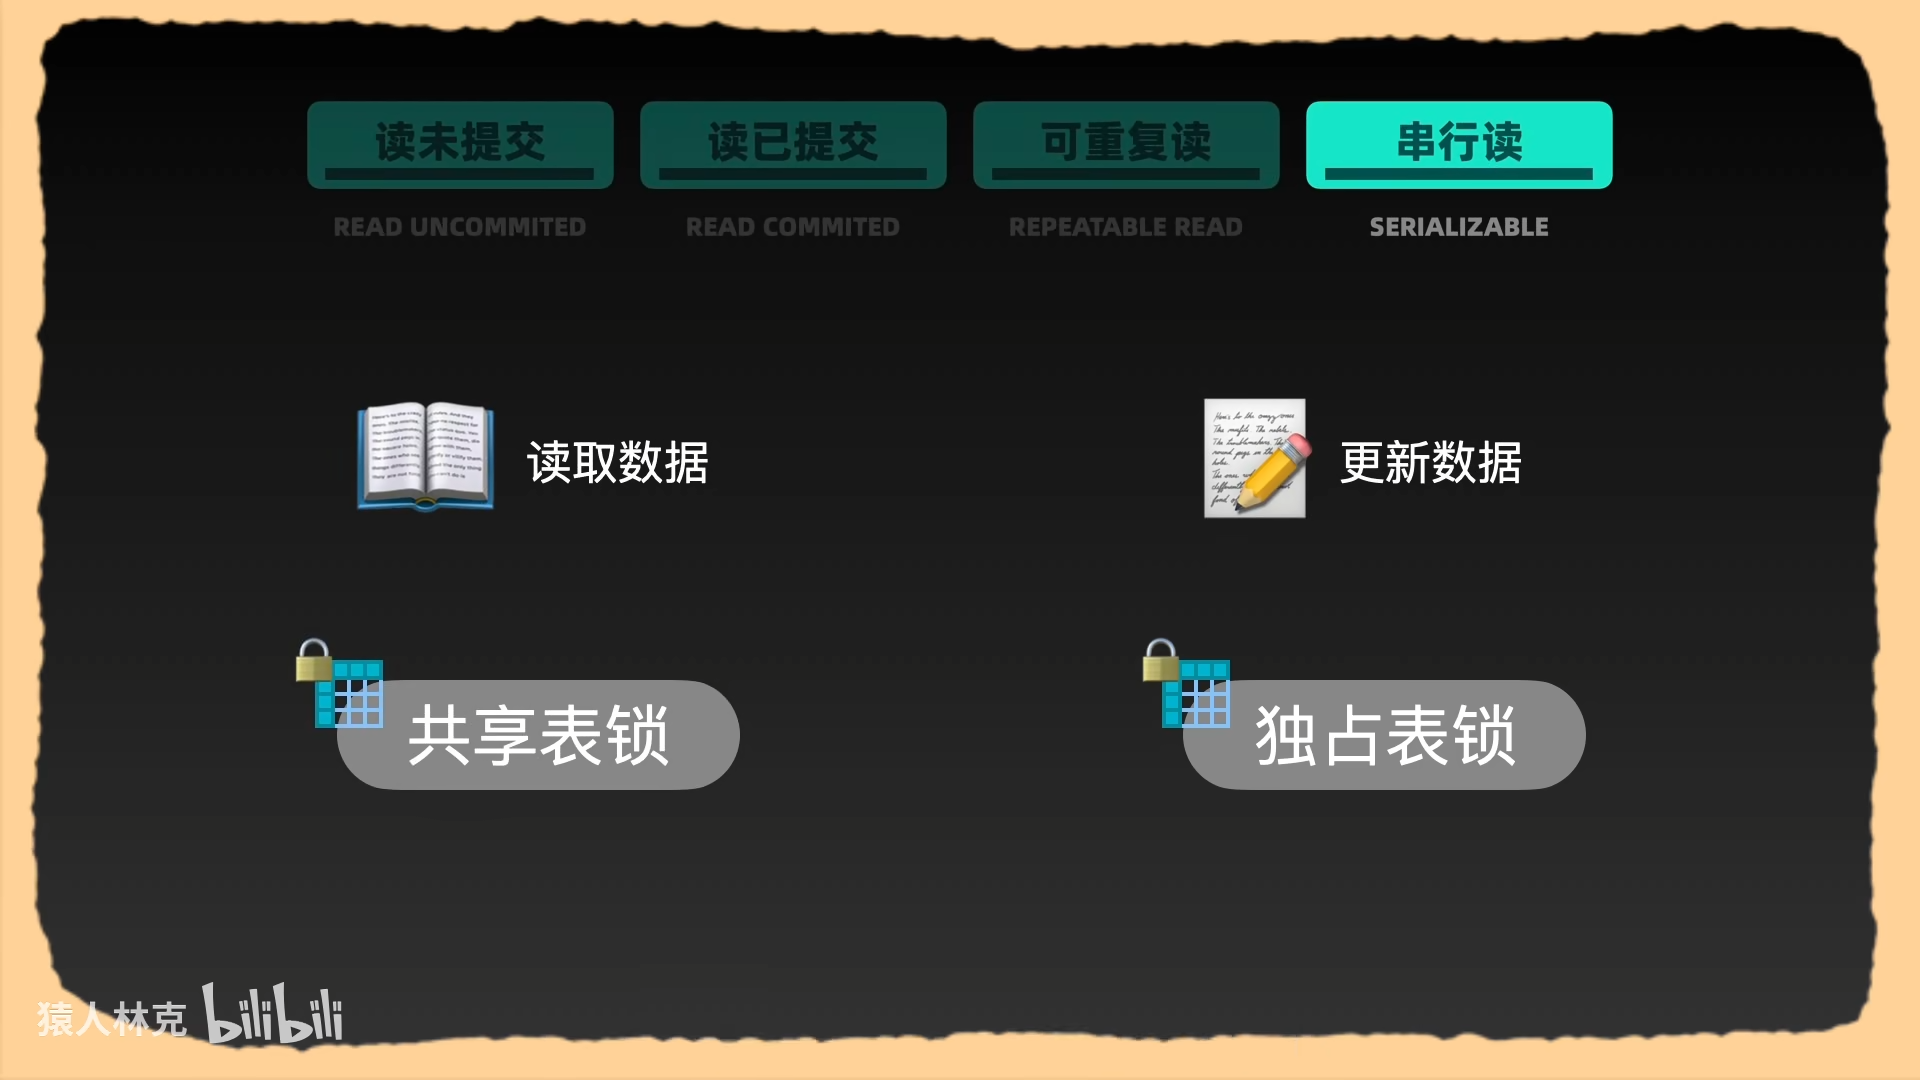
解決方案: 可串行化: 完全使用鎖不再使用 MVCC,會在讀的時候加鎖,
spring中的交易
springboot 啟動檔案上開啟交易管理,加入註解 @EnableTransactionManagement
註解 @Transactional,標註在 service 層的 方法,類,介面 上
- 唯讀
@Transactional(readOnly = true) - 逾時回滾,釋放資源
@Transactional(timeout = 3) - 回滾策略
rollbackFor/rollbackForClassName/noRollbackFor/rollbackFor - 隔離級別 : 並不是所有資料庫都支援所有隔離級別。某些資料庫可能將較高的隔離級別降級到較低的級別
@Transactional(isolation = Isolation.DEFAULT)//使用資料庫預設的隔離級別
@Transactional(isolation = Isolation.READ_UNCOMMITTED)//讀未提交
@Transactional(isolation = Isolation.READ_COMMITTED)//讀已提交
@Transactional(isolation = Isolation.REPEATABLE_READ)//可重複讀
@Transactional(isolation = Isolation.SERIALIZABLE)//串行化
- 傳播行為
propagation^sz3dj3
A 呼叫 B 方法時, A 有無交易 B 的傳播設定
../JAVA微服务核心/JAVAWEB/JavaWeb#传播行为 propagation
required / required_new / supports / not_supports / never / mandatory / nested
A 呼叫 B 方法時
required: B 需要交易 A 有交易,則 B Join A A no thing , B then create a thing by itselfrequired_newB needs a new thing A if there is a thing, then suspend,B a new thing will first guarantee its own operationsupportsB supports transactions, A can have no transaction A if there is a thing, then join, if no thing, then it does not matternot_supportsB does not support things A call with no thing B, A there is a thing B then suspendneverA and B both must have no thing A call B, A also must have no thing, other d wise abnormalmandatoryA call B, A must have a thing, otherwise abnormalnestedA call a new thing B, A a thing exists as a nested thing,A no thing executes as a new thing
Log
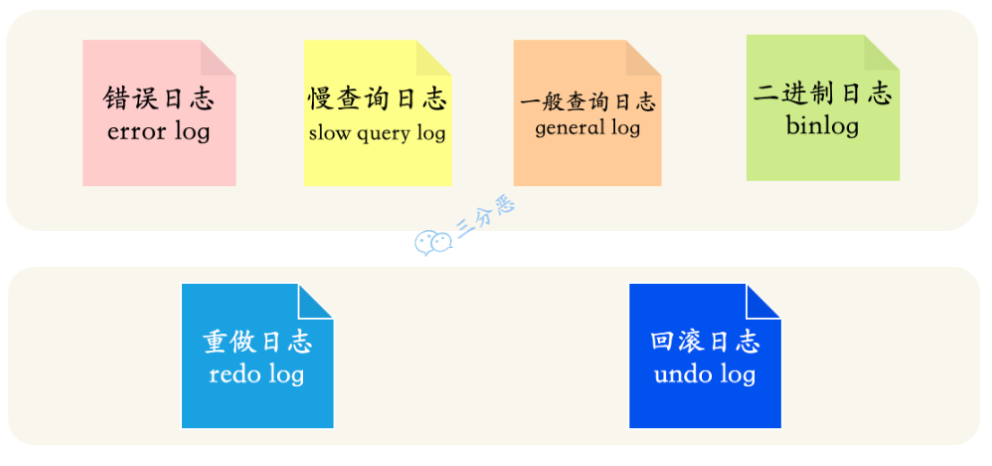
| undo (before) | redo (after) | binlog | |
|---|---|---|---|
| Function | Atomicity, consistency | Durability (depending on the strategy, the flush frequency differs) | Synchronize data, affect replica data |
| Trigger scenario | When rollback is needed (deadlock, transaction failure) | When the system crashes | Data recovery, replication and auditing |
| Feature | Record the data before modification | Record the data after modification | All database related data |
| Scope | Only affects local data | Only affects local data | Record local changes,affectreplica data |
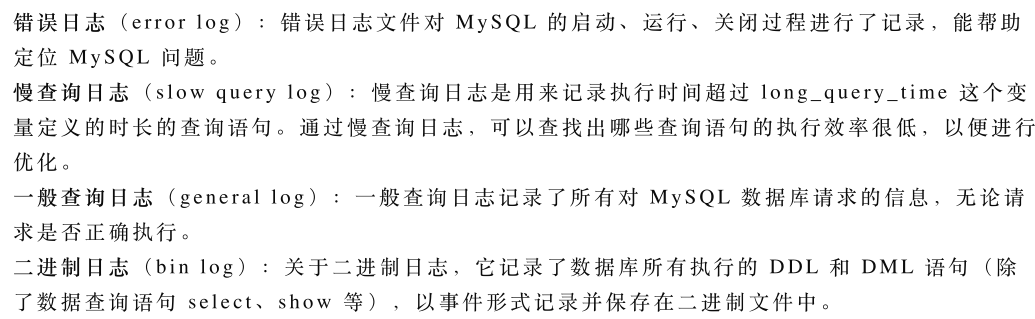
redo and undo binlog
Data modification before the appearance undo log rollback log, its function istransaction rollback, that is, when an error occurs during transaction execution or the user actively rolls back, the data can be restored to the state before the transaction started.undo log It is also used to implement MVCC, so that different transactions can read different versions of data. The main function of undo log is to roll back uncommitted transactions, and it cannot be used to undo committed transactions, that is, human error code execution cannot be recovered
Data modification after the appearance redo log redo log
If the operator makes a mistake and executes a statement incorrectly, and it is unrelated to the transaction, then it is necessary to rely on binlog (change history query, database primary and replica, backup and recovery), redo log is only responsible for ensuring that the data submitted by the transaction is not lost, and it does not record the statements executed by the transaction. If the operator makes a mistake and executes an incorrect statement, redo log cannot provide a rollback operation to the state before the error.
- undo log is the regret medicine, and it takes effect during transaction execution.
- redo log 是「保險箱」,在事務提交時生效,保證已提交事務的持久性
- binlog 是「時光機」,在事務結束後生效,可以恢復到過去某個時間點的資料狀態。
redo log (資料恢復保證 持久性) 重做日誌
REDO LOG 主要用於在系統 崩潰 後恢復 已提交事務的修改 /確保事務的持久性
REDO LOG 不對外暴露,主要用於資料庫內部的崩潰恢復過程
記錄了對於 InnoDB 儲存引擎的事務日誌
redo log : 為了保證持久化,我們只需要保證崩潰重啟後能把改動恢復即可
例如,某個事務將系統表空間中第 10 號頁面中偏移量為 100 處的那個位元組的值 1 改成 2。我們只需要記錄一下: 將第 0 號表空間的 10 號頁面的偏移量為 100 處的值更新為 2
redo 日誌是順序寫入磁碟的
事務執行過程中,redo log 不斷記錄
日誌佔用的空間非常小
降低刷盤頻率
undo log 日誌 (保證 原子性 與 一致性 ) 回滾日誌
每條 SQL 透過執行器,就會立刻在回滾段 UNDO LOG
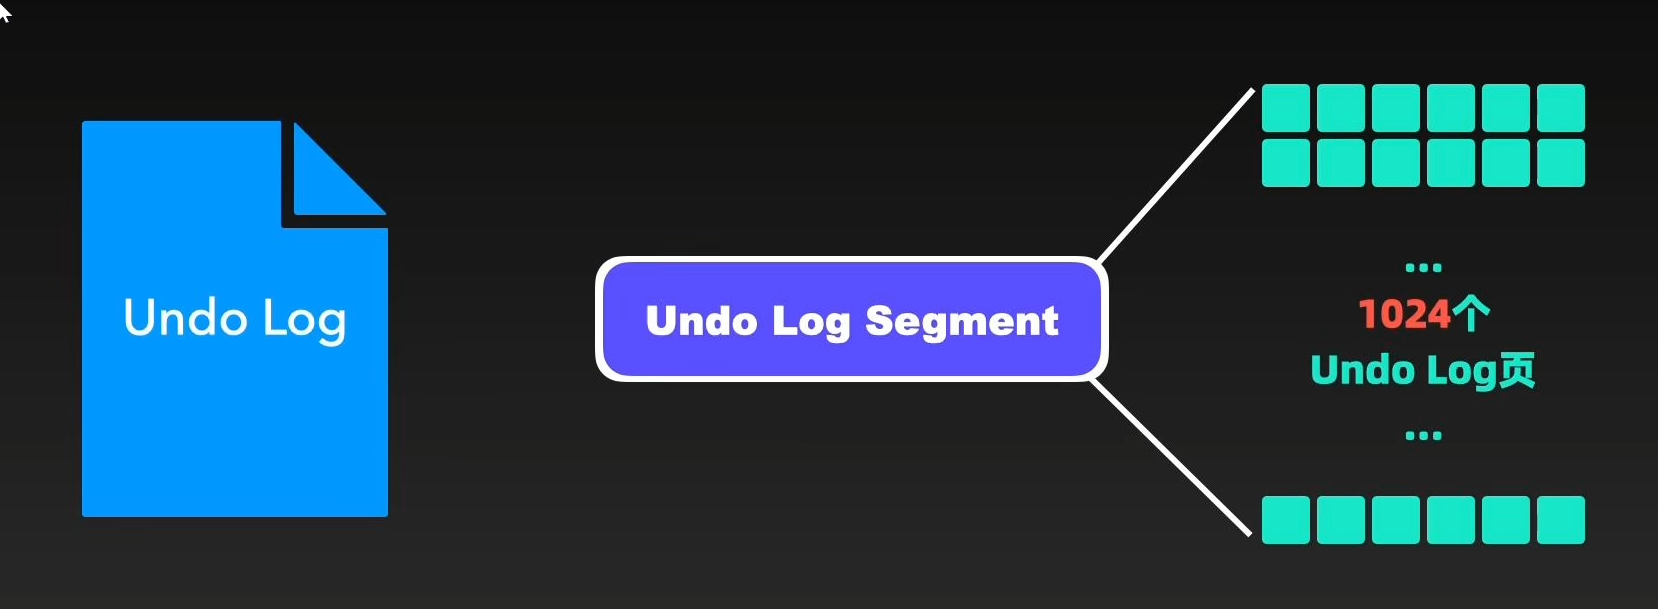
UNDO LOG 主要用於回滾事務,以確保資料庫的原子性和一致性。它記錄的是每個事務在執行過程中對資料所做的修改之前的原始值。
作用 :
- 回滾資料
MVCCMysql/Mysql高級 > undo 日誌
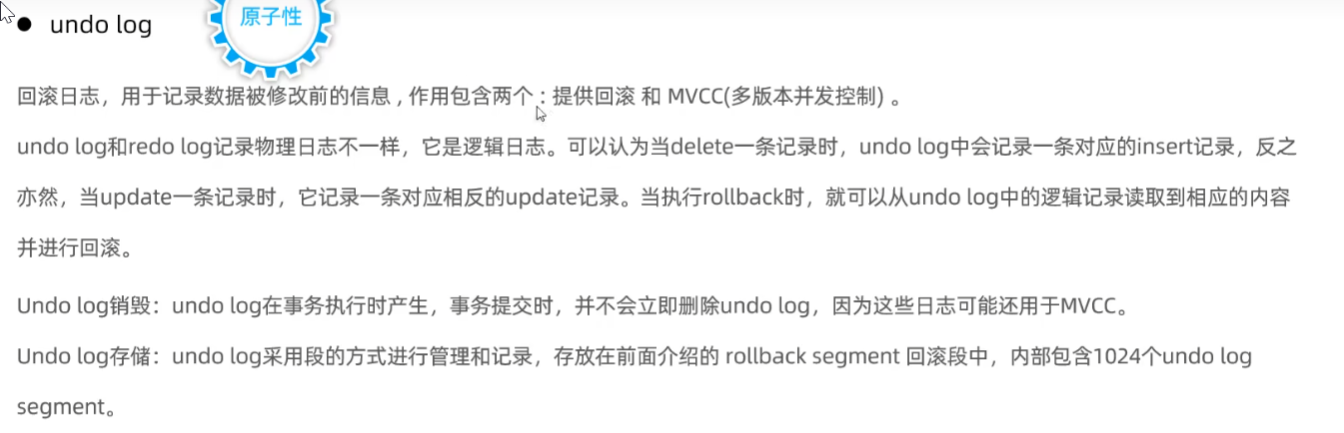
binlog和redo log有什麼區別
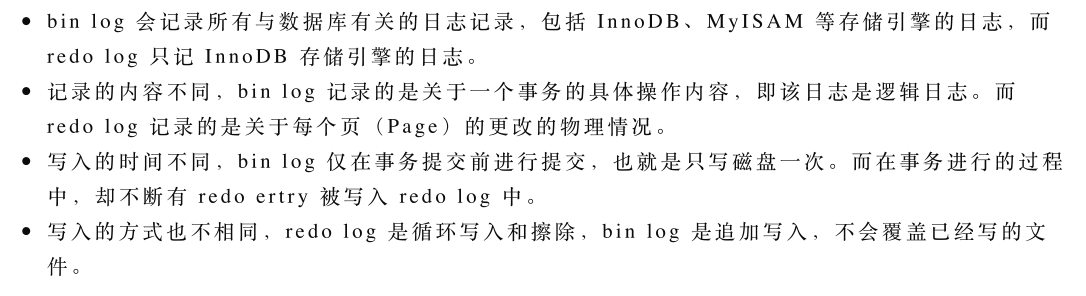 只有當一個事務 成功提交 時,MySQL 才會將這個事務期間的 所有邏輯操作 寫入 binlog。
事務執行過程中不成功->回滾用到 undo log
也就是說事務執行過程中->不斷寫入 redo log ->但是只有事務提交後,崩潰才會用到 redo log,事務沒提交就崩潰則 undo log
事務提交時->寫入 bin log(因為沒提交時寫入沒有意義,沒提交說明沒有執行完畢,可能發生故障依靠 undo log 即可) ->- 使用 binlog 將資料庫恢復到過去的某個時間點(例如,發生誤操作時)/主從複製時,從庫透過讀取主庫的 binlog 來同步資料/用於審計資料庫操作
bin log 是在事務提交後記錄的,需要確保事務已經提交再記錄,因此需要兩階段提交
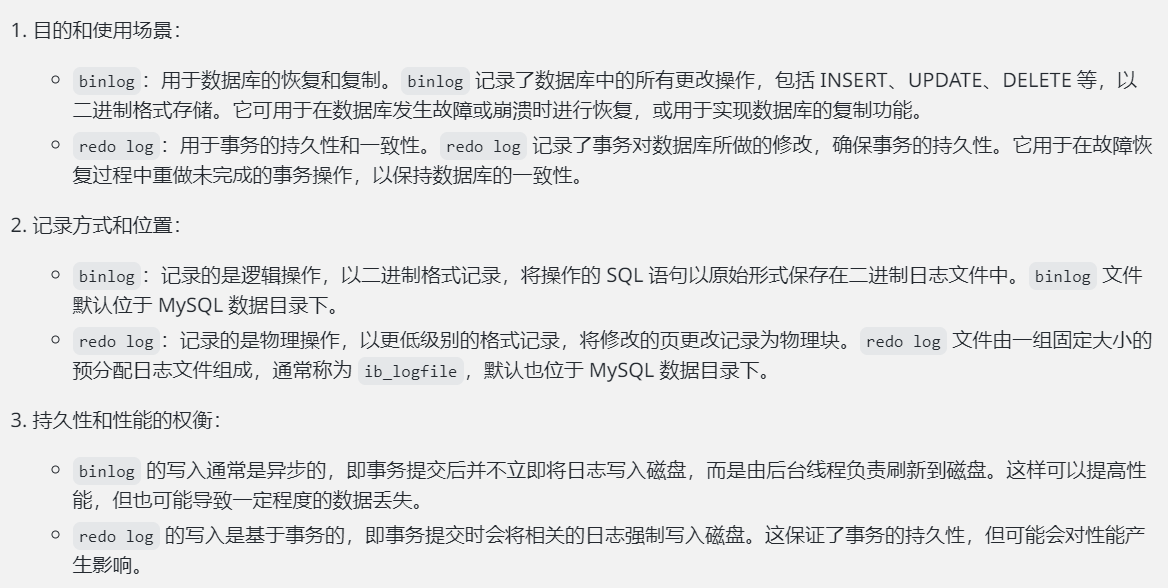
Binlog 用於記錄所有更改資料庫的操作,包括 INSERT、UPDATE、DELETE 等。主要用於資料的複製和恢復,支援主從複製,可以用來將資料恢復到某個時間點。
你知道一條更新語句是怎麼執行的嗎
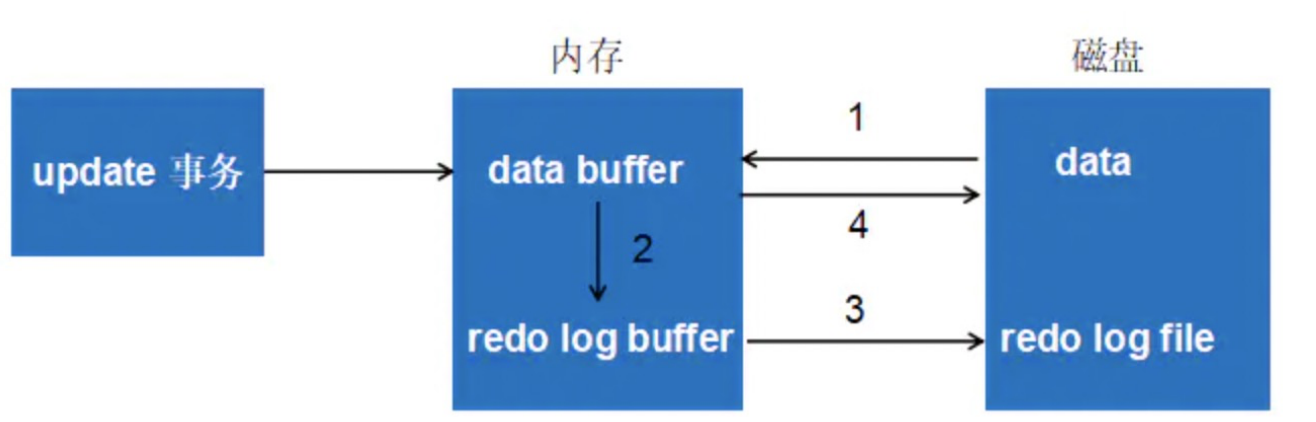
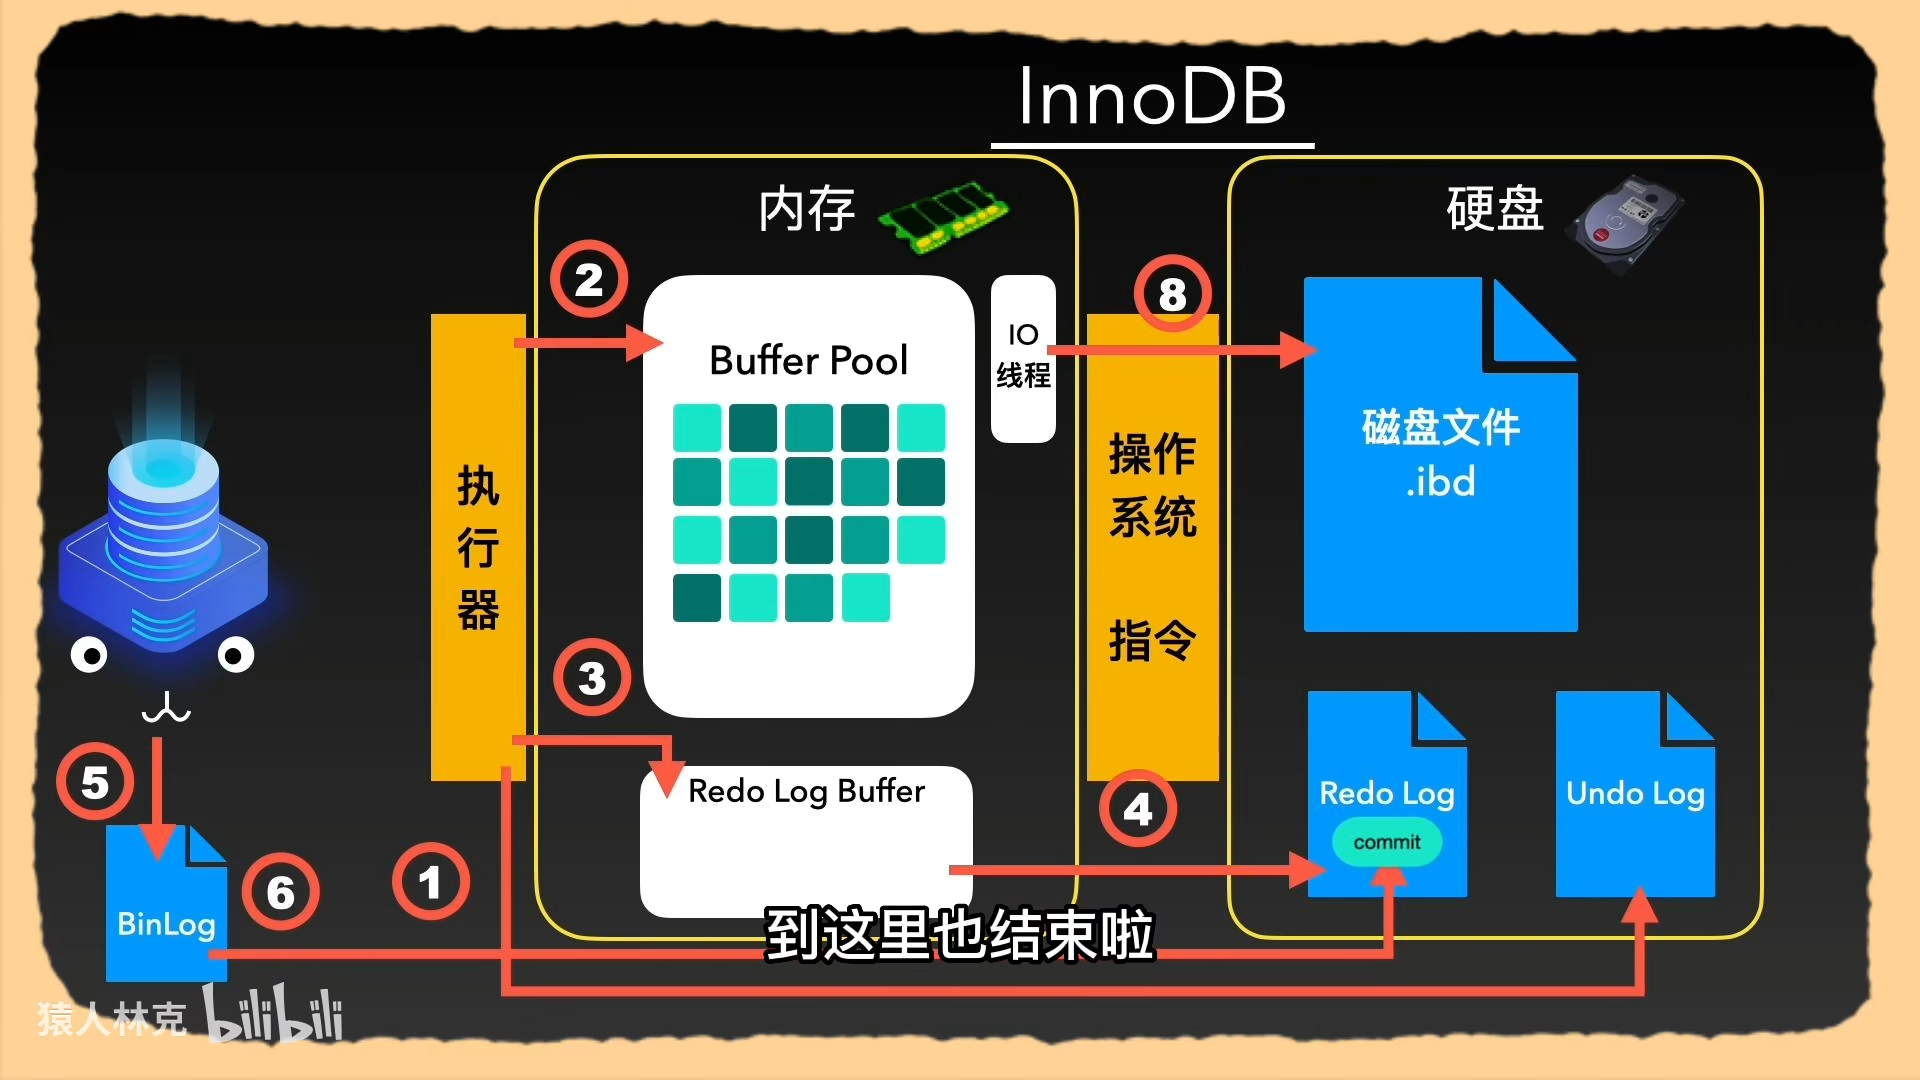
一條 update 語句執行時,先在 Undo Log 記錄一筆反向的記錄,Undo Log 記錄完成後,再進入 Buffer pool 中,對 Buffer pool 中的資料進行修改(這一步執行修改的命令),修改完成後寫入 Redo log Buffer
- 進入
prepare階段Redo log Buffer寫入redo Log,標記為prepare,binlog會被寫入到記憶體中的binlog cache
- 進入
commit階段- 刷盤寫入
binLog,寫入完成後將Redo log設定為commit,一次資料的寫入就完成了。只要binlog寫磁碟成功,就算redo log的狀態還是prepare也沒有關係,一樣會被認為事務已經執行成功;
- 刷盤寫入
先寫入 redo log ,後寫入 bin log
 關聯式資料庫(例如 MySQL)通常都是在執行命令之前記錄日誌(方便故障恢復),而 Redis AOF 持久化機制則是在執行完命令之後再記錄日誌。
為何 redo log 要兩階段提交
redo log關注的是實際資料的變化,確保資料頁的更新能在崩潰後恢復。binlog關注的是邏輯操作,記錄的是如何從一個狀態變更到另一個狀態
binlog 記錄的是邏輯操作,也就是對資料庫的具體操作,例如 SQL 語句或資料變化事件。
當你執行 UPDATE table_name SET a = 3 WHERE ... 時,binlog 會記錄這個 SQL 語句,而不是實際資料的變化。
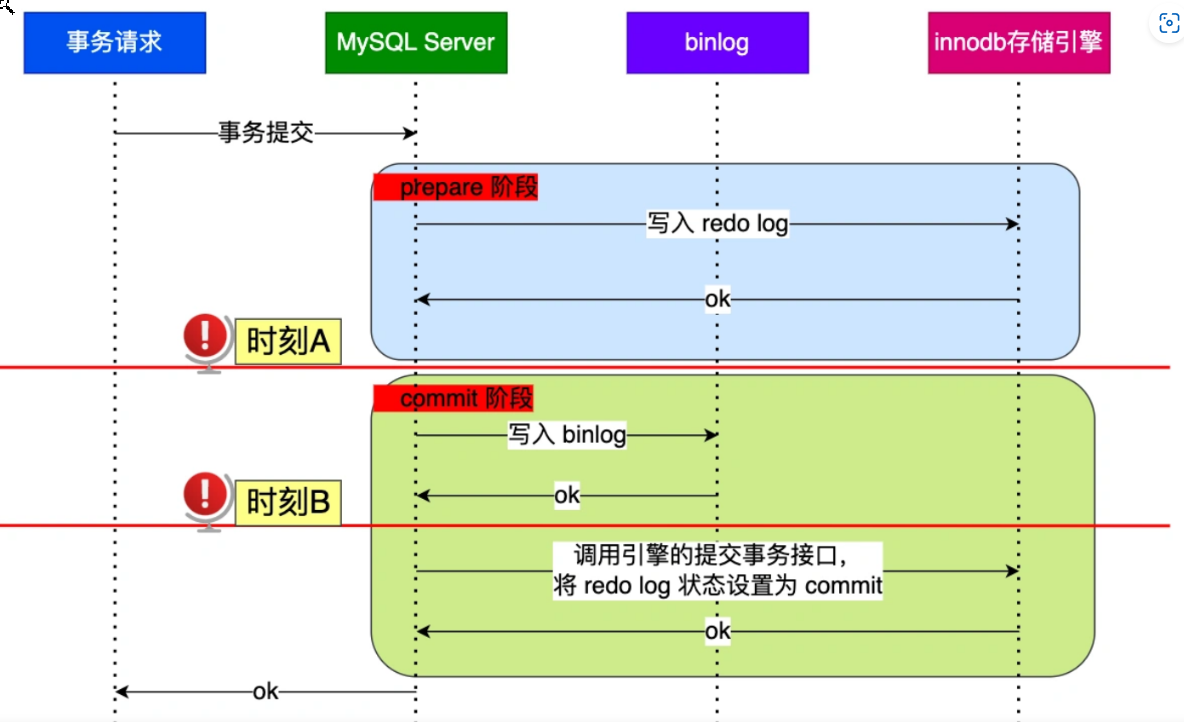
- 當機情況
直接提交分為下面兩種
先寫入
redo log,後寫入bin log:
寫完 binlog log 且 commit 後,就具有了 持久性,
如果還沒有 commit 就當機,分為三種情況
binlog嘗試寫入時發生失敗,MySQL 檢查發現沒有資料,進行 undo log 回滾binlog已經寫完還來不及commit就當機,這時,MySQL 會去檢查 binlog 中是否有這個事務的記錄。
- 如果 binlog 中有這個事務的記錄,說明第二階段第一步成功了,此時 MySQL 認為這個事務是完整的,將這個事務的 redo log 設定為 commit,並完成事務提交
binlog: 寫入一半發生當機, MySQL 在啟動恢復時,會檢查 binlog 檔案,並辨識出哪些是完整的事務記錄,哪些是不完整的。對於不完整的binlog記錄,MySQL在恢復時會直接跳過。避免了從機資料不一致, 最後 mysql 進行 undo log 回滾
- 為什麼不刪除 binlog:
- 效能考量: binlog 是追加寫入的,刪除操作會非常複雜,涉及到檔案結構的修改,效率很低。
- 容錯考量: 即使 binlog 中存在一些不完整的事務記錄,這些記錄在恢復時會被跳過,不會對資料一致性產生影響,因為只有事務成功提交後,從庫才會同步這些完整的 binlog。
如果先寫入 bin log ,當機後做出更新的資料不會被恢復, 但是,由於 bin log 中已经记录了这条更新操作,使用 bin log 进行数据恢复或备份时,会认为数据已经被更新过了,但实际没有更新,这个更新会被同步到从机,导致从机比主机多一条记录
第一阶段 prepare: 用来确保宕机可以正确恢复,宕机发生在 prepare 之后,MySQL 可以根据 redo log 的状态来判断事务是否可以提交,或者需要回滚
第二阶段 commit: 用来确保从机 redo log 是一致的, 保证了事务的 原子性(要么都成功,要么都失败)和 主库 binlog 完整性,进而间接保证了 主从数据一致性。
索引
redo log 怎么刷入磁盘的
Mysql/Mysql高级 > ^5wu9ub
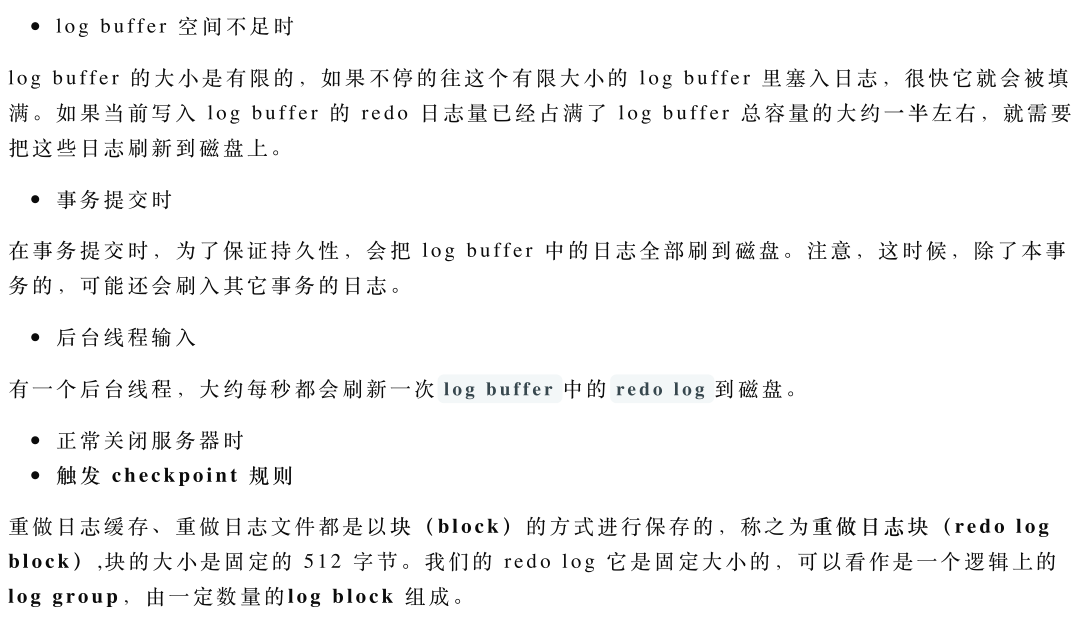
什么时候会刷入磁盘
log buffer /事务提交时/后台线程输入/正常关闭服务器/ checkpoint 规则
一棵 B+树能存储多少条数据呢
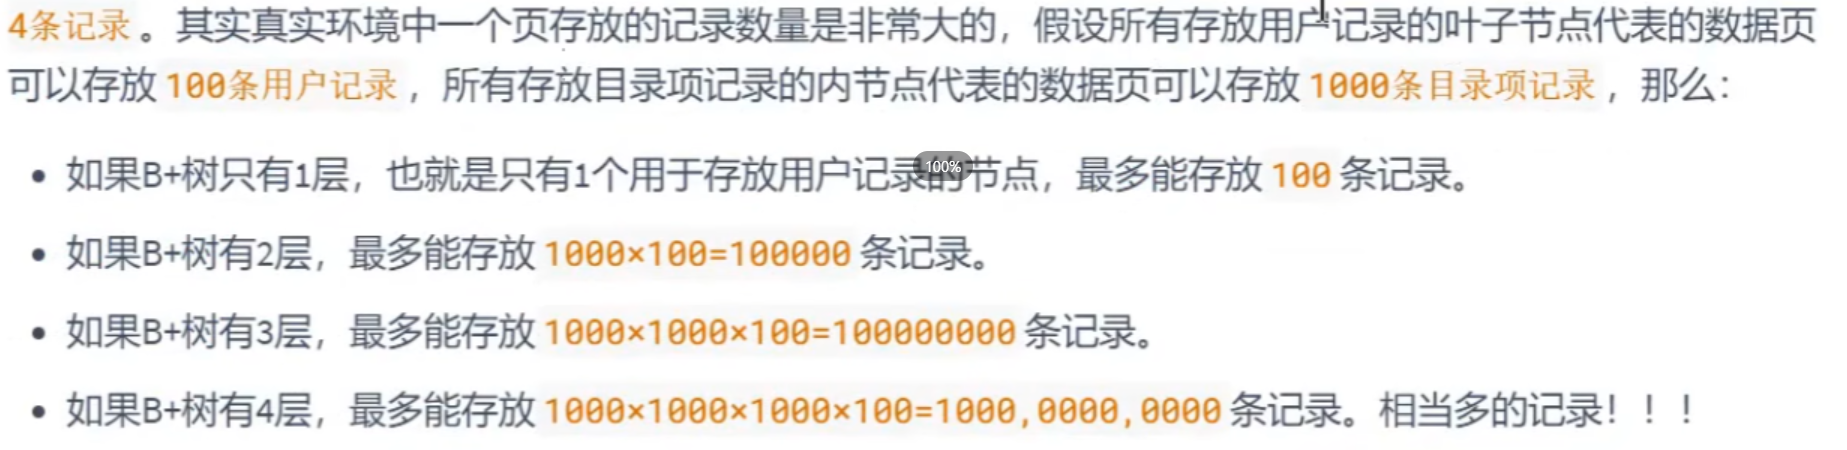
存放数据量=叶子节点数 = 单个目录页存放记录数 × 单个子目录页存放记录数 ×叶子节点页存放记录数
如果假设目录页能存 1000 条目录,叶子节点能存储 100 条目录 三层就能存储 1000×1000×100 = 1 亿
为什么要用 B+ 树,而不用普通二叉树
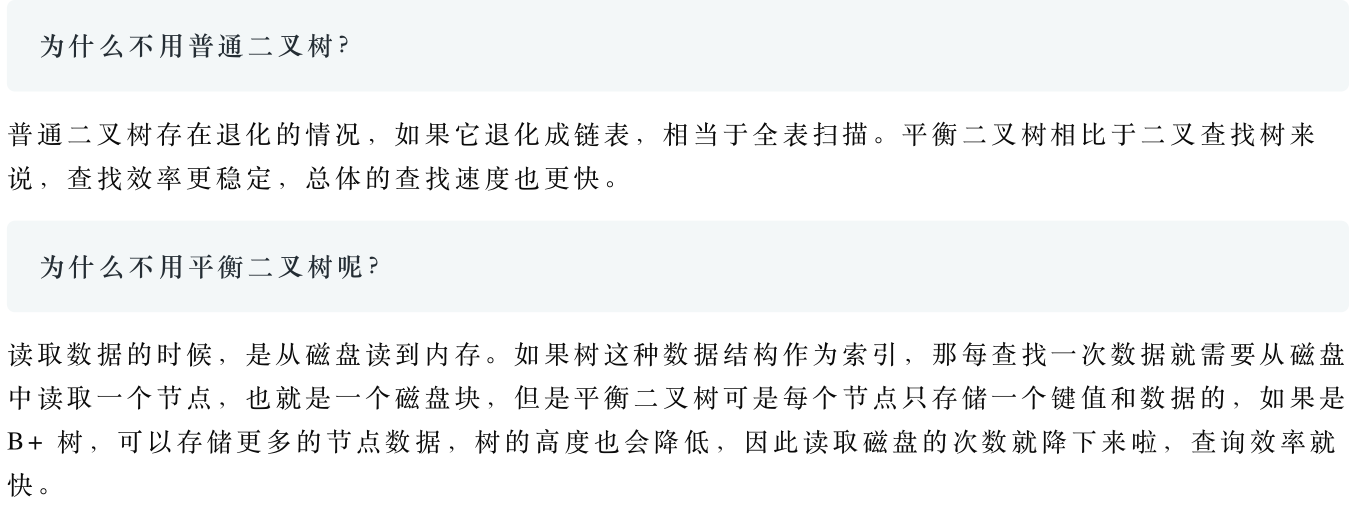
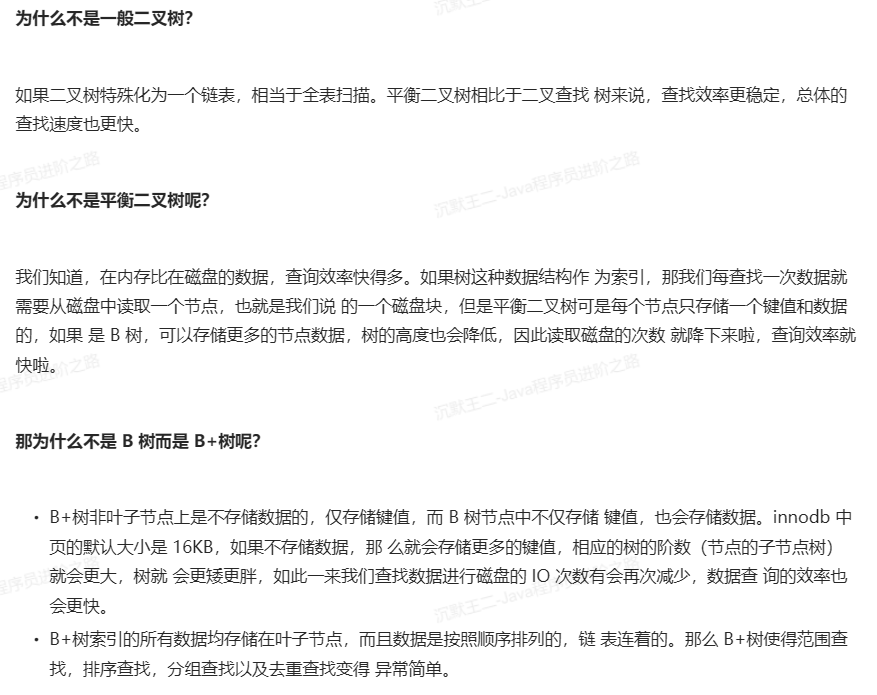
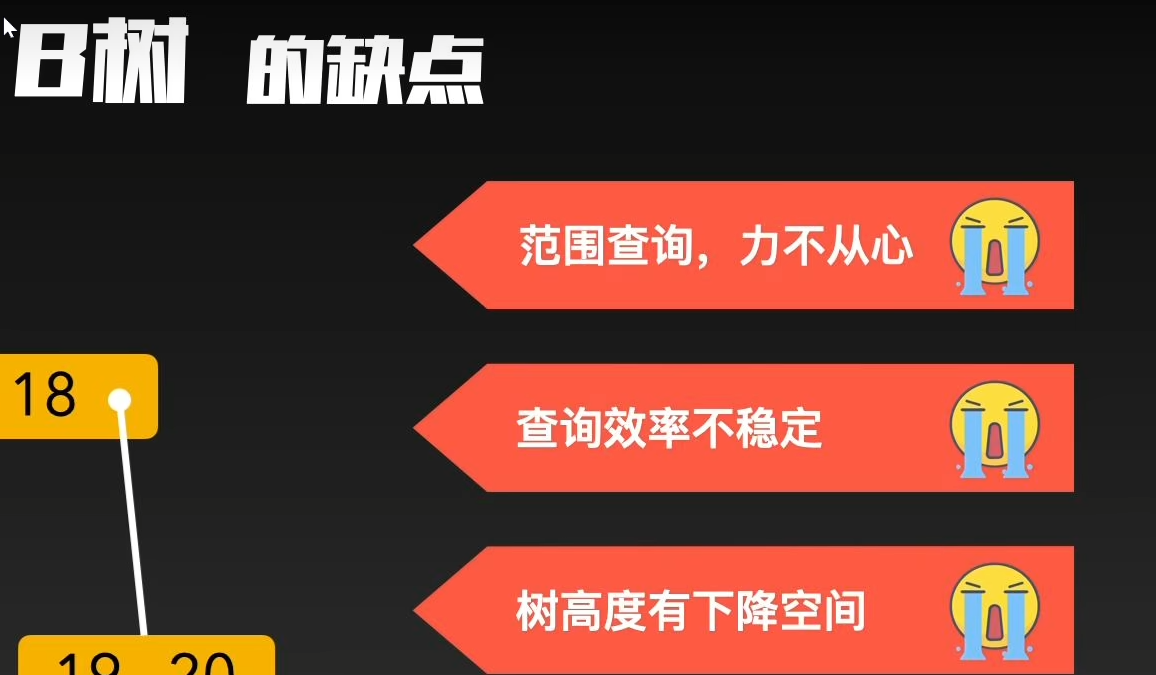
为什么用 B+ 树而不用 B 树呢
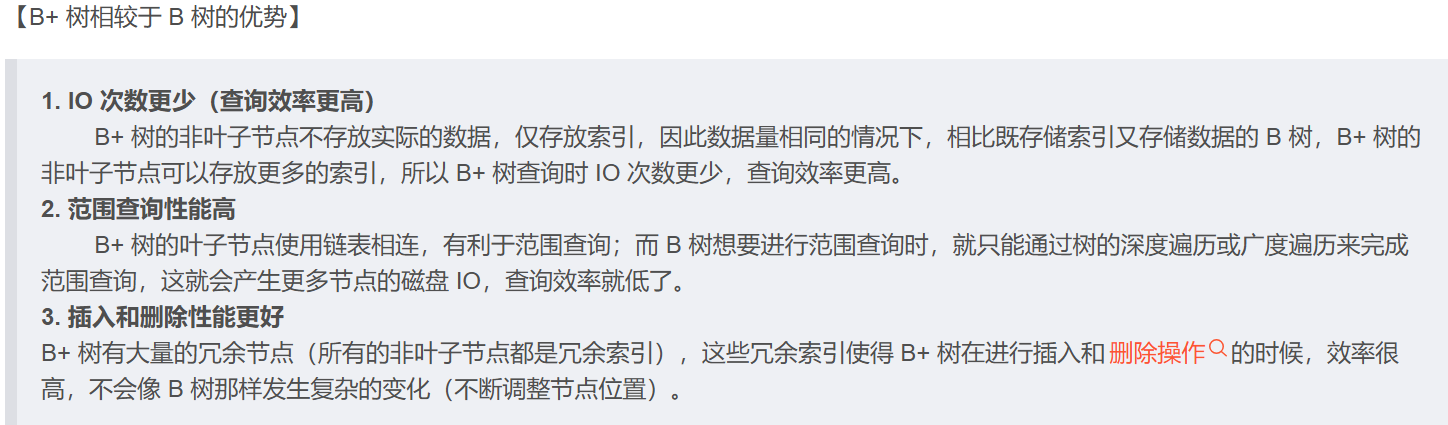
B+是 B 的加强版/扫描能力强,只需要遍历叶子/磁盘读写强大 ,IO 次数少,且 IO 次数稳定,意味着效率稳定/排序能力强 (数据之间是链表)
B+ 所有数据都在最底层,效率稳定,且非叶子节点不装数据,能储存更多的目录信息,会连接更多的叶子节点,也就是可以储存更多的数据,且由于所有数据都在最底层,每个页之间采用双向链表连接 ,可以很方便的范围查询
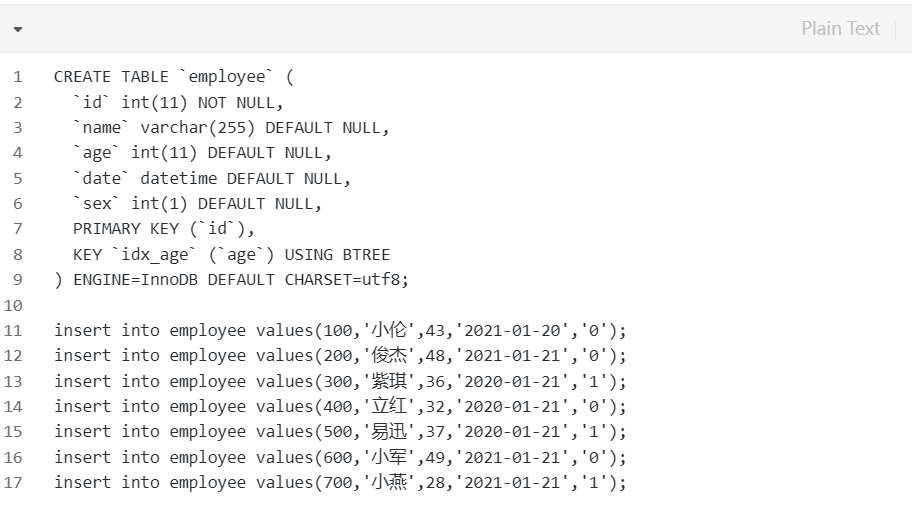
一次 B+索引树的查找过程
简介
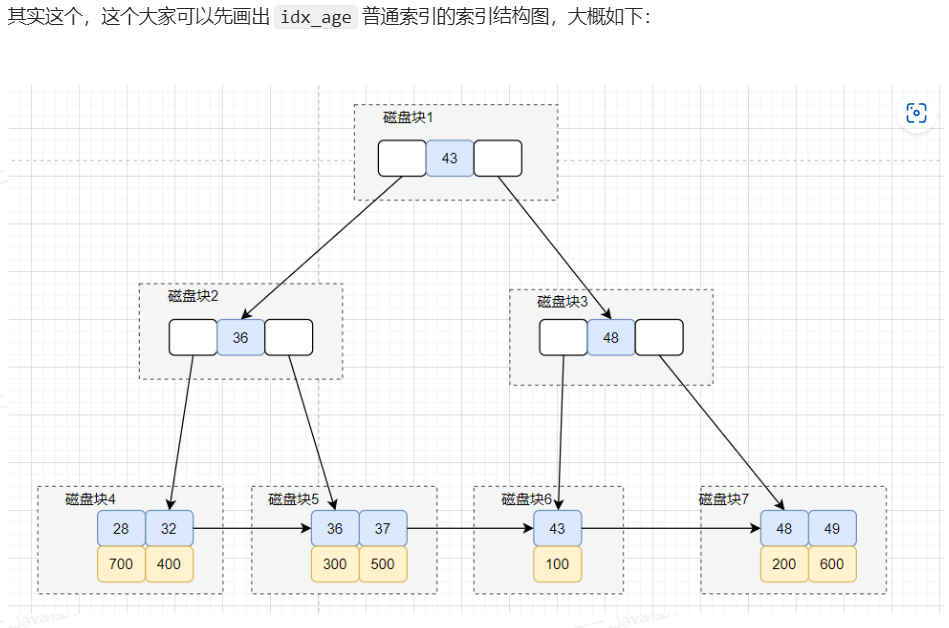
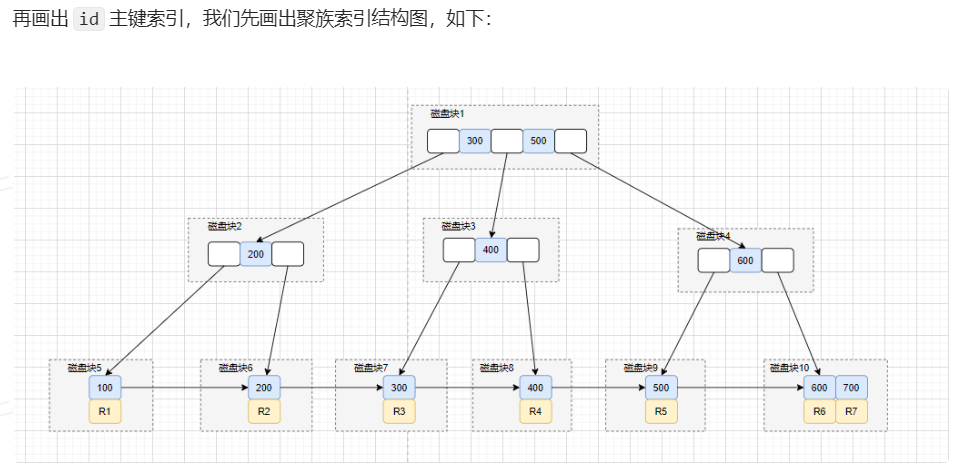
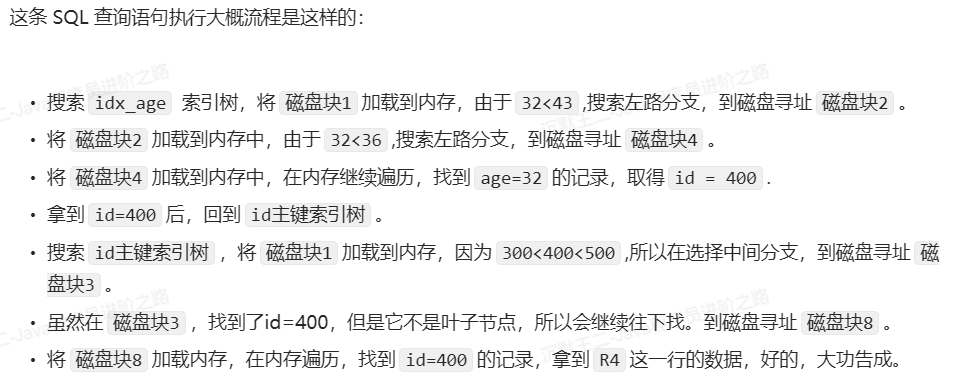
大表如何添加索引
由于创建索引时,是会对表加锁的,可能影响到正常业务,于是创建一个数据结构相同的表 B,创建好需要的索引,然后把大表的数据导入到表 B,然后表 B 名改为大表名,原大表换别名
hash 索引和 B+ 树的区别
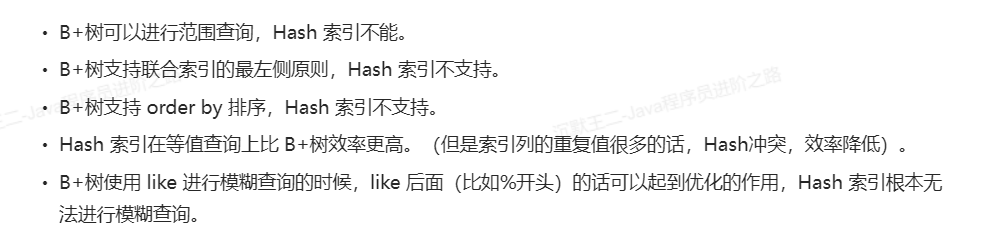
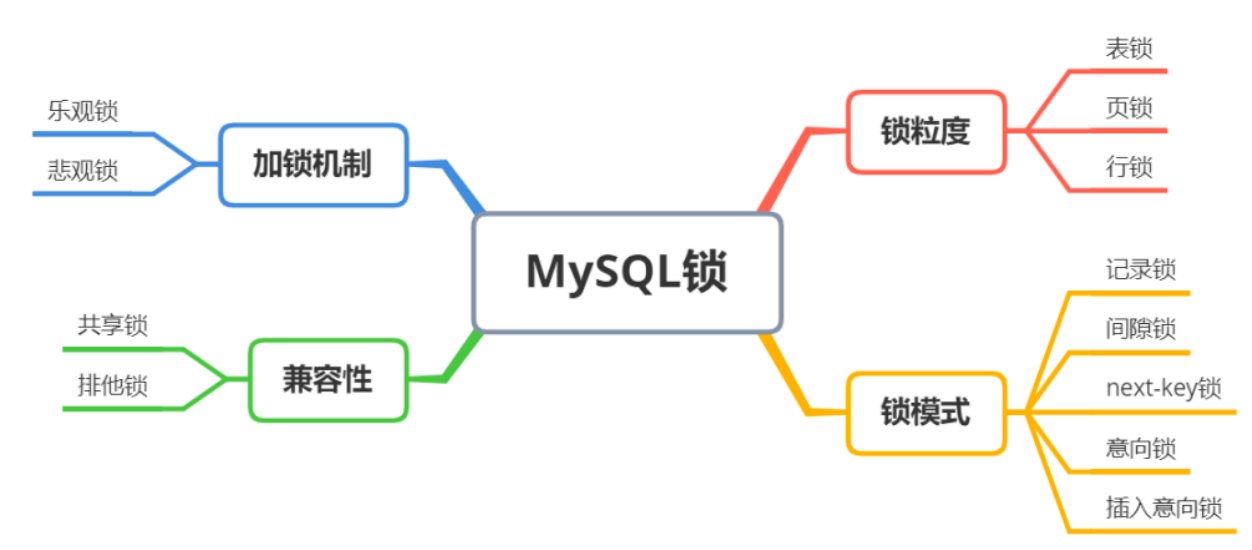
锁
脏写: 修改了别的事物的数据
脏读: (读取到另一个正在修改的数据事物)一个事务正在访问并修改数据,修改还没有提交到数据库时,另外一个事务也访问并使用了这个数据,读到的数据是脏数据 (Dirty Data),依据脏数据所做的操作可能是不正确的解决 : 开启事物 A 没结束时,事物 B 查询读取到的值是事物 A 未开启时的值,即使已经修改,但事物 A 提交后再查数会变,不可重复读
不可重复读: (事物自身读取后的数据被修改 )一个事务多次读同一数据还没有结束时,另外一个事务也读取并修改了同一数据,导致第一个事务再次读取该数据时得到了不同的结果。
解决: 查询依旧是未修改的值
幻读 : 事物自身读取后一个范围内的数据后另一个事物插入了新事物插入了新数据,造成两次读到内容不一致
查询特定一行, 虽然第二次没有比第一次 多出 新插入的数据,但插入相同数据会失败 (如果少了数据叫 不可重复读)
行锁中的间隙锁/临键锁解决
Mysql/Mysql高级 > ^5cjxde 隔离级别 : 读未提交<读已提交 (脏读)<可重複讀<可序列化
表鎖
表級別的 S/X 鎖
觸發 : DDL 操作, drop table``alter table 或 無法使用索引可能導致行鎖升級為表鎖
手動觸發 : Lock Tables t READ/WRITE
在執行複雜的查詢(如聚合、連接等)時,可能會對整個表加 S 鎖,以確保查詢的一致性。 執行資料定義語言(DDL)操作(如建立、修改或刪除表)時,通常會加 X 鎖,以確保結構變更的安全性和一致性。
表鎖就是不對 DML 加鎖,但 DDL 期間阻塞 DML,同理 DML 阻塞 DDL
一般不會用到, InnoDB 表級別的 S 鎖和 X 鎖了解就可
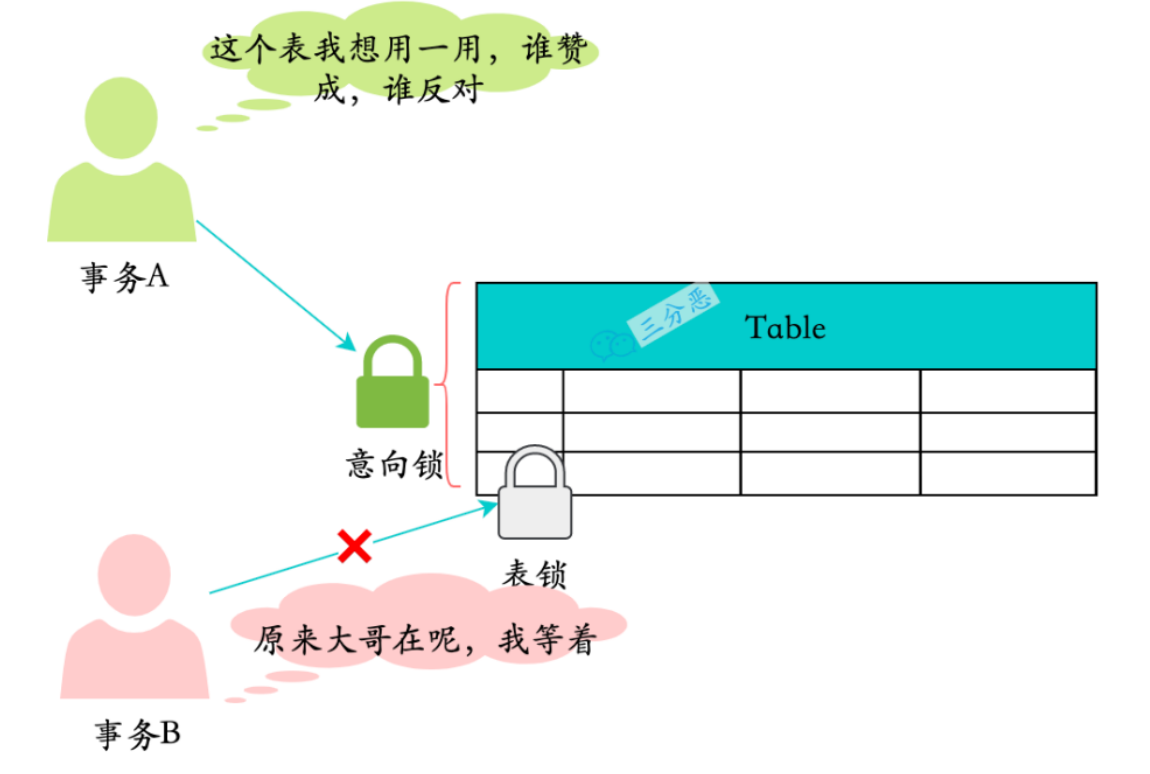
意向鎖 (意向共享鎖 IS 或意向排他鎖 IX)
兩者可以共存; 插入意向鎖(行鎖) 則表示有資料想要插入間隙 , 不同於 意向鎖
觸發: 任意隔離級別,任意讀寫
就是 標識鎖 , 為了協調 行鎖 和 表鎖 的關係,支持兩種鎖並存
在表中某一行加 X鎖 的情況下,其他事務不知道這個表中有沒有 X/S鎖,需要一條一條資料進行遍歷,效率低,因此加入了 IX/IS 意向鎖來標識這個表中哪一行有 X/S鎖 (排他鎖), 以便快速判斷
有 讀意向鎖 可以加表級 讀鎖
有 寫意向鎖,表級 讀寫鎖 都不能加,但可以加行級 讀寫鎖
自增鎖
MySQL 或 MySQL 高級 > ③ 自增鎖 AUTO-INC 鎖 了解
當一個事務要 插入insert 包含自增列的新記錄時,它首先會取得自增鎖
- 中繼資料鎖 (
MDL 鎖) Mysql/Mysql進階 > 中繼資料鎖 MDL 鎖 Mysql/Mysql進階 > 中繼資料鎖 MDL 鎖MDL讀取鎖: 對資料表進行新增刪除修改查詢操作時新增,此時不能進行結構變更MDL寫入鎖: 對資料表進行結構變更操作時新增,此時不能進行新增刪除修改查詢記錄鎖 : 可實現兩種隔離等級 : 讀取未提交<讀取已提交
加入S鎖
select ... FOR SHARE

一般加入X鎖,因為讀取的時候為了避免髒讀,不可重複讀,幻讀就直接加入的X鎖

加入X鎖
select ... FOR UPDATE

8.0 : 新增了`NOWAIT,SKIP LOCKED`語法,能夠立刻傳回,如果查詢的資料列已經加鎖,則會
	NOWAIT 立刻傳回錯誤
	SKIP LOCKED 立刻傳回不包含鎖定的資料列

新插入的資料由隱式鎖保護,確保不會被其他交易看到
資料列鎖
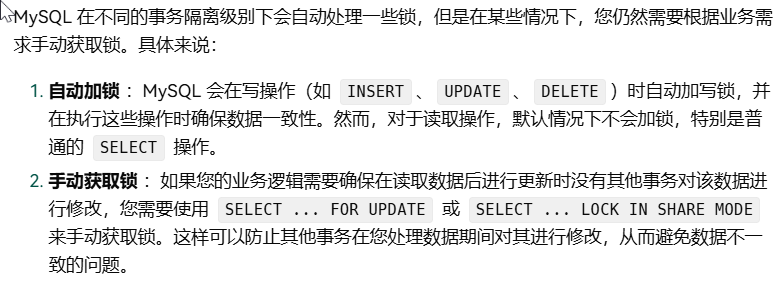 如果想要讀取操作取得寫入鎖就要手動取得
記錄鎖(Record Locks)
記錄鎖就是資料列鎖 (資料列的讀寫鎖)
Mysql/Mysql進階 > 2 寫入操作
間隙鎖(Gap Locks)< > : 解決幻讀
間隙鎖/臨鍵鎖 讓 可重複讀 隔離等級在一定程度上避免幻讀
mysql 8.0 預設 gap-lock 不是關閉
會在插入的記錄 主鍵值 和 mysql 資料表中上一筆記錄的主鍵值之間加入 間隙鎖, 為 開區間, 閉區間鎖 就是 臨隙鎖
臨鍵鎖<= >=(Next-Key Locks) Closed space version
is to lock nonexistent data
The closed space version of a gap lock locks the data itself in addition to the gap lock. The purpose of a gap lock is to prevent other transactions from inserting new rows between two existing values, but it does not block modification operations on existing rows. A next-key lock, which is the closed space version of a gap lock, locks not only the gap but also the existing data rows within the gap, thereby providing stricter data protection
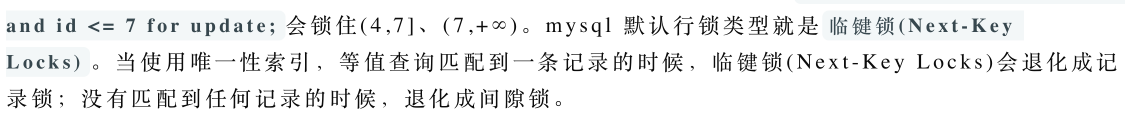 The inability to use an index causes what originally appears only in update statements within row locks, namely the
record lock to have the following added on top of it: gap lock, causing other transactions to be unable to update data within the gap
Locking(7,+∞)is to prevent transaction A, after queryingid<7 , from also querying values greater than 7. If it is not locked, phantom reads may occur
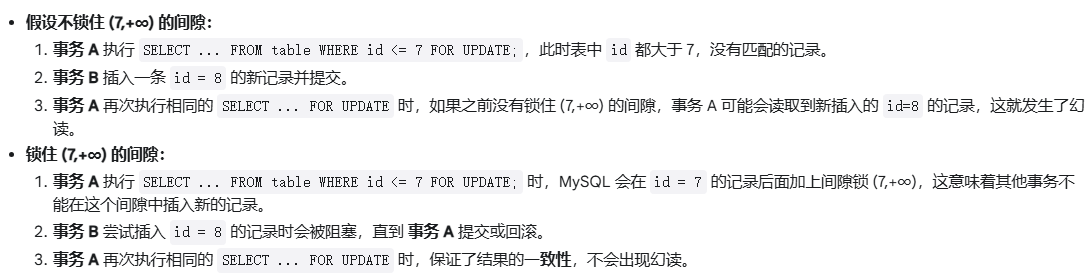
and id = 7 for update; Without an index, the entire table will be locked
Insert intention lock
An intention lock is a table lock An insert intention lock is a row lock
It indicates that a transaction wants to insert data into a gap but is currently waiting. It is a lock generated while waiting
When a transaction inserts a record, it needs to determine whether that position has been locked by another transaction with a gap、next-key locks lock. If so, it waits,InnoDB It is stipulated that while waiting, a lock structure must also be generated in memory, indicating that a transaction wants to insert data into the gap but is currently waiting. An insert intention lockmust be added, a type of Gap lock(a different intention lock)
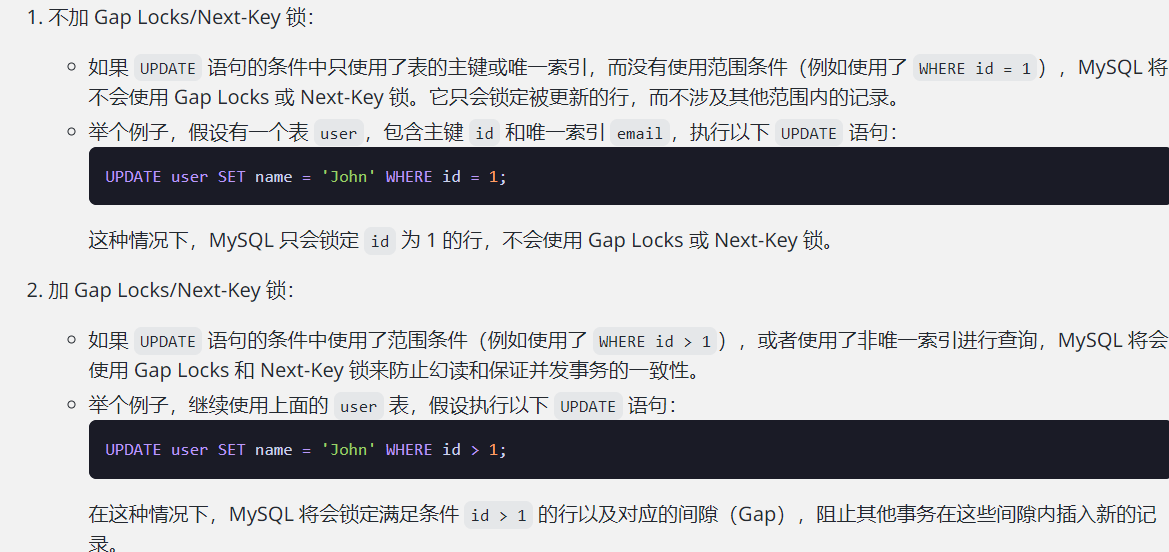 The first case used
MVCC to solve it
If one transaction holds an insert intention lock, other transactions attempting to insert into the same gap will be blocked
Page lock
The data of a table is organized into one or more pages, page lock is between table lock and row lock a lock granularity in between
In fact, InnoDB row locks mark lock information within data pages, so they can be regarded as a finer-grained control of page locks. The locked resources are more than row locks and less than table locks
How does Mysql add row-level locks, lock degradation
The object being locked is the index
The basic unit of lockingis next-key lock(left open, right closed
The basic range of lockingis the range of adjacent indexes, index order and the previous record of the current record
The basic order of locking: index scan order, scanning starts from the starting position of the index
Lock degradation condition: unique index
next-key lock The object to be locked must be within the current query range records.
Because the locking mechanism of InnoDB is based on records and gaps as units
Unique indexequalityquery
will lock the primary key index. If the index of a precisely matched record contains next-key lock it will degrade to a record lock (the reason is that in the scenario of a unique index equality query where the queried record exists, a record lock alone can also avoid the phantom read problem).
(Special case: if the precisely matched content does not exist, it will degrade togap lock,鎖定表中前後存在資料所在的區間)
唯一索引 range 查詢
如果宣告範圍的數不存在於表中,該記錄中索引的 next-key next key lock 會退化成 gap lock
其他掃描的記錄,則是在這些記錄的索引上加 next-key lock
案例
- 對於
> <select * from user where id > 15 for update;
會對 >15 的數的區間全部每個都加上 next key lock, 最後相當於 (15,+∞]
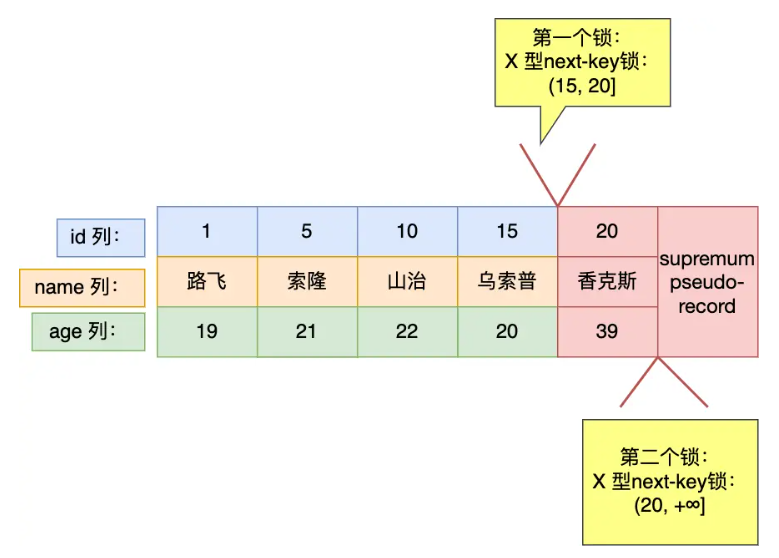
select * from user where id < 5 for update;
select * from user where id < 6 for update;
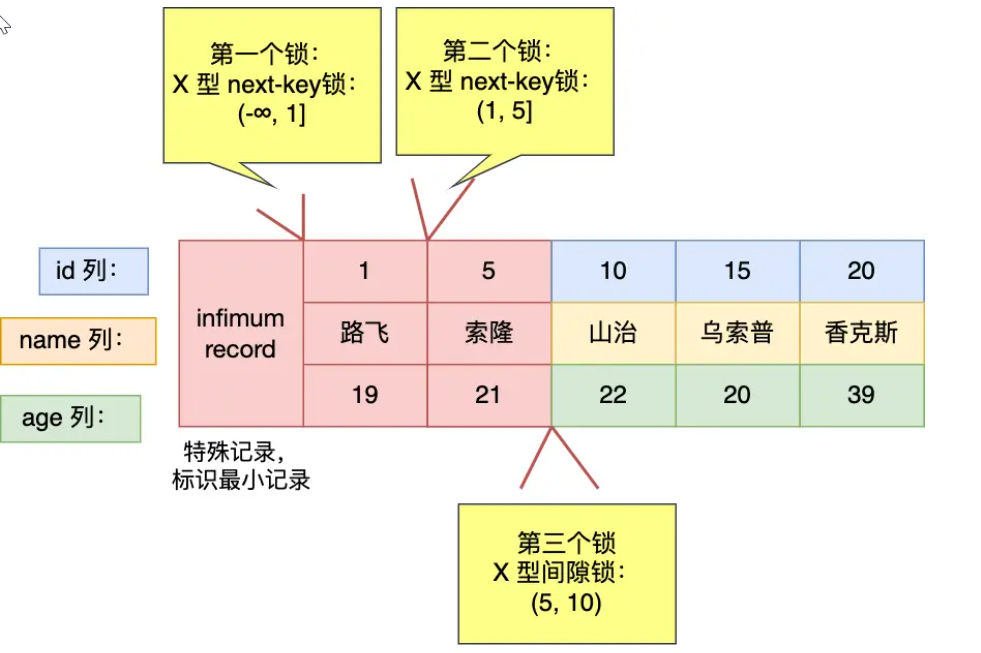
InnoDB 會從索引的起始位置開始掃描,直到找到不符合 id < 6條件的記錄
找到 1,5,和第一個不符合的 10
開始加鎖
2 個 next-key lock:分別鎖定 (-∞, 1] 和 (1, 5]
1 個間隙鎖: 鎖定 (5, 10) 範圍的間隙。注意這裡只有間隙鎖,沒有行鎖,因為 id=10 不滿足 id < 6 的條件。
1 和 5 都是查詢範圍內的記錄,要加 next-key lock
- 對於
>= <=select * from user where id >= 15 for update;
等值匹配的記錄本身加上 record lock, 最後相當於 [15,+∞]
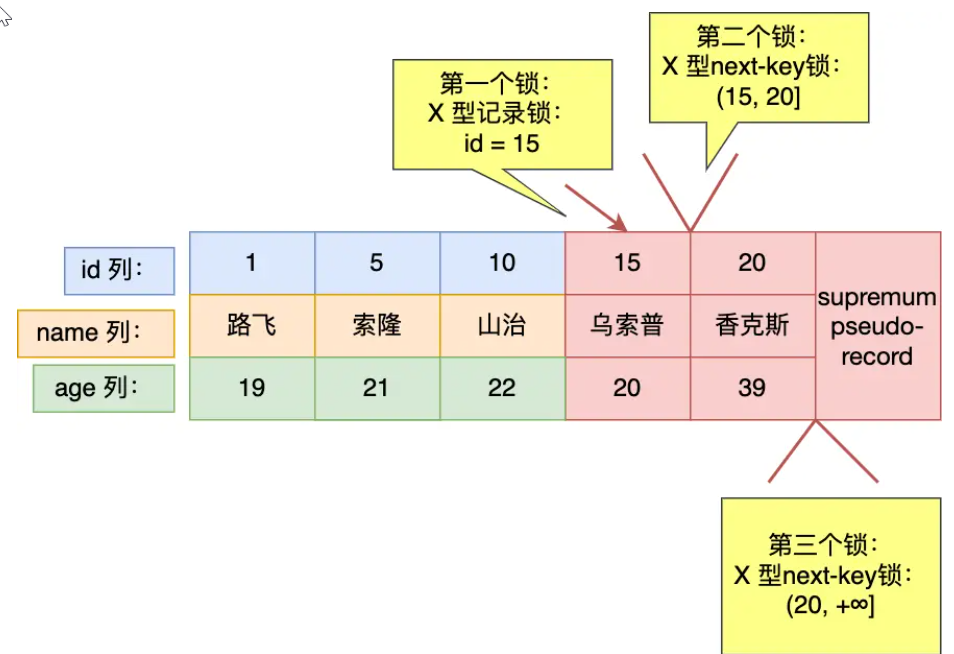
select * from user where id <= 5 for update;
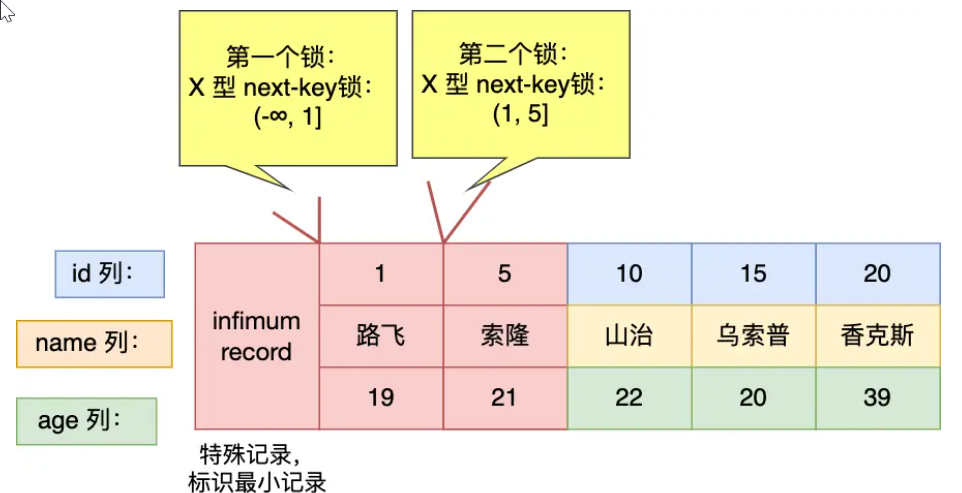
在針對「小於或者小於等於」的唯一索引(主鍵索引)範圍查詢時,存在這兩種情況會將索引的 next-key lock 會退化成間隙鎖的:
- 二級索引:如果查詢是基於二級索引(非聚簇索引)進行的,會首先鎖定二級索引,然後再鎖定對應的主鍵索引。為
next key lock
事務 A : update name='xiaolin' where id =1
事務 B : update name='xiaolin' where id =5
如果 id 有唯一索引,行鎖,事務 A, B 不影響
假設 ID 是二級索引,主鍵是 ID2,則會加上 next-key 鎖,事務 A, B 阻塞影響
- 會在 id 索引上,對 id = 1 這條記錄加上臨鍵鎖,鎖定 (-∞, 1] 這個範圍(包括記錄和間隙)。透過回表,找到 id = 1 對應的 ID2 = 100(假設),會在主鍵索引上,對 ID2 = 100 這條記錄加上臨鍵鎖,鎖定 (-∞, 100] (這裡假設主鍵值是連續的,實際情況更複雜)
沒有唯一索引就會全表掃描,於是就會對所有記錄加上 next-key 鎖 (記錄鎖+間隙鎖),相當於把整個表鎖住了。
那 update 語句的 where 帶上索引就能避免全表記錄加鎖了嗎?
並不是。關鍵還得看這條語句在執行過程種,優化器最終選擇的是index scan,還是full table scan,如果走了全表掃描,就會對全表的記錄加鎖了。
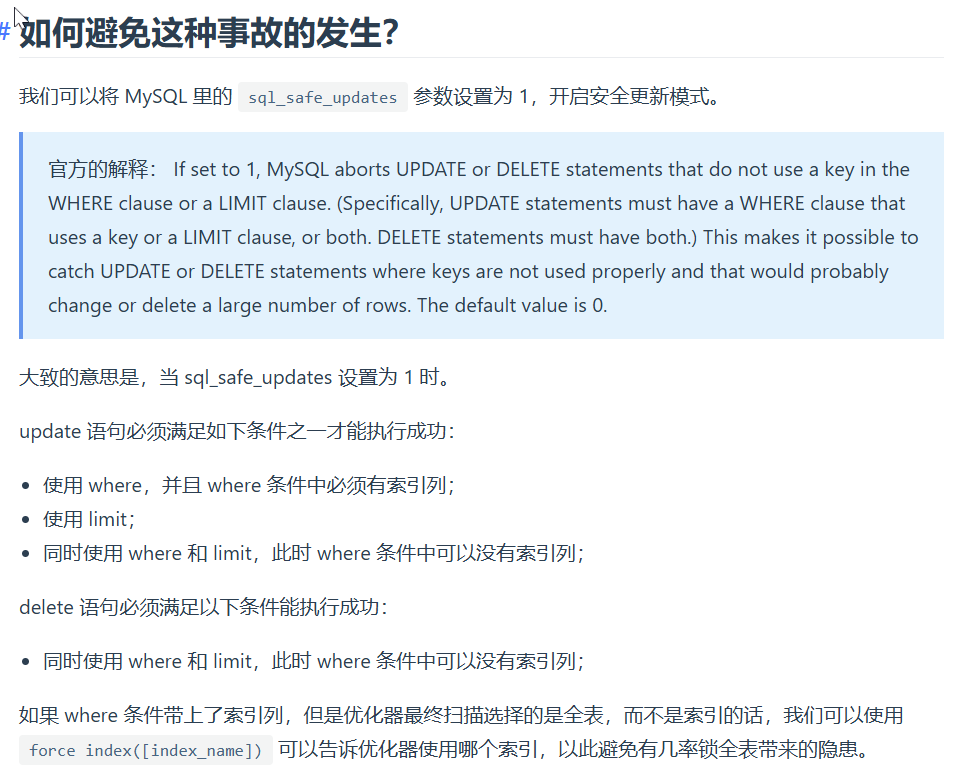
- 鎖升級
innoDB 引擎不存在鎖升級的問題,因為其不是根據每個記錄來產生行鎖的,是根據每個事務訪問的每個頁對鎖進行管理的。
悲觀鎖
optimistic lock, pessimistic lock 是一種 設計 思想,上面的分類是 基於實操
臨間鎖,行鎖都可以劃分為悲觀鎖
樂觀鎖
Mysql 預設悲觀鎖機制, 但支援樂觀鎖機制
不採用資料庫自身的鎖機制,而是透過程式 版本號 T機制 / CAS 機制 來實現,不存在死鎖
java.util.concurrent.atomic 套件下的原子變數類就是使用樂觀鎖的一種實現方式 : CAS 實現
只要有修改的語句就會版本加一 UPDATE ... SET version=version+1 WHERE version=version 每次修改前檢查版本是不是和自己讀到的版本一致,不一致就說明有別的事物進行了修改,保證了讀到的資料是別人沒有改過的
版本號機制 /時間戳機制
Mysql/Mysql進階 > ^p2oa6s
MySQL 8.0綜合使用MVCC、鎖機制以及版本號機制或CAS機制
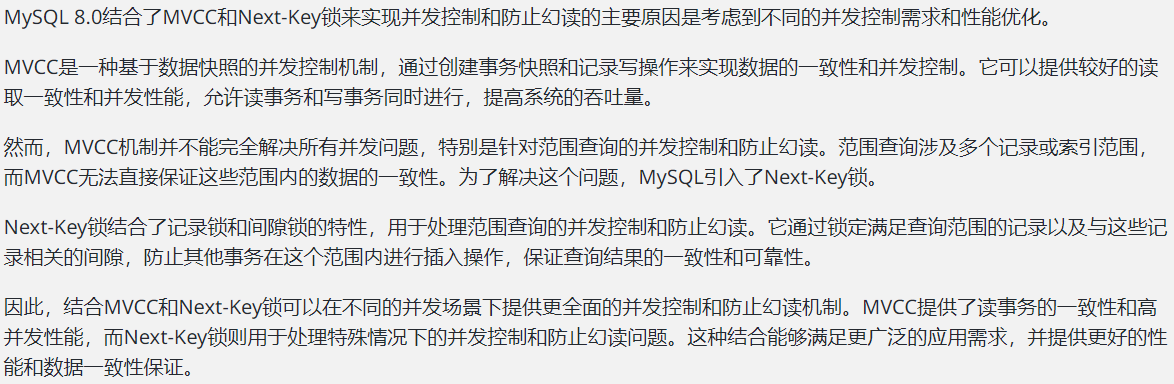
MVCC
MVCC (Multiversion Concurrency Control),即多版本並行控制技術,由於頻繁加解鎖會非常影響效能,為了避免只依靠鎖,降低鎖的使用,透過 MVCC 機制可以 減少對行級鎖 的使用, 它使得大部分支援行鎖的事務引擎,不再單純的使用行鎖來進行資料庫的並行控制,取而代之的是把資料庫的行鎖與行的多個版本結合起來,只需要很小的開銷, 就可以實現 非鎖定讀,從而大大提高資料庫系統的並行效能
如讀取資料不會上讀鎖,在某些特定的查詢中,例如涉及到某些聚合函數或子查詢,MySQL 可能會選擇加鎖而不是使用快照。
預設隔離級別下使用 MVCC+鎖 依然存在的問題
快照讀 : 不加鎖 , 有可能讀到歷史資料,如果串行隔離級別快照讀會變成當前讀 , 快照讀透過 MVCC 提供資料的快照,不會加鎖,允許其他事務同時對資料進行修改。
問題: 不一致 (有可能讀到歷史資料)/幻读
當前讀 : 加鎖,為了最新資料
MVCC基於 undo log 和 Read View
undo log鏈:關聯每個事務的提交,相當於有了資料的各個階段的各種版本
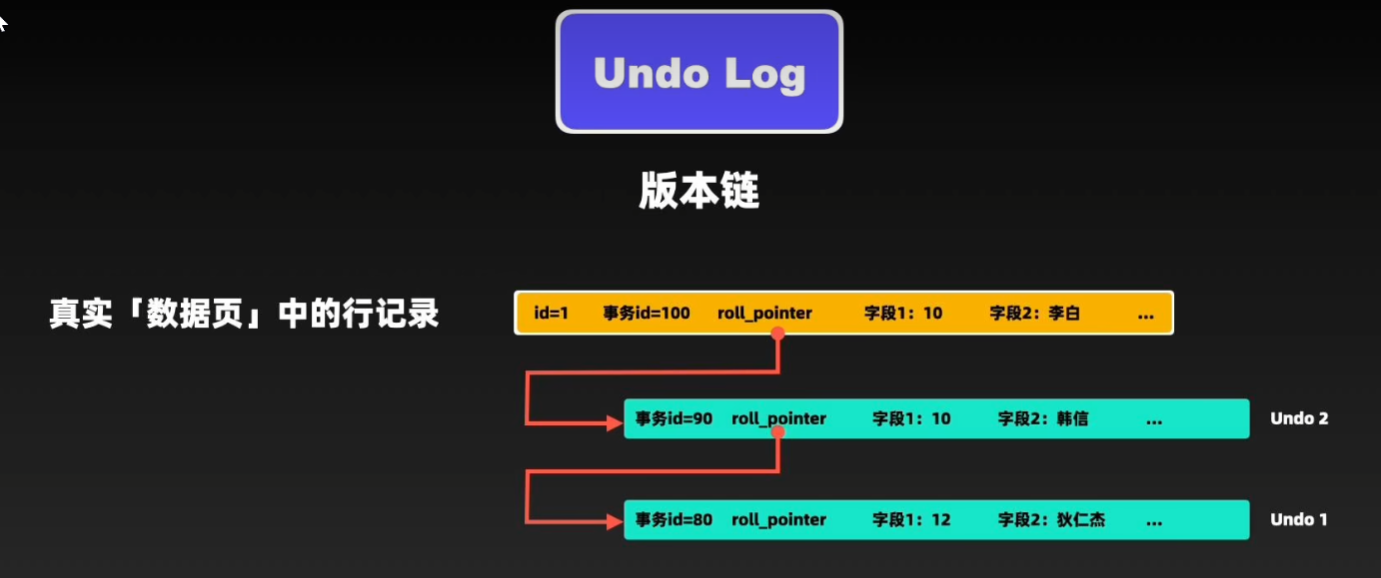
如何選擇需要的版本,根據 readview 讀視圖
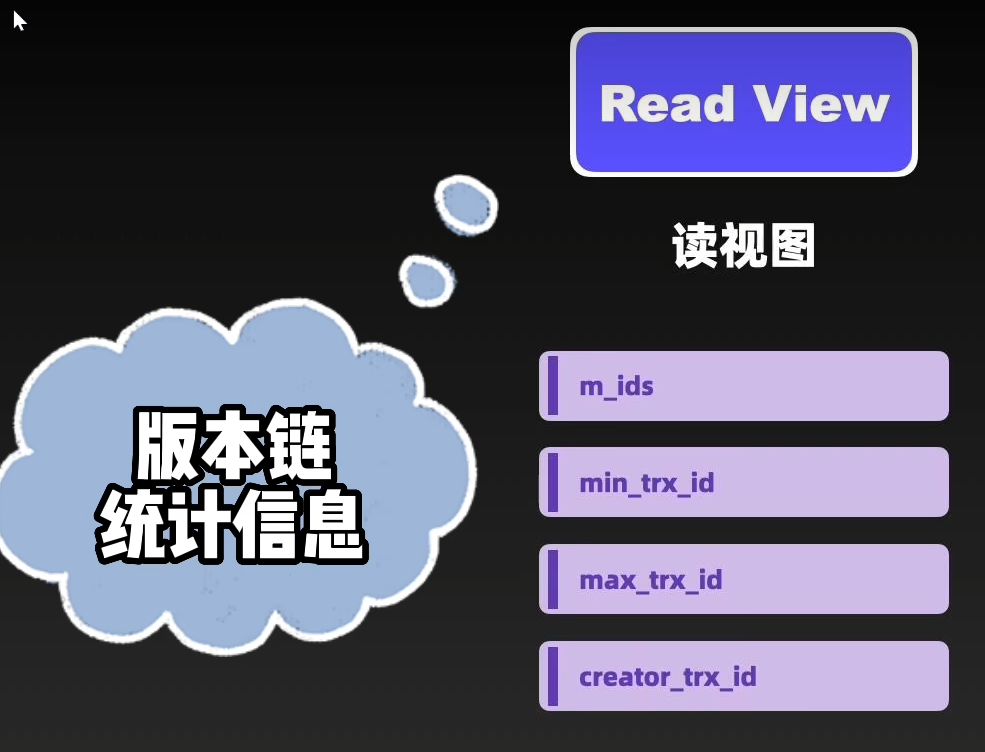
Read view 記錄了版本鏈的統計值,後續查詢處理就無需遍歷所有的版本鏈了
creator_trx_id:建立該Read View的事務ID。min_trx_id:當前資料庫中最小活躍事務的ID。max_trx_id:當前資料庫中最大的事務ID。m_ids:活躍事務的ID集合。
每個事務都會建立自己的 Read view,包含當前事務自己的
creator_trx_id, 遍歷 undo log鏈
如果在 undo log鏈 中
事務 id<min_trx_id, 則該事務生成前,該事務就已經提交,
事務 id>max_trx_id,則是該事務產生 Readview 後別的事務的操作,因此不可見。
事務 min_trx_id<id<max_trx_id & id not in m_ids(活躍事務id),說明該事務已經提交,可以讀取。
事務 id=creator_trx_id 是自身事務建立的,可以直接存取
因此,Read View 的作用是幫助事務確定在其建立時哪些資料是可見的,並透過遍歷 undo log 來實現這一點。
(設計思想類似:頁目錄、意向鎖)
Mysql/Mysql高級 > 隱藏欄
DB_TRX_ID,事務ID ,每次修改時,都會把該事務 ID複製給 DB_TRX_ID;
DB_ROLL_PTR,回滾指標,指向回滾段的 undo 日誌
MVCC 可以解決不可重複讀和幻讀嗎?
幻讀 不可以
不可重複讀 可以
讀已提交 每次讀都產生一個 Readview
可重複讀 只產生一個 Readview, 保證不會讀到其他事務的
維運
備份
- 先備份了使用者表的資料: 2.然後有使用者發起了購買商品的操作: 3.接著再備份商品表的資料。 也就是在備份使用者表和商品表之間,有使用者購買了商品。 這種情況下
常規備份的結果是使用者表中該使用者的餘額並沒有扣除,反而商品表中該商品的庫存被減少了, 後面用這個備份檔案還原資料庫資料的話,使用者錢沒少,而庫存少了,等於使用者白嫖了一件商品。
加 全域鎖: 整個資料庫唯讀,影響業務
解決方式: 使用 mysqldump --single-transaction ,MySQL 在備份資料庫之前先開啟事務。會建立 readview, 不影響讀和寫,這種方式餘額和庫存都不會減少。這種方法只適用於支援「可重複讀隔離級別的事務」的儲存引擎。對於 MyISAM 這種不支援事務的引擎,在備份資料庫時就要使用全域鎖的方法。