Redis 的单线程与多线程
Redis 单线程和多线程
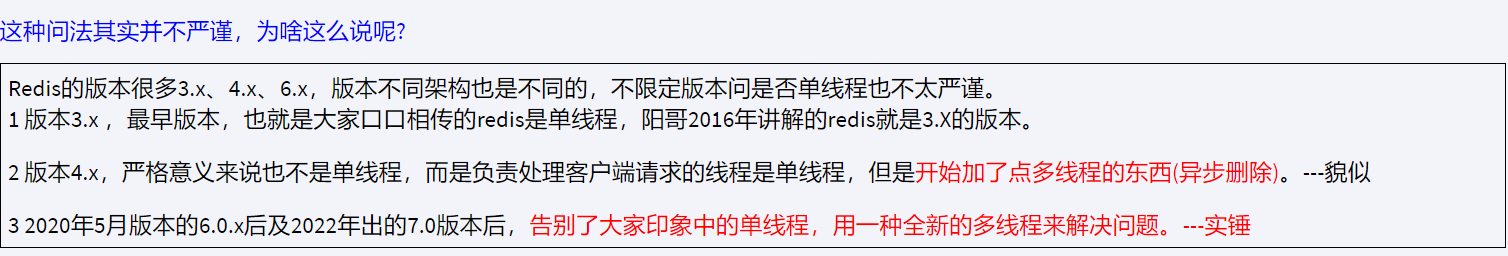
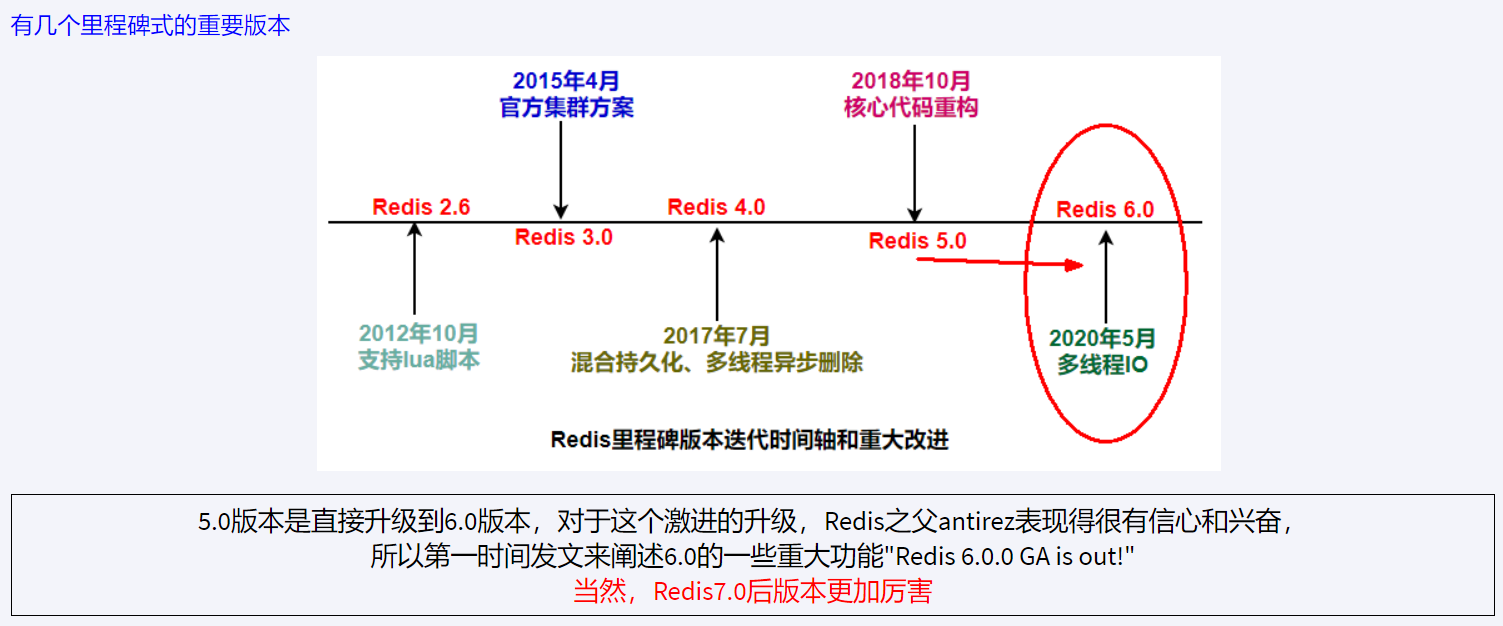
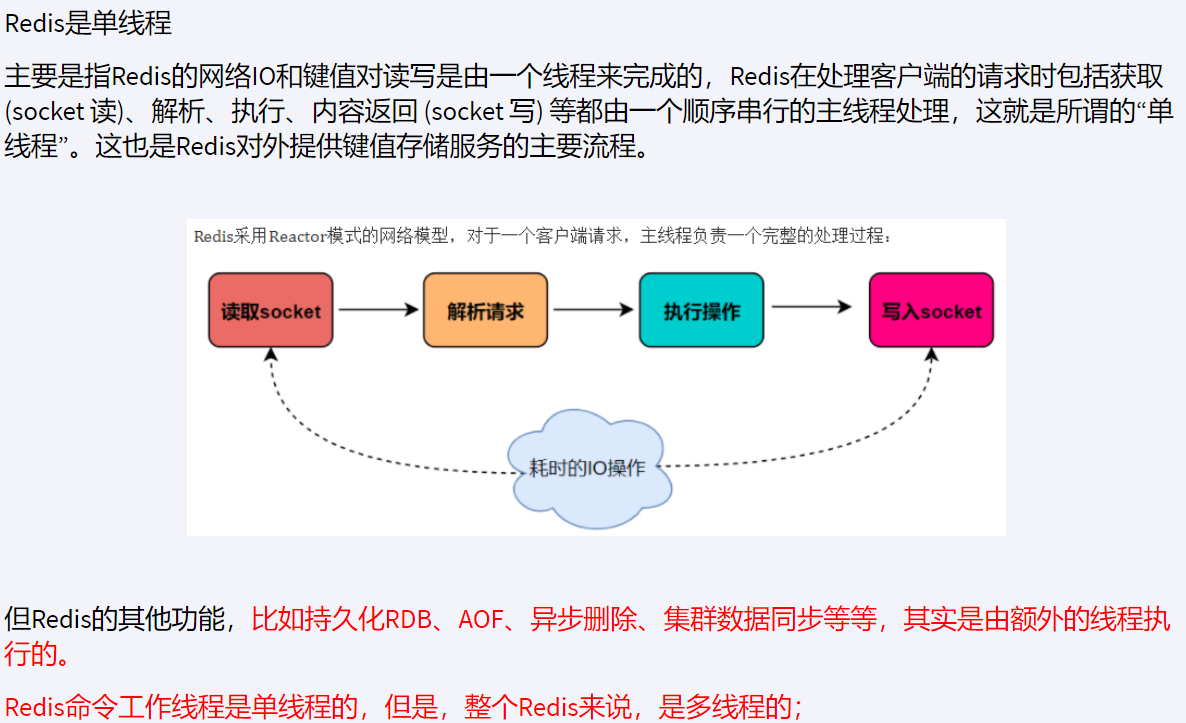
到 6.0 以后,整个 redis 来说,是多线程的,但 redis 的 工作线程 (十大数据类型的操作)是单线程 , 如 RDB,AOF,异步删除,集群数据同步 都是额外的线程执行的
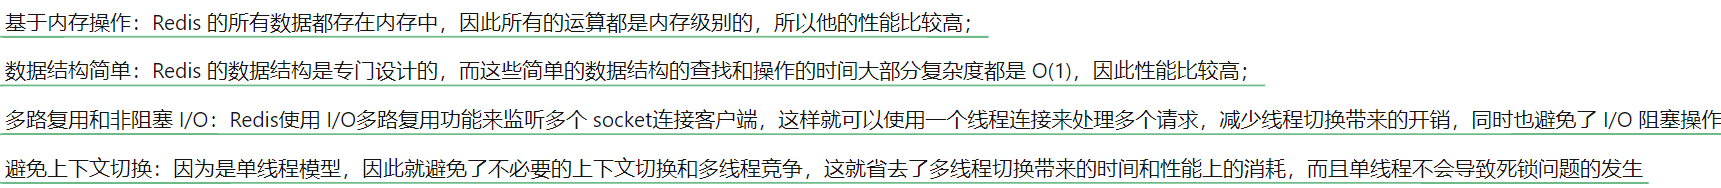
Redis最初为何选择单线程
最初单线程仍然很快的原因
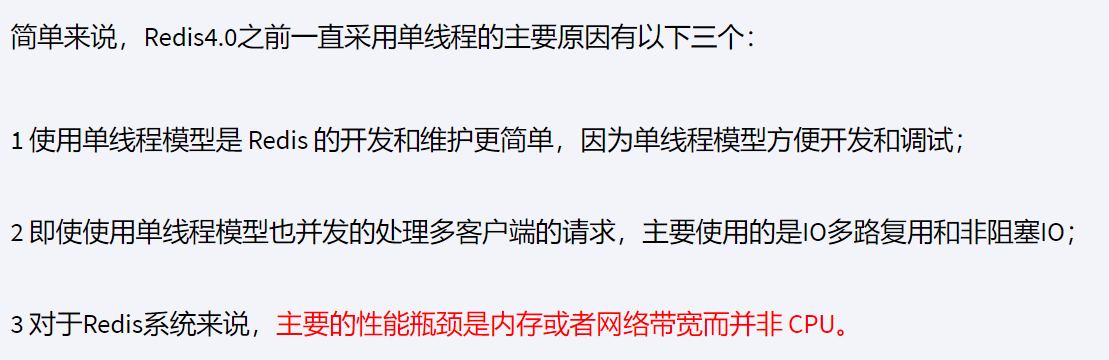
多线程是为了更好的利用 CPU,而对于 redis 来说主要瓶颈是内存或者网络带宽而非 CPU,而且即使单线程也能通过多路复用和非阻塞 IO 来并发处理客户端的请求, 最初单线程的维护和开发更加简单
为什么后来又加入了多线程
例如时包含了成千上万个元素的 hash 集合时,那么 del 指令就会造成 Redis 主线程卡顿
等待很久这个线程才会释放,类似加了一个synchronized锁,你可以想象高并发下,程序会超级堵
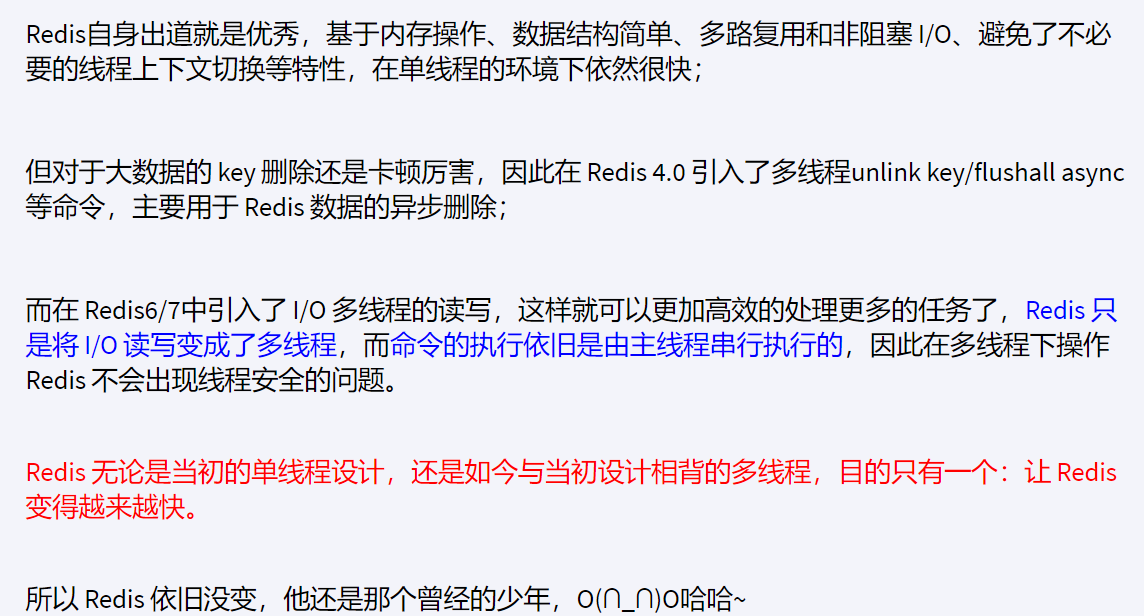
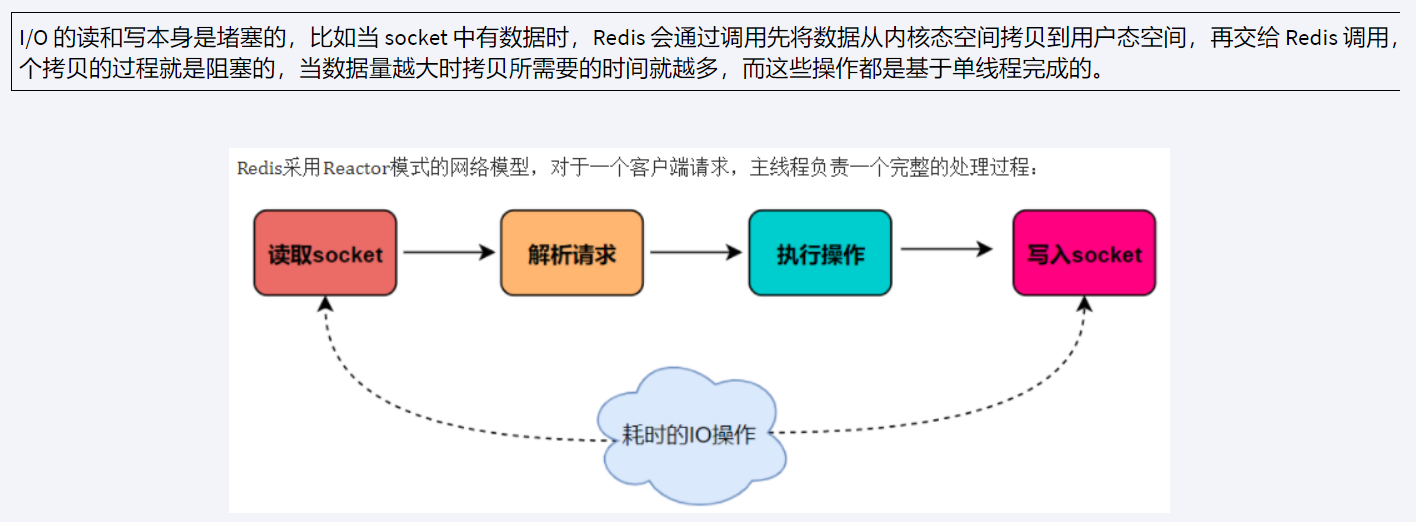
网络 IO 是多线程, 真正干活的线程还是单线程
多个服务器连接一个 redis 服务器进行操作,多个网络 IO,但是只有 redis 主线程负责写入
IO多路复用入门,真正的主线程登场
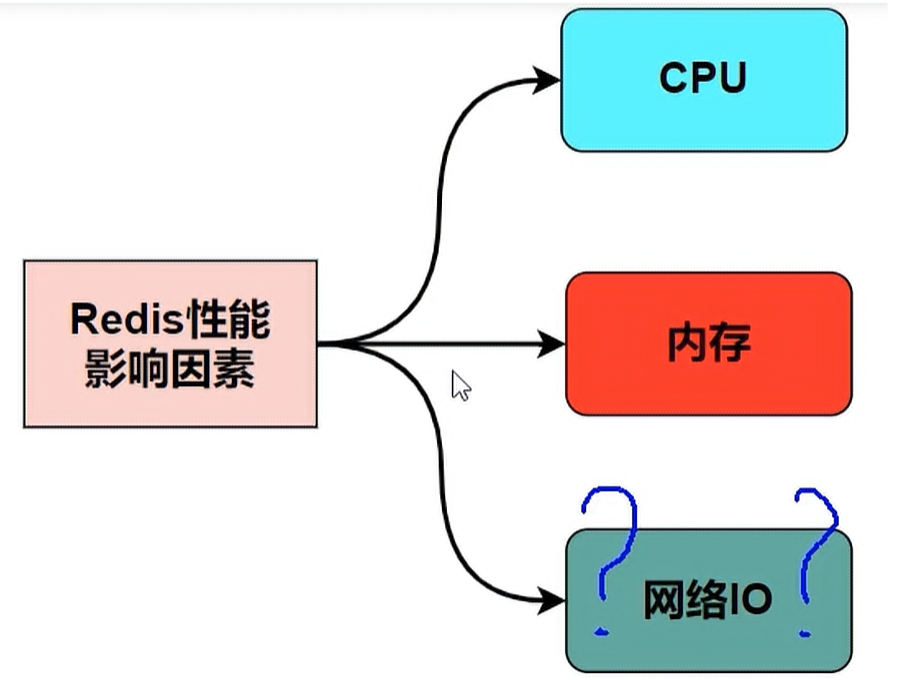
一般来说CPU,内存都不是问题,网络IO是主要的问题
虽然有些命令操作可以用后台线程或子进程执行(比如数据删除、快照生成、AOF重写)。但是,从网络IO处理到实际的读写命令处理,都是由单个线程完成的。Redis的性能瓶颈有时会出现在网络IO的处理上,也就是说,单个主线程处理网络请求的速度跟不上底层网络硬件的速度,为了应对这个问题:
采用多个IO线程来处理网络请求,提高网络请求处理的并行度,Redis6/7就是采用的这种方法
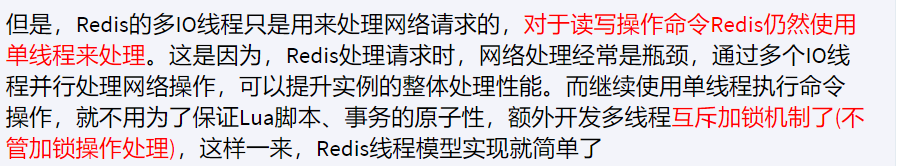 也就是网络IO是多线程,真正干活的线程还是单线程
- 连接,建立了
Socket连接
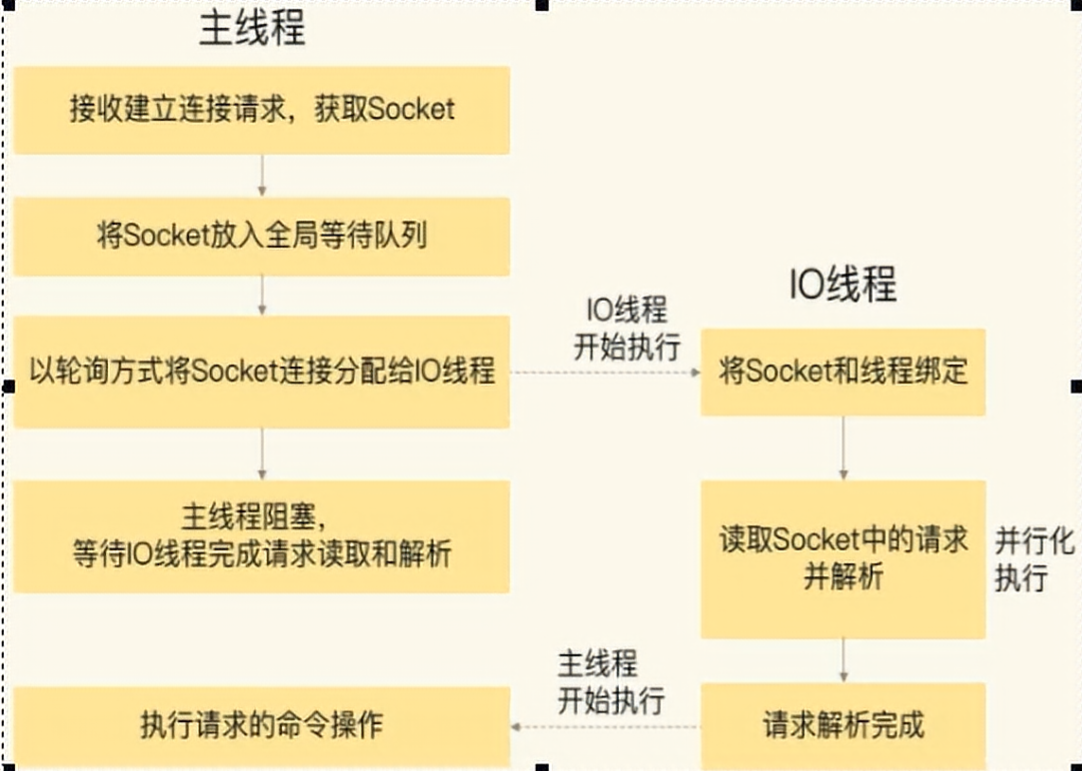
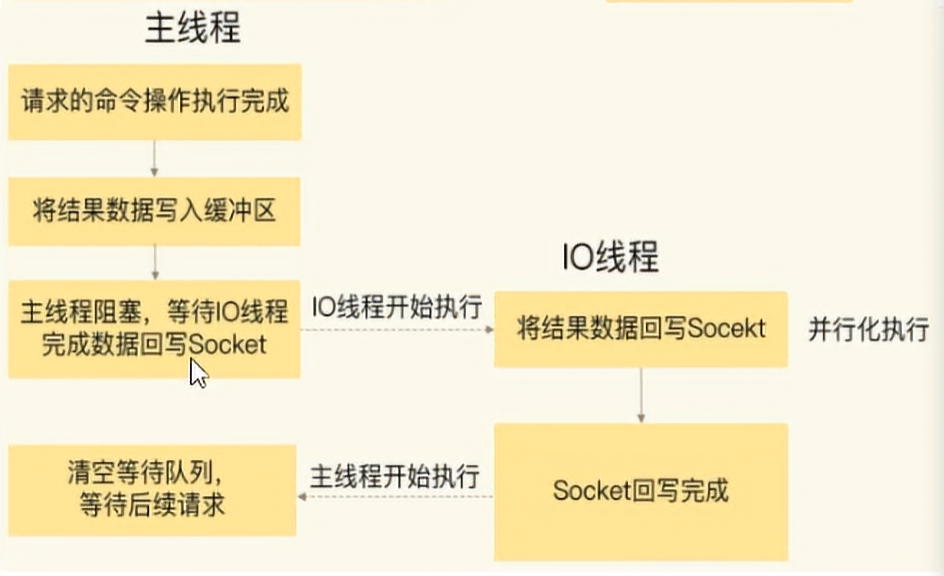
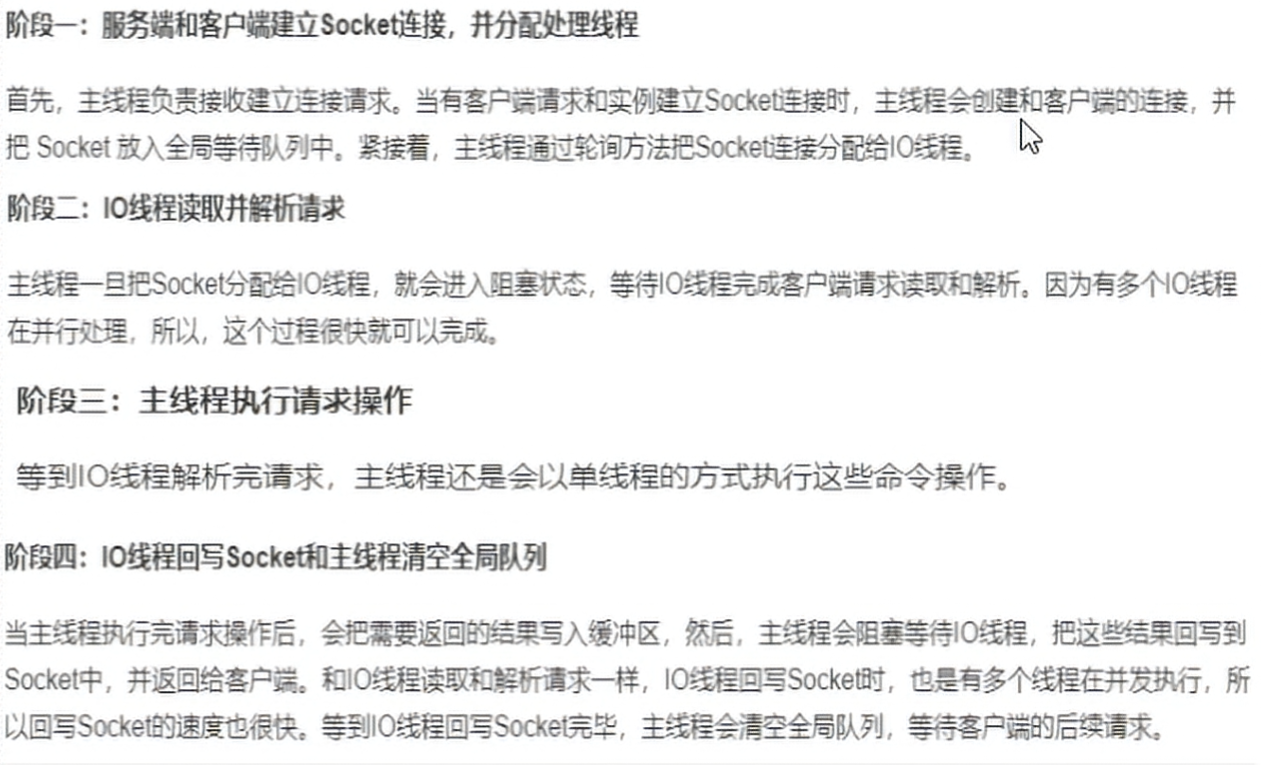
IO线程读取和解析,比如网络是否通,IP是否允许,防火墙是否允许
redis 很快的原因是 IO 多路复用和 epoll 函数的使用
Unix 网络编程中五种 IO 模型
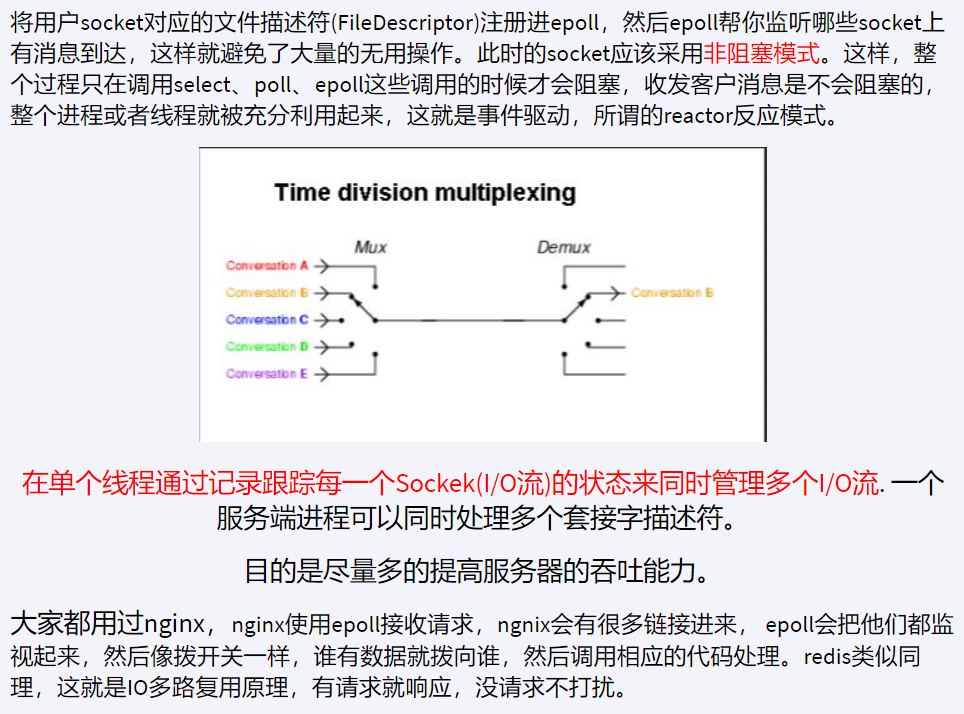
IO 多路复用入门 : 只用一个服务进程就可以同时处理多个套接字描述符连接
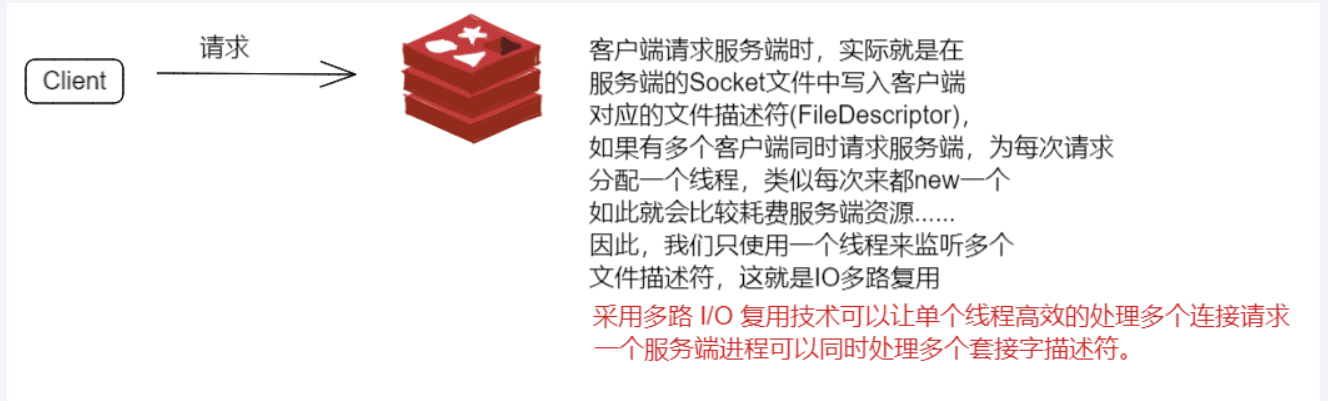
IO 多路复用就是一种同步的 IO 模型, 实现一个线程监视多个文件句柄, 一旦某个文件句柄就绪就可以通知到对应程序进行相应的读写操作, 没有问及那句柄就绪就会阻塞应用程序, 从而释放计算机资源
IO 多路复用 : 使用单线程就能够处理多个客户端的连接, 无需维护过多的进程
IO多路复用入门
文件描述符 FD 句柄
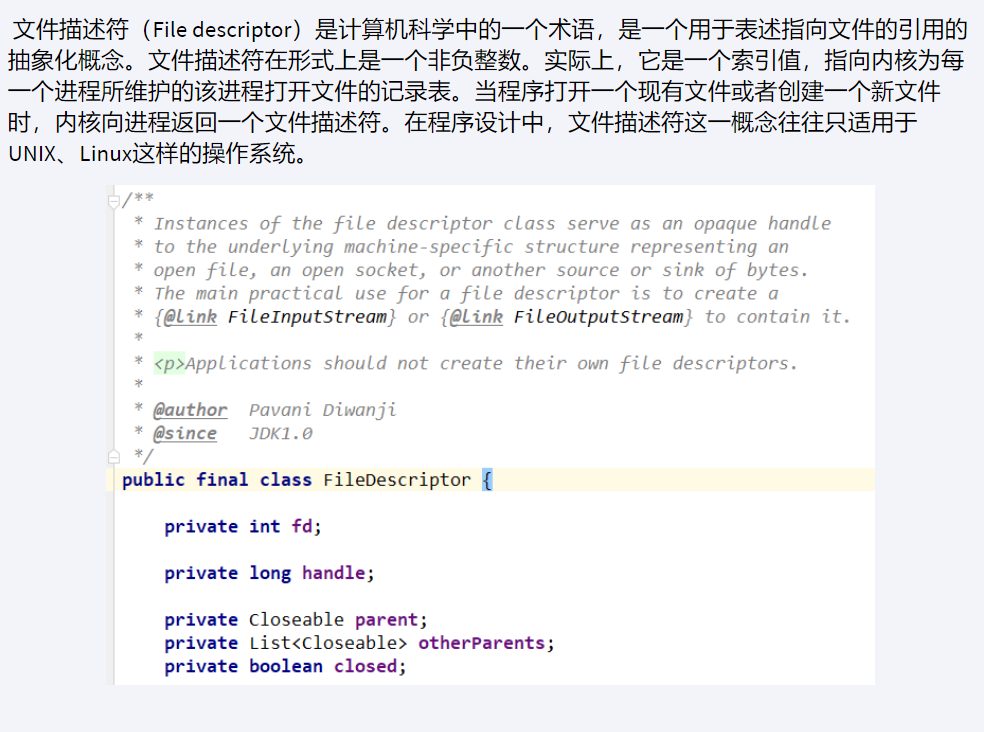
IO多路复用是什么
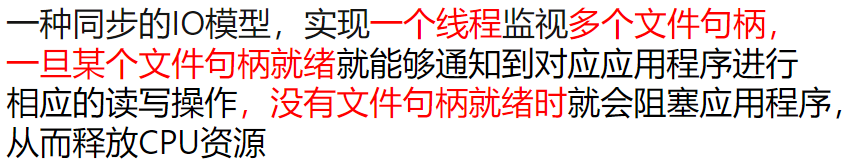
"文件句柄就绪"通常指的是操作系统中的文件描述符(file descriptor)或文件句柄(file handle)处于一种可以进行I/O操作的状态。
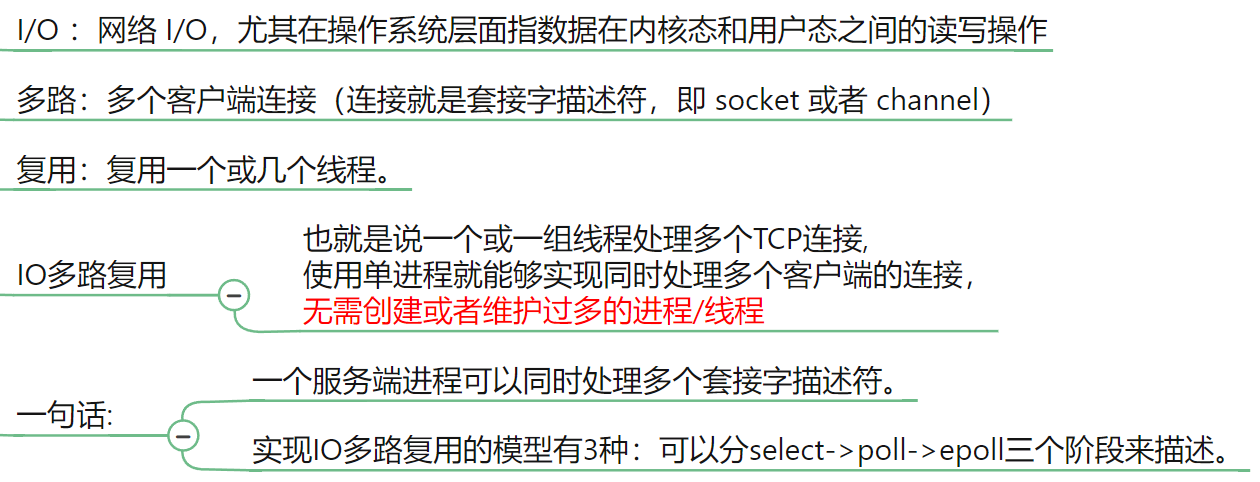
redis与多路复用
redis 不会出现线程安全问题因为主命令执行依旧是由主线程执行完成的
redis 与多路复用
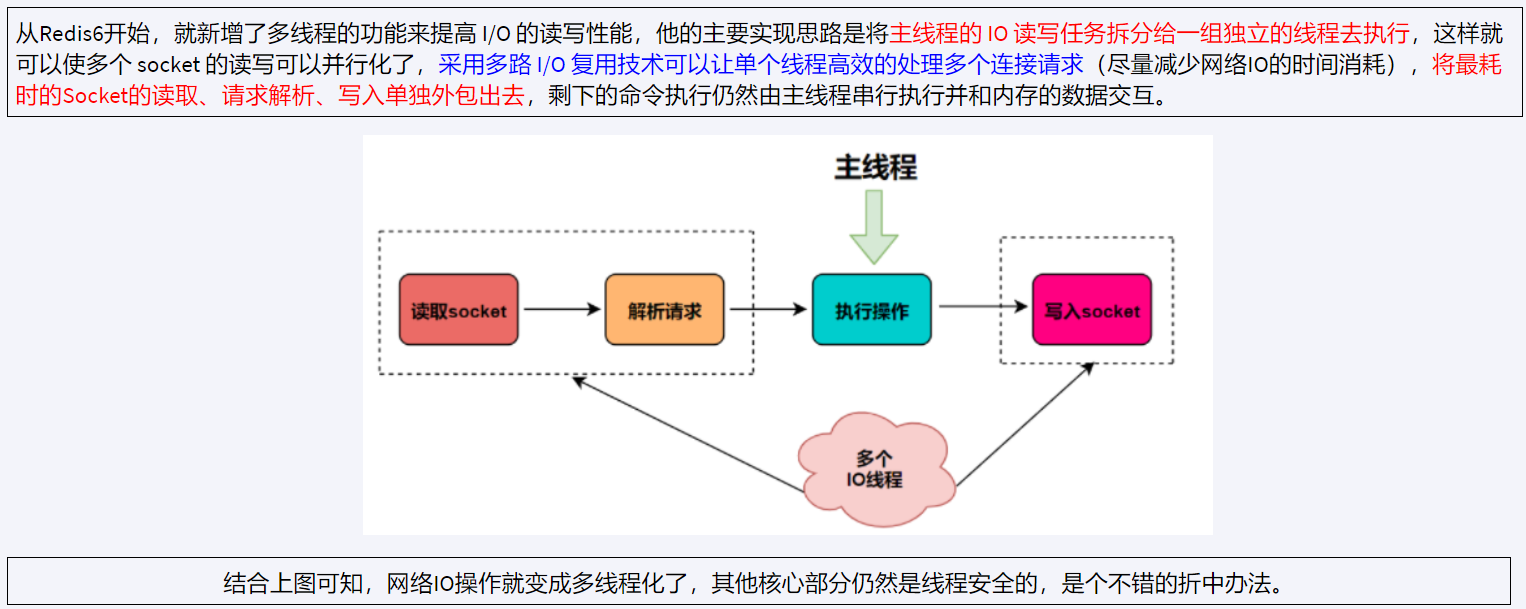
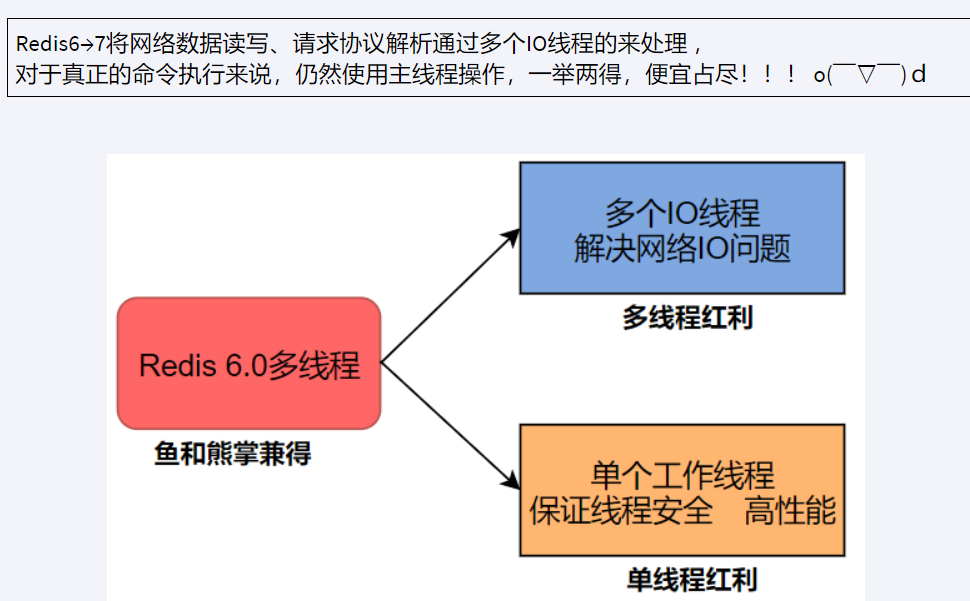
由于多线程默认关闭,实际应用中,如果发现 redis 实例的 CPU 开销不大但吞吐量却没有提升,可以考虑开启, 80%的公司单线程就够了
开启多线程

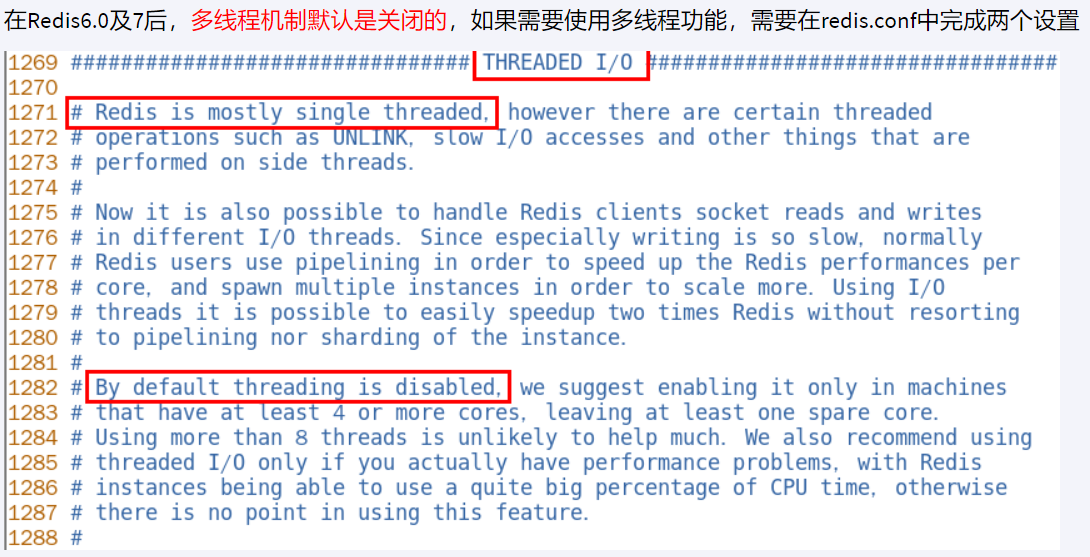
1.设置io-thread-do-reads配置项为yes,表示启动多线程。
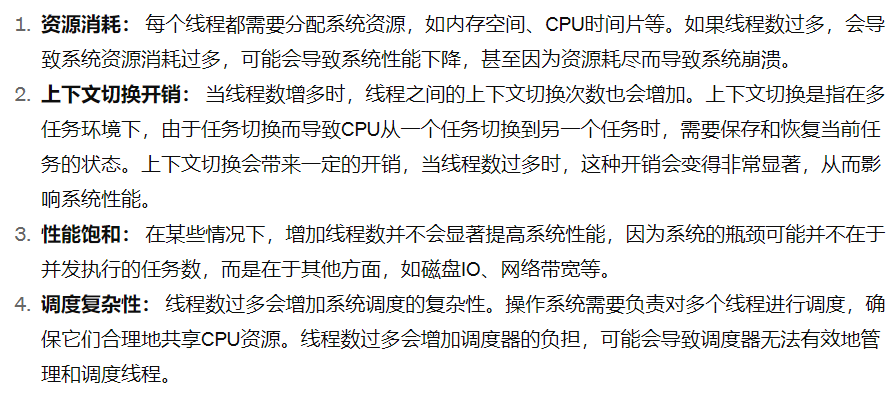
2。设置线程个数。关于线程数的设置,官方的建议是如果为 4 核的 CPU,建议线程数设置为 2 或 3,如果为 8 核 CPU 建议线程数设置为 6,线程数一定要小于机器核数,线程数并不是越大越好。
线程不是越大越好
Redis 的多路复用指的是在单线程中通过 epoll 或 kqueue 等机制同时监听多个套接字的可读写状态,从而实现对多个连接的管理和处理。这种机制使得 Redis 单线程能够处理大量的并发连接而不会阻塞。
即使 Redis 不使用多线程,仍然可以利用多路复用机制来管理连接。这是因为多路复用并不依赖于多线程,而是利用了操作系统提供的异步 I/O 机制,通过单个线程来监听和处理多个连接的状态变化。
BigKey
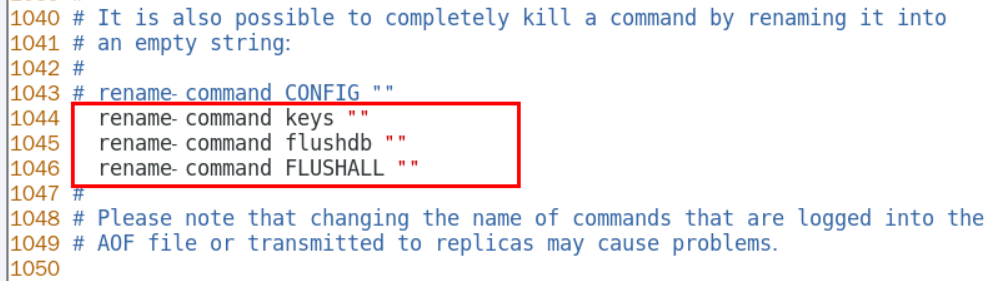
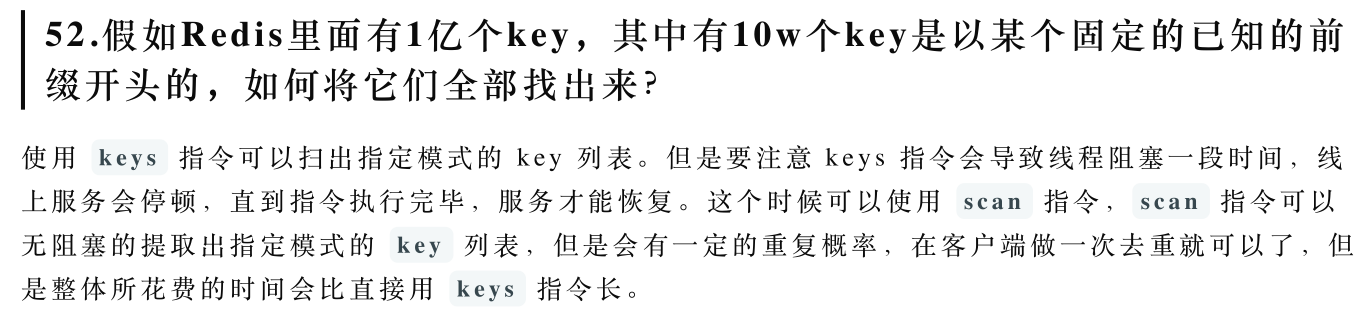
禁用redis中keys */flushDB/flushALL
直接配置文件中配置成空串 ""
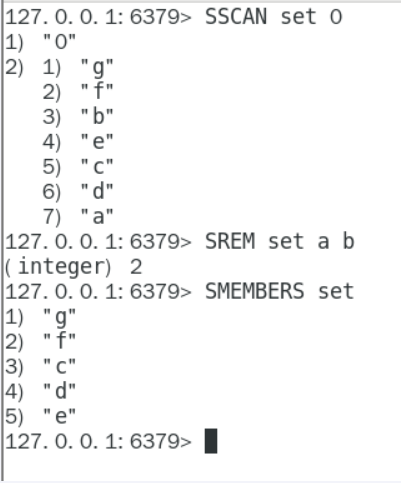
scan
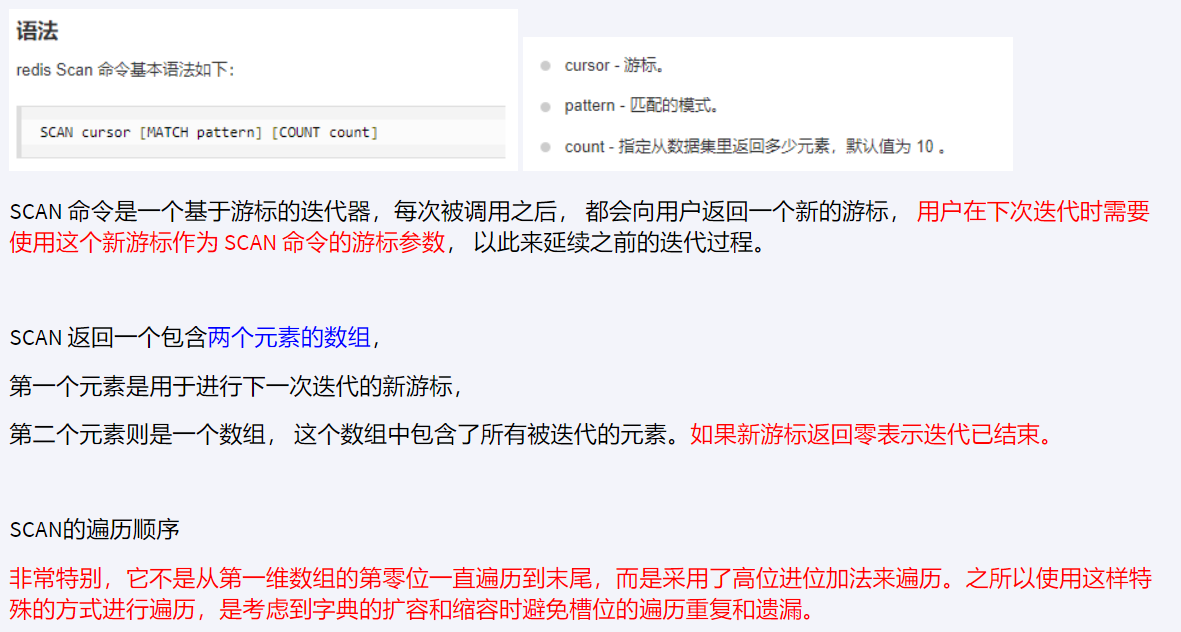
Redis 的 SCAN 命令是用于迭代集合中的元素的命令。它可以用于遍历集合中的所有元素,而不会阻塞服务器。
相比于使用 KEYS 命令获取所有元素,SCAN 命令更加高效,因为它可以在不同的迭代器之间平均地分布工作负载,而不会对服务器产生太大的负载
SCAN cursor [MATCH pattern] [COUNT count] [TYPE type]
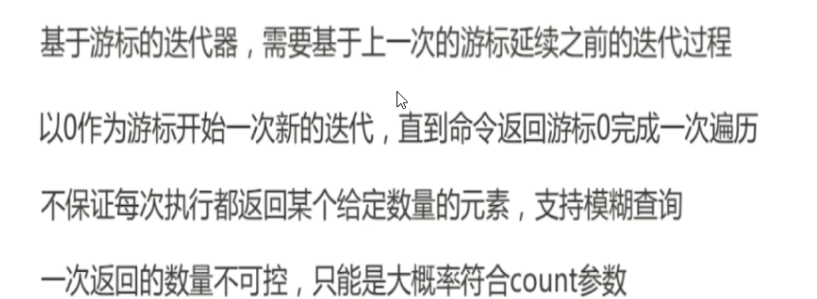
SCAN 返回一个包含两个元素的数组
第一个元素是用于进行下一次迭代的新游标
第二个元素则是一个 数组,这个数组中包含了所有被迭代的元素。如果新游标返回零表示迭代已结束。
一次返回的数量不可控, 只能是大概率符合 count 参数
使用方式
- 创建好
scanParams scan中填入scanParams
定义一个scan
ScanParams scanParams = new ScanParams().match(pattern).count(count); ScanResult<String> scanResult = jedis.scan(cursor, scanParams);

//第一个元素
cursor = scanResult.getCursor();
//第二个元素
List<String> keys = scanResult.getResult();
基本使用
大 key
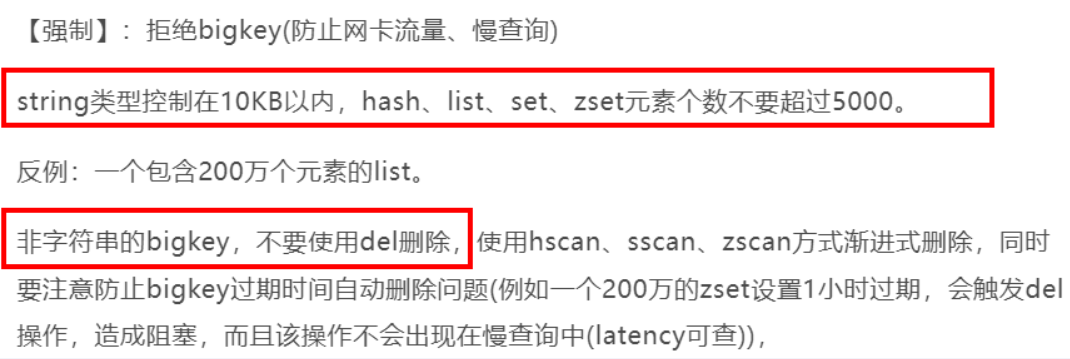
多大算大key
《阿里云规范》
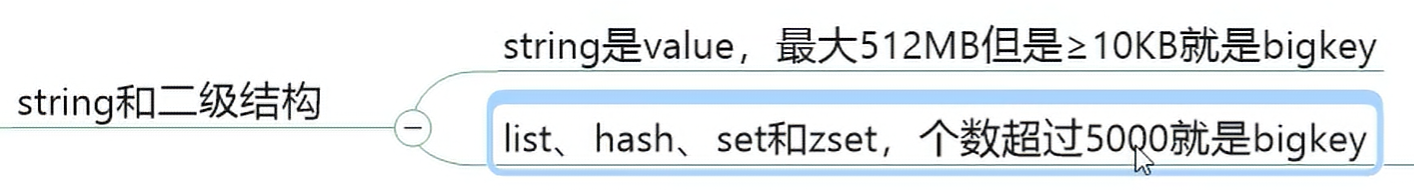
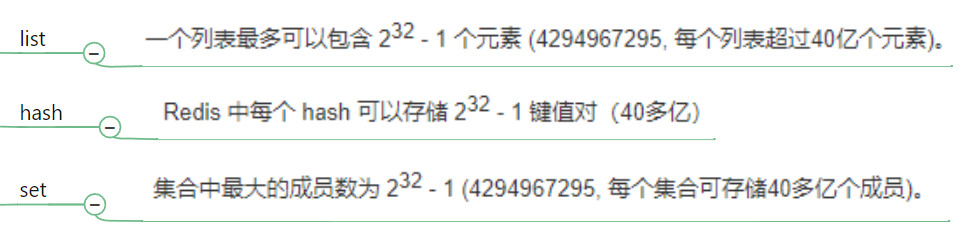
如何发现大key
redis-cli xxxx 结尾加上 --bigkeys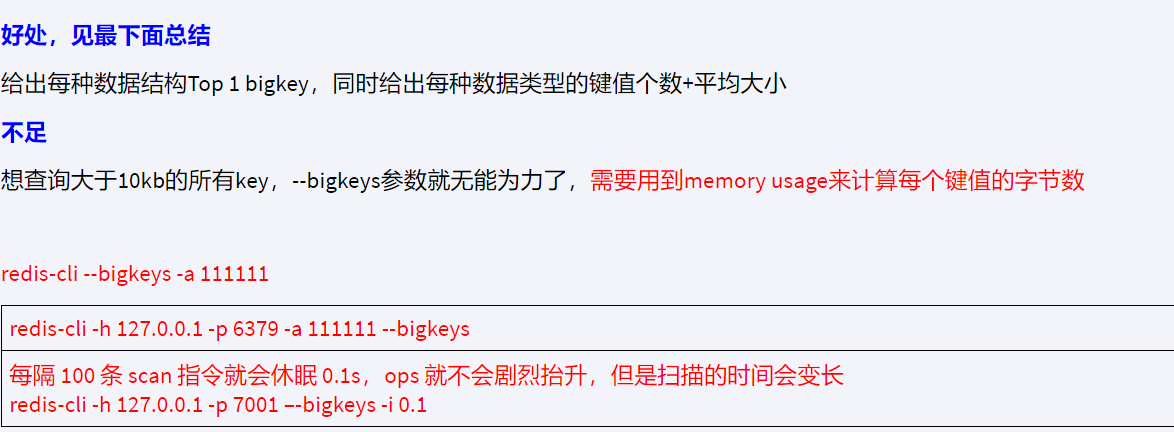 虽然
--bigkeys命令可以帮助你找到一些大键,但是当键的大小超过一定限制时,它可能无法提供高效的性能,甚至可能会对Redis实例的稳定性和整体性能产生负面影响。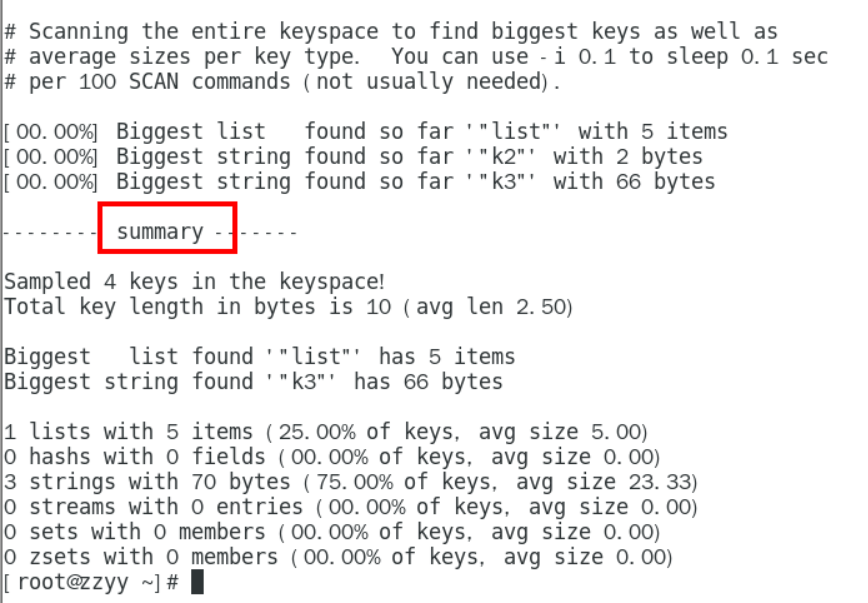
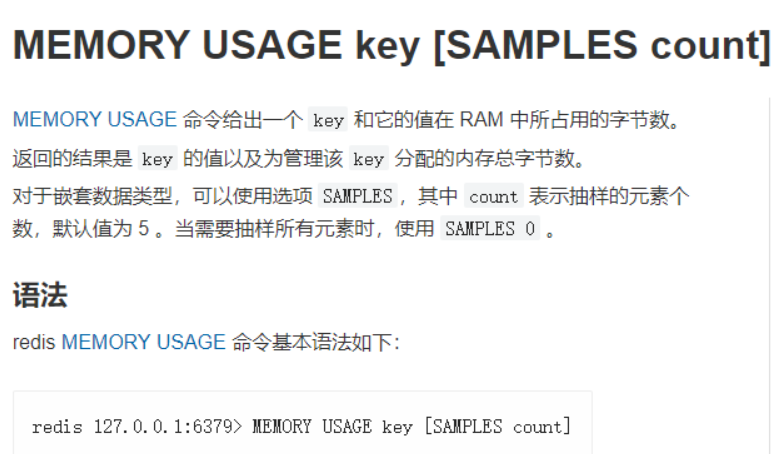
memory usage key
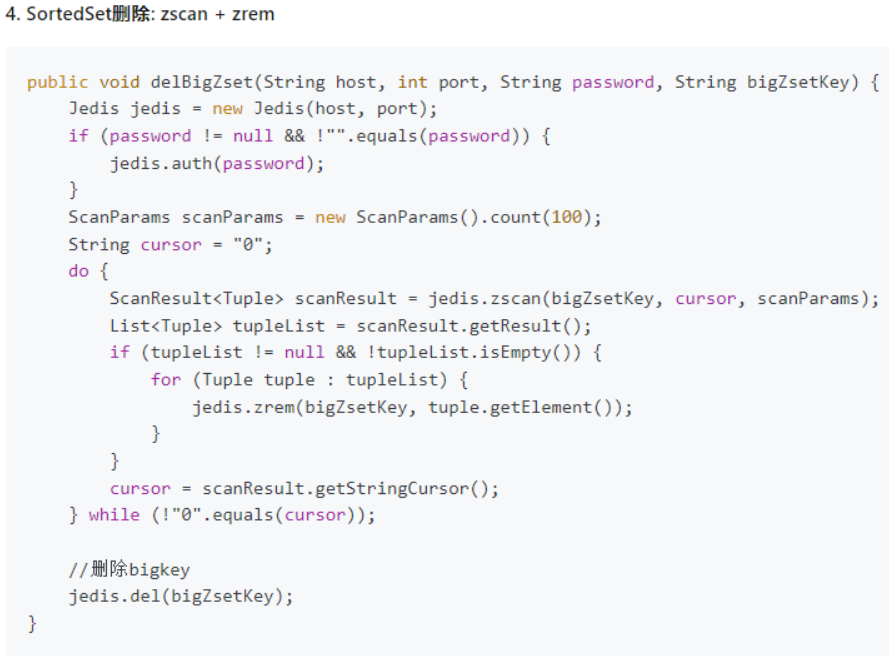
删除
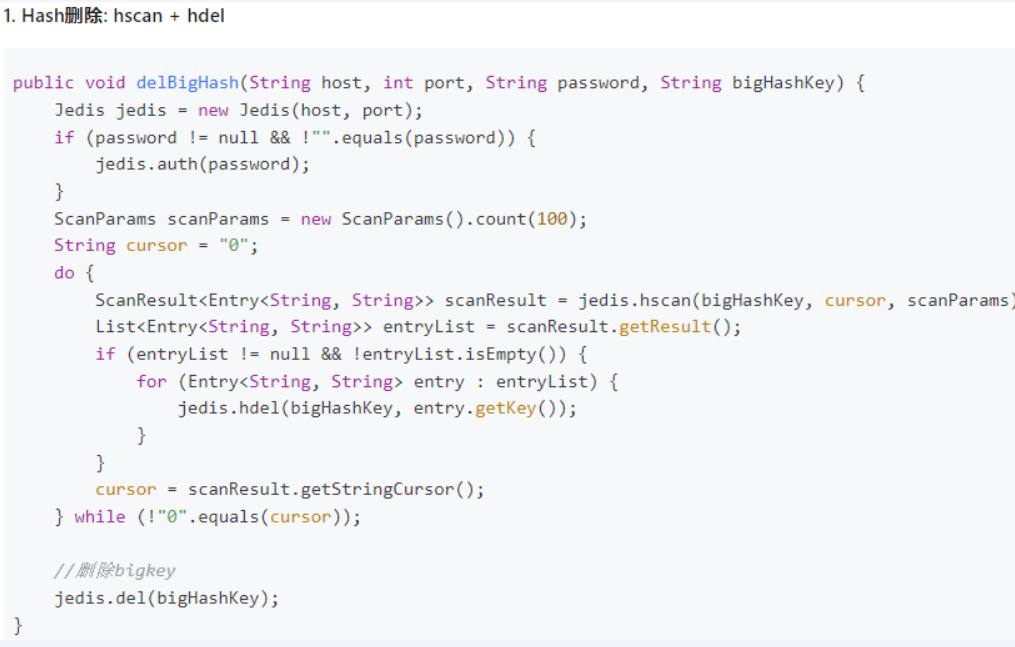
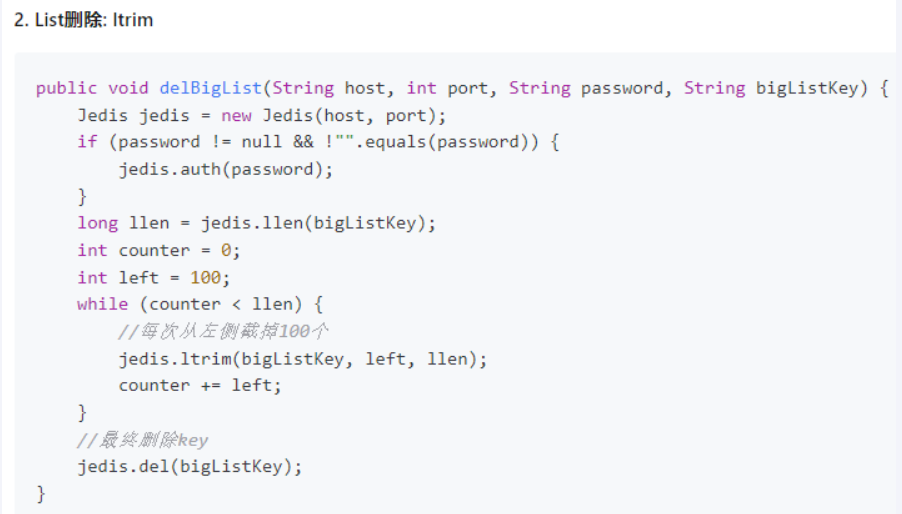
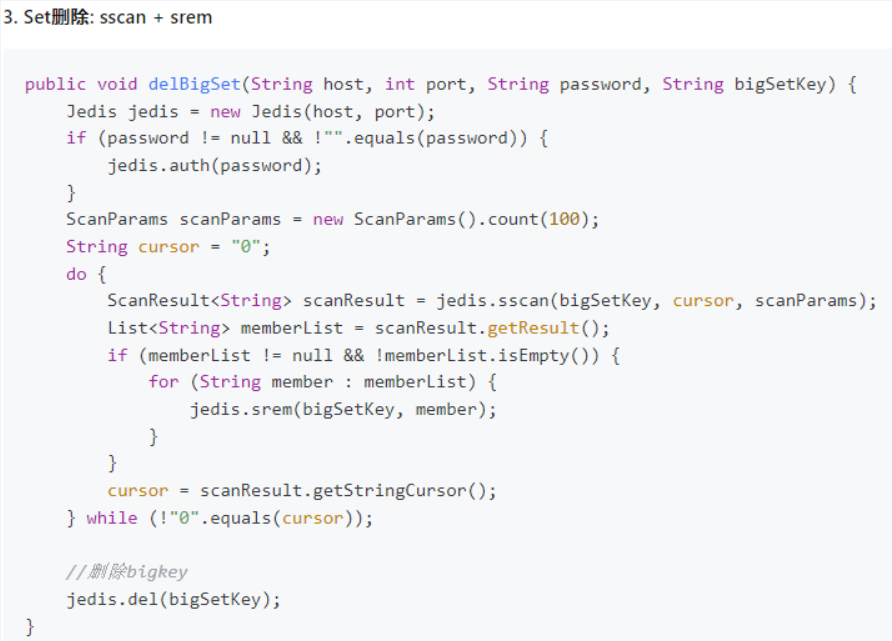
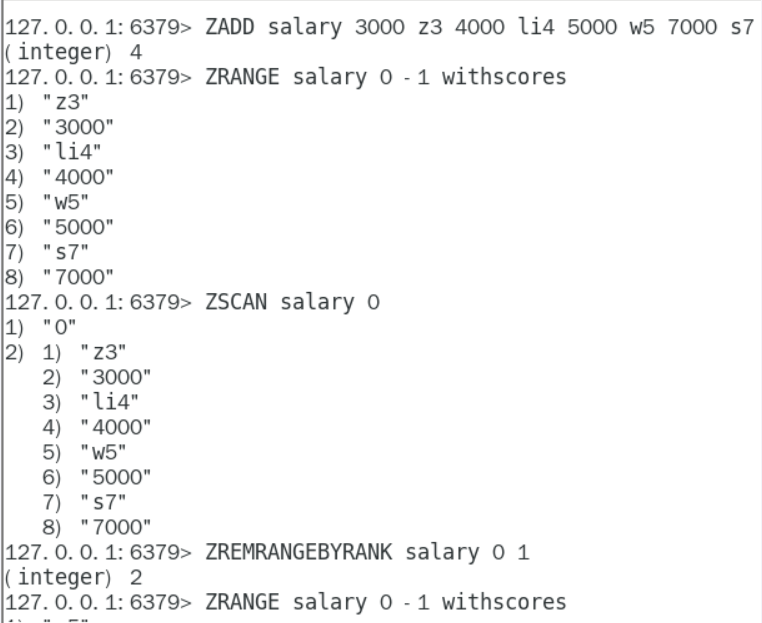
渐进式删除 , 慢慢删除部分数据,最后再进行 del
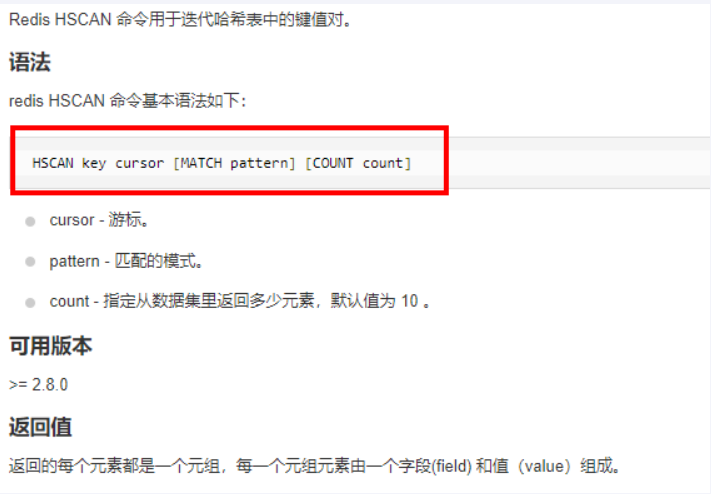
hash

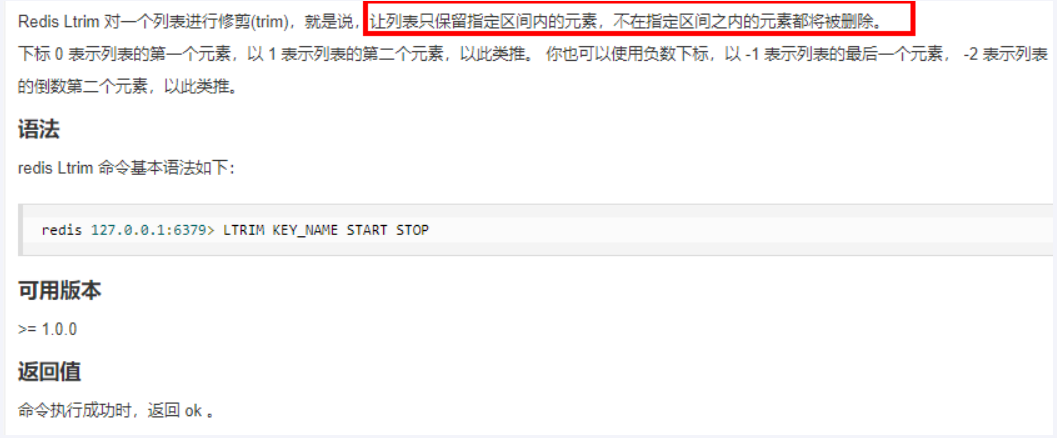
list

set

zset

设置调优
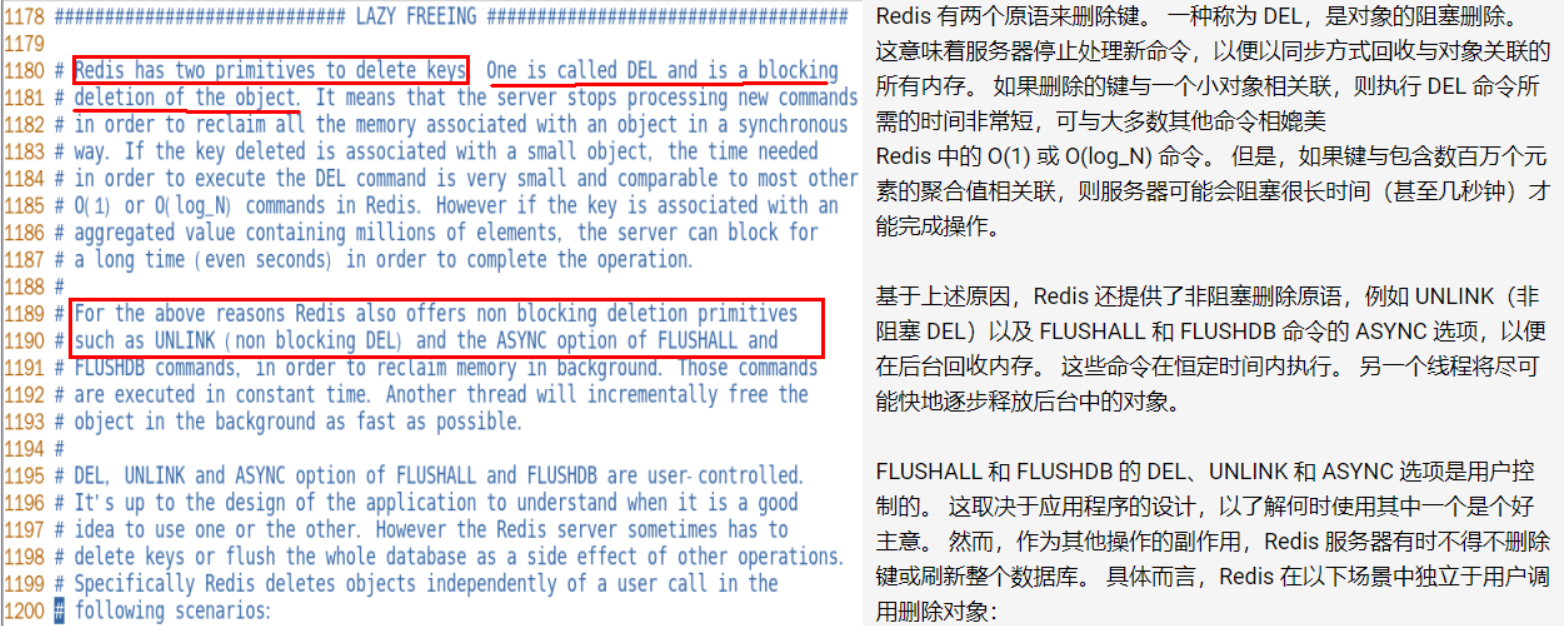
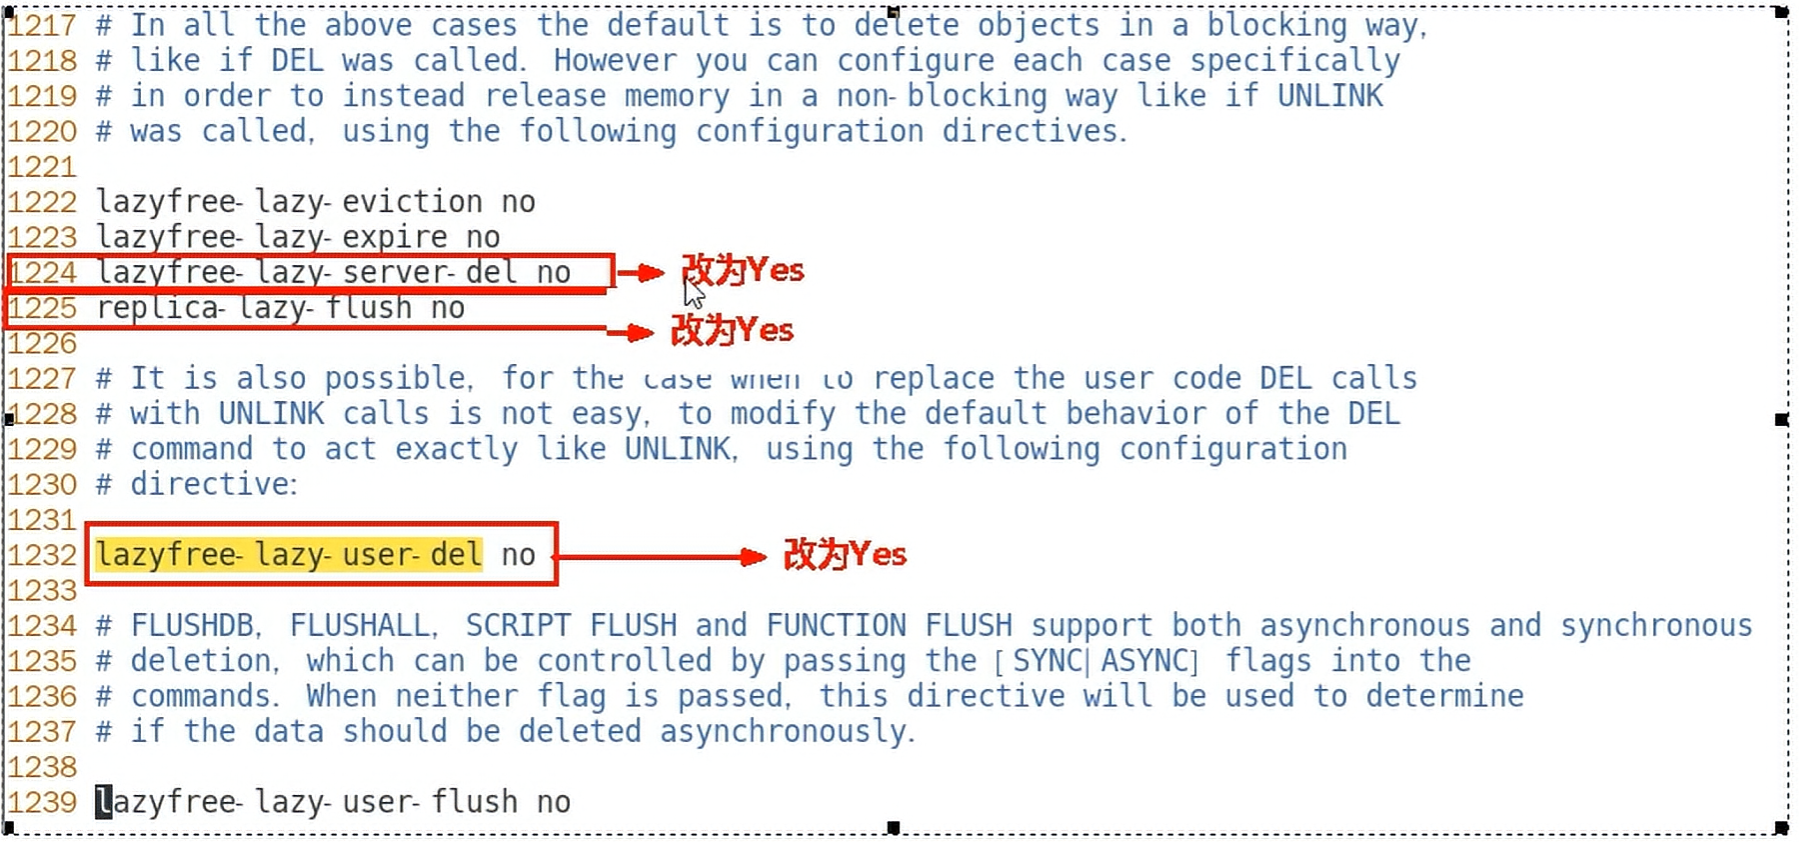
redis 有两种删除模式,阻塞和非阻塞
LAZY FREEING
缓存双写一致性
redis 充当缓存,分为两种
- 只读缓存 (数据只在
redis中存在,不存在mysql) - 读写缓存 (有写有读)
- 同步直写策略 assets/Redis高级篇/image-20240226220618130.png 即时生效业务要求,采取先更新数据库,后删除缓存
- 异步缓写策略 assets/Redis高级篇/image-20240226220544159.png 物流等,不着急从mysql更新到 redis
获取缓存策略 : 双检加锁策略
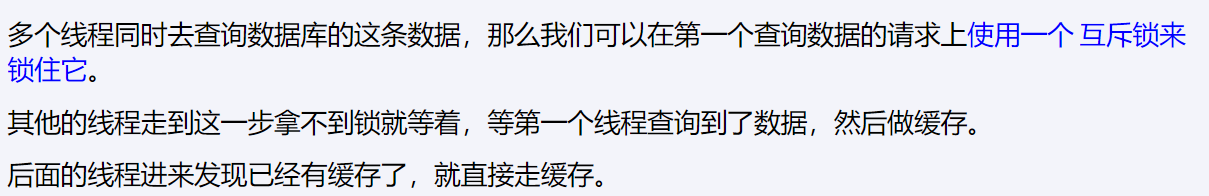
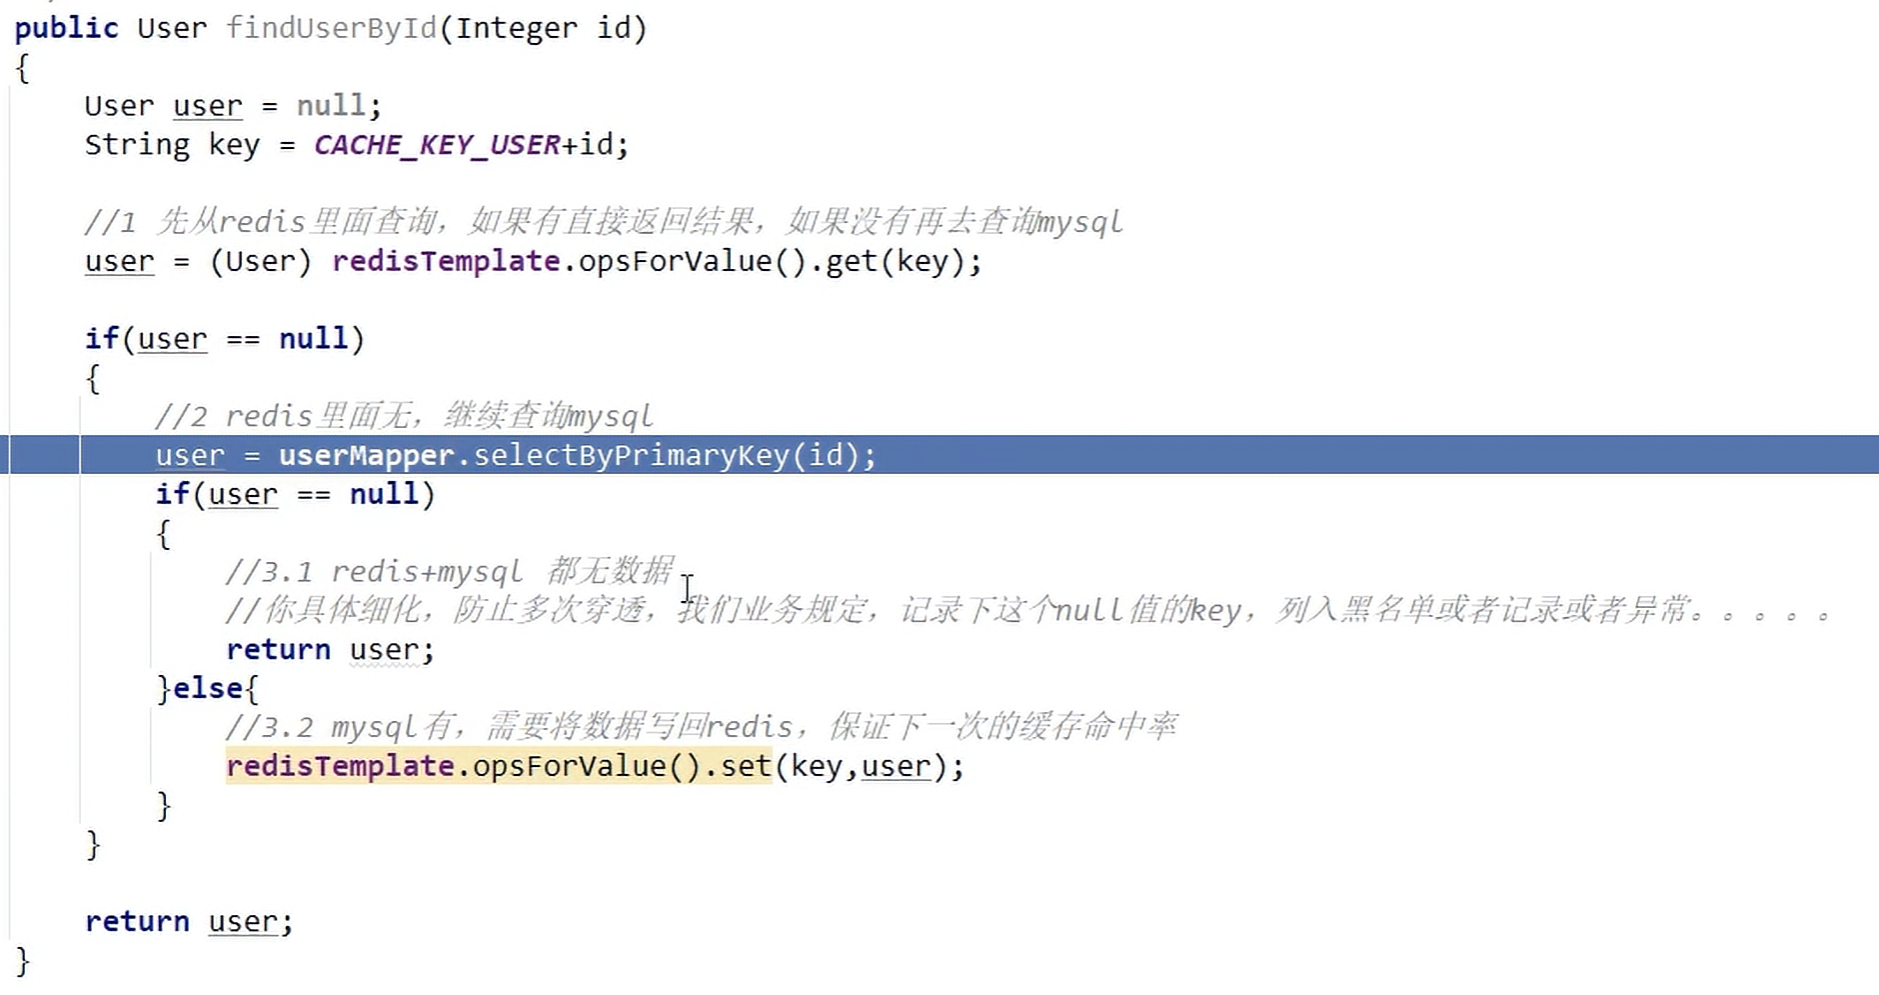
采用双检加锁机制, 只保证一个线程从 mysql 读取最新数据, 然后写入 mysql, 完成了数据的一致性, 其他线程在拿到锁再查时就有已经有了缓存
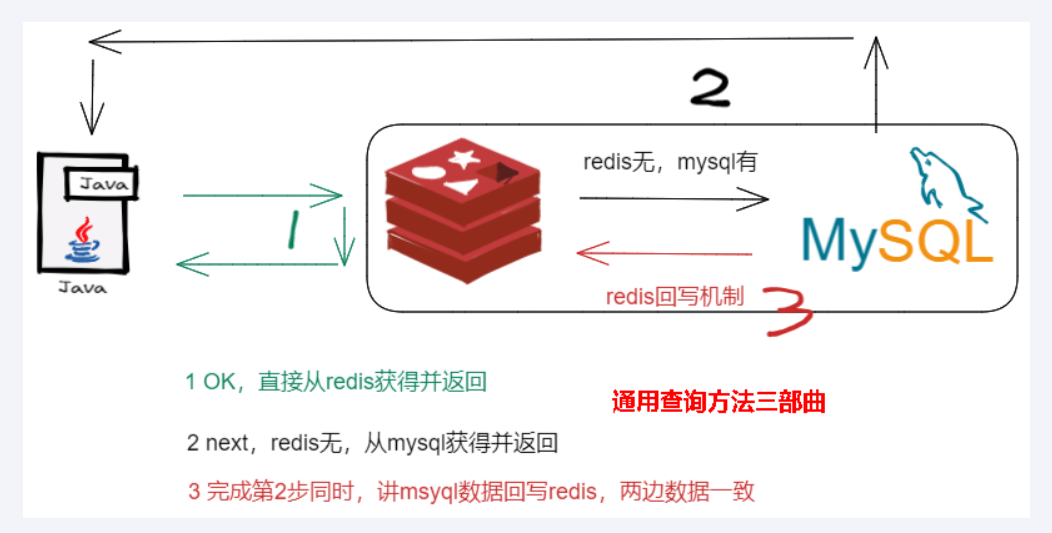
首先尝试从 redis 中获取,没有后尝试获取锁,
获取机制 : 双检加锁策略
从redis获取,redis无则从mysql取
@Service
@Slf4j
public class UserService {
    public static final String CACHE_KEY_USER = "user:";
    @Resource
    private UserMapper userMapper;
    @Resource
    private RedisTemplate redisTemplate;

    /**
     * 业务逻辑没有写错,对于小厂中厂(QPS《=1000)可以使用,但是大厂不行
     * @param id
     * @return
     */
    public User findUserById(Integer id)
    {
        User user = null;
        String key = CACHE_KEY_USER+id;

        //1 先从redis里面查询,如果有直接返回结果,如果没有再去查询mysql
        user = (User) redisTemplate.opsForValue().get(key);

        if(user == null)
        {
            //2 redis里面无,继续查询mysql
            user = userMapper.selectByPrimaryKey(id);
            if(user == null)
            {
                //3.1 redis+mysql 都无数据
                //你具体细化,防止多次穿透,我们业务规定,记录下导致穿透的这个key回写redis
                return user;
            }else{
                //3.2 mysql有,需要将数据写回redis,保证下一次的缓存命中率
                redisTemplate.opsForValue().set(key,user);
            }
        }
        return user;
    }


    /**
     * 加强补充,避免突然key失效了,打爆mysql,做一下预防,尽量不出现击穿的情况。
     * @param id
     * @return
     */
    public User findUserById2(Integer id)
    {
        User user = null;
        String key = CACHE_KEY_USER+id;

        //1 先从redis里面查询,如果有直接返回结果,如果没有再去查询mysql,
        // 第1次查询redis,加锁前
        user = (User) redisTemplate.opsForValue().get(key);
        if(user == null) {
            //2 大厂用,对于高QPS的优化,进来就先加锁,保证一个请求操作,让外面的redis等待一下,避免击穿mysql
            synchronized (UserService.class){
                //第2次查询redis,加锁后
                user = (User) redisTemplate.opsForValue().get(key);
                //3 二次查redis还是null,可以去查mysql了(mysql默认有数据)
                if (user == null) {
                    //4 查询mysql拿数据(mysql默认有数据)
                    user = userMapper.selectByPrimaryKey(id);
                    if (user == null) {
                        return null;
                    }else{
                        //5 mysql里面有数据的,需要回写redis,完成数据一致性的同步工作
                        redisTemplate.opsForValue().setIfAbsent(key,user,7L,TimeUnit.DAYS);
                    }
                }
            }
        }
        return user;
    }
}
更新策略
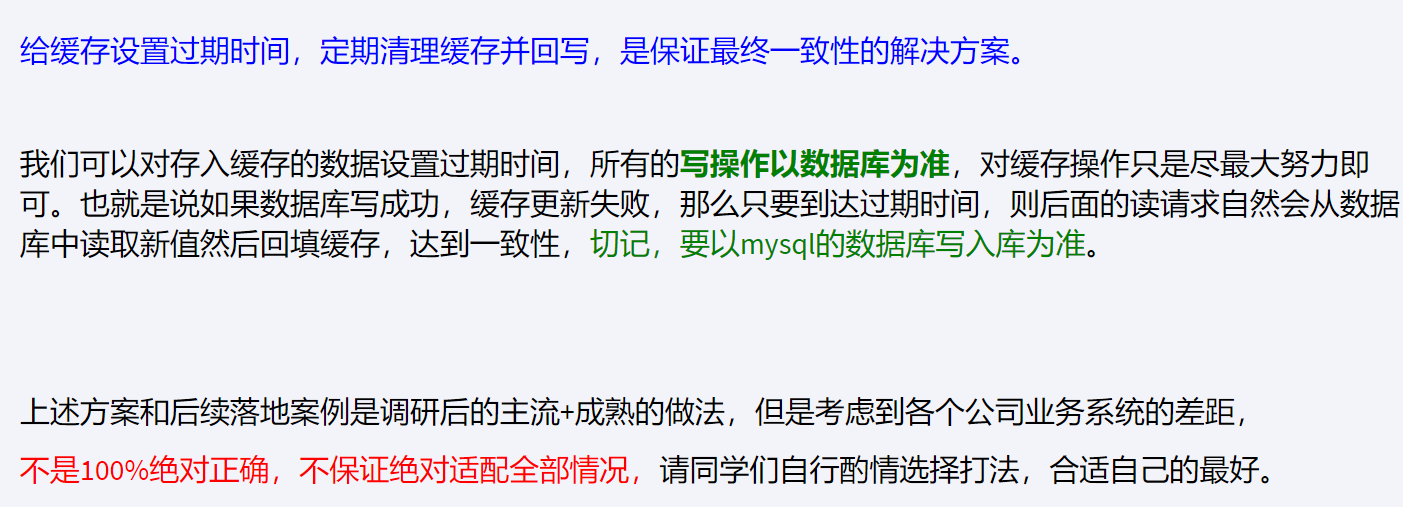
给缓存设置过期时间,定期清理缓存并回写,是保证最终一致性的解决方案
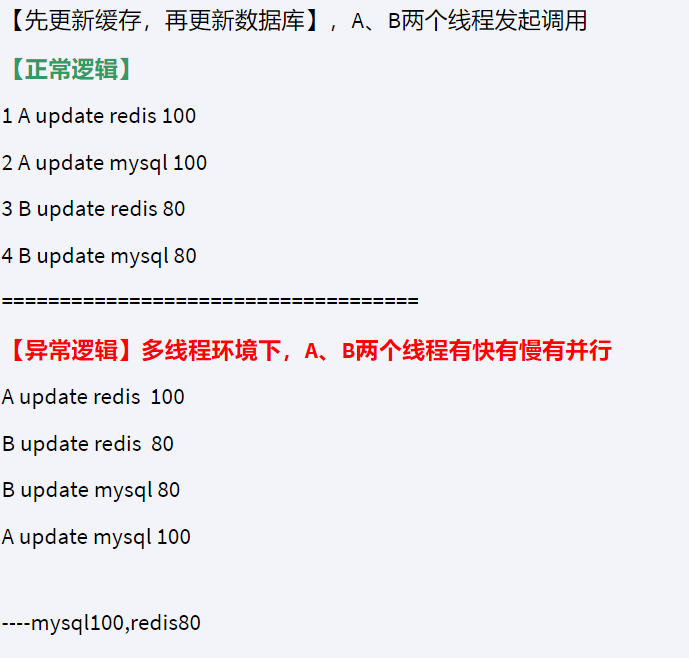
先更新缓存,再更新数据库
不推荐,业务上把mysql作为底单数据,保证最后解释
同样多线程
先删除缓存,再更新数据库(延迟双删)
先删除了reids数据,让然后mysql进行了更新,mysql没更新完的时候就访问了数据,访问获取了旧值,还会把旧值写回了redis,之前就白删了,就导致新更新的数据没有同步到redis,redis中数据一直是脏的,采用延时双删来解决,也就是在mysql更新后再删除一次redis,延迟删除时间需要估算
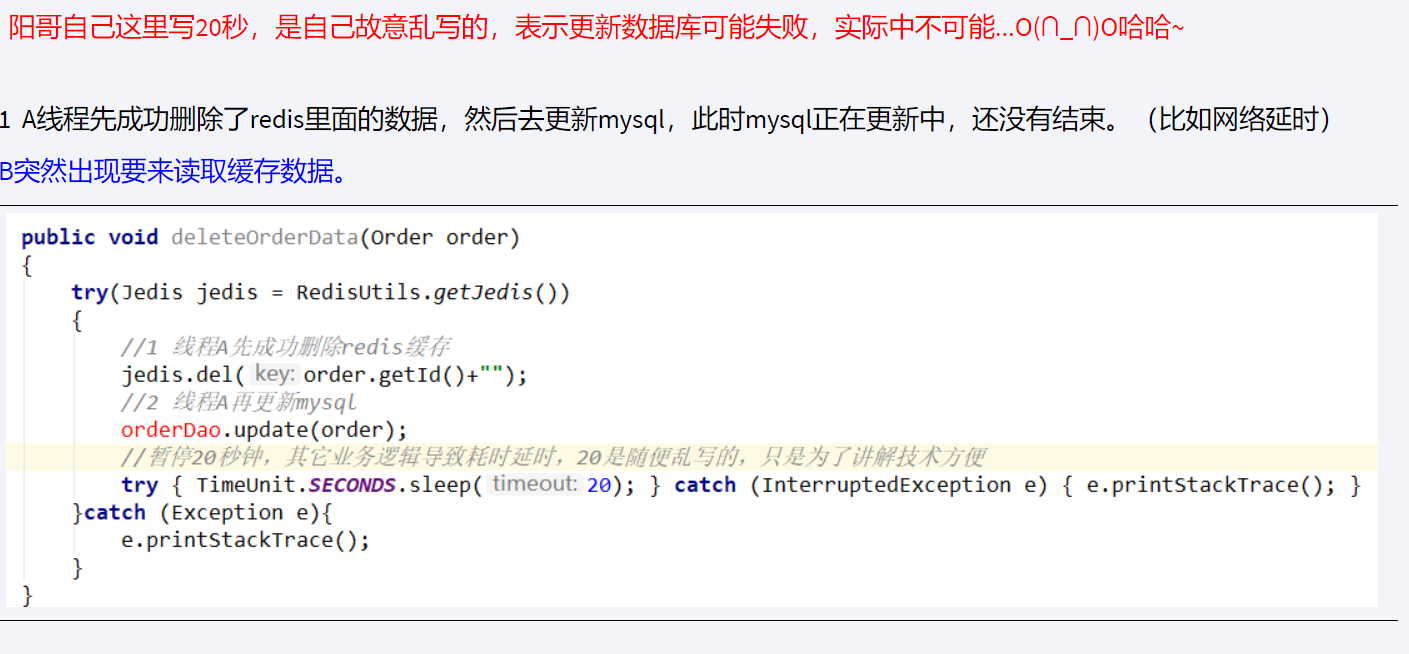
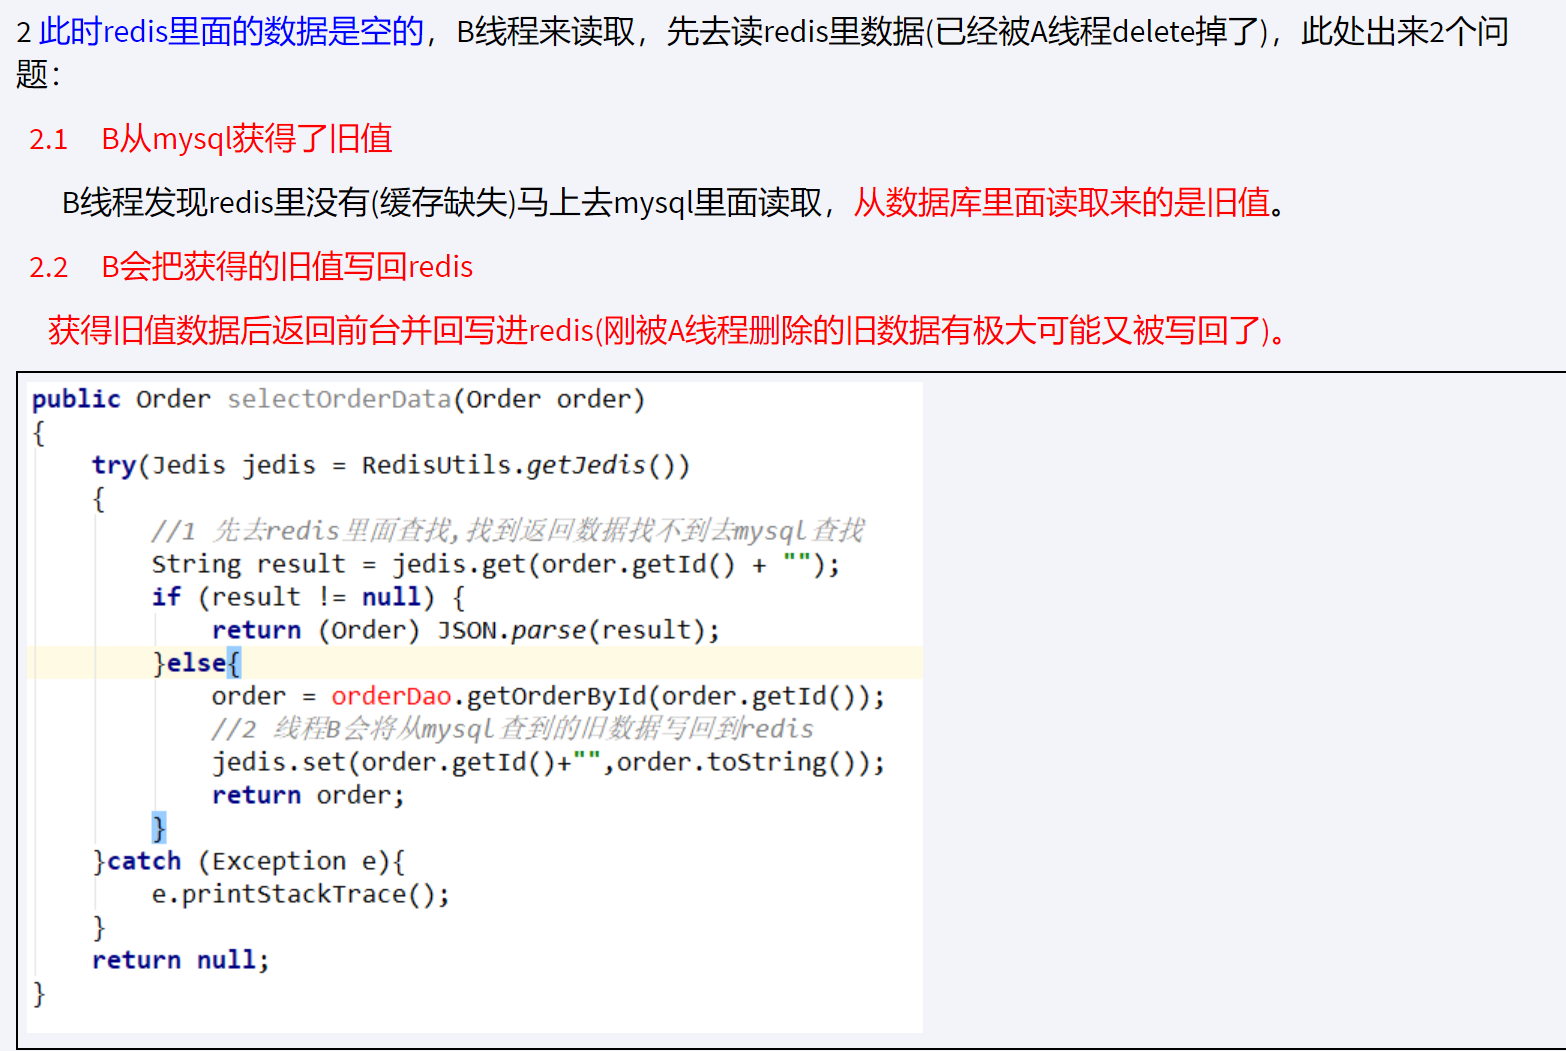
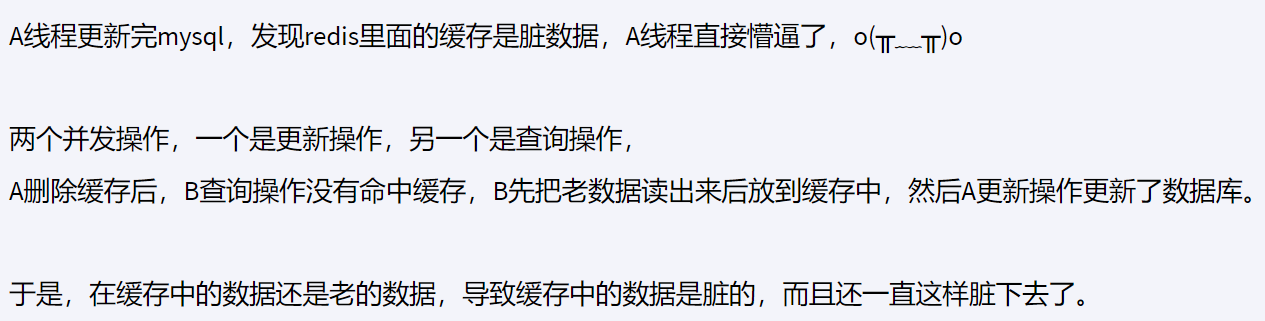
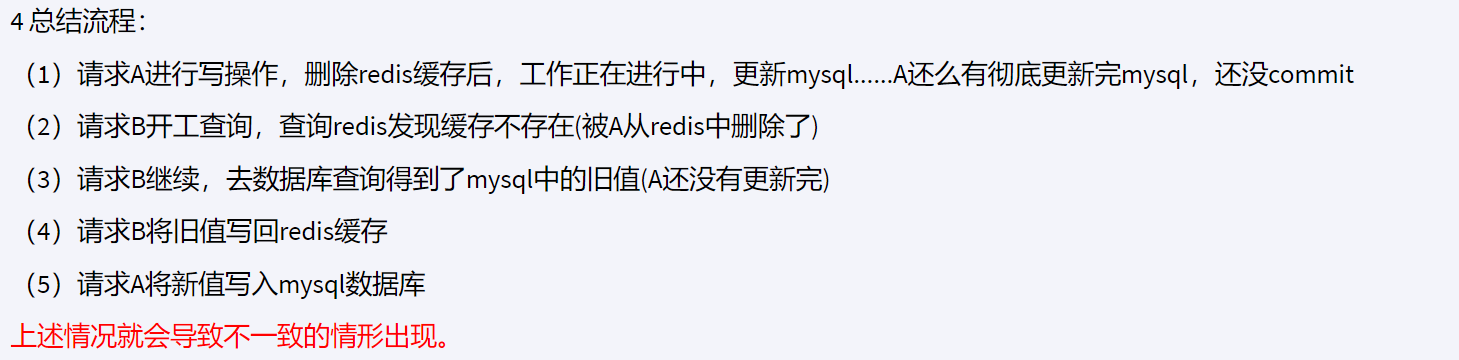
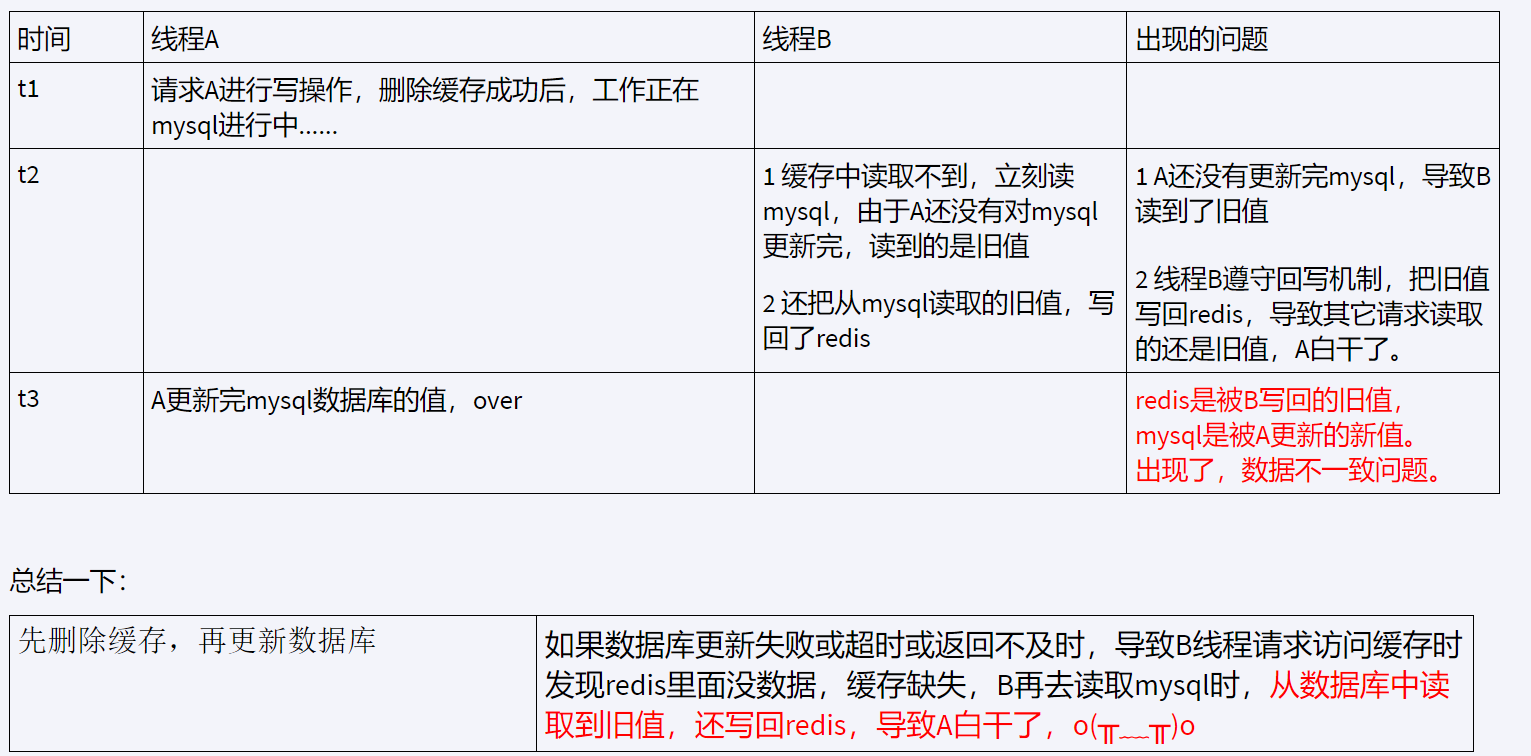
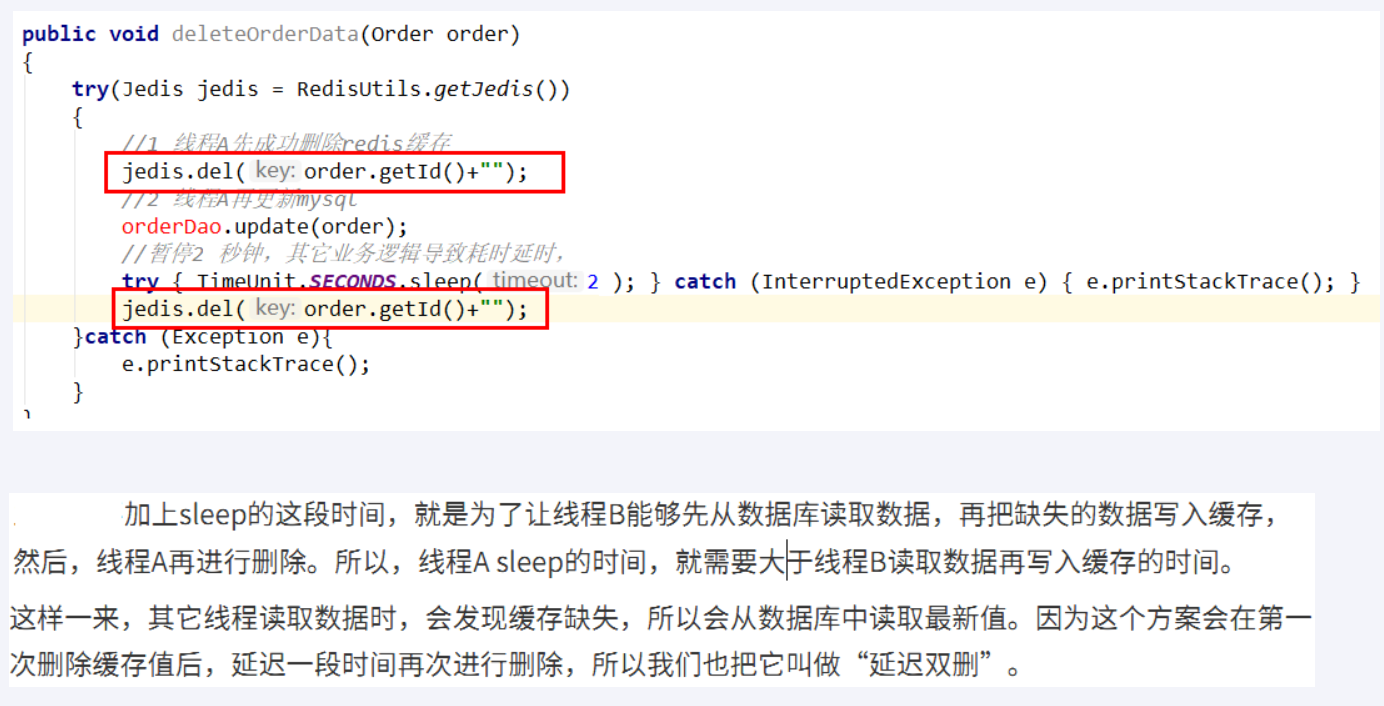
解决方案 : 延时双删策略
更新mysql前后两次进行删除,负责删除的A线程sleep时间要大于B线程写入redis缓存的时间,防止别的线程读取到旧数据写入reids后没有被删除(第二次删除:将删除变成异步的避免吞吐量降低)
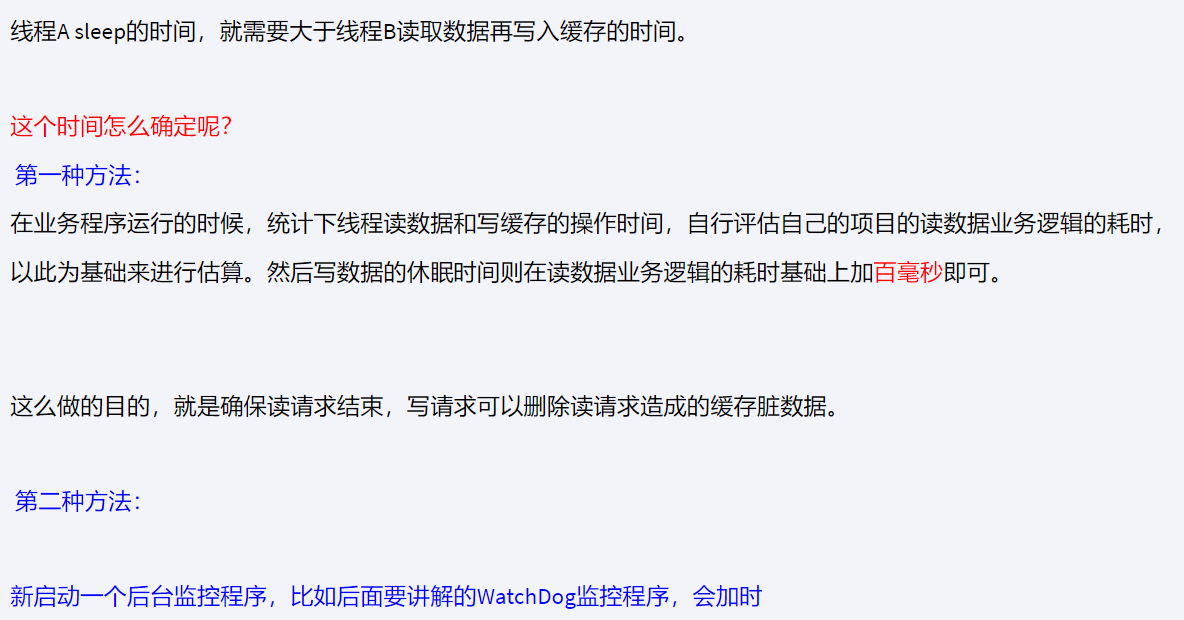
- 删除该休眠多久
- 同步淘汰策略,吞吐量降低怎么办法
将删除变成异步的避免吞吐量降低
前面的方案都不完美,就算解决还要引入新的比如延时双删
先更新数据库,再更新缓存
- 异常情况: 多线程下,顺序错乱
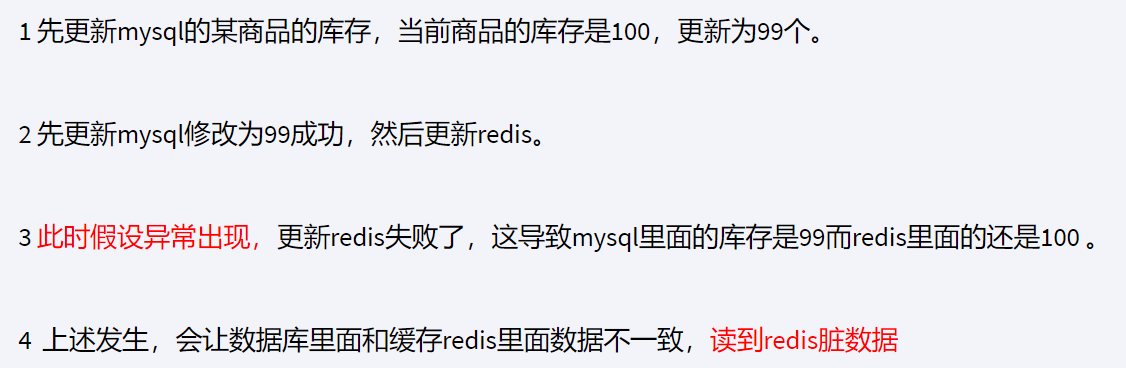
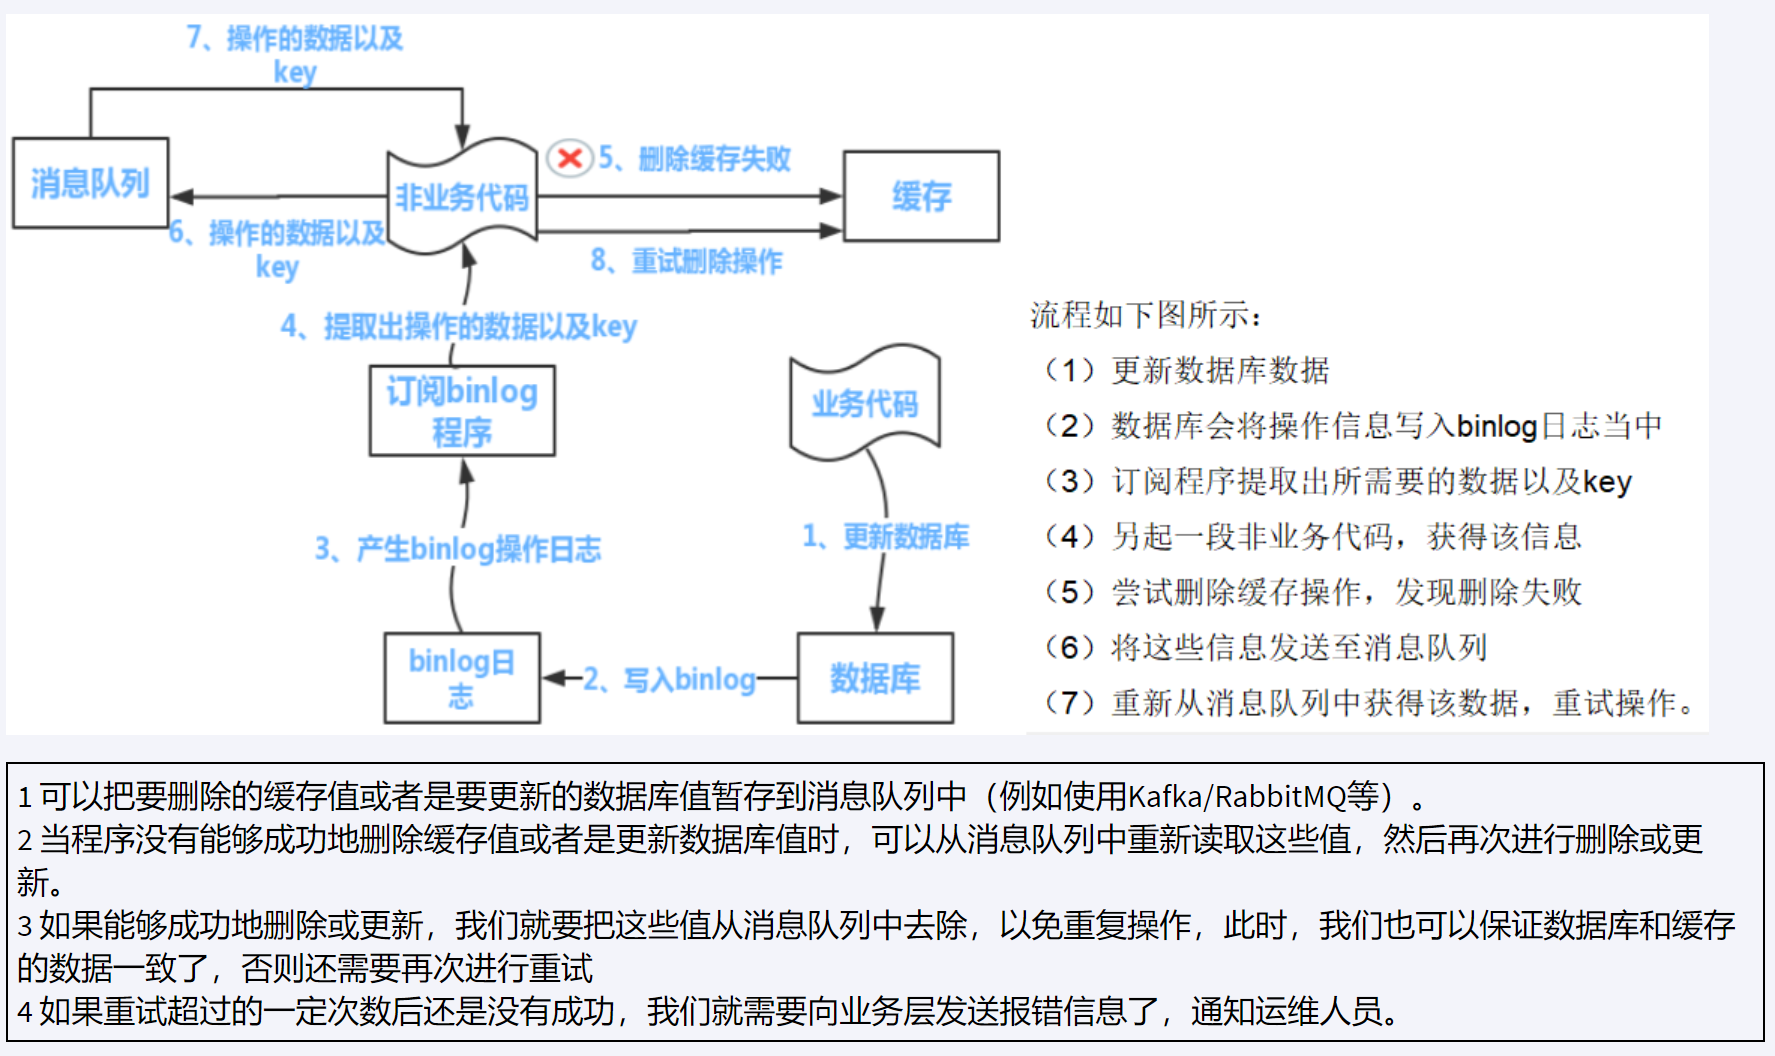
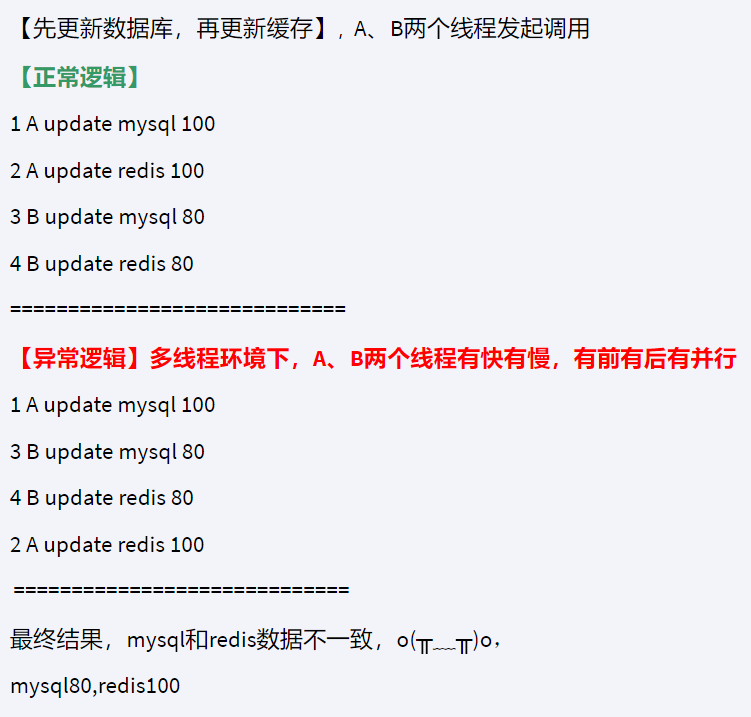 1.异常情况:redis更新失败,redis读到脏数据
先更新数据库,再删除缓存(推荐)
问题还是读到旧值,但mysql更新完后旧值就会被替换,下次的请求就会得到最新的值,不会引发其他新的问题
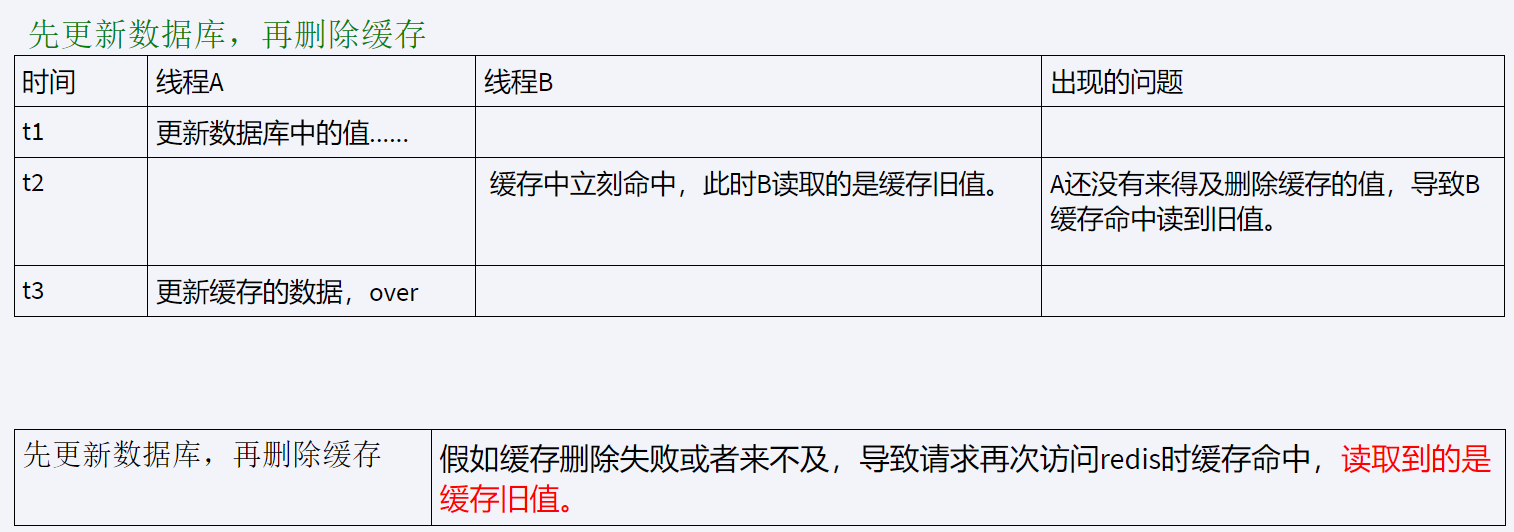
但如果删除失败就有问题了
面试
面试
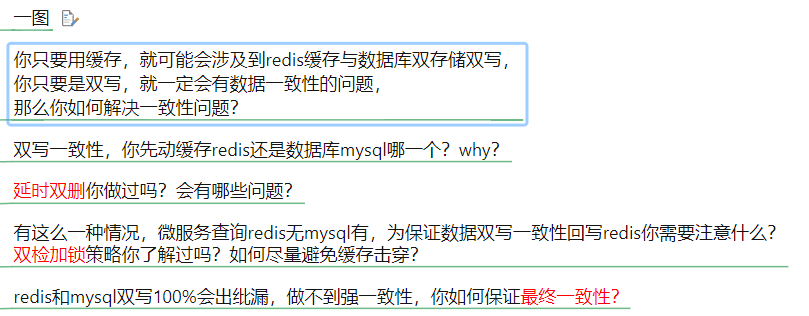

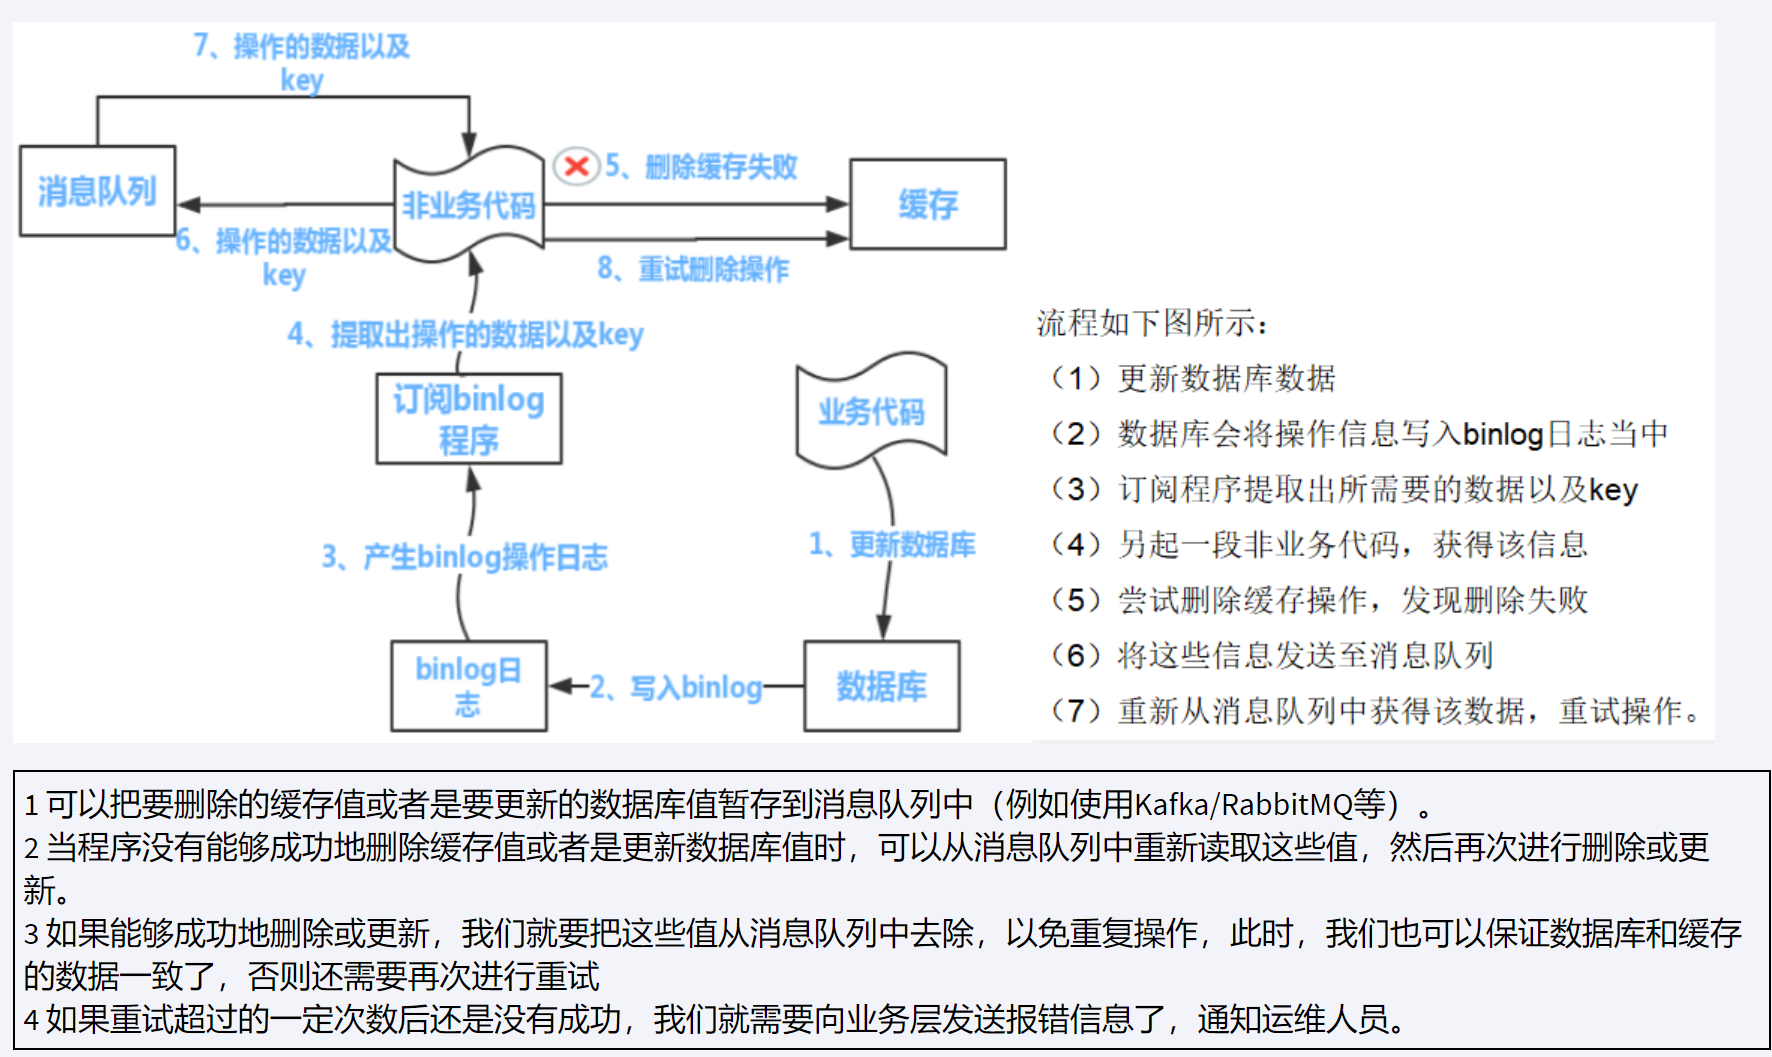
事实一致性很难做到 , 一般都是最终一致性
总结
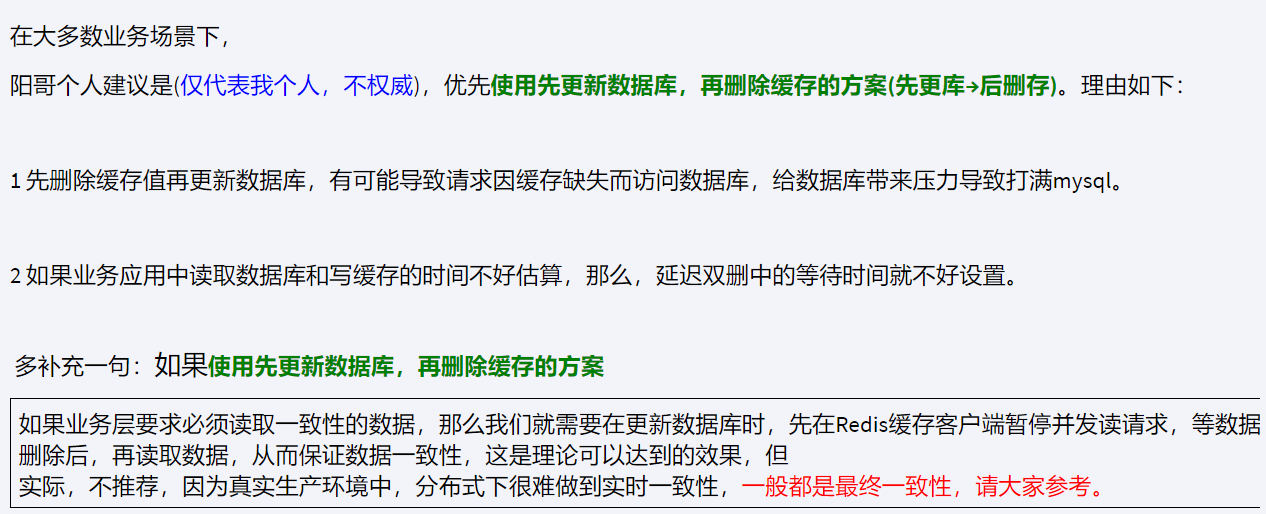
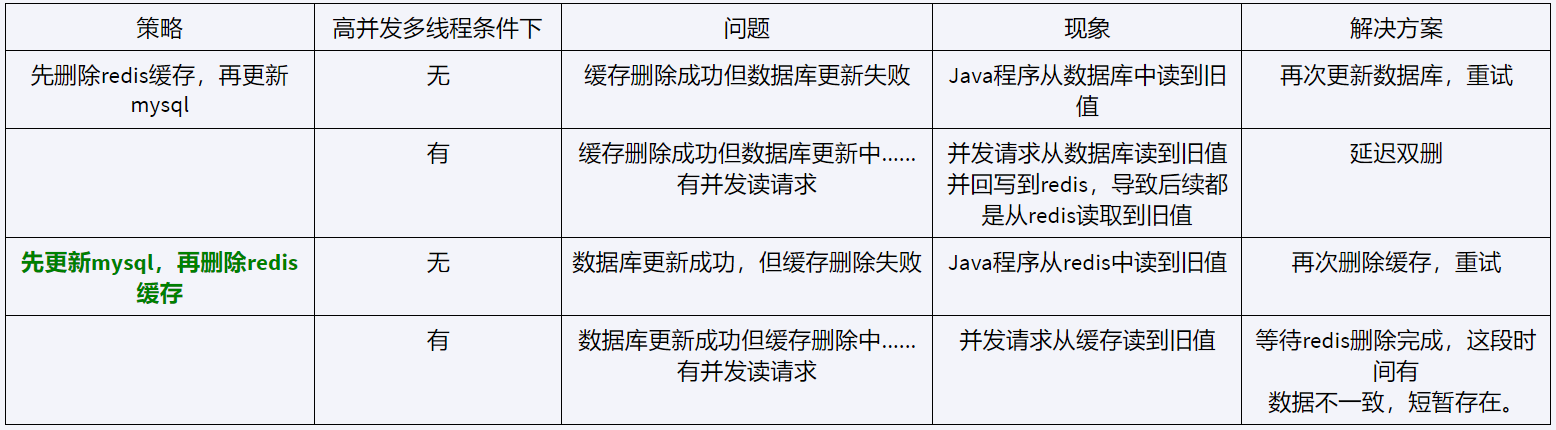
Redis 与 MySQL 数据双写一致性工程落地案例
cannel
alibaba/canal: 阿里巴巴 MySQL binlog 增量订阅&消费组件 (github.com)
如何知道mysql发生了变动?并且能够通知给redis?
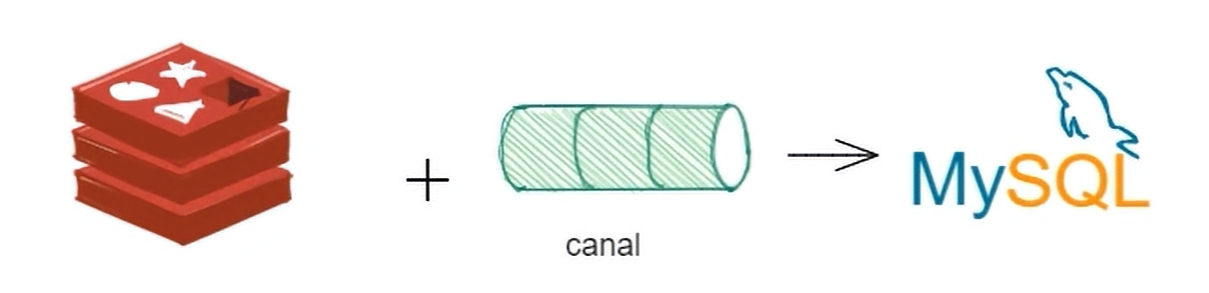
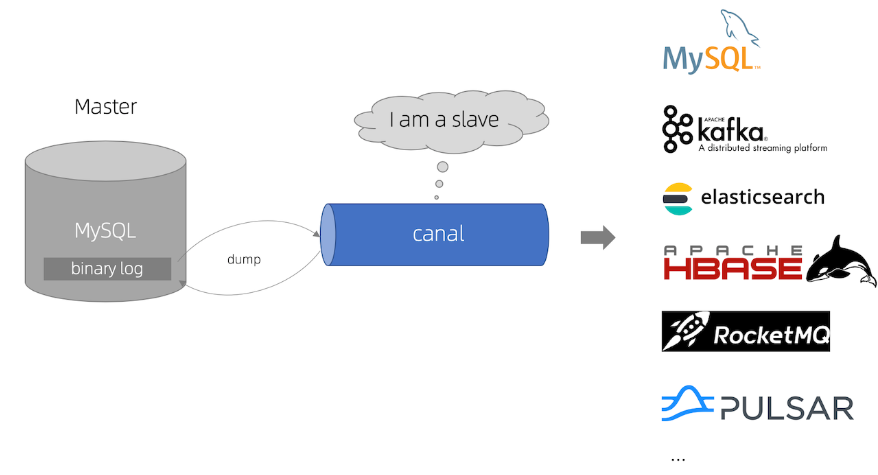
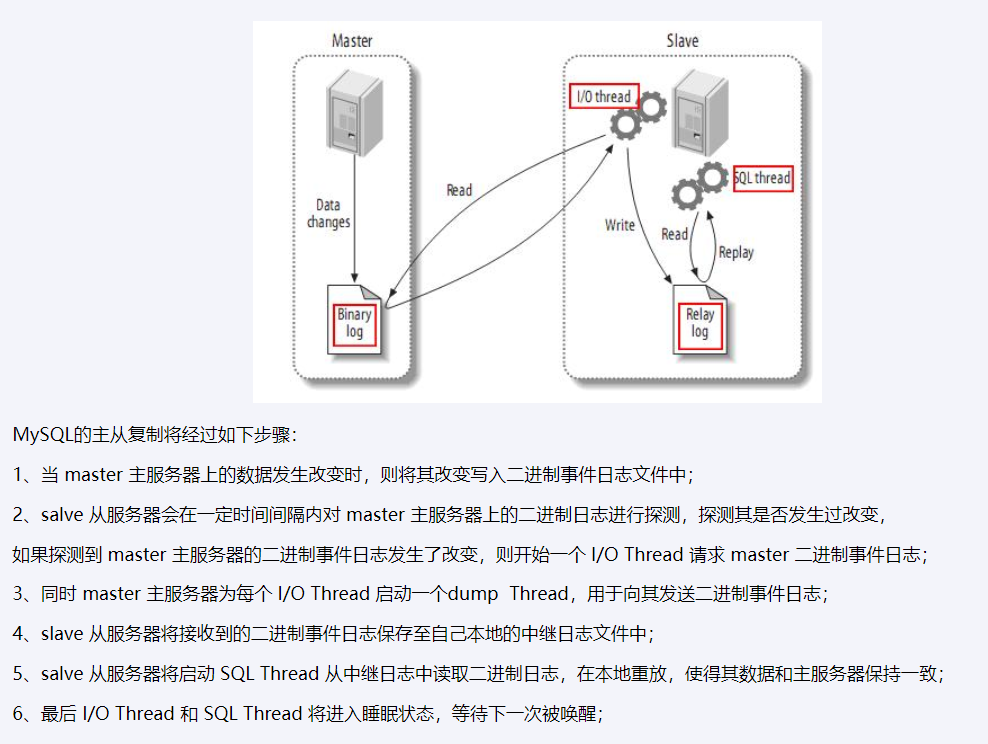
传统mysql主从复制的工作原理
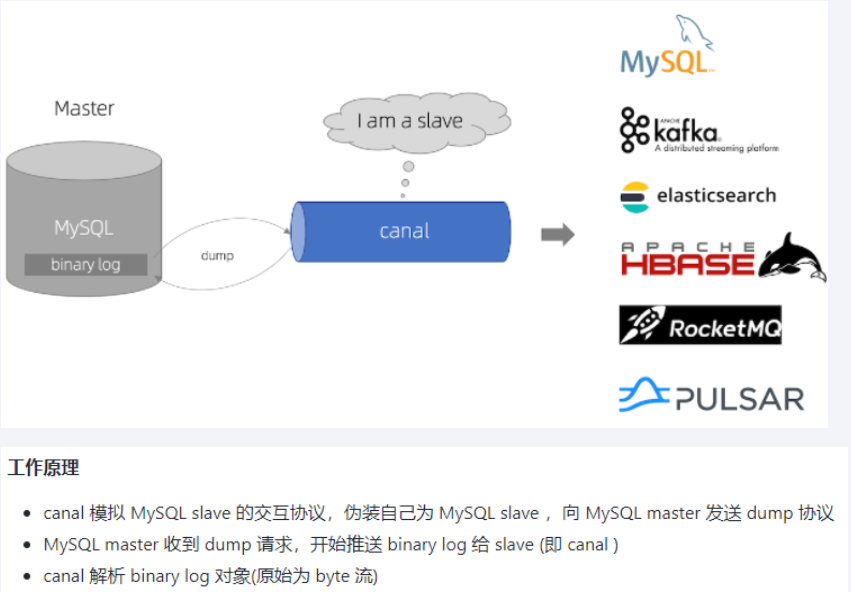
canal工作原理
使用canal前mysql修改
- mysql配置修改
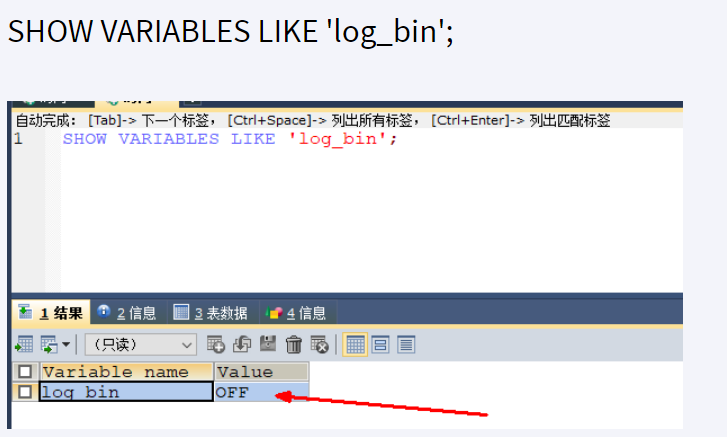
开启mysql的binlog写入功能
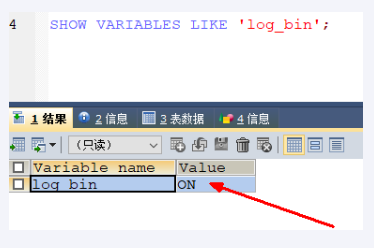
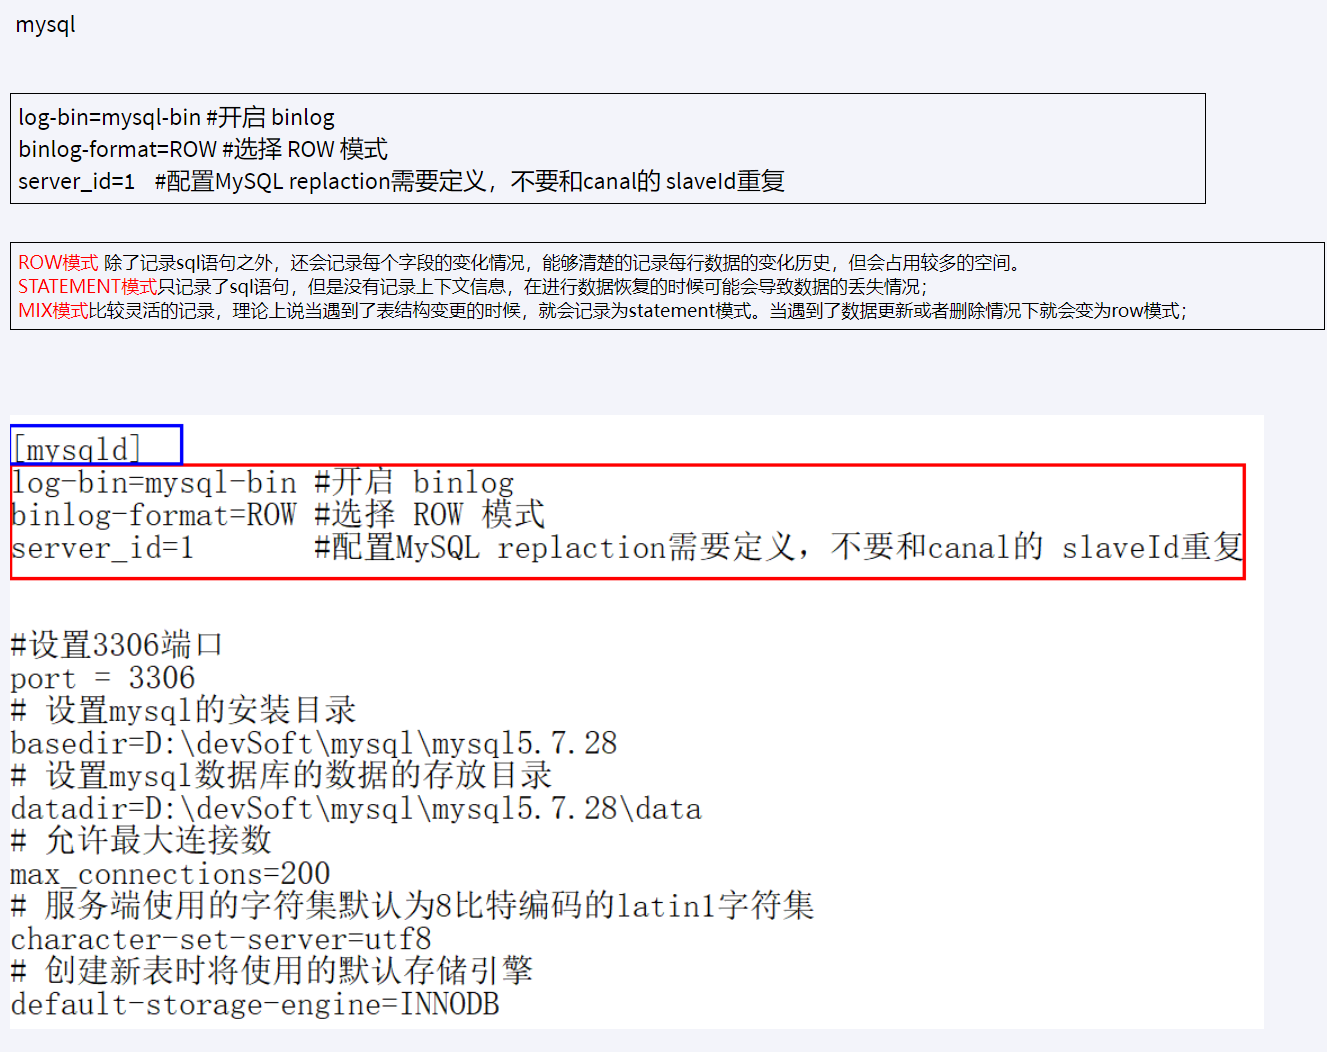 之后会变成ON
新建canal账户并授权 select * from mysql.user
DROP USER IF EXISTS 'canal'@'%'; CREATE USER 'canal'@'%' IDENTIFIED BY 'canal'; GRANT ALL PRIVILEGES ON . TO 'canal'@'%' IDENTIFIED BY 'canal'; FLUSH PRIVILEGES; SELECT * FROM mysql.user;
安装配置canal
- 下载depolyer版本然后解压到
/mycanal路径下
- 配置

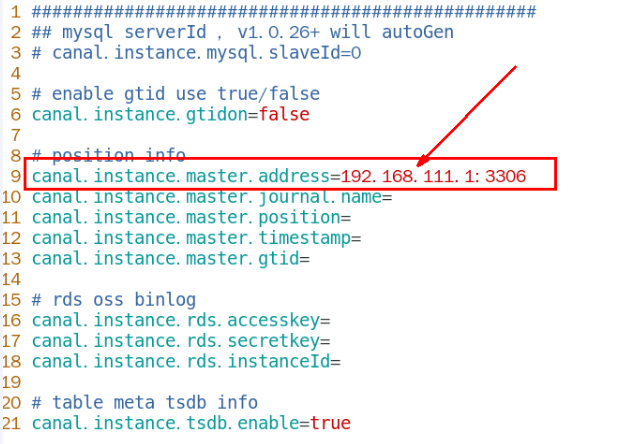
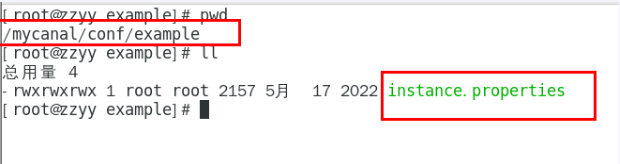 将master填写自己的mysql地址
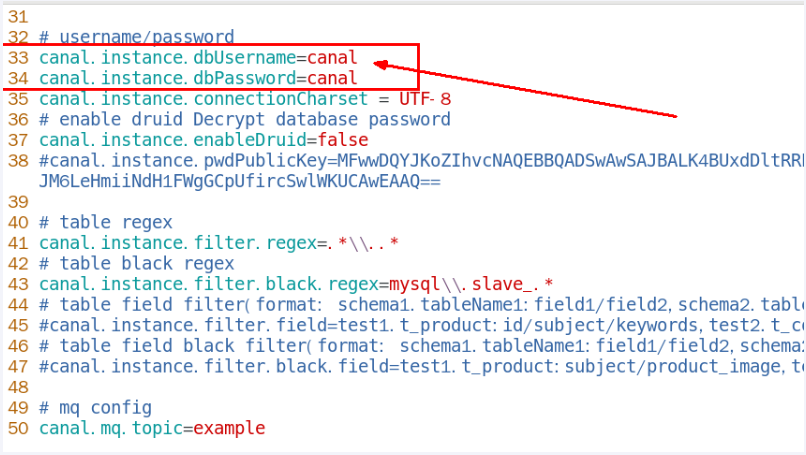
 将账户换成之前自己新建的
启动
/opt/mycanal/bin路径下执行 ./startup.sh
日志
mycanal/logs/canal 中cat canal.log
canal在java业务中的编写
pom
<dependency>
    <groupId>com.alibaba.otter</groupId>
    <artifactId>canal.client</artifactId>
    <version>1.1.0</version>
</dependency>


<dependency>
		<groupId>redis.clients</groupId>
		<artifactId>jedis</artifactId>
		<version>3.8.0</version>
</dependency>
RedisUtils
public class RedisUtils
{
    public static final String  REDIS_IP_ADDR = "192.168.111.185";
    public static final String  REDIS_pwd = "111111";
    public static JedisPool jedisPool;

    static {
        JedisPoolConfig jedisPoolConfig=new JedisPoolConfig();
        jedisPoolConfig.setMaxTotal(20);
        jedisPoolConfig.setMaxIdle(10);
        jedisPool=new JedisPool(jedisPoolConfig,REDIS_IP_ADDR,6379,10000,REDIS_pwd);
    }

    public static Jedis getJedis() throws Exception {
        if(null!=jedisPool){
            return jedisPool.getResource();
        }
        throw new Exception("Jedispool is not ok");
    }

}
canal配置RedisCanalClientExample
public class RedisCanalClientExample
{
public static final Integer _60SECONDS = 60;
public static final String REDIS_IP_ADDR = "192.168.111.185";
private static void redisInsert(List<Column> columns)
{
JSONObject jsonObject = new JSONObject();
for (Column column : columns)
{
System.out.println(column.getName() + " : " + column.getValue() + " update=" + column.getUpdated());
jsonObject.put(column.getName(),column.getValue());
}
if(columns.size() > 0)
{
try(Jedis jedis = RedisUtils.getJedis())
{
jedis.set(columns.get(0).getValue(),jsonObject.toJSONString());
}catch (Exception e){
e.printStackTrace();
}
}
}
private static void redisDelete(List<Column> columns)
{
JSONObject jsonObject = new JSONObject();
for (Column column : columns)
{
jsonObject.put(column.getName(),column.getValue());
}
if(columns.size() > 0)
{
try(Jedis jedis = RedisUtils.getJedis())
{
jedis.del(columns.get(0).getValue());
}catch (Exception e){
e.printStackTrace();
}
}
}
private static void redisUpdate(List<Column> columns)
{
JSONObject jsonObject = new JSONObject();
for (Column column : columns)
{
System.out.println(column.getName() + " : " + column.getValue() + " update=" + column.getUpdated());
jsonObject.put(column.getName(),column.getValue());
}
if(columns.size() > 0)
{
try(Jedis jedis = RedisUtils.getJedis())
{
jedis.set(columns.get(0).getValue(),jsonObject.toJSONString());
System.out.println("---------update after: "+jedis.get(columns.get(0).getValue()));
}catch (Exception e){
e.printStackTrace();
}
}
}
public static void printEntry(List<Entry> entrys) {
for (Entry entry : entrys) {
if (entry.getEntryType() == EntryType.TRANSACTIONBEGIN || entry.getEntryType() == EntryType.TRANSACTIONEND) {
continue;
}
RowChange rowChage = null;
try {
//获取变更的row数据
rowChage = RowChange.parseFrom(entry.getStoreValue());
} catch (Exception e) {
throw new RuntimeException("ERROR ## parser of eromanga-event has an error,data:" + entry.toString(),e);
}
//获取变动类型
EventType eventType = rowChage.getEventType();
System.out.println(String.format("================> binlog[%s:%s] , name[%s,%s] , eventType : %s",
entry.getHeader().getLogfileName(), entry.getHeader().getLogfileOffset(),
entry.getHeader().getSchemaName(), entry.getHeader().getTableName(), eventType));
for (RowData rowData : rowChage.getRowDatasList()) {
if (eventType == EventType.INSERT) {
redisInsert(rowData.getAfterColumnsList());
} else if (eventType == EventType.DELETE) {
redisDelete(rowData.getBeforeColumnsList());
} else {//EventType.UPDATE
redisUpdate(rowData.getAfterColumnsList());
}
}
}
}
public static void main(String[] args)
{
System.out.println("---------O(∩_∩)O哈哈~ initCanal() main方法-----------");
//=================================
// 创建链接canal服务端
CanalConnector connector = CanalConnectors.newSingleConnector(new InetSocketAddress(REDIS_IP_ADDR,
11111), "example", "", "");
int batchSize = 1000;
//空闲空转计数器
int emptyCount = 0;
System.out.println("---------------------canal init OK,开始监听mysql变化------");
try {
connector.connect();
//connector.subscribe(".*\\..*");
//监控越多,回写越慢,只对重要数据保证双写一致性
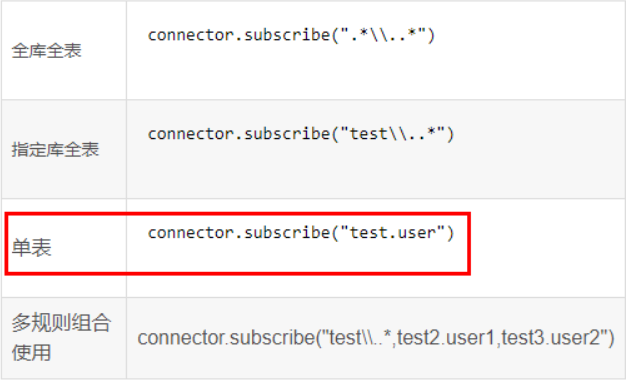
connector.subscribe("bigdata.t_user");
connector.rollback();
int totalEmptyCount = 10 * _60SECONDS;
while (emptyCount < totalEmptyCount) {
System.out.println("我是canal,每秒一次正在监听:"+ UUID.randomUUID().toString());
Message message = connector.getWithoutAck(batchSize); // 获取指定数量的数据
long batchId = message.getId();
int size = message.getEntries().size();
if (batchId == -1 || size == 0) {
emptyCount++;
try { TimeUnit.SECONDS.sleep(1); } catch (InterruptedException e) { e.printStackTrace(); }
} else {
//计数器重新置零
emptyCount = 0;
printEntry(message.getEntries());
}
connector.ack(batchId); // 提交确认
// connector.rollback(batchId); // 处理失败, 回滚数据
}
System.out.println("已经监听了"+totalEmptyCount+"秒,无任何消息,请重启重试......");
} finally {
connector.disconnect();
}
}
}
配置细则
java程序下connector.subscribe配置的过滤正则
try-with-resources无需再手动关闭
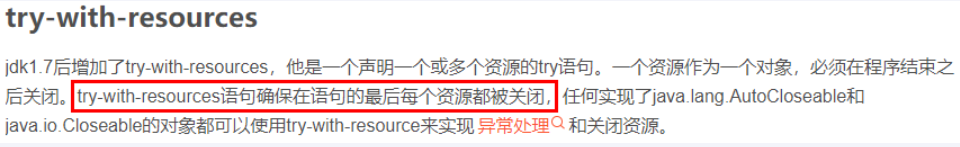
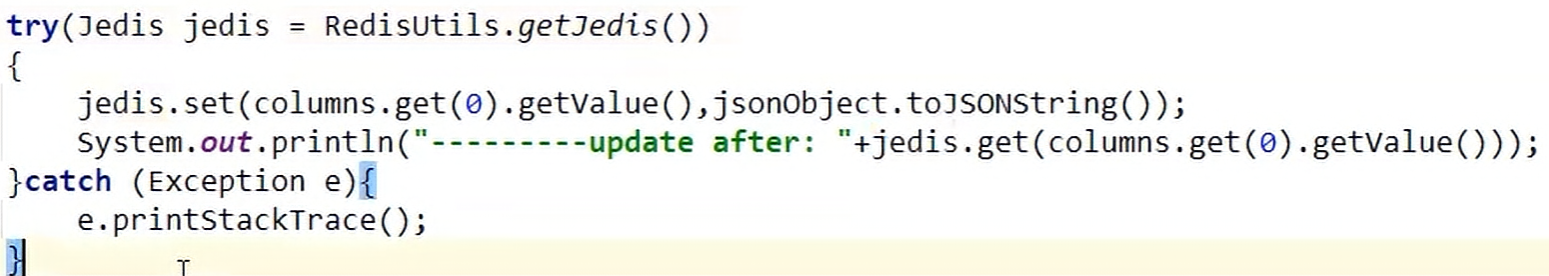
jedis会自动关闭,所以不需要手动finally
案例落地实战 bitmap/hyperloglog/GEO
hyperloglog
UV/PV/DAU/MAU : 独立访客/页面浏览量/日活跃用户/月活跃用户
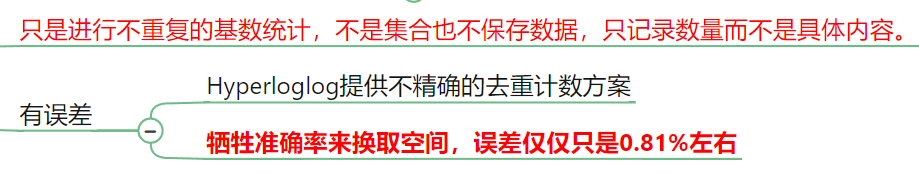
基数统计 : 统计集合中不重复的元素个数, 就是对集合去重复后剩余元素的计算,通过概率算法,并不存储数据本身,预估基数值,同时保证误差在一定范围内
百分之 0.81 误差
JAVA微服务生态/Redis7/基础/Redis入门 > redis 基数统计( HyperLogLog )
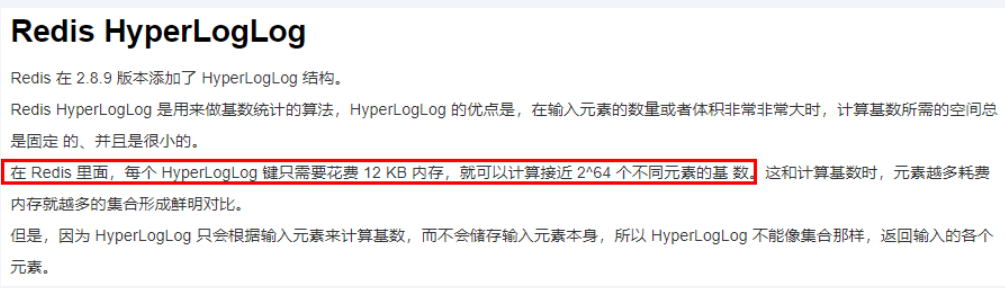
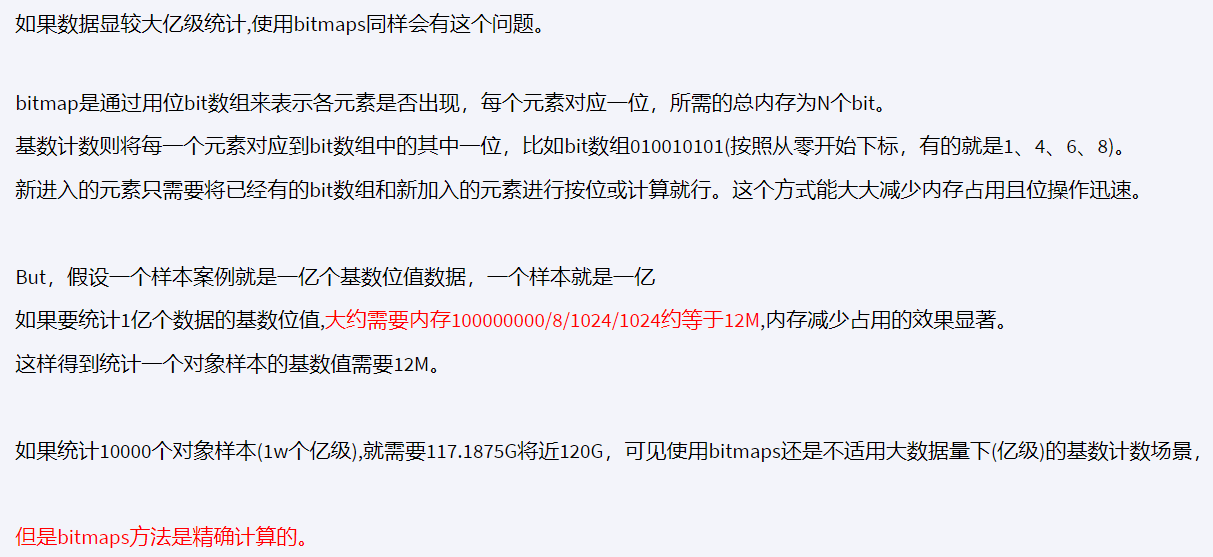
hyperloglog如何演化出来的
由于bitmap在数据量过大时占用了过多内存,因此演化出了hyperloglog,内存减少的效果显著
1.04/16384/16384 = 0.0081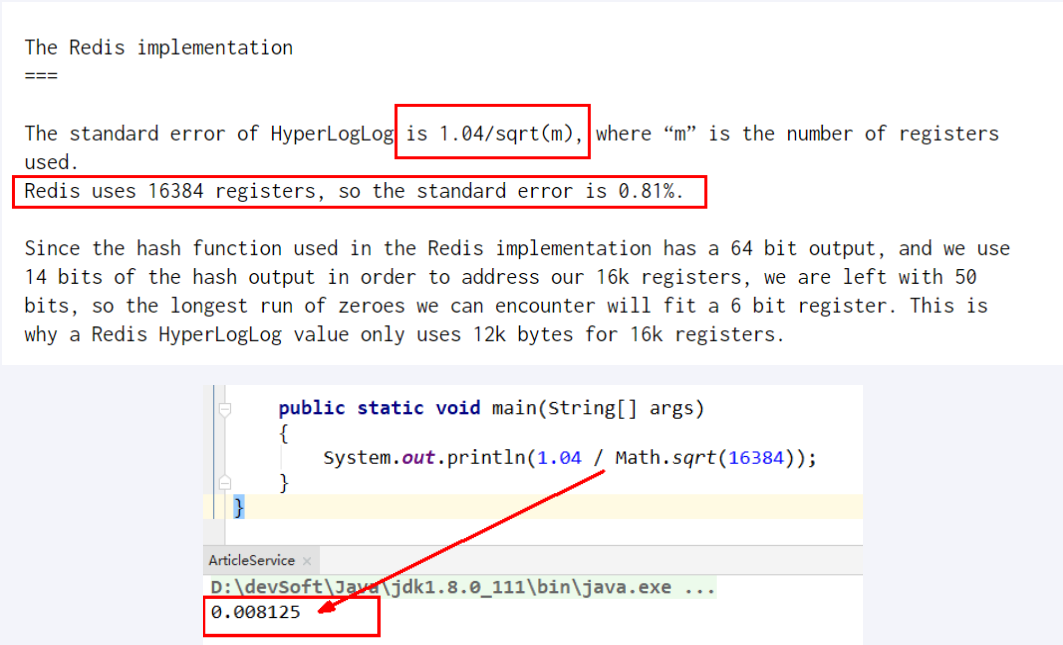
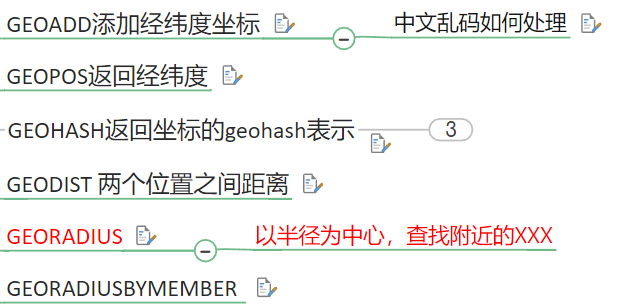
GEO
JAVA微服务生态/Redis7/基础/Redis入门 > 地理空间 GEO
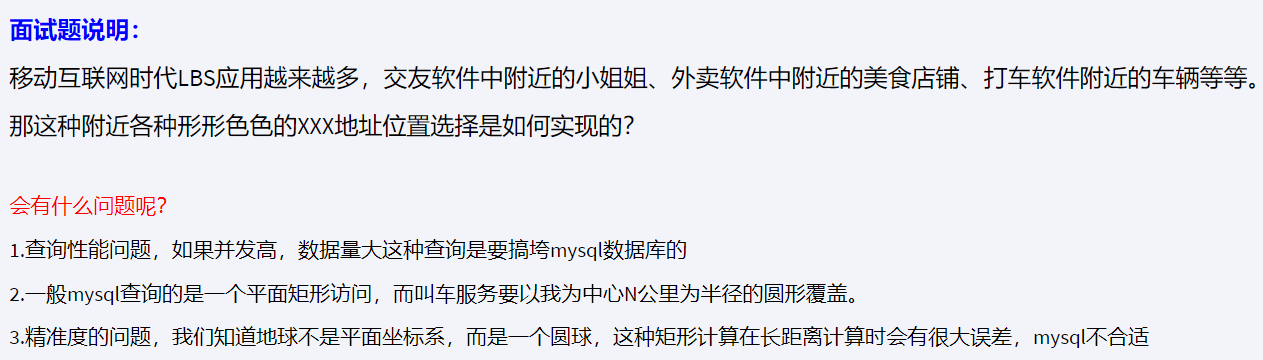
JAVA微服务生态/Redis7/基础/Redis入门 > 地理空间 GEO
RedisTemplate对GEO的相关操作
public static final String CITY ="city";

@Autowired
private RedisTemplate redisTemplate;
public String geoAdd()
{
    Map<String, Point> map = new HashMap<>();
    map.put("天安门",new Point(116.403963,39.915119));
    map.put("故宫",new Point(116.403414,39.924091));
    map.put("长城",new Point(116.024067,40.362639));

    redisTemplate.opsForGeo().add(CITY,map);

    return map.toString();
}

public Point position(String member) {
    //获取经纬度坐标
    List<Point> list = redisTemplate.opsForGeo().position(CITY, member);
    return list.get(0);
}

public String hash(String member) {
    //geohash算法生成的base32编码值
    List<String> list = redisTemplate.opsForGeo().hash(CITY, member);
    return list.get(0);
}

public Distance distance(String member1, String member2) {
    //获取两个给定位置之间的距离
    Distance distance = redisTemplate.opsForGeo().distance(CITY, member1, member2,
            RedisGeoCommands.DistanceUnit.KILOMETERS);
    return distance;
}
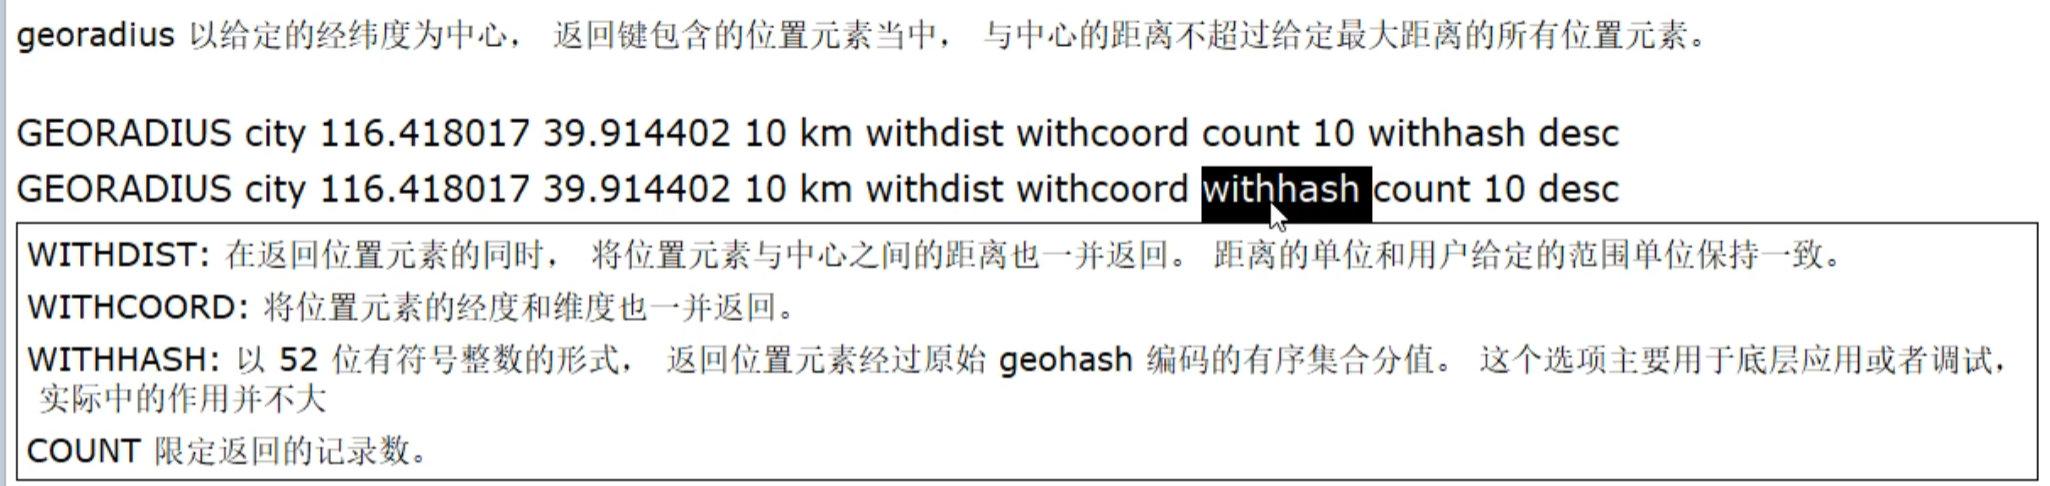
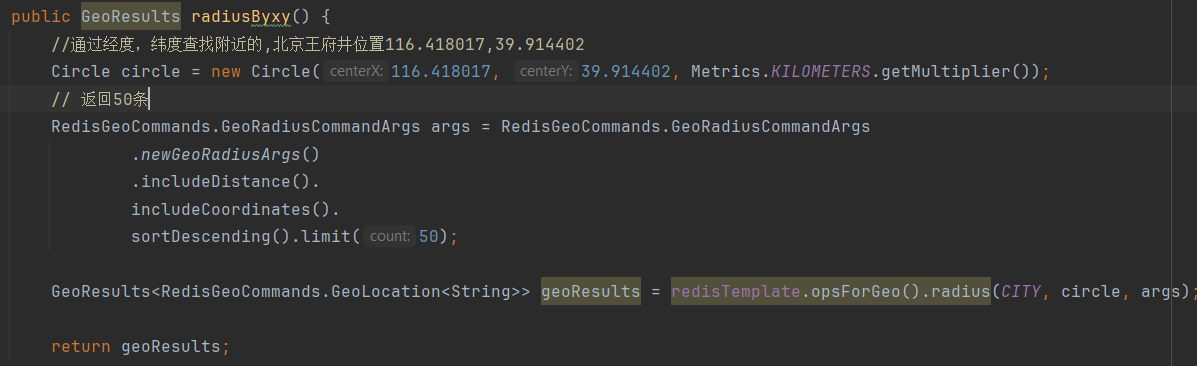
public GeoResults radiusByxy() {
    //通过经度,纬度查找附近的,北京王府井位置116.418017,39.914402
    //Metrics.KILOMETERS.getMultiplier()以千米为单位的圆的半径
    Circle circle = new Circle(116.418017, 39.914402, Metrics.KILOMETERS.getMultiplier());
    // 返回50条
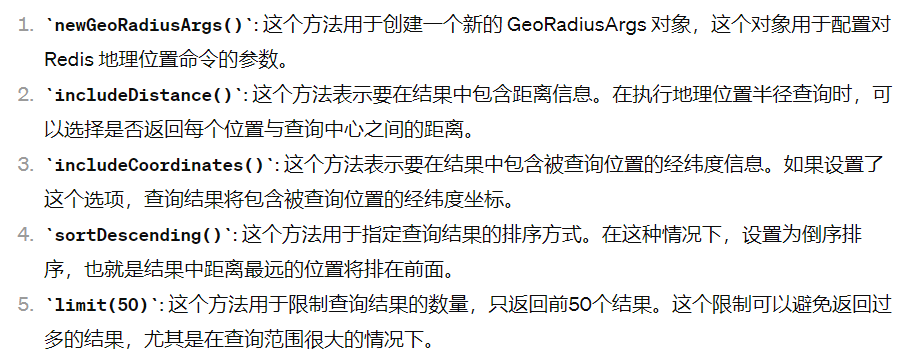
    RedisGeoCommands.GeoRadiusCommandArgs args = RedisGeoCommands.GeoRadiusCommandArgs.newGeoRadiusArgs().includeDistance().includeCoordinates().sortDescending().limit(50);

    GeoResults<RedisGeoCommands.GeoLocation<String>> geoResults = redisTemplate.opsForGeo().radius(CITY, circle, args);

    return geoResults;
}
public GeoResults radiusByMember() {
    //通过地方查找附近
    return null;
}
bitmap
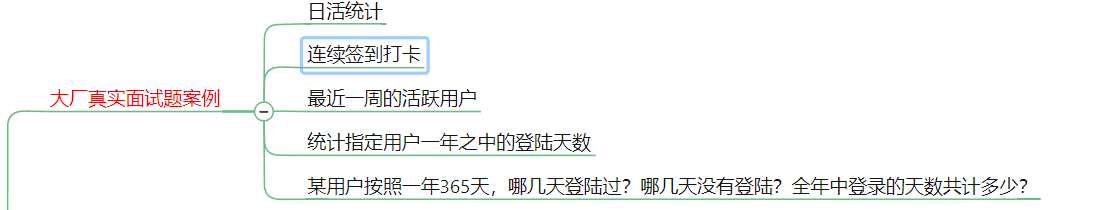
JAVA微服务生态/Redis7/基础/Redis入门 > redis 位图( bitmap )
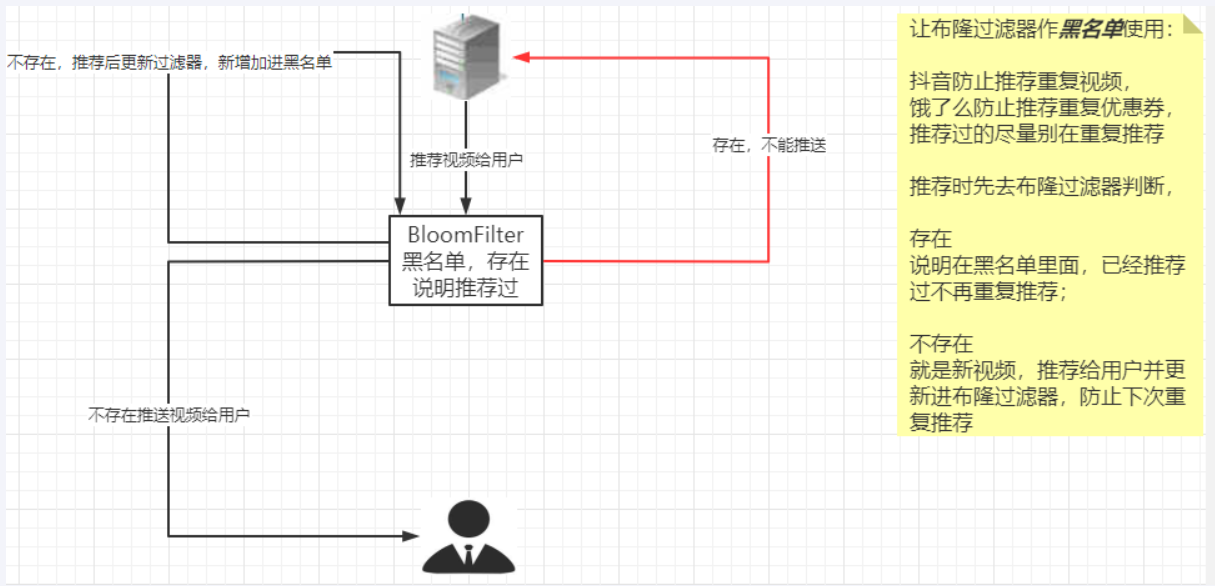
布隆过滤器 BloomFilter
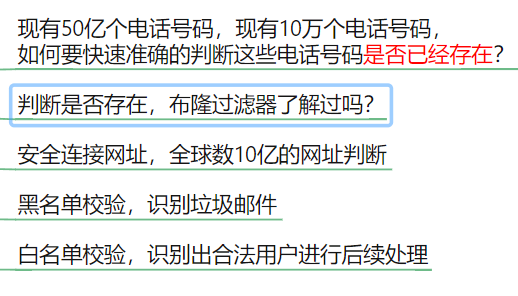
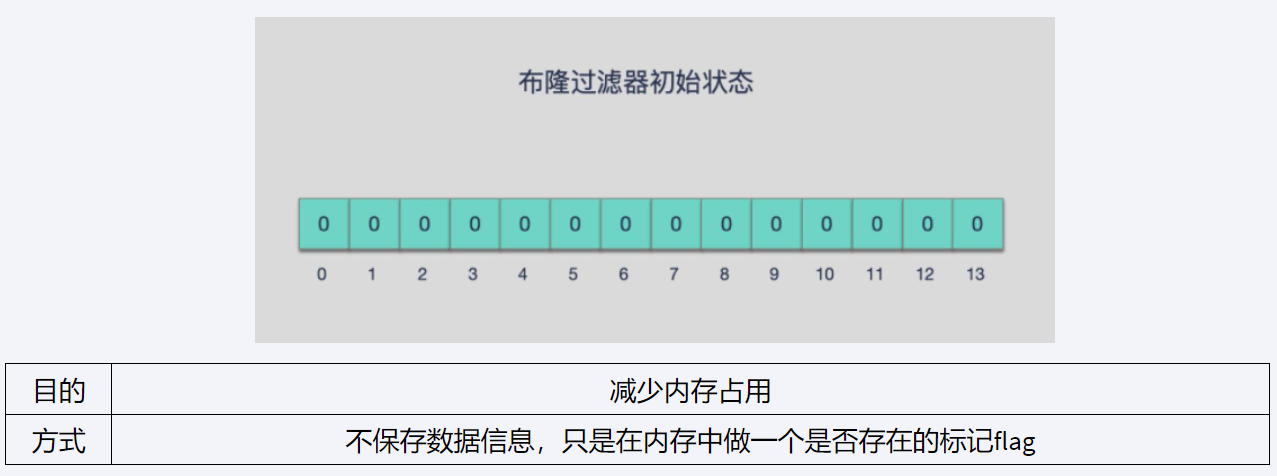
布隆过滤器是一段很长的 二进制数组+哈希算法 制作而成的,并不存储数据而是判断数据是否存在
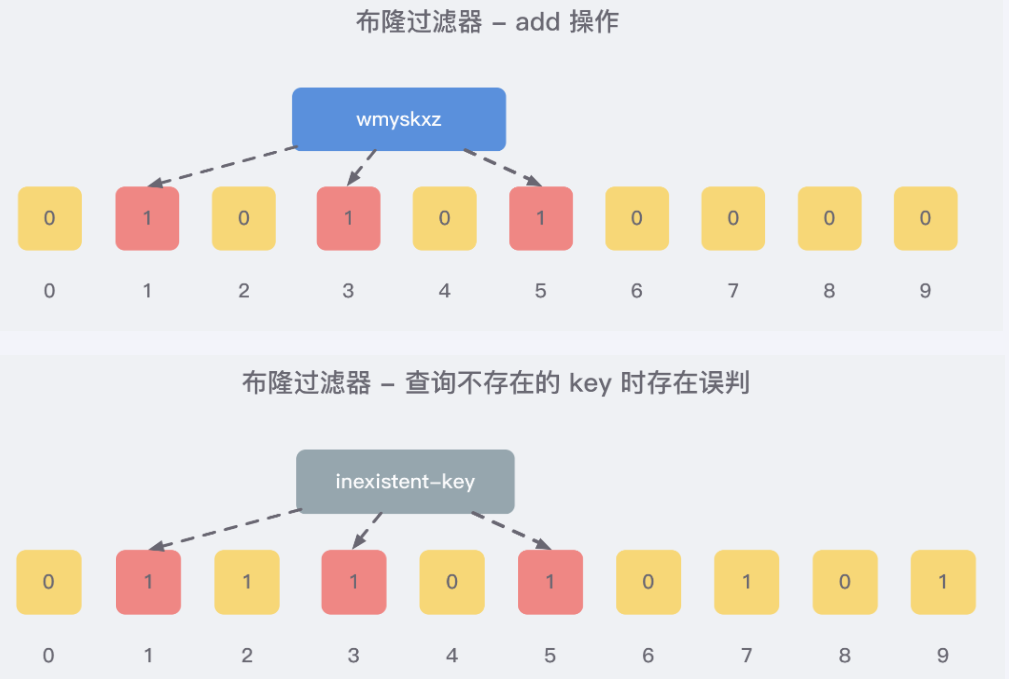
布隆过滤器就是利用自身存在则可能存在 (不同数据 hash 值可能一样),不存在则一定不存在的特性,快速判断一定一定 不存在于样本中的数据 / 存在于样本中的数据(有误差) , 根据需求进行过滤
高效的插入和查询,占用空间少
返回的结果是不确定+不够完美
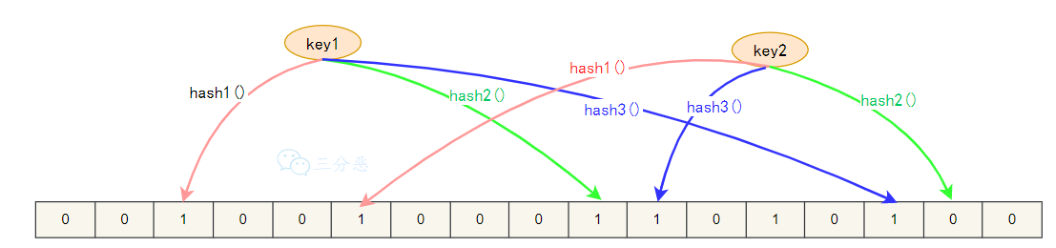
由一个初始值为 0 的 bit 数组和多个哈希函数构成 , 用来快速判断 集合 中是否存在某个元素, 判断一个区间是否有数据
- 根据存在是否 (存在的判断有误差)
白名单校验: 存在才允许访问 ,不存在不允许访问(解决 redis 缓存穿透) 黑名单校验 (垃圾邮件): 存在不允许访问,不存在允许访问
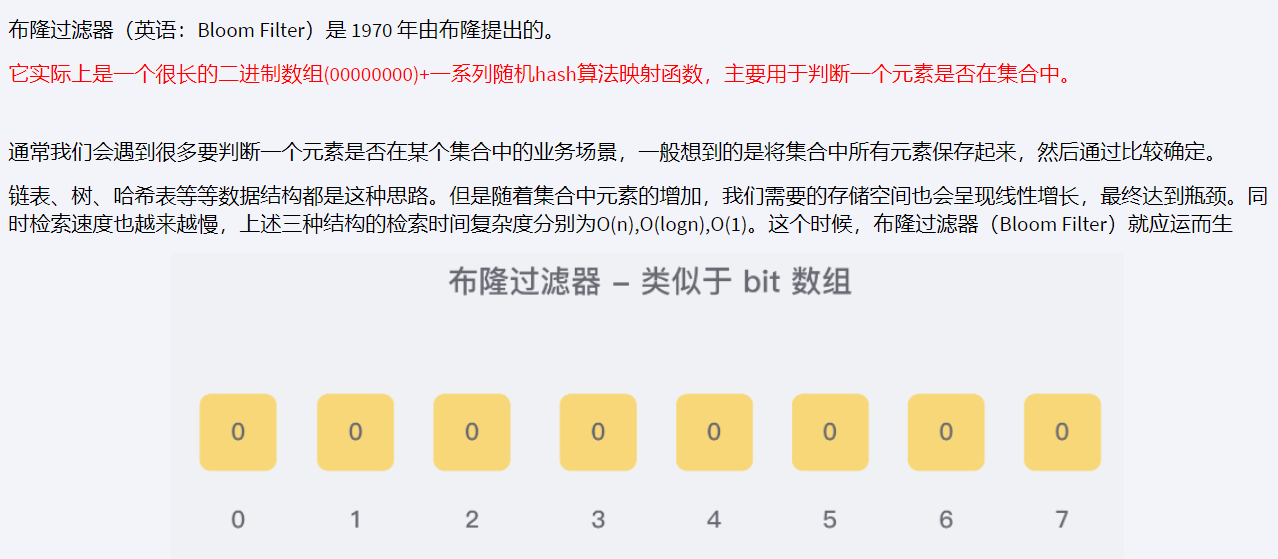
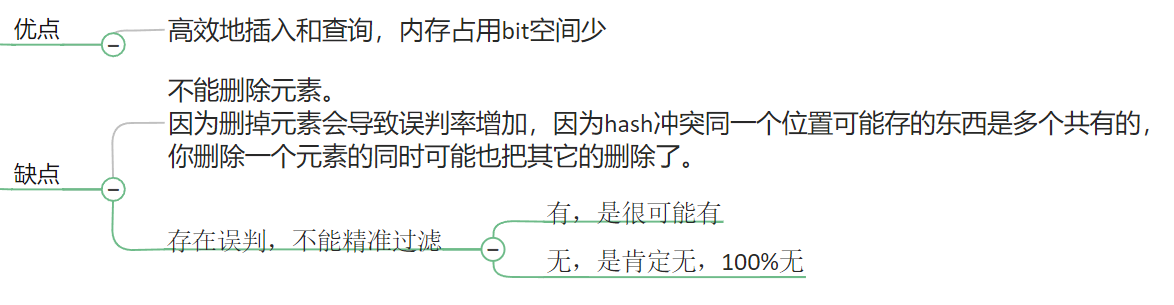
原理
我们可以将 redis 中的一个 bitmap 数据制作成布隆过滤器
原理和操作
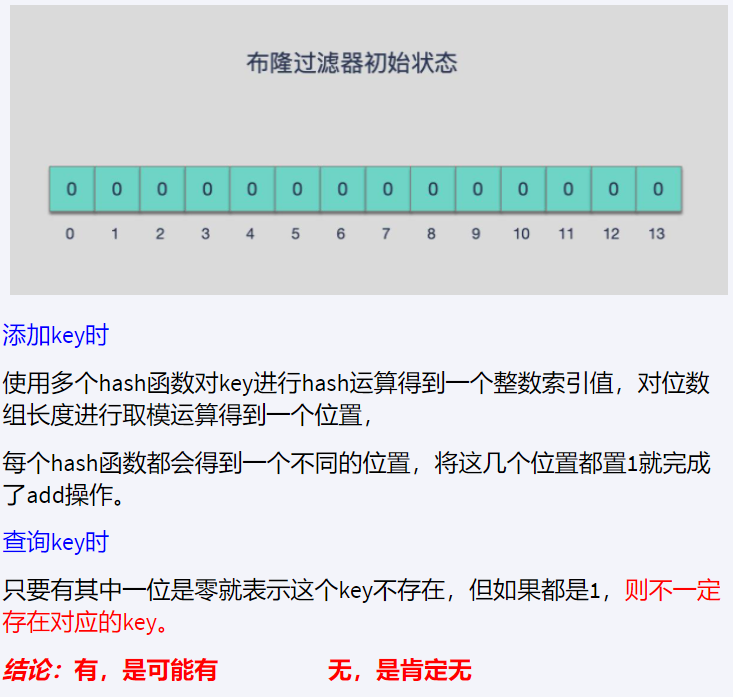
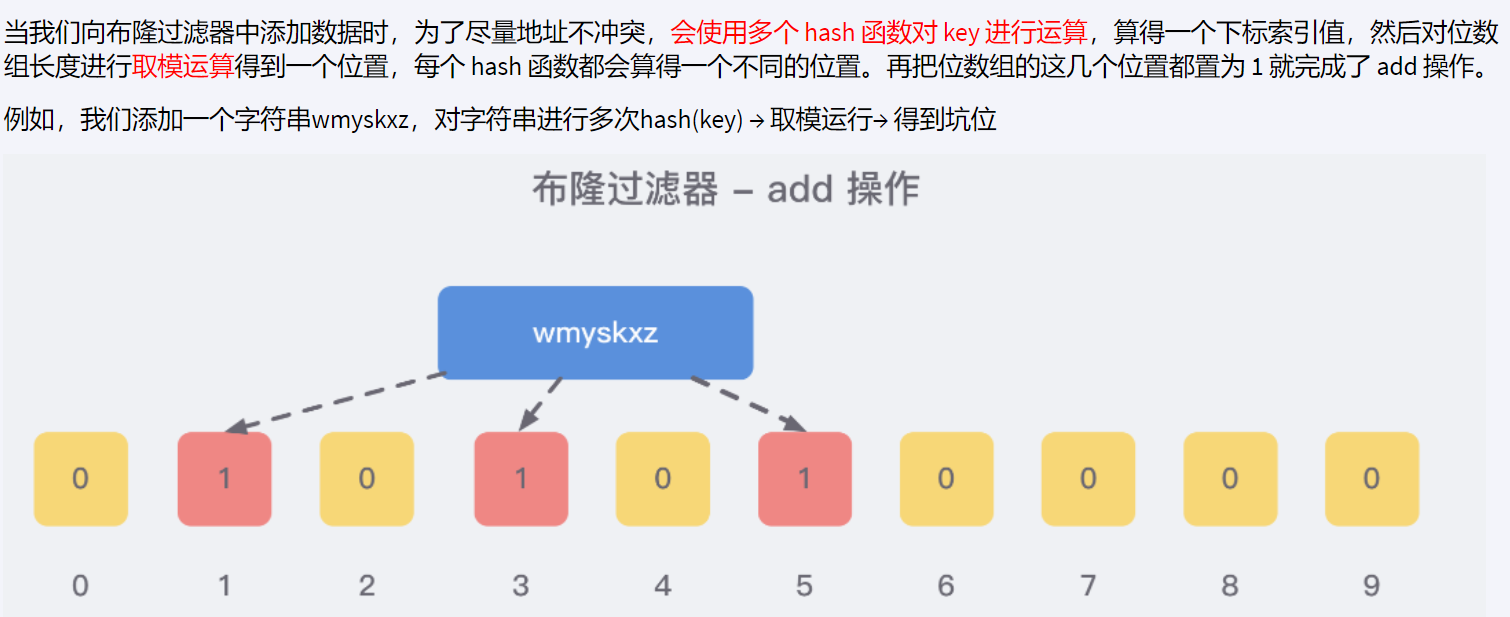
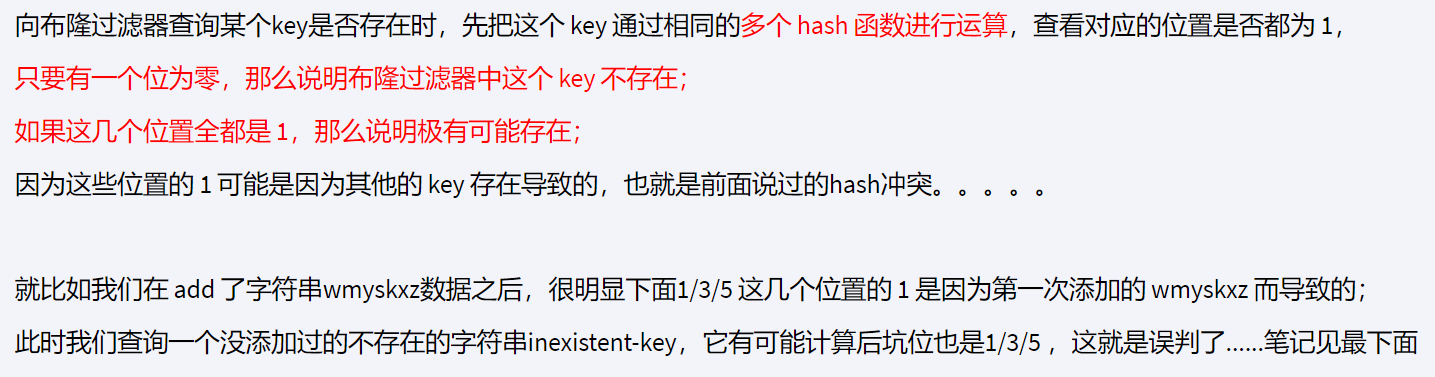
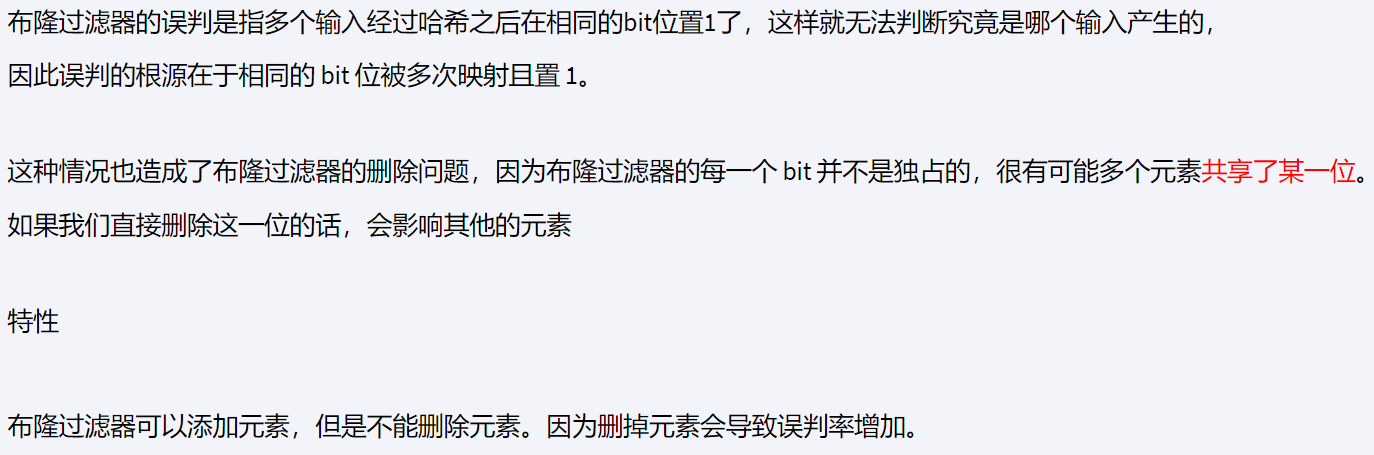
可以用多个坑位联合表示一个数据是否存在,多个坑位同时存在才存在
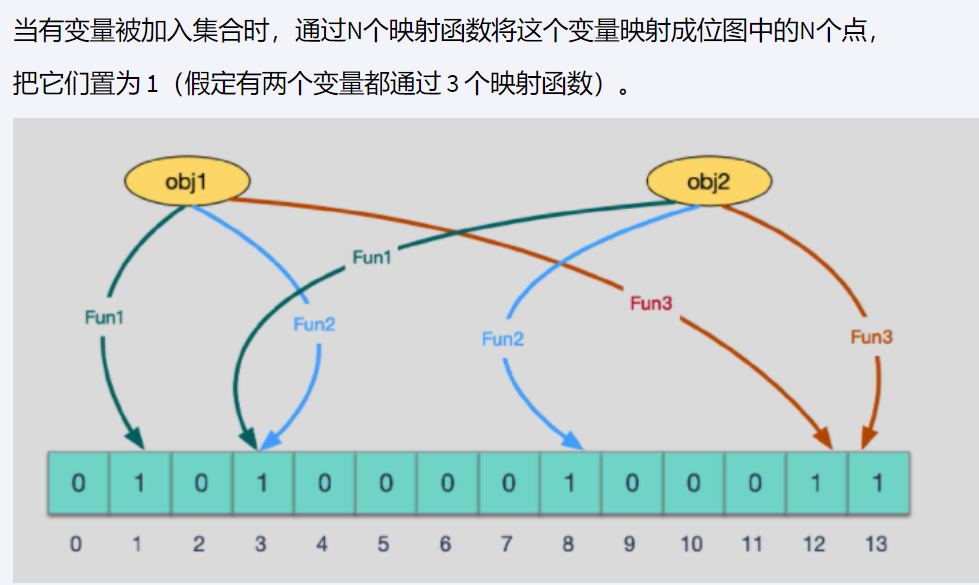
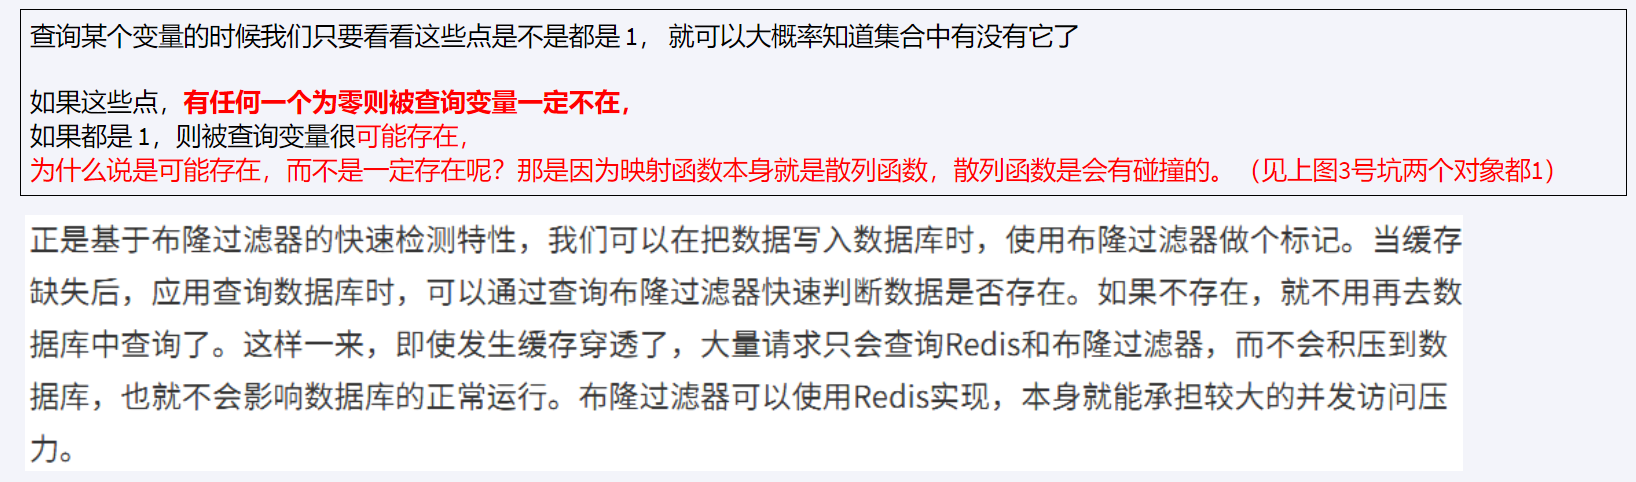
所以布隆过滤器添加完成后尽量减少删除
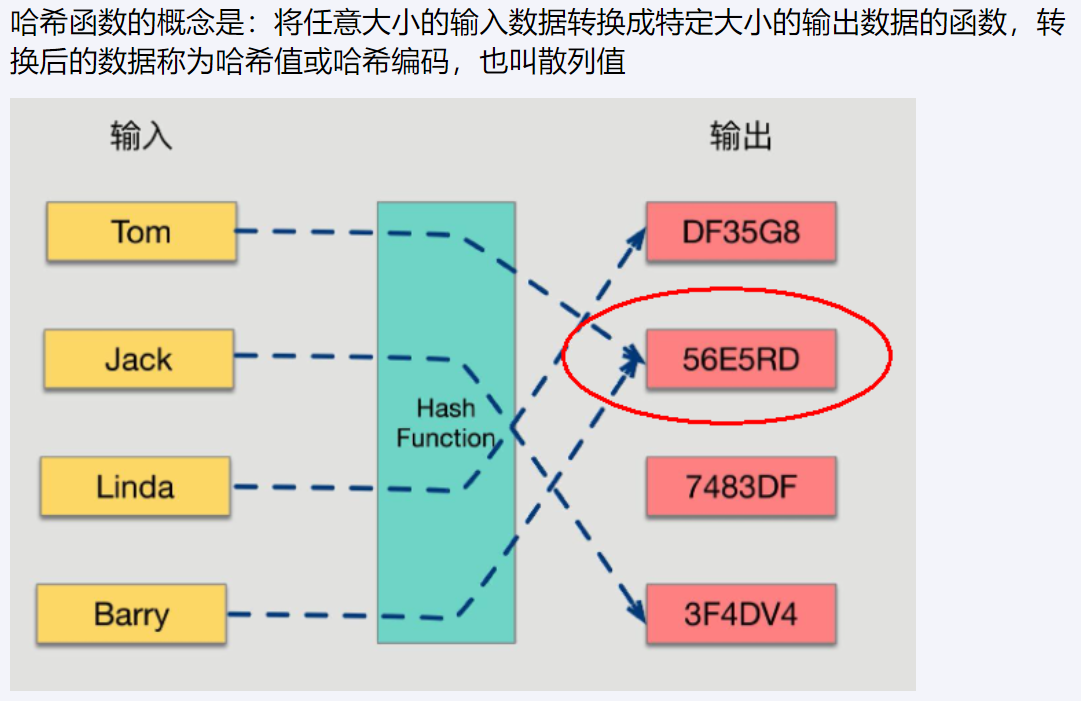
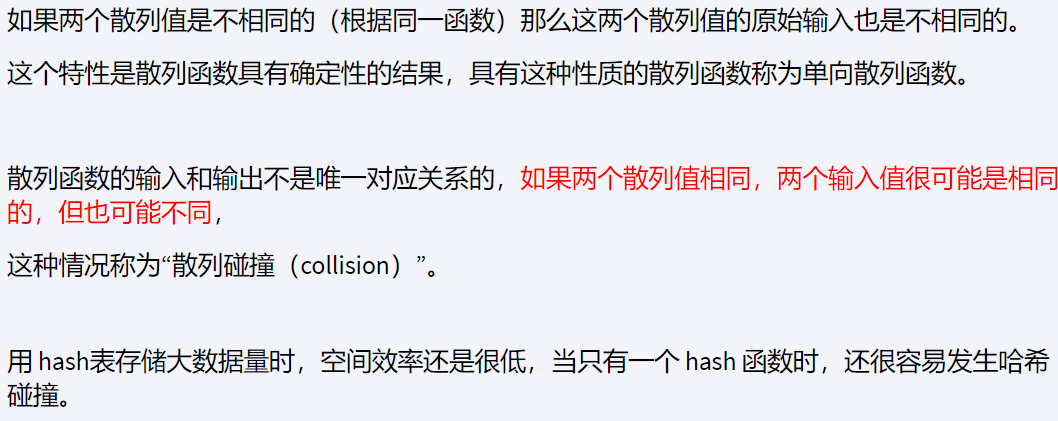 只有一个hash函数时,容易发生哈希碰撞,多个hash函数能减少哈希碰撞
使用步骤
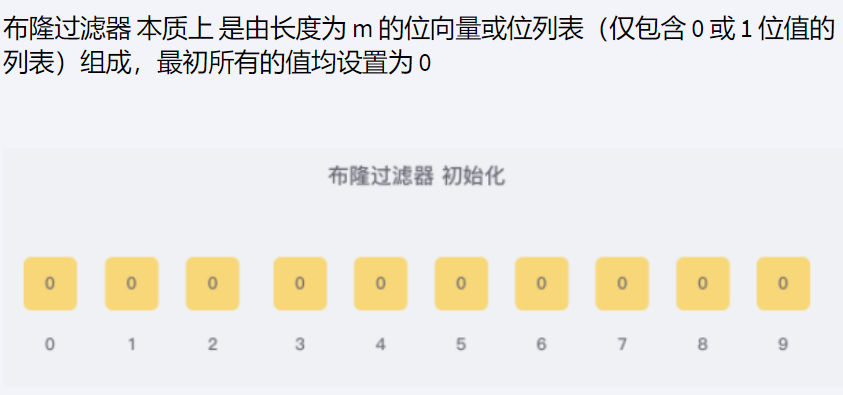
初始化bitmap
添加占坑位
判断是否存在
使用场景
解决缓存穿透问题
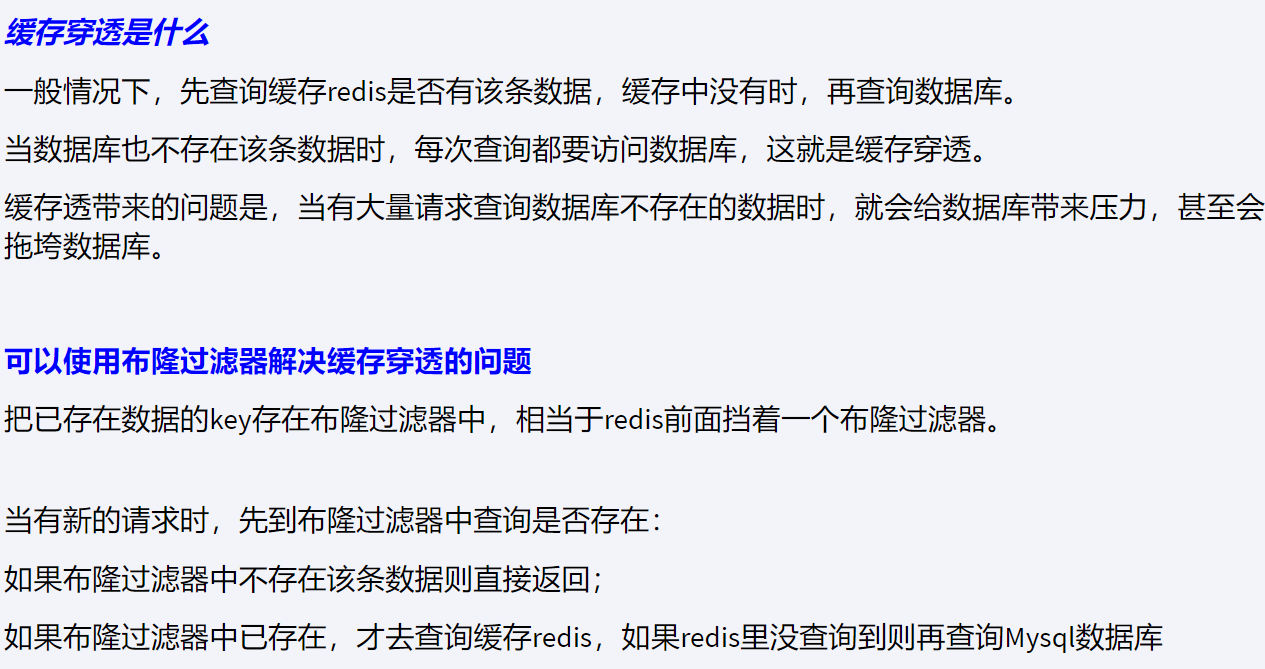
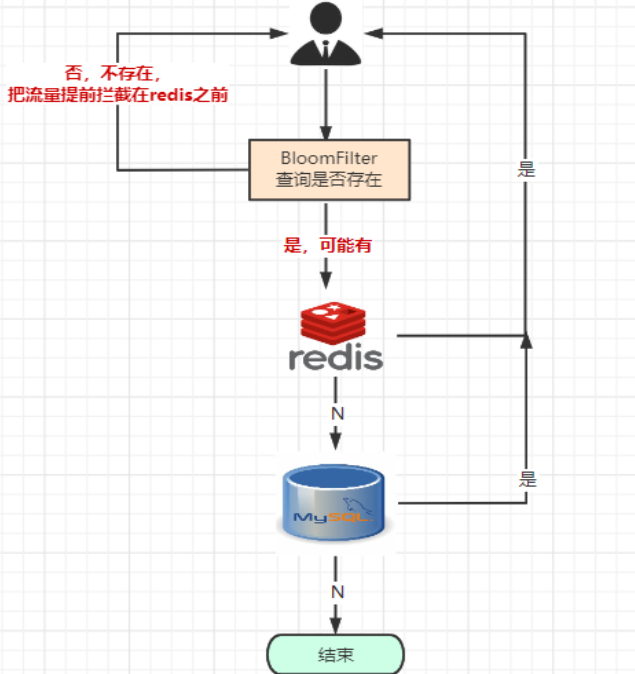
手写布隆过滤器
一般不用手写,用谷歌的 guava 即可
Math.abs 计算绝对值,避免负数
手写布隆过滤器
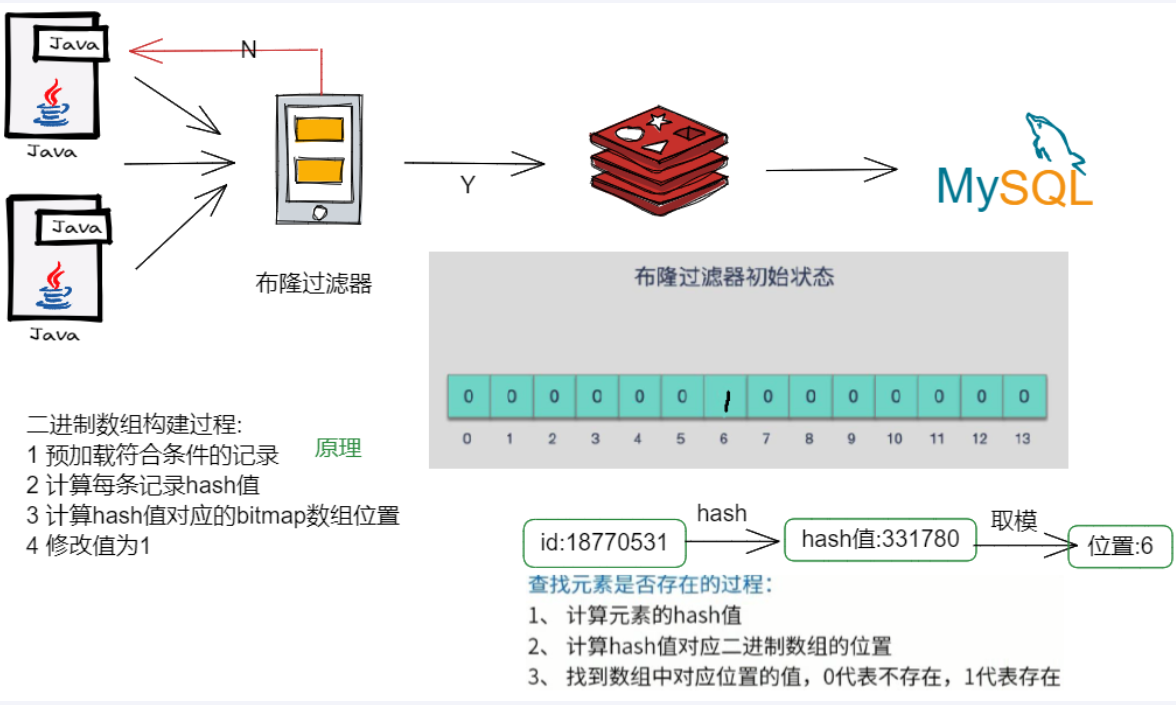
计算哈希后通过hashValue和2的32次方取余后得到对应的下标坑位
通过
BloomFlterInit将已经存在数据作为白名单加入到布隆过滤器通过
CheckUtils检查新的数据是否在布隆过滤器得到哈希值
int hashvalues = Math.abs(key.hashCode());得到槽数
long v = (long) (hashvalues % Math.pow(2, 32));设置bit
redisTemplate.opsForValue().setBit("whitelistCustomer",v, true);
布隆过滤器, 添加 @component, @PostConstruct
自定义一个 键值 如 whitelistCustomer, 数据类型为 bitmap, 这个数据类型的 bitmap 就作为布隆过滤器
将其他键的值进行计算, 得出对应的坑位,并设置为true
BloomFilterInit
* 布隆过滤器白名单初始化工具类,一开始就设置一部分数据为白名单所有,
* 白名单业务默认规定:布隆过滤器有,redis是极大可能有。


@Component
public class BloomFilterInit
{
    @Resource
    private RedisTemplate redisTemplate;

    @PostConstruct//初始化白名单数据,暂时注释省的后台打印
    public void init()
    {
        //1 白名单客户加载到布隆过滤器
        String key = "customer:12";
        //2 计算hashValue,由于存在计算出来负数的可能,我们取绝对值
        int hashValue = Math.abs(key.hashCode());
        //3 通过hashValue和2的32次方后取余,获得对应的下标坑位
        long index = (long)(hashValue % Math.pow(2,32));
        log.info(key+" 对应的坑位index:{}",index);
        //4 设置redis里面的bitmap对应类型白名单:whitelistCustomer的坑位,将该值设置为1
        redisTemplate.opsForValue().setBit("whitelistCustomer",index,true);

    }
}
CheckUtils 同样计算出坑位的值 , 检查是否在布隆过滤器中
checkItem 就代表布隆过滤器
CheckUtils
public class CheckUtils
{
    @Resource
    private RedisTemplate redisTemplate;

    public boolean checkWithBloomFilter(String checkItem,String key)
    {
        int hashValue = Math.abs(key.hashCode());
        long index = (long)(hashValue % Math.pow(2,32));
        ////checkItem就是key值
        boolean existOK = redisTemplate.opsForValue().getBit(checkItem,index);
        log.info("--->key:"+key+" 对应坑位下标index: "+index+" 是否存在:"+existOK);

        return existOK;
    }
}
java
public Customer findCustomerByIdWithBloomFilter (Integer customerId)
{
    Customer customer = null;
    //缓存key的名称
    String key = CACHA_KEY_CUSTOMER + customerId;

    //布隆过滤器check,无是绝对无,有是可能有
    //===============================================
    if(!checkUtils.checkWithBloomFilter("whitelistCustomer",key))
    {
        log.info("白名单无此顾客,不可以访问: "+key);
        return null;    }
    //===============================================

    //1 查询redis
    customer = (Customer) redisTemplate.opsForValue().get(key);
    //redis无,进一步查询mysql
    if (customer == null) {
        //2 从mysql查出来customer
        customer = customerMapper.selectByPrimaryKey(customerId);
        // mysql有,redis无
        if (customer != null) {
            //3 把mysql捞到的数据写入redis,方便下次查询能redis命中。
            redisTemplate.opsForValue().set(key, customer);
        }
    }
    return customer;
}
除了布隆还有布谷鸟过滤器
mapper
abel533/Mapper: Mybatis Common Mapper - Easy to use (github.com)
https://www.bilibili.com/video/BV13R4y1v7sP?p=121&vd_source=17535a06cd4587318e9b67ac64afeab7
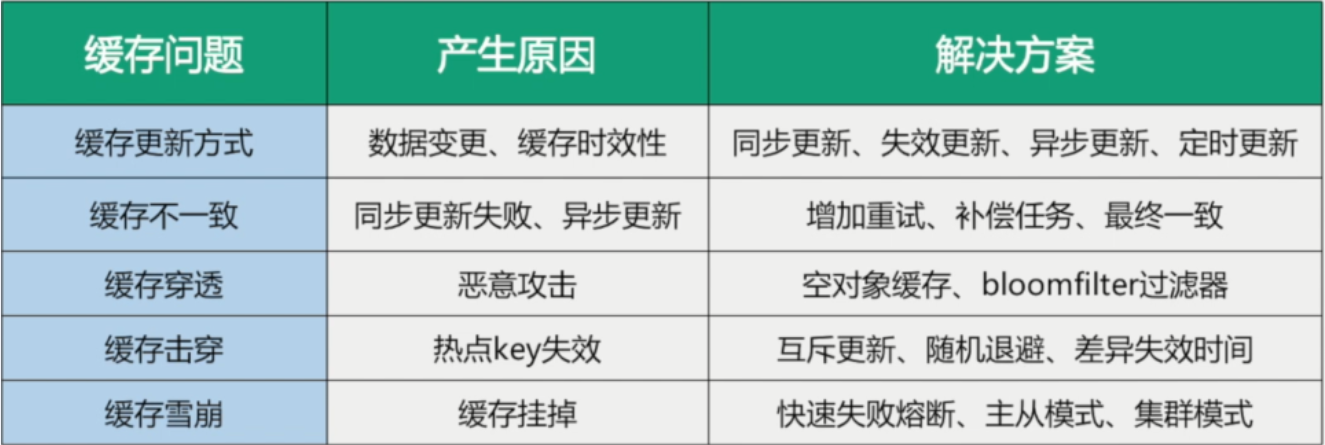
缓存预热+缓存雪崩+缓存击穿+缓存穿透
缓存预热
主动将数据先放到 redis 中
@PostConstruct初始化白名单数据 (也用于初始化布隆过滤器)- 从配置文件
application.yml注入
@Value("${whitelist.ips}") // 注入 IP 白名单
private String ips;
@Value("${whitelist.users}") // 注入 用户白名单
private String users;
缓存雪崩
缓存雪崩
redis 挂了,或者 redis 中同时有大量 key 大面积失效
解决:
- 均匀过期
redis中的热点key设置为永不过期、过期时间错开redis缓存集群实现高可用:主从+哨兵、集群,AOF/RDB- 熔断降级 服务熔断/服务降级
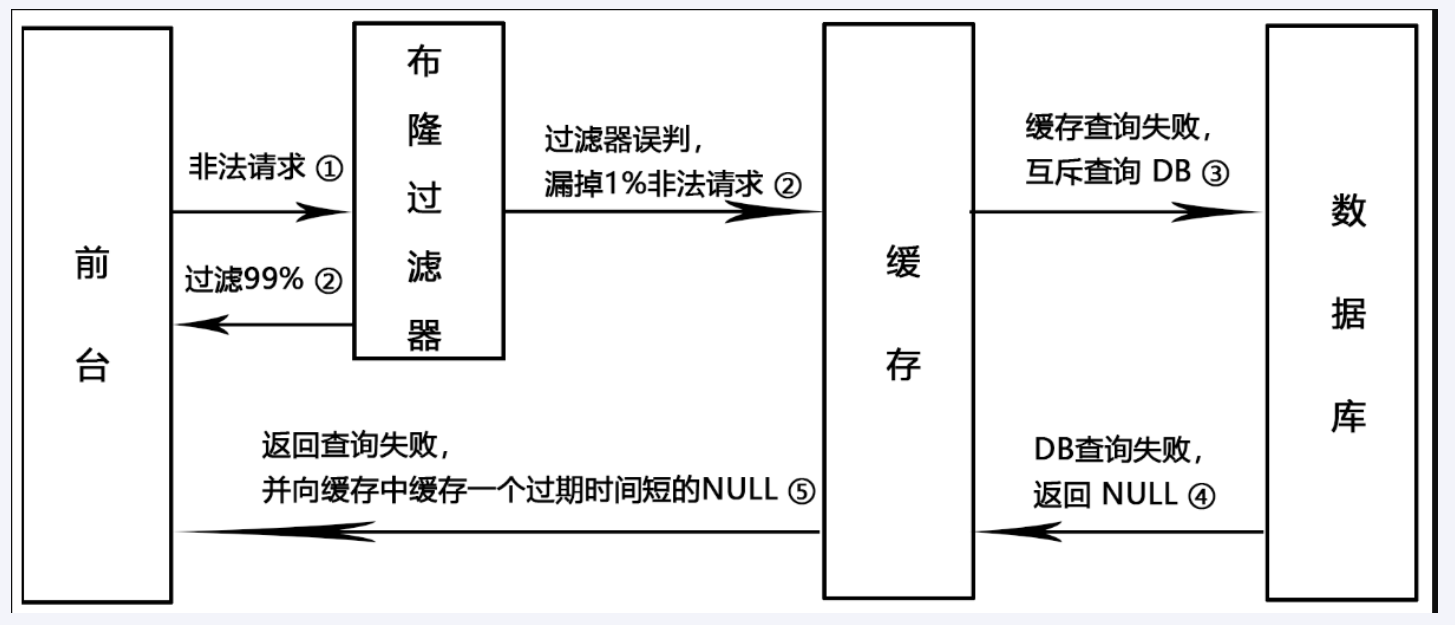
缓存穿透
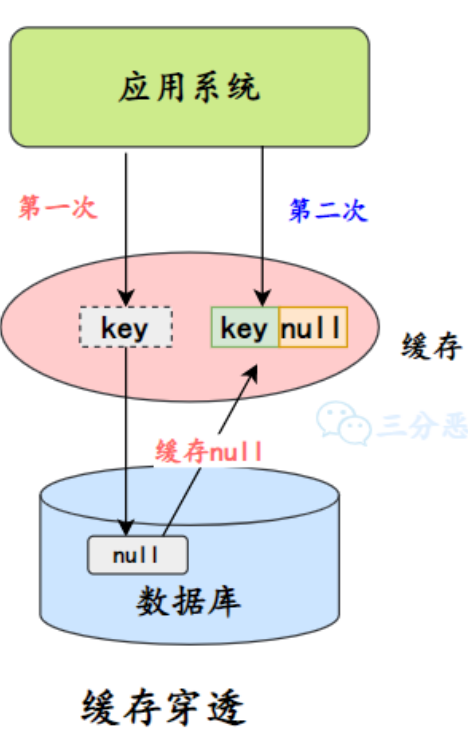
每次查询 redis 中都没有,自始至终都没有,直接达到了 mysql 导致数据库压力暴增

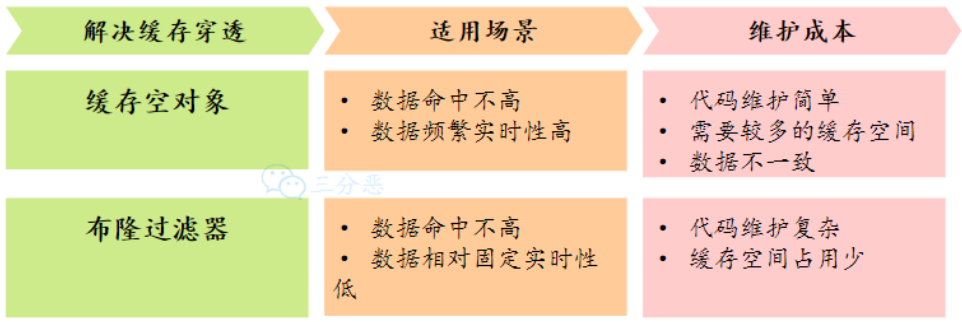
解决方案
空对象缓存 (使用默认值) 穿透的都进一步缓存到
redis中,黑客会用不同key进行更新, 会写入很多无关紧要的key,越写越大Google布隆过滤器Guava(权威且建议) Guava 解耦性好 误判概率很小可以接受 将全部合法的key放入Guava版本布隆过滤器+redis里面,不然数据返回null
<!--guava Google 开源的 Guava 中自带的布隆过滤器-->
        <dependency>
            <groupId>com.google.guava</groupId>
            <artifactId>guava</artifactId>
            <version>23.0</version>
        </dependency>
Guava白名单实例
误判率越小:生成的槽位越多,使用的哈希函数越多
但是,增加哈希函数的数量也会增加计算开销。通常情况下,合理的哈希函数数量可以在保持低误判率的同时降低计算成本
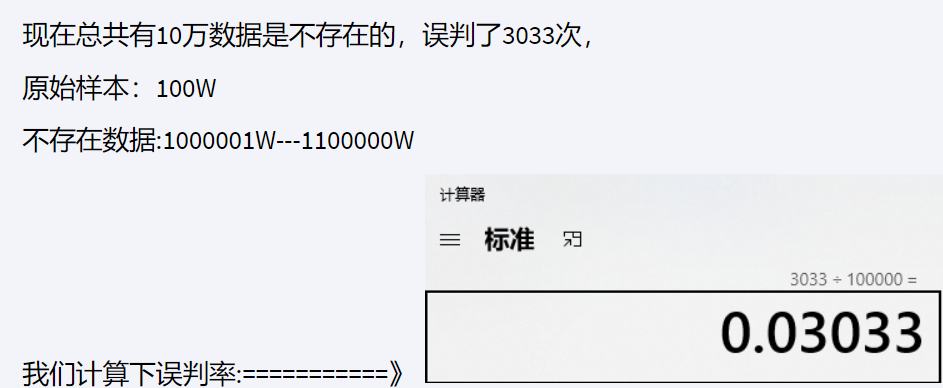
这10万数据都不在布隆过滤器中,应该都不存在,但由于过滤器误判可能判为存在

@Service
@Slf4j
public class GuavaBloomFilterService
{
    //1 定义一个常量
    public static final int _1W = 10000;
    //2 定义我们guava布隆过滤器,初始容量
    public static final int SIZE = 100 * _1W;
    //3 误判率,它越小误判的个数也就越少(思考,是否可以是无限小??没有误判岂不是更好)
    public static double fpp = 0.01;//0.01 0.000000000000001
    //4 创建guava布隆过滤器
    private static BloomFilter<Integer> bloomFilter = BloomFilter.create(Funnels.integerFunnel(), SIZE,fpp);


    public void guavaBloomFilter()
    {
        //1 先让bloomFilter加入100W白名单数据
        for (int i = 1; i <= SIZE  ; i++) {
            bloomFilter.put(i);
        }
        //2 故意取10W个不在合法范围内的数据,来进行误判率的演示
        ArrayList<Integer> list = new ArrayList<>(10 * _1W);

        //3 验证
        //过滤器只添加了SIZE的数据,故意从SIZE+1外的数据开始判断,出现误判
        for (int i = SIZE+1; i <= SIZE+(10 * _1W) ; i++)
        {
            if(bloomFilter.mightContain(i))
            {
                log.info("被误判了:{}",i);
                list.add(i);
            }
        }
        log.info("误判总数量:{}",list.size());
    }
}
Guava黑名单实例
缓存击穿
某个 key 被大量请求时,这个 key 正好失效了,就会导致大量的请求打到数据库上,造成缓存击穿

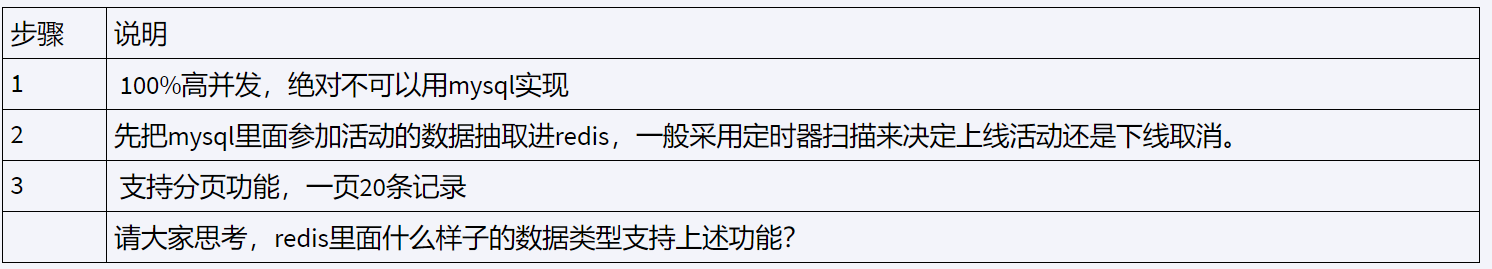
有些黑客会在活动结束一瞬间,这一瞬间会有一批 redis 被删掉,新的导入 redis, 黑客会利用这一瞬间进行缓存击穿
解决: 双检加锁、互斥更新、随机退避、差异失效时间
互斥更新: 与双检加锁类似,但更侧重于确保只有一个线程更新缓存,其他线程等待更新完成后直接读取缓存。
随机退避 : 当缓存失效时,不同的请求在访问数据库前进行随机延迟,这样可以避免大量请求同时访问数据库。影响用户体验。
原因
比如双十一的业务只干几天,时间过后清除了但又被访问到了
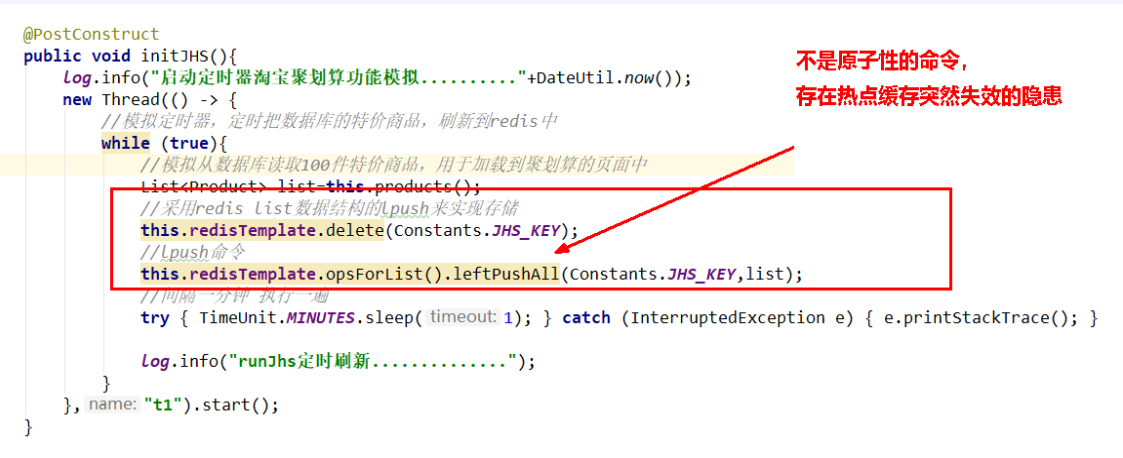 刚刚删除后可能又其他线程来访问
- 解决
- 使用前面的读取时双检加锁
- 差异失效时间,或者对于访问频繁的热点 key, 干脆不设置过期时间
- 使用两份数据 A 失效 B 作为备份, A 删除时还没有更新完, 此时有 B 顶着
总结
手写 Redis 分布式锁
(锁名|UUID|计数器)``redisLock:uuid:valueNumber
锁名 : 都是相同的,确保唯一,锁只有一把 UUID = 工厂 UUID+线程 UUID : 判断该锁是否是自己创建的,以便来判断是否能进行删除(确保只有创建该锁的对该锁有权限操作该锁),是否可进行重入操作,但是锁中 UUID 绑定线程
使用 Hset 构建分布式锁
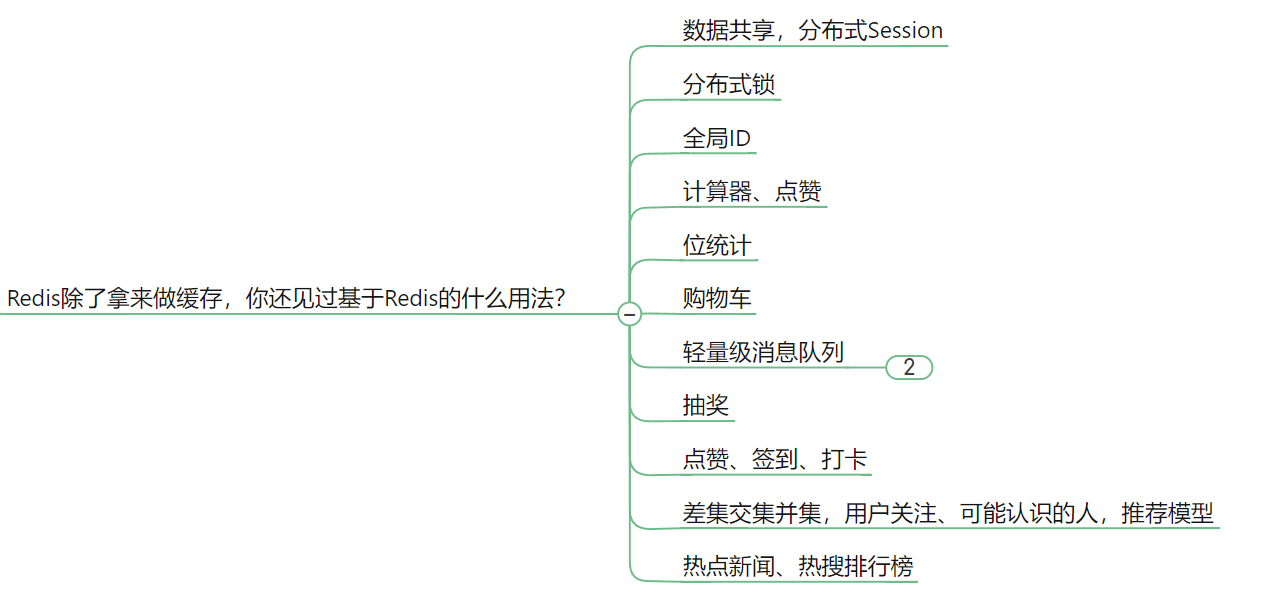
由于分布式多个虚拟机,而 Java 中的锁只能管一个虚拟机,单线程的 线程锁机制 不再起作用,此时就需要一个可以让所有线程都能访问获取的锁 (可以通过 redis 或者 zookeeper 来构建),来跨进程跨服务

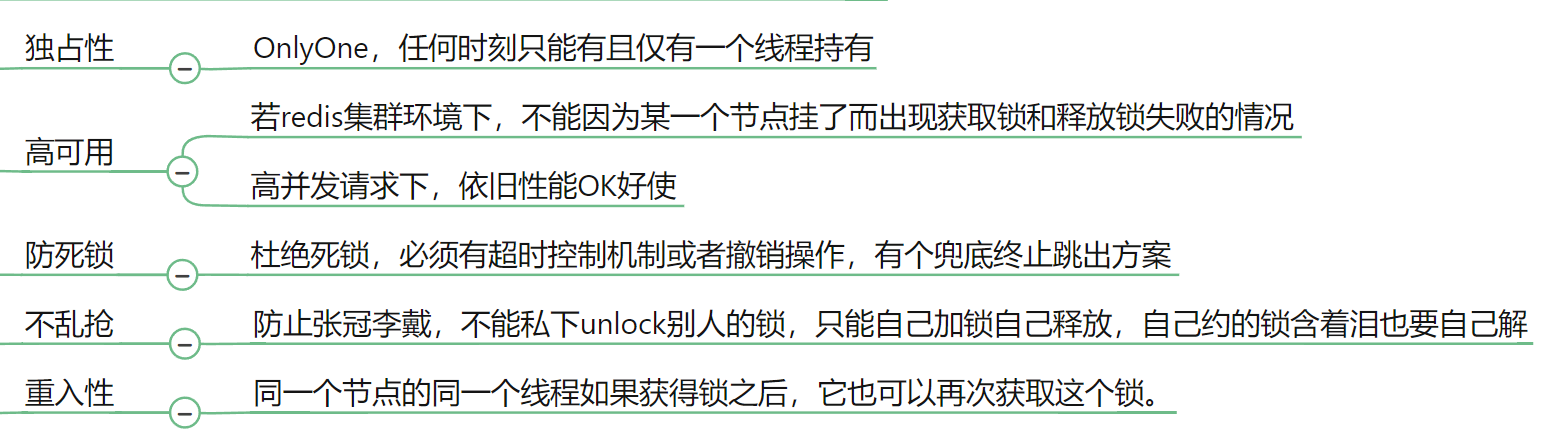
一个合格redis锁所需的
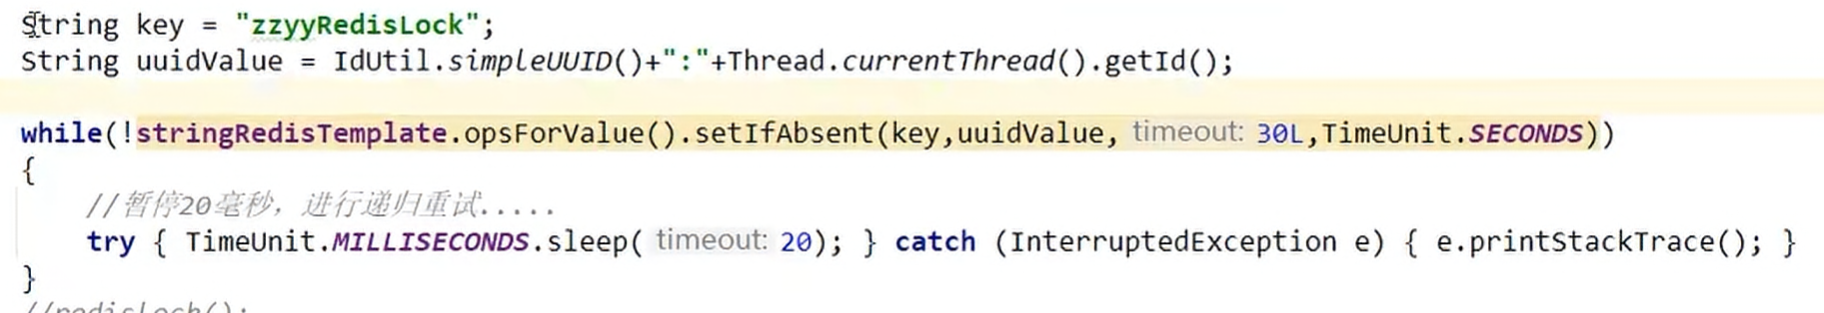
利用 redis 中的 string 数据类型(可重用锁时改进为 hash ),创建一个 key 值固定有且只有一个的,作为分布式锁,别的线程过来都要抢这个唯一的 redis 锁后才能进行操作,单机版的锁 (synchronized/lock)则只能管当前自己线程
防止多线程的 虚假唤醒
- 问题 1 : 防止多线程的
虚假唤醒,不要使用if判断,而是使用while,while在wait唤醒后,又进行一次while判断,而if不会,同样递归在高并发容易出错,而此时采用自旋来代替方法重试调用
抢不到要重试,如果使用 if,则需要 递归 重试,太多请求可能爆 StackOverflowError
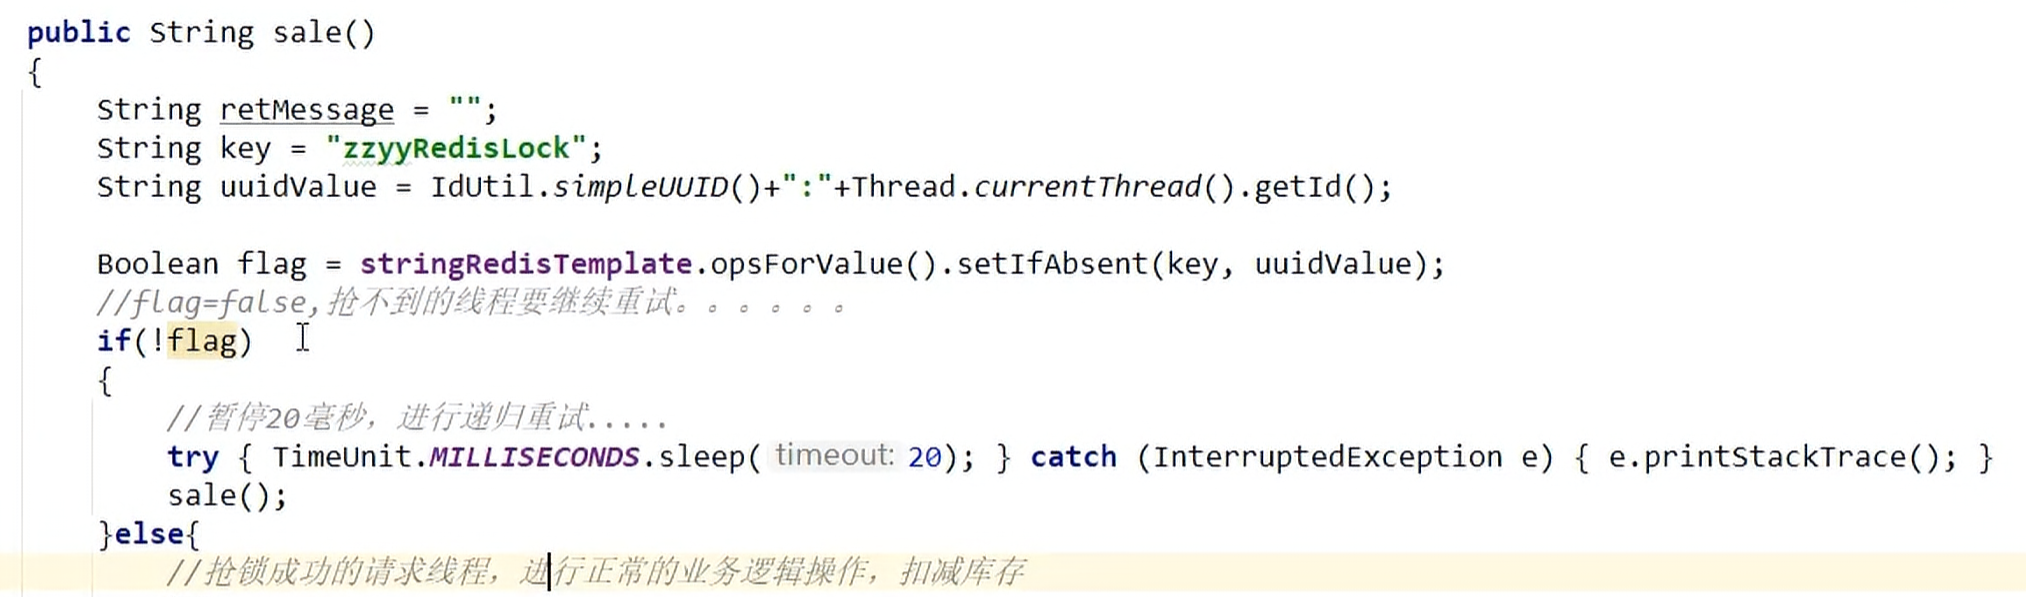 为了防止多线程的
虚假唤醒,不要使用if判断,而是使用while
while 可以在满足条件时一直运行,而 if 想要一直运行则需要递归本方法

- 改善,避免了
StackOverflowError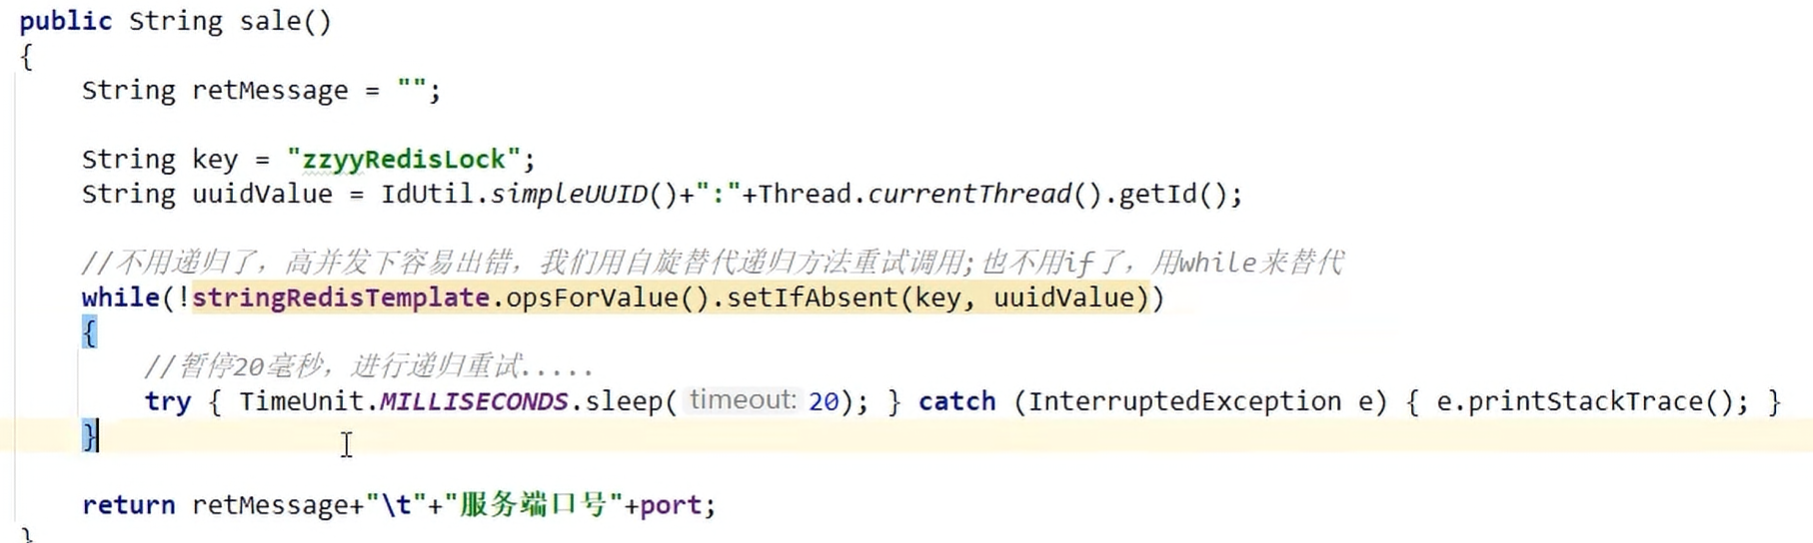 只有拿到锁时才会结束
保证过期和创建具有原子性
- 问题 2 : 宕机导致的问题 ,需要保证过期和创建具有原子性
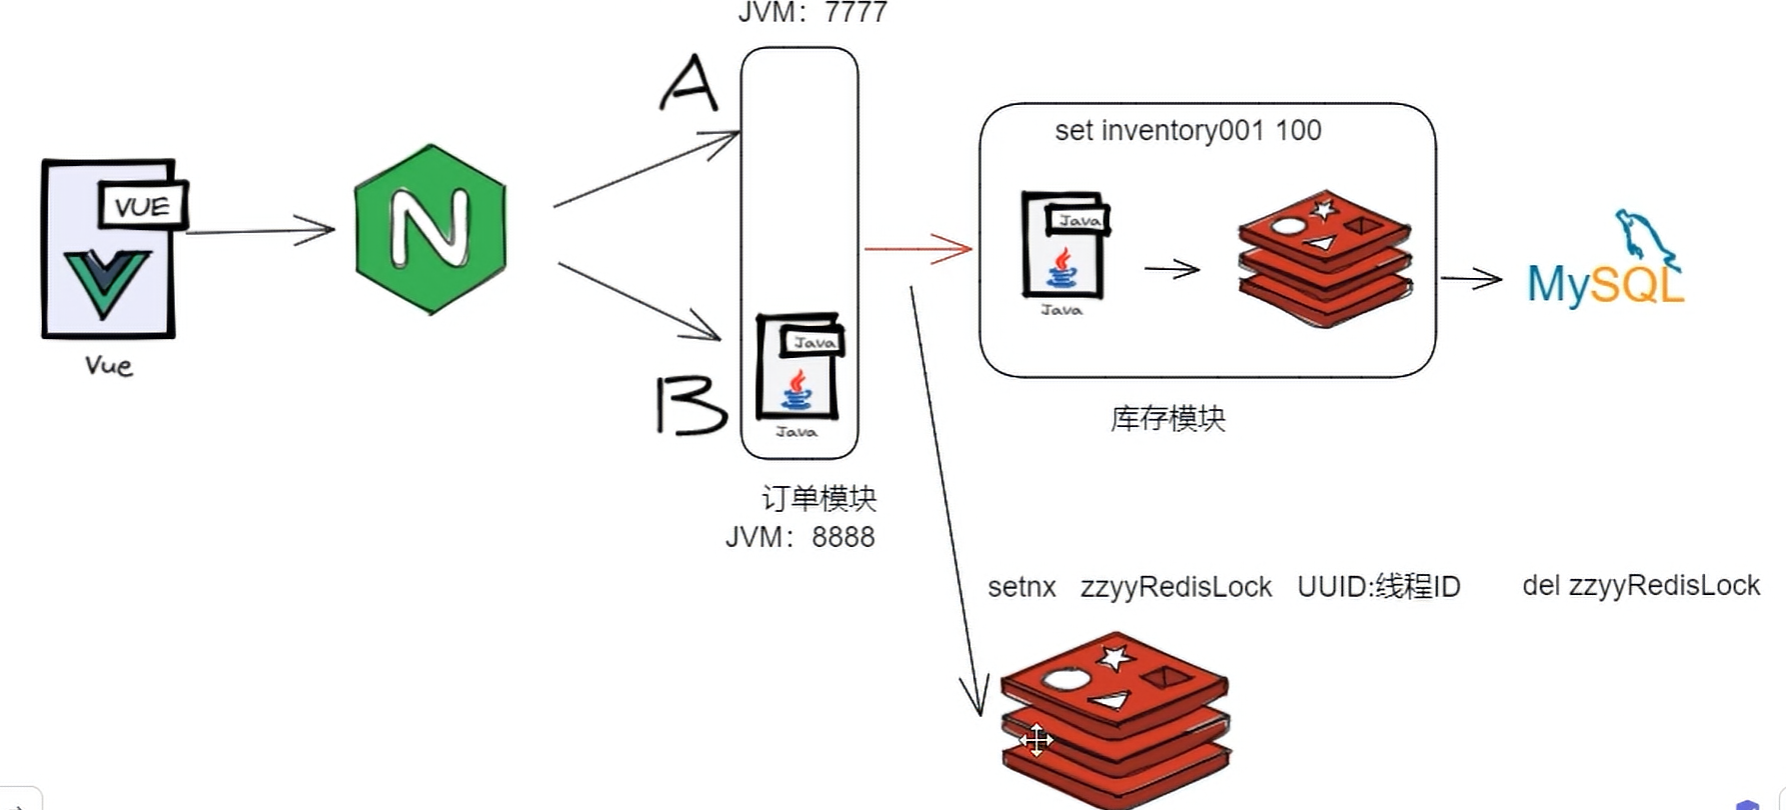 当拿到锁后,其中一个
Java 服务 A突然宕机了,而创建的的分布式锁没有设置时间依然存在,而没有设置过期时间就会一直存在,需要加上到期时间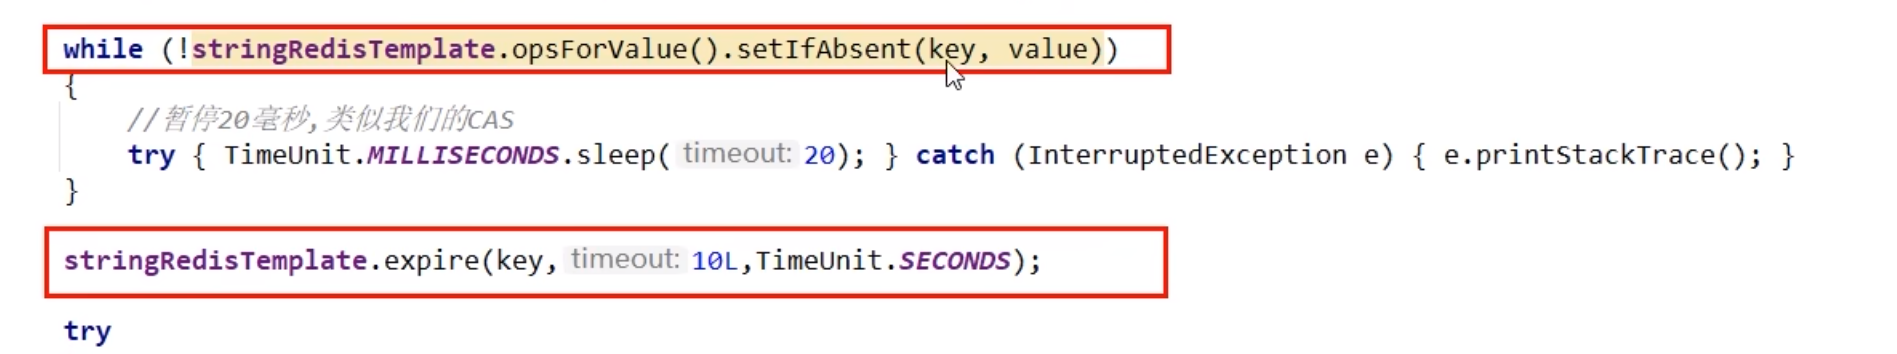 这串代码不具有 原子性,可能出现抢到锁了,但是却挂了没有设置上过期时间(程序崩溃、服务器宕机等),确保抢到锁的同时设置上了过期时间则具有原子性
如何防止到期误删 key
- 问题 3 : 如何防止到期误删 key ,过期时间到了锁已经失效了但任务还没有完成,别的线程拿到了锁,之后自己完成后进行删除,却删除了别人线程的锁
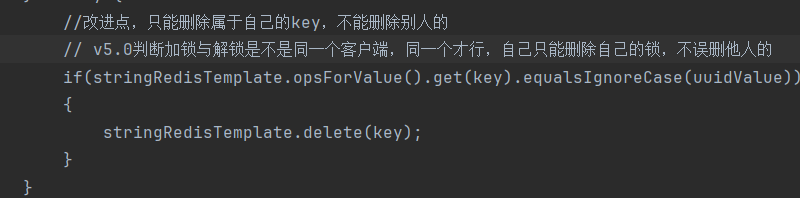
锁也就是 key 通过设置相同的,value 设置为 uuid,则会通过判断 value 的值来判断该 key 是否是自己创建的
因为 key 都是相同的,key 存在则不能进行创建,这样到期后别的线程创建了新的锁,自己的锁已经到期,也不会删除别人创建的锁
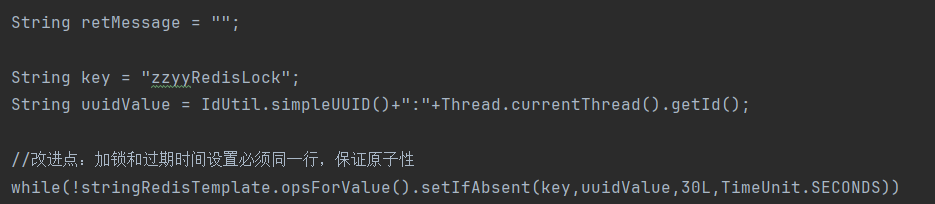
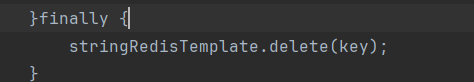
以前
现在: 判断是否是自己的,
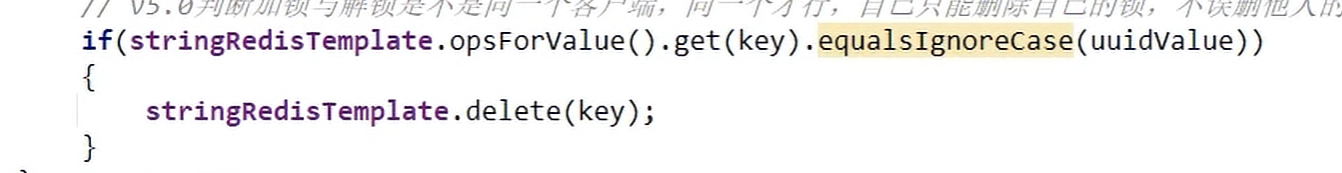 但该删除操作依旧不具有原子性
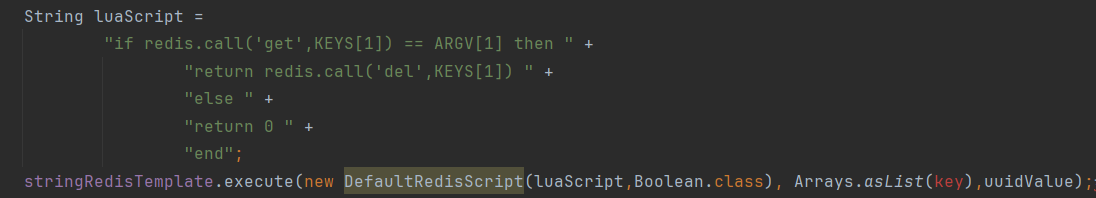
lua 脚本: 将删除具有原子性
Distributed Locks with Redis | Redis
判断和删除两个操作如何具有原子性?
- 问题四 : 删除不具有原子性,需要
lua 脚本,如果刚判断完挂掉了就会导致没有删除
作用
redis 调用 lua 脚本通过 eval 命令保证代码执行的原子性,直接 return 返回脚本执行后的结果值
lua 脚本的作用就是 将多条命令进行多合一执行,如上面三条变成一次性执行
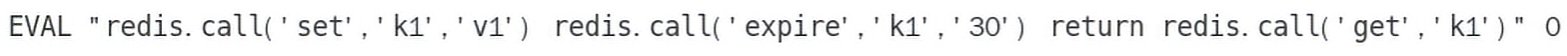
语法格式
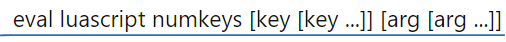
nil 代表返回空,等价于 java 中的 false
nil=false
1=true
0=false
- lua语法格式
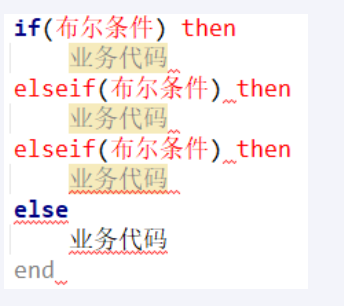

end" 后的参数数量先依次分给 KEYS, 再分给 ARGV
EVAL 命令中,KEYS 参数的数量之后的所有参数都会被视为 ARGV 参数
java 中 lua 脚本的使用
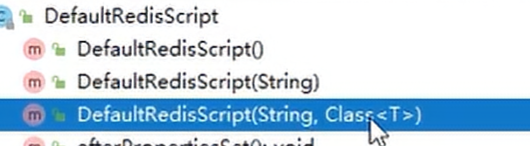
执行 lua 脚本推荐用 DefaultRedisScript()
stringRedisTemplate.execute(new DefaultRedisScript(luaScript,Boolean.class), Arrays.asList(key),uuidValue);

Arrays.asList(key)==KEYS[]
uuidValue==ARGV[]
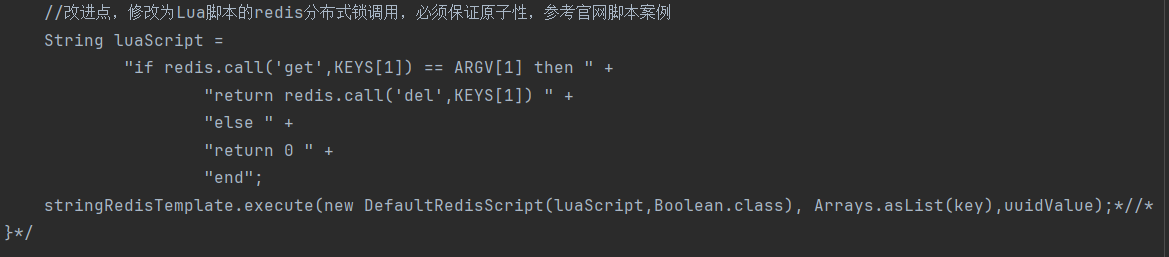
nil = null 1 = true 0 = false 返回值有三套值
所以用 Boolean.class 接受,也可以用 Long.class 接受
但 Boolean.class 类型无法直接接受 Redis 返回的 nil 值
Redis Lua 脚本返回值到 Java Boolean 的转换规则:尝试将 Redis Lua 脚本的返回值转换为 Boolean 时,它会遵循一定的规则。通常,Redis 的整数返回值会被这样转换:
0 会被转换为 false,任何非零的整数 (通常是 1 或其他正数/负数) 会被转换为 true
Lua 语言本身的真值和假值规则: 在 Lua 的逻辑判断中(例如 if 条件),lua 认为 0 和 空字符串 都是 true, 除了 false 和 nil 为假, 其他值都为真。
注意
如果 lua 脚本外面有双引号了,里面要改成单引号

Boolean 代表了返回值
可重用锁
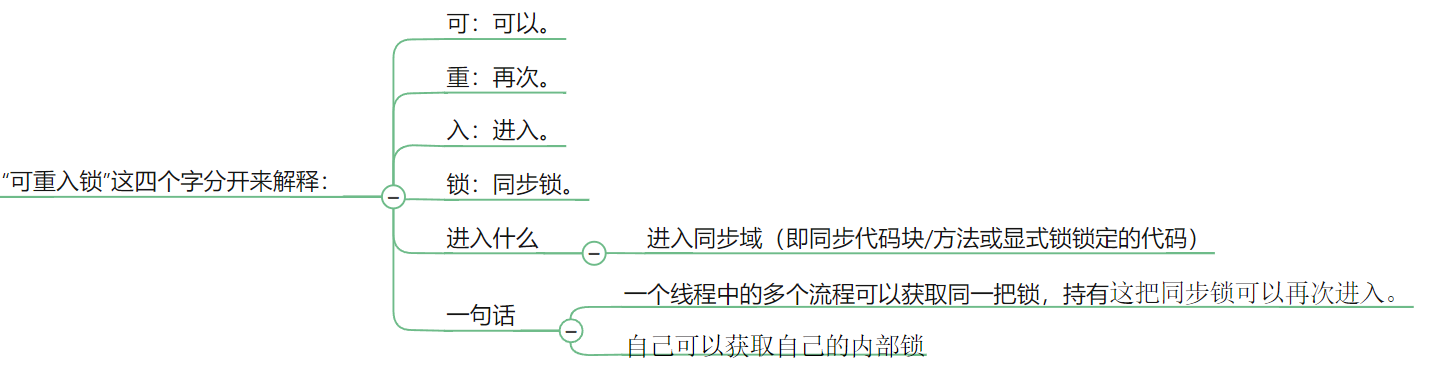
同一个线程中的方法拿到锁后,本身调用的方法又需要拿锁,该如何设计?
redis 中一个业务拿到锁后,下次还是自己抢到,该如何分配?
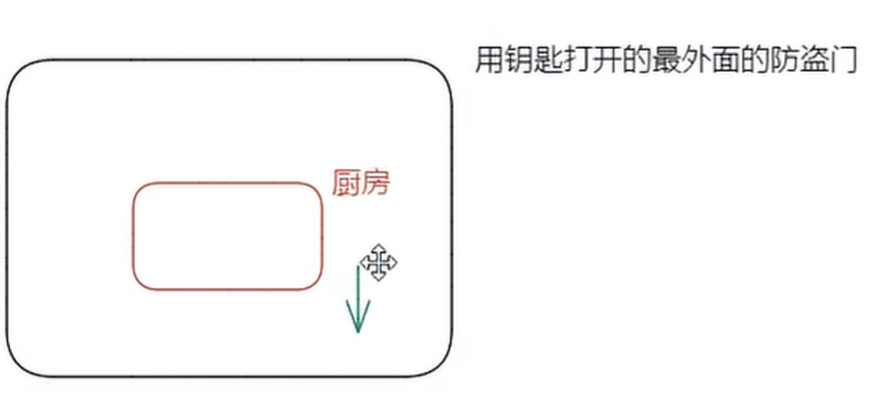
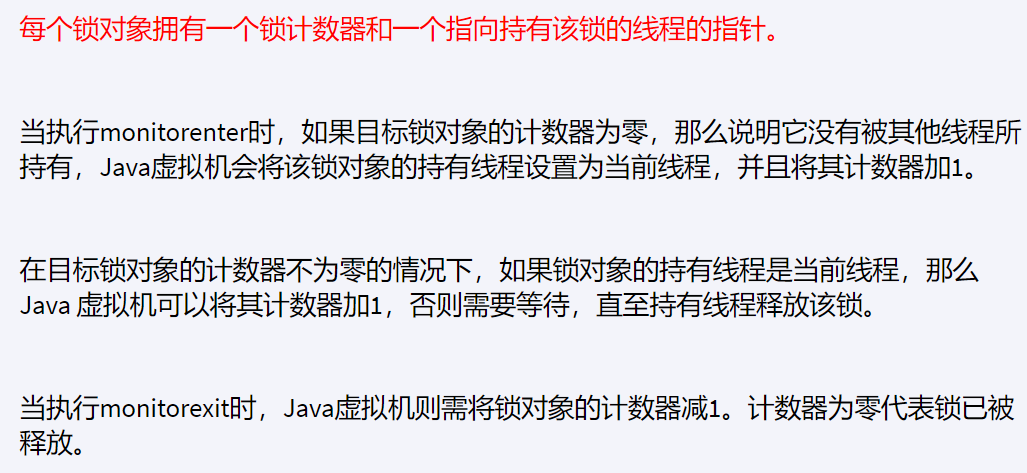
一个线程中的一个方法拿到锁后,方法内的方法如果再需要锁,可以用之前拿到的锁进行重用
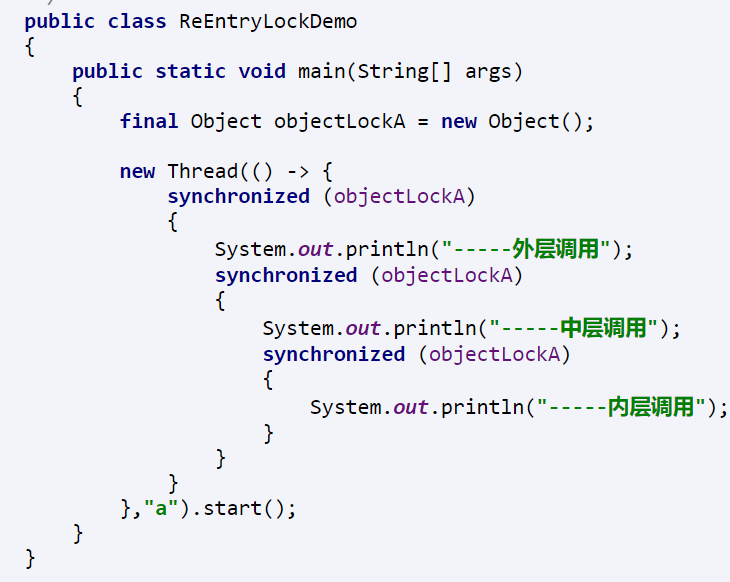
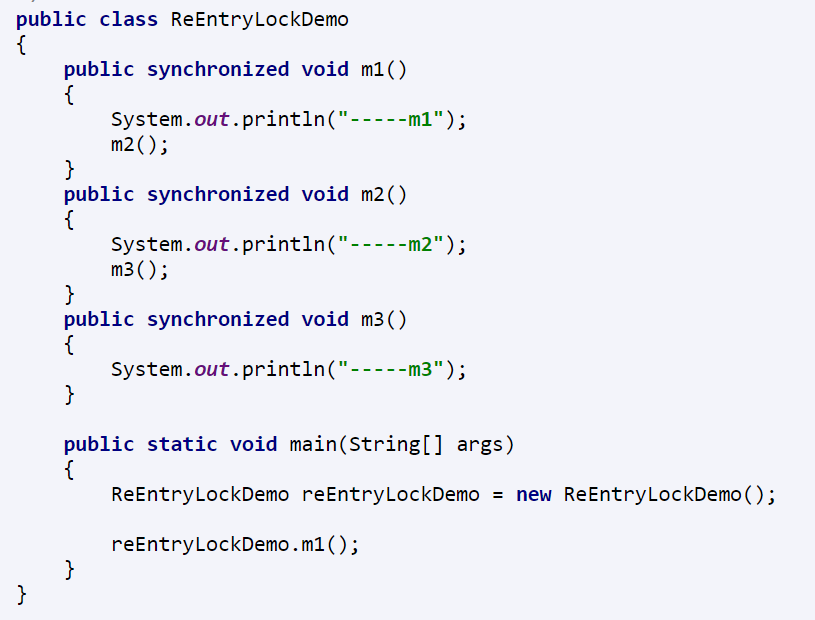
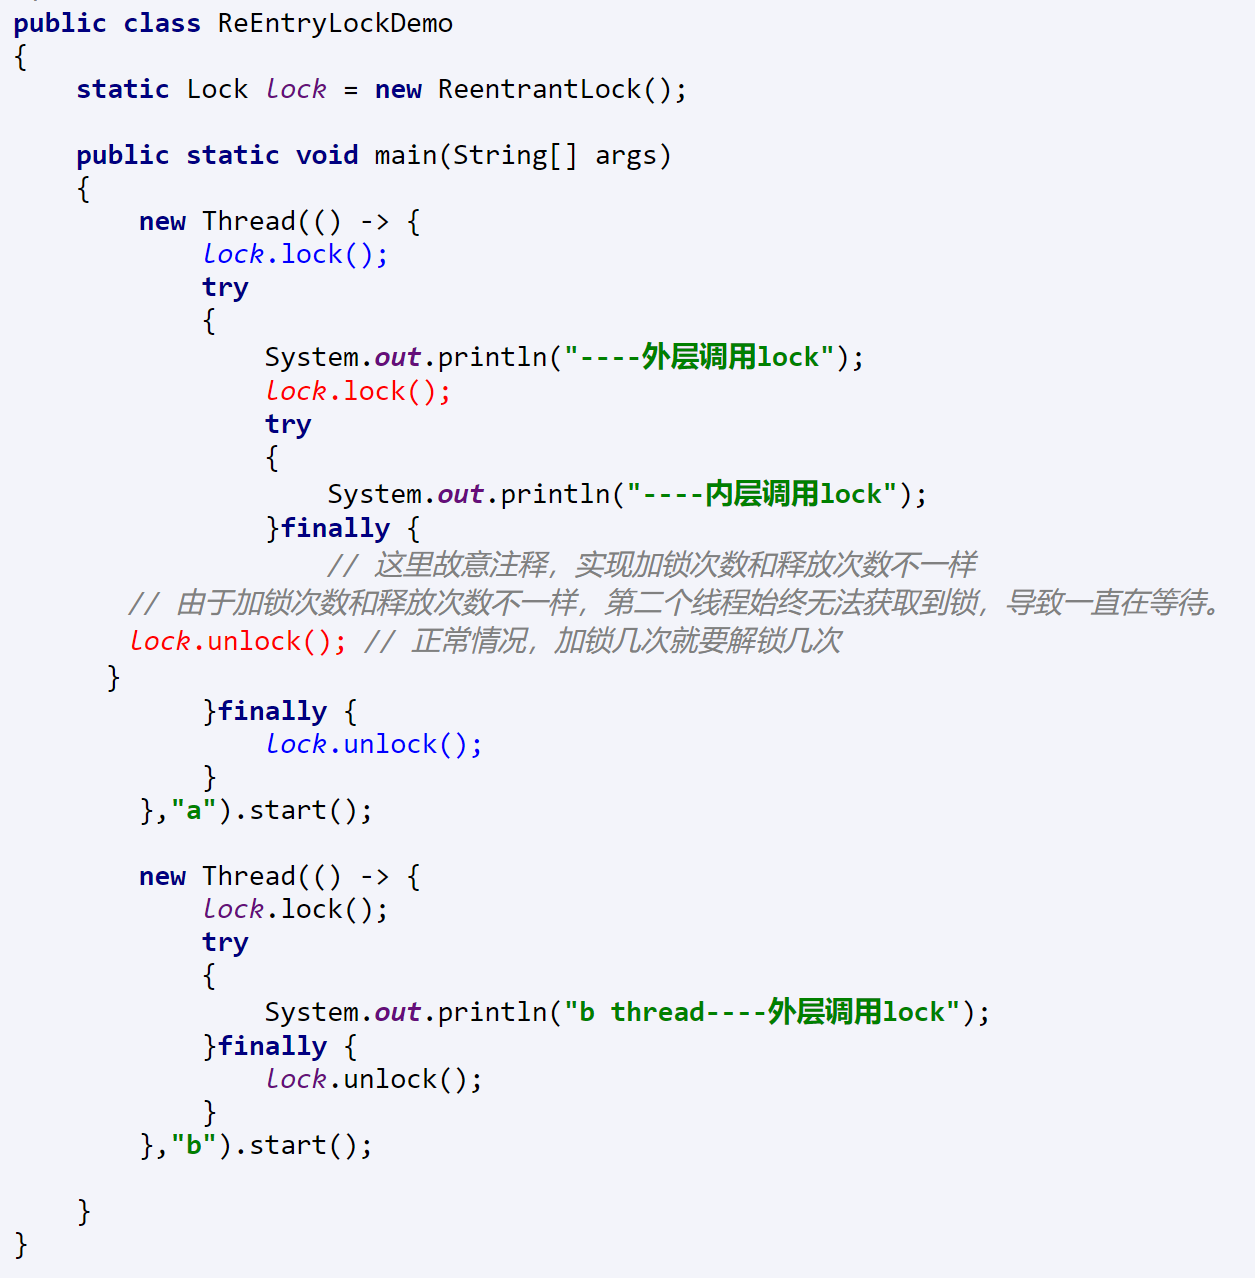
每个锁对象拥有一个锁计数器和一个指向持有该锁的线程的指针。
隐式锁 如synchronized 都是可重用锁
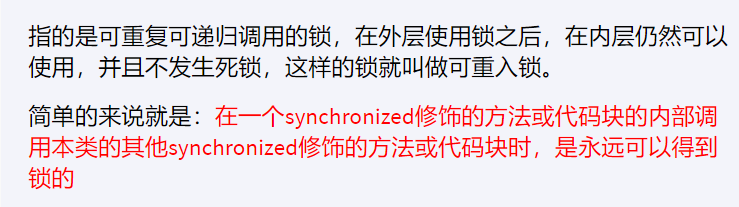

原理
同步块
同步方法
显式锁
只需要将自己写的 redis 锁具有 lock,unlock 功能,以及锁的计数器 就可以
只有 redis 中 hash 满足 kkv 结构
(锁名|UUID|计数器)``redisLock:uuid:valueNumber
锁名都是相同的,UUID 只是删除时进行判断,和可重用锁时进行判断
因此应该用 hash 版 redis 锁代替之前的 string 版本
LOCK
为了 lock 希望将下面一段抽取出来
希望将这一段抽进一个方法变成lock
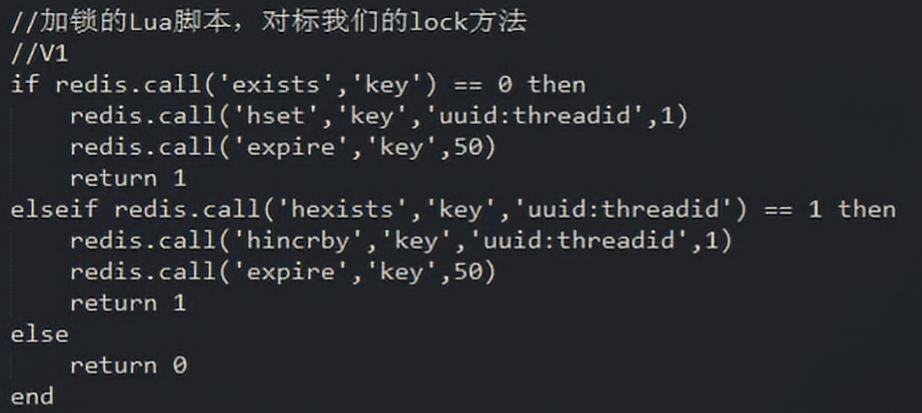
Lock: 加锁并计数的lua脚本
判断锁是否存在,存在创建,计数默认为1,设置过期时间 如果判断存在,且是自己的,说明重用,设置计数器加一,设置过期时间
返回0没有,返回1有
 优化为
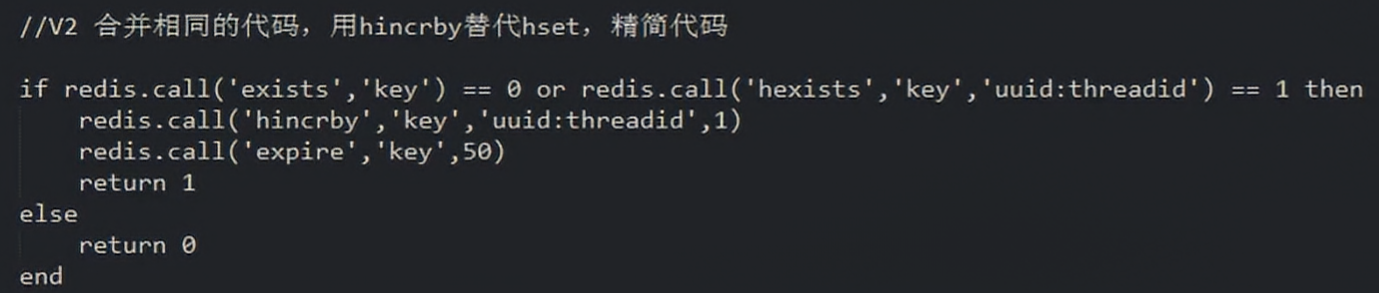 然后改写为lua脚本
hincrby如果没有会自动创建

lua 脚本中返回给 java 的数据,也就是 ruturn 中:0 会被转换为 false,任何非零的整数 (通常是 1 或其他正数/负数) 会被转换为 true
lua 脚本中 : call 方法返回 0 (不存在)或者 1 存在
Lua 语言本身的真值和假值规则:在 Lua 的逻辑判断中(例如 if 条件),lua 认为 0 和 空字符串 都是 true, 除了 false 和 nil 为假, 其他值都为真。
unLOCK
unlock: 将这一段抽进一个方法变成unlock
判断锁是否存在且为自己的,然后计数器减一 判断计数器如果为零直接删除 如果不存在直接返回
call方法 return 0 时,它通常表示执行成功并返回一个整数值,就相当于java中return
计数器减到0说明已经全部被解锁,可以删除
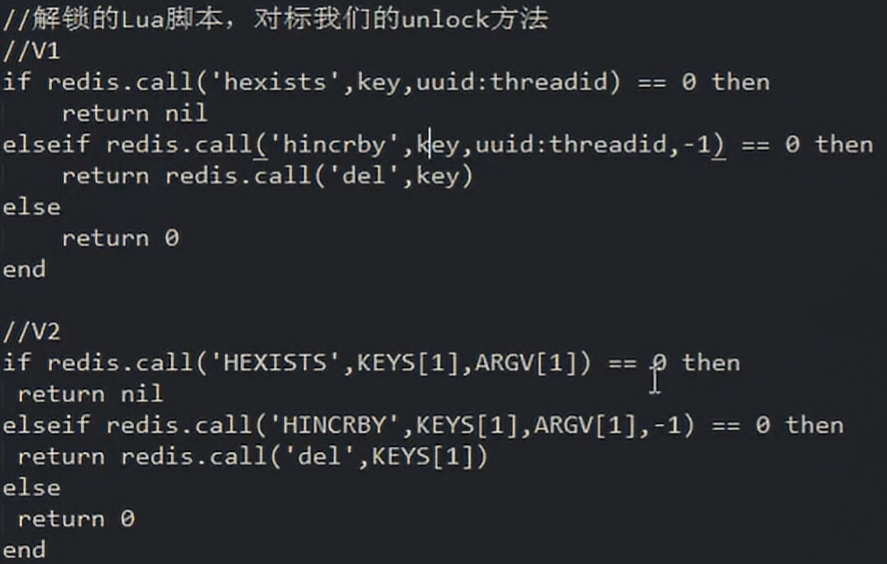
目前 UUID 是在锁中生成的, 重用锁会导致 UUID 不一样,后期使用一个工厂造锁来解决
lua 整合进 java 程序
实现 Lock 锁 , 按照 Lock 锁的规范进行设计
引入工厂模式: 就是提前给你 new 好各种类型,自己选择使用
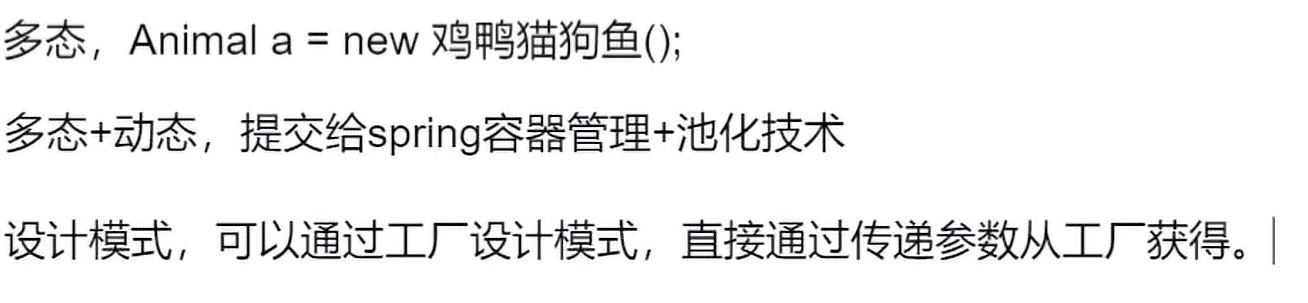
- 问题
uuid 在锁中制造,而通过工厂造锁,重用时工厂会重新造锁,导致 uuid 都不一样 ,同一个线程出现了两个 uuid 为了确保同一个线程共用一个锁,需要设置为同一个UUID
因此锁工厂引入固定的 uuid,这样不同线程生成相同的 uuid,而在 redis 锁中 uuid 是线程工厂的 uuid+ 对应线程
解决: 在工厂中制造好 UUID, 不在锁中制作
- 问题
有时业务执行时间长,如何自动续时长
通过 java 的定时器 timer
写一个自动续时的 lua 脚本,比如过了 10s 还没有完成,自动加钟
加钟脚本
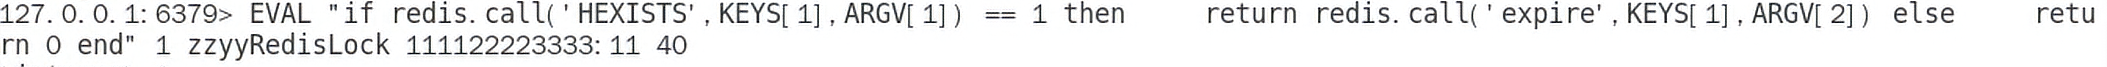
DistributedLockFactory工厂
@Component
public class DistributedLockFactory
{
    @Autowired
    private StringRedisTemplate stringRedisTemplate;
    private String lockName;
    private String uuid;

    public DistributedLockFactory()
    {
        this.uuid = IdUtil.simpleUUID();
    }

    public Lock getDistributedLock(String lockType)
    {
        if(lockType == null) return null;

        if(lockType.equalsIgnoreCase("REDIS")){
            this.lockName = "zzyyRedisLock";
            return new RedisDistributedLock(stringRedisTemplate,lockName,uuid);
        }else if(lockType.equalsIgnoreCase("ZOOKEEPER")){
            this.lockName = "zzyyZookeeperLockNode";
            //TODO zookeeper版本的分布式锁
            return null;
        }else if(lockType.equalsIgnoreCase("MYSQL")){
            //TODO MYSQL版本的分布式锁
            return null;
        }

        return null;
    }
}
timer 是 java 的定时器,用 timer 来实现续期
RedisDistributedLock
lock()会调用 tryLock()
tryLock()调用tryLock(long time, TimeUnit unit)
import cn.hutool.core.util.IdUtil;
import org.springframework.data.redis.core.StringRedisTemplate;
import org.springframework.data.redis.core.script.DefaultRedisScript;
import org.springframework.stereotype.Component;

import java.util.Arrays;
import java.util.Timer;
import java.util.TimerTask;
import java.util.concurrent.TimeUnit;
import java.util.concurrent.locks.Condition;
import java.util.concurrent.locks.Lock;


/**
 * @auther zzyy
 * @create 2023-01-09 16:41
 * 我们自研的redis分布式锁,实现了Lock接口
 */
//@Component 引入DistributedLockFactory工厂模式,从工厂获得即可
public class RedisDistributedLock implements Lock
{
    private StringRedisTemplate stringRedisTemplate;

    private String lockName;//KEYS[1]
    private String uuidValue;//ARGV[1]
    private long   expireTime;//ARGV[2]


    public RedisDistributedLock(StringRedisTemplate stringRedisTemplate, String lockName, String uuid)
    {
        this.stringRedisTemplate = stringRedisTemplate;
        this.lockName = lockName;
        this.uuidValue = uuid+":"+Thread.currentThread().getId();
        this.expireTime = 30L;
    }


    @Override
    public void lock()
    {
        tryLock();
    }
    @Override
    public boolean tryLock()
    {
        try {tryLock(-1L,TimeUnit.SECONDS);} catch (InterruptedException e) {e.printStackTrace();}
        return false;
    }

    @Override
    public boolean tryLock(long time, TimeUnit unit) throws InterruptedException
    {
        if(time == -1L)
        {
            String script =
                    "if redis.call('exists',KEYS[1]) == 0 or redis.call('hexists',KEYS[1],ARGV[1]) == 1 then    " +
                            "redis.call('hincrby',KEYS[1],ARGV[1],1)    " +
                            "redis.call('expire',KEYS[1],ARGV[2])    " +
                            "return 1  " +
                    "else   " +
                            "return 0 " +
                    "end";
            System.out.println("lockName:"+lockName+"\t"+"uuidValue:"+uuidValue);
            //执行脚本为true成功,但while中为false会跳出循环,也就是需要取反
            while(!stringRedisTemplate.execute(new DefaultRedisScript<>(script,Boolean.class), Arrays.asList(lockName), uuidValue,String.valueOf(expireTime)))
            {
                //暂停60毫秒
                try { TimeUnit.MILLISECONDS.sleep(60); } catch (InterruptedException e) { e.printStackTrace(); }
            }
            //新建一个后台扫描程序,来坚持key目前的ttl,是否到我们规定的1/2 1/3来实现续期
            renewExpire();
            return true;        }
        return false;
    }


    //执行解锁脚本
    @Override
    public void unlock()
    {
        System.out.println("unlock(): lockName:"+lockName+"\t"+"uuidValue:"+uuidValue);
        String script =
                "if redis.call('HEXISTS',KEYS[1],ARGV[1]) == 0 then    " +
                        "return nil  " +
                "elseif redis.call('HINCRBY',KEYS[1],ARGV[1],-1) == 0 then    " +
                        "return redis.call('del',KEYS[1])  " +
                "else    " +
                        "return 0 " +
                "end";
        // nil = null 1 = true 0 = false 返回值有三套值
        Long flag = stringRedisTemplate.execute(new DefaultRedisScript<>(script, Long.class), Arrays.asList(lockName), uuidValue, String.valueOf(expireTime));

        //如果没锁会返回null,说明超时,自己的锁会自动消失,不会影响其他线程创建自己的锁(key:value,number)
        if(null == flag)
        {
            throw new RuntimeException("this lock doesn't exists,o(╥﹏╥)o");
        }
    }
	  //自动续期
    private void renewExpire()

    {
        String script =
                "if redis.call('HEXISTS',KEYS[1],ARGV[1]) == 1 then     " +
                        "return redis.call('expire',KEYS[1],ARGV[2]) " +
                "else     " +
                        "return 0 " +
                "end";
        //timer是java的定时器
        new Timer().schedule(new TimerTask()
        {
            @Override
            public void run()
            {
                if (stringRedisTemplate.execute(new DefaultRedisScript<>(script, Boolean.class), Arrays.asList(lockName), uuidValue, String.valueOf(expireTime)))
                {
                    renewExpire();
                }
            }
        },(this.expireTime * 1000)/3);
    }


    //====下面两个暂时用不到,不再重写
    //不需要考虑中断,用完就删就行了
    @Override
    public void lockInterruptibly() throws InterruptedException
    {

    }
    @Override
    public Condition newCondition()
    {
        return null;
    }
}
//V8.0,实现自动续期功能的完善,后台自定义扫描程序,如果规定时间内没有完成业务逻辑,会调用加钟自动续期的脚本
//V8.0,实现自动续期功能的完善,后台自定义扫描程序,如果规定时间内没有完成业务逻辑,会调用加钟自动续期的脚本
public String sale()
{
    String retMessage = "";

    Lock redisLock = distributedLockFactory.getDistributedLock("redis");
    redisLock.lock();
    try    {
        //1 查询库存信息
        String result = stringRedisTemplate.opsForValue().get("inventory001");
        //2 判断库存是否足够
        Integer inventoryNumber = result == null ? 0 : Integer.parseInt(result);
        //3 扣减库存,每次减少一个
        if(inventoryNumber > 0)
        {
            stringRedisTemplate.opsForValue().set("inventory001",String.valueOf(--inventoryNumber));
            retMessage = "成功卖出一个商品,库存剩余:"+inventoryNumber;
            System.out.println(retMessage+"\t"+"服务端口号"+port);
            //暂停120秒钟线程,故意的,演示自动续期的功能。。。。。。
            try { TimeUnit.SECONDS.sleep(120); } catch (InterruptedException e) { e.printStackTrace(); }

        }else{
            retMessage = "商品卖完了,o(╥﹏╥)o";
        }
    }finally {
        redisLock.unlock();
    }
    return retMessage+"\t"+"服务端口号"+port;
}
CAP
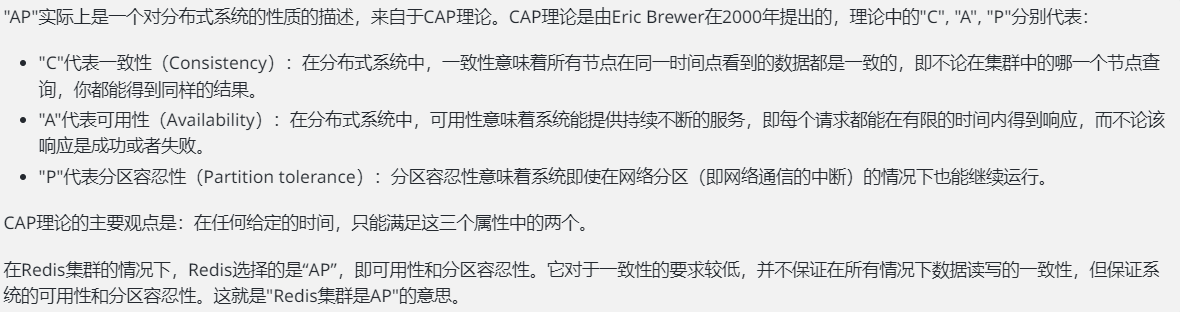
面试
如何编写?
首先按照 Java 中 juc 中的 LOCK 规范实现方法,
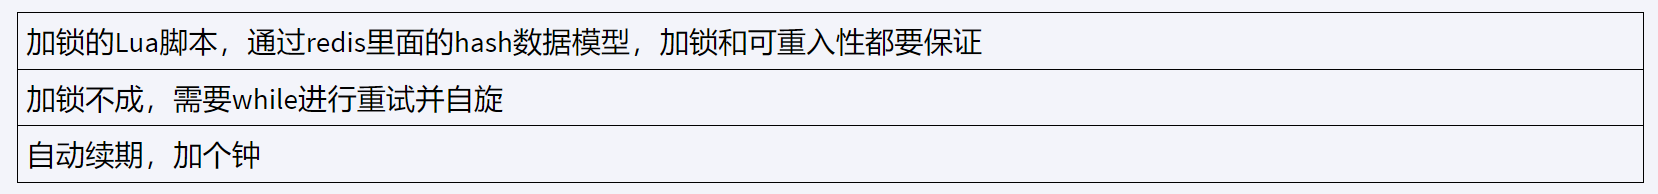
上锁逻辑 : 使用 Hset , KKV 结构来进行加锁,通过 while 以一定间隔, 重试,不断 自旋 来判断是否能够达到锁,通过 lua 脚本来保证原子性,通过续期来保证时间长的业务能够自动续期顺利完成业务
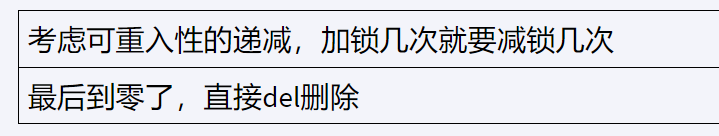
解锁逻辑 : 确保保证是自己的锁,只能自己删除自己的锁,通过锁的计数器,为 0 才可以删除
使用Redis实现分布式锁 | Redis --- Distributed Locks with Redis | Redis
Redlock 算法和底层源码分析
使用Redis实现分布式锁 _ Redis --- Distributed Locks with Redis _ Redis (03_03_2024 21_53_05) ↗
单点故障
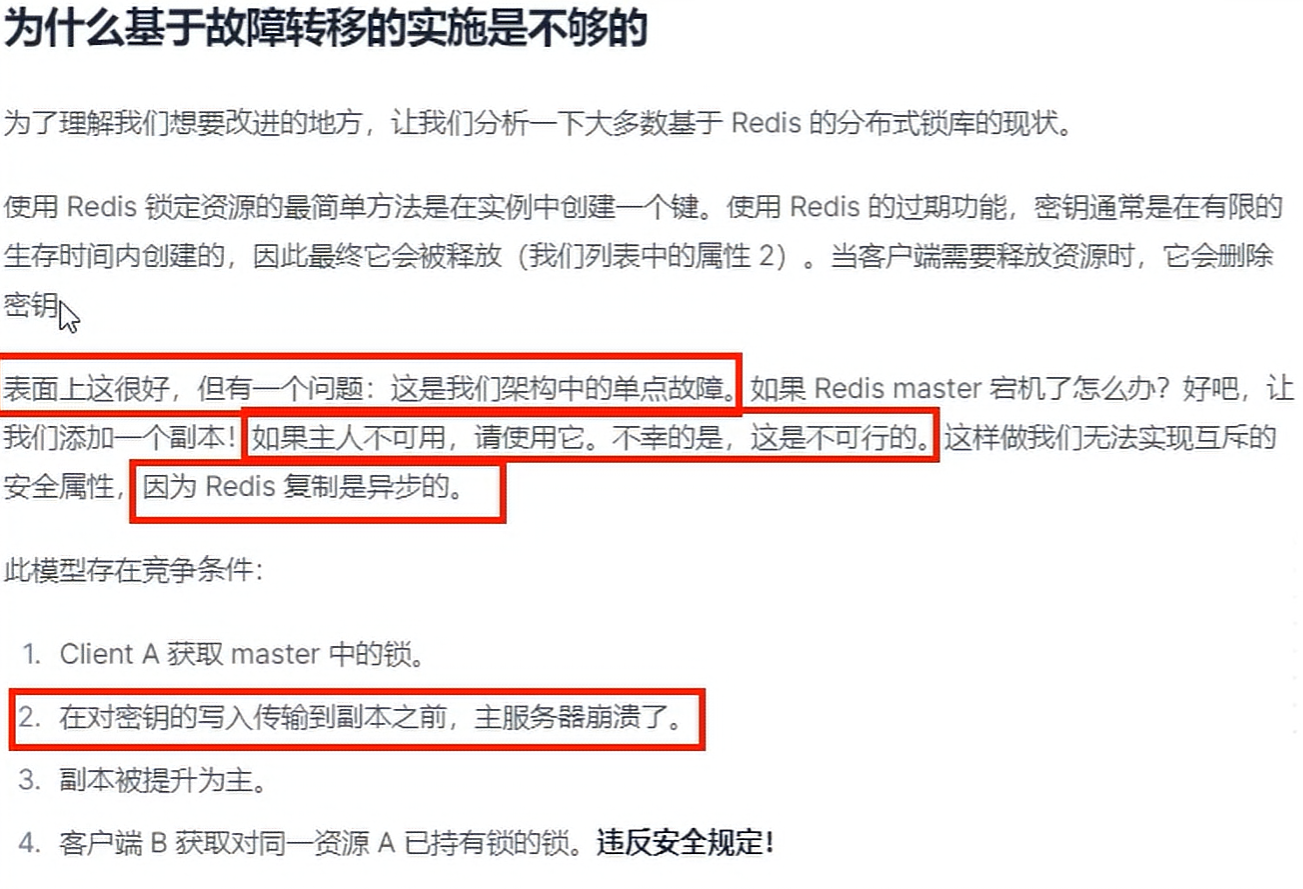
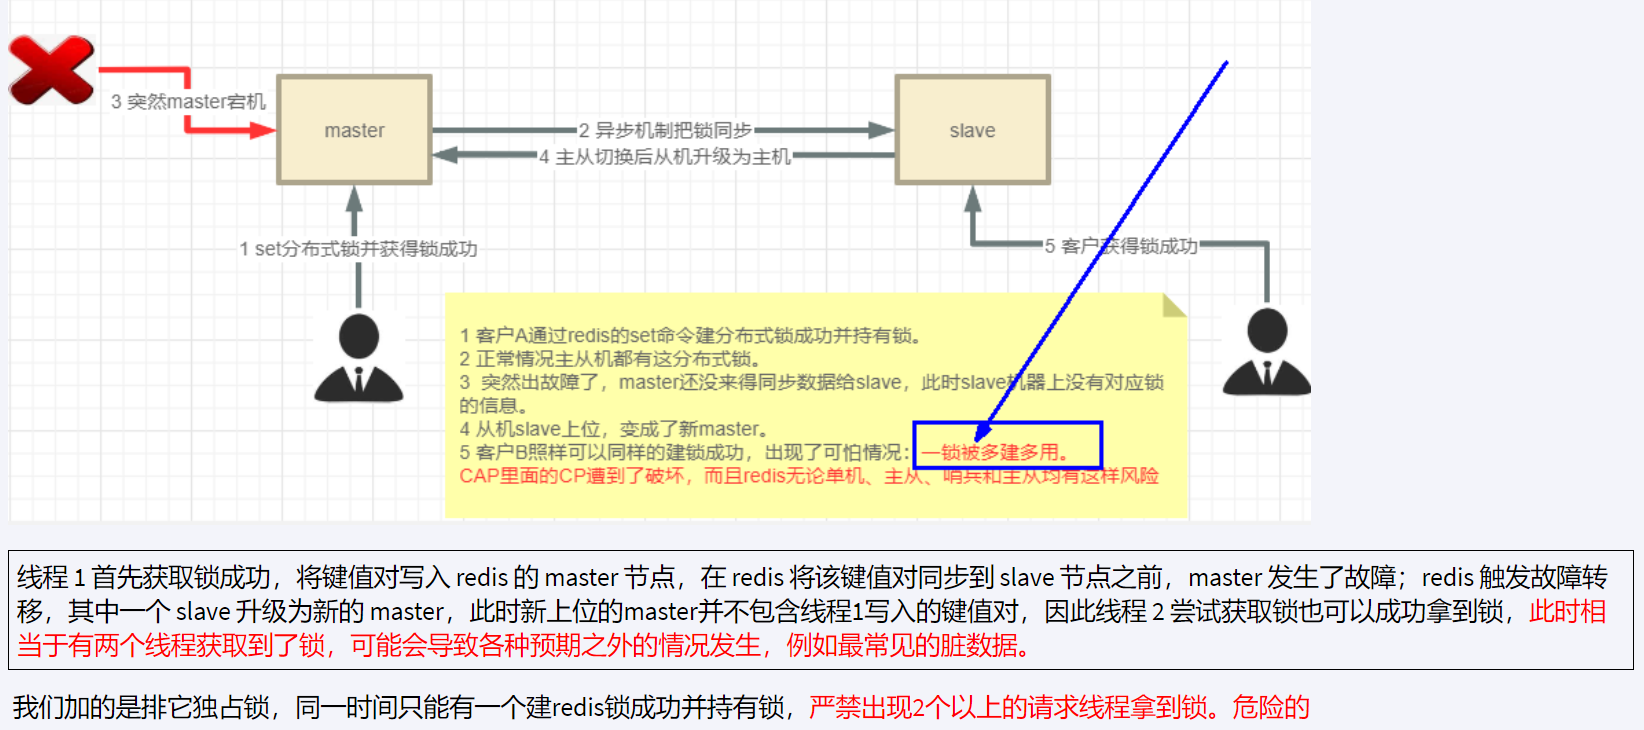
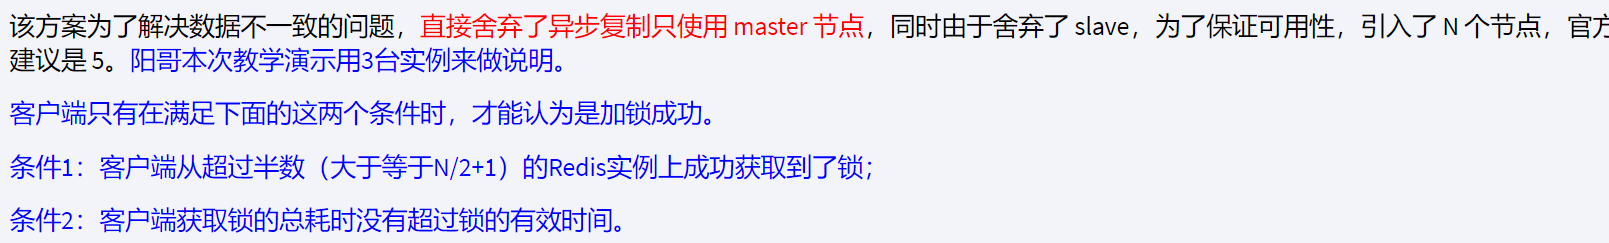
单点故障: 由于之前 redis 中复制是异步的,突然宕机会出现锁消失的问题,线程一拿到锁后,master 还未将锁写入 slave 后就挂了,然后 slave 被选举为了 master,线程二看到新的 master 没有锁后就创建了自己的锁,此时出现两个以上线程拿到了锁,这种情况是严禁的,解决方法就是舍弃 slave 节点,而是创建锁节点,只能从锁节点获取锁
Redlock
8. 分布式锁和同步器 · redisson/redisson Wiki (github.com)
redisson/redisson: Redisson
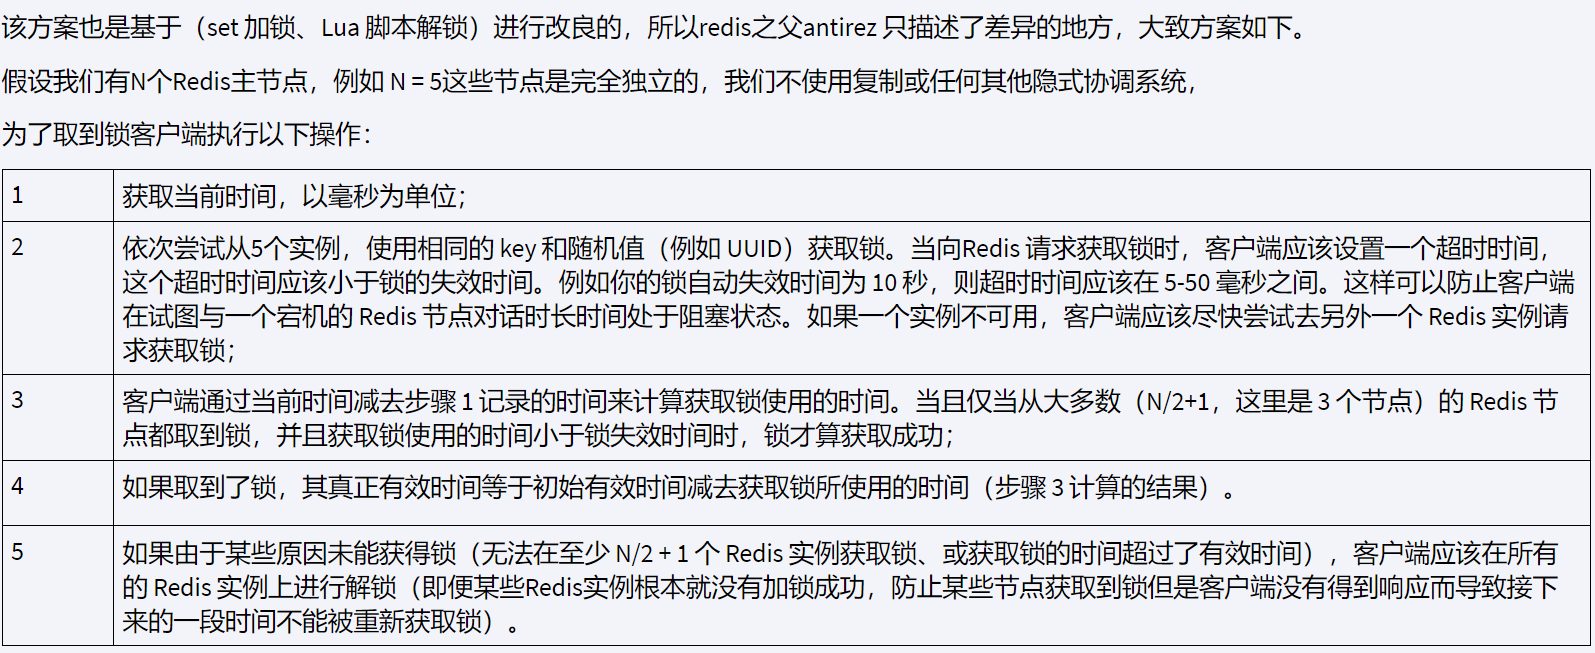
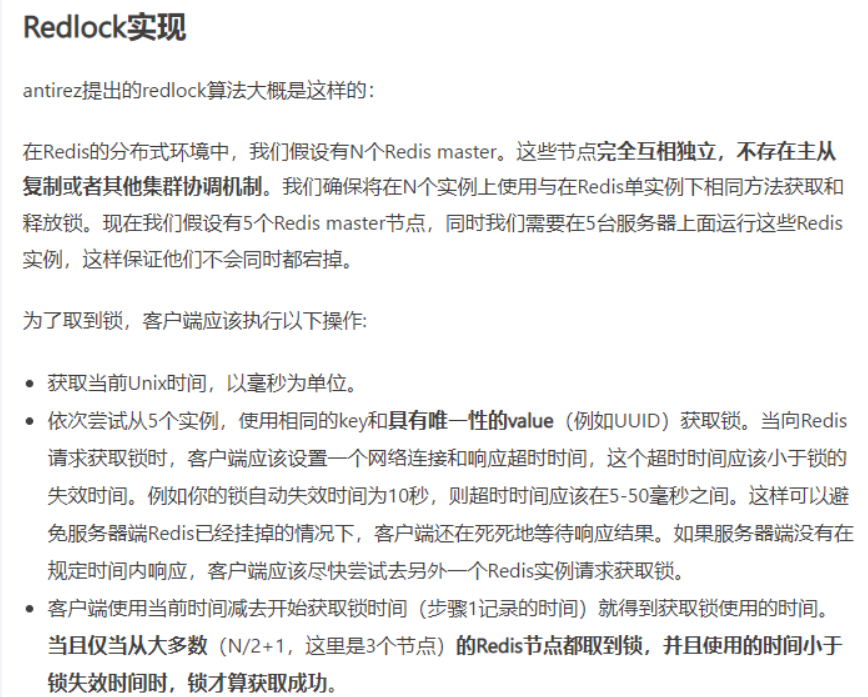
使用多个 reids, 每个都是 master, 没有使用复制或任何其他隐式协调系统
Redlock
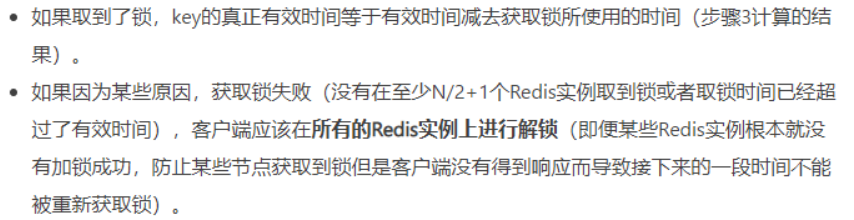
第二步就是依次尝试在每个Redis 实例上获取锁,如果超过超时时间就直接下一次redis获取,最后尝试完所有的redis所消耗的时间,减去第一步消耗的时间就是获取锁耗时
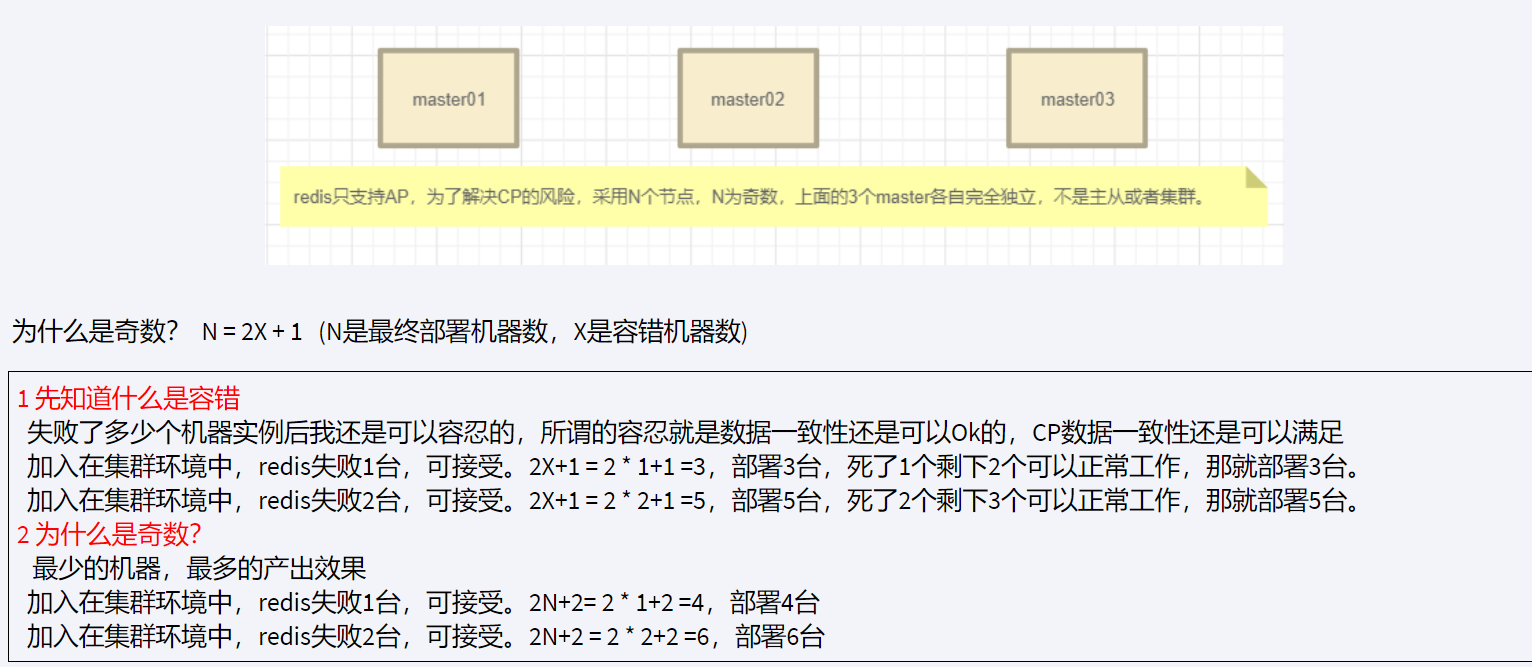
容错公式
2x+1
x为挂掉的个数
配置
1. 改pom

        <dependency>
            <groupId>org.redisson</groupId>
            <artifactId>redisson</artifactId>
            <version>3.19.1</version>
        </dependency>


2. 在configuration中redisConfig中的配置(或者配置yaml)

@Bean
public Redisson redisson()
{
    Config config = new Config();
    //添加多台,这里只是演示
    config.useSingleServer().setAddress("redis://192.168.111.185:6379").setDatabase(0).setPassword("111111");

  // or read config from file
//config = Config.fromYAML(new File("config-file.yaml"));

    return (Redisson) Redisson.create(config);
}
- 问题
redlock 也要判断是否是自己的锁
//V9.1,引入Redisson对应的官网推荐RedLock算法实现类
@Autowired
private StringRedisTemplate stringRedisTemplate;

@Value("${server.port}")
private String port;

@Autowired
private DistributedLockFactory distributedLockFactory;

//V9.1,引入Redisson对应的官网推荐RedLock算法实现类
@Autowired
private Redisson redisson;
public String saleByRedisson()
{
    String retMessage = "";

    RLock redissonLock = redisson.getLock("zzyyRedisLock");
    redissonLock.lock();

    try{
        //1 查询库存信息
        String result = stringRedisTemplate.opsForValue().get("inventory001");
        //2 判断库存是否足够
        Integer inventoryNumber = result == null ? 0 : Integer.parseInt(result);
        //3 扣减库存,每次减少一个
        if(inventoryNumber > 0)
        {
            stringRedisTemplate.opsForValue().set("inventory001",String.valueOf(--inventoryNumber));
            retMessage = "成功卖出一个商品,库存剩余:"+inventoryNumber;
            System.out.println(retMessage+"\t"+"服务端口号"+port);
        }else{
            retMessage = "商品卖完了,o(╥﹏╥)o";
        }
    }finally {
        //改进点,只能删除属于自己的key,不能删除别人的
        if(redissonLock.isLocked() && redissonLock.isHeldByCurrentThread())
        {
            redissonLock.unlock();
        }
    }
    return retMessage+"\t"+"服务端口号"+port;
}
源码解析
依旧是加锁,可重入,续命,解锁
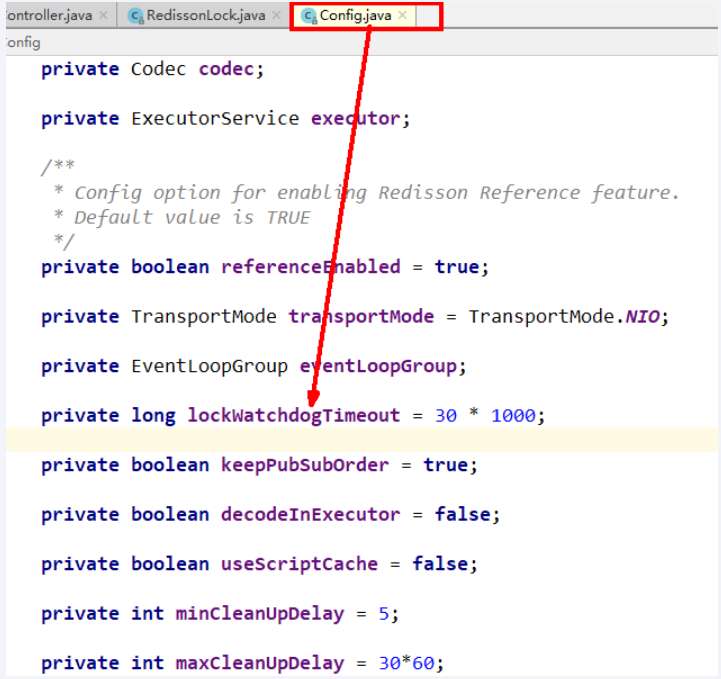
redissonLock 默认过期时间 30 秒,
java
新new出的默认30秒
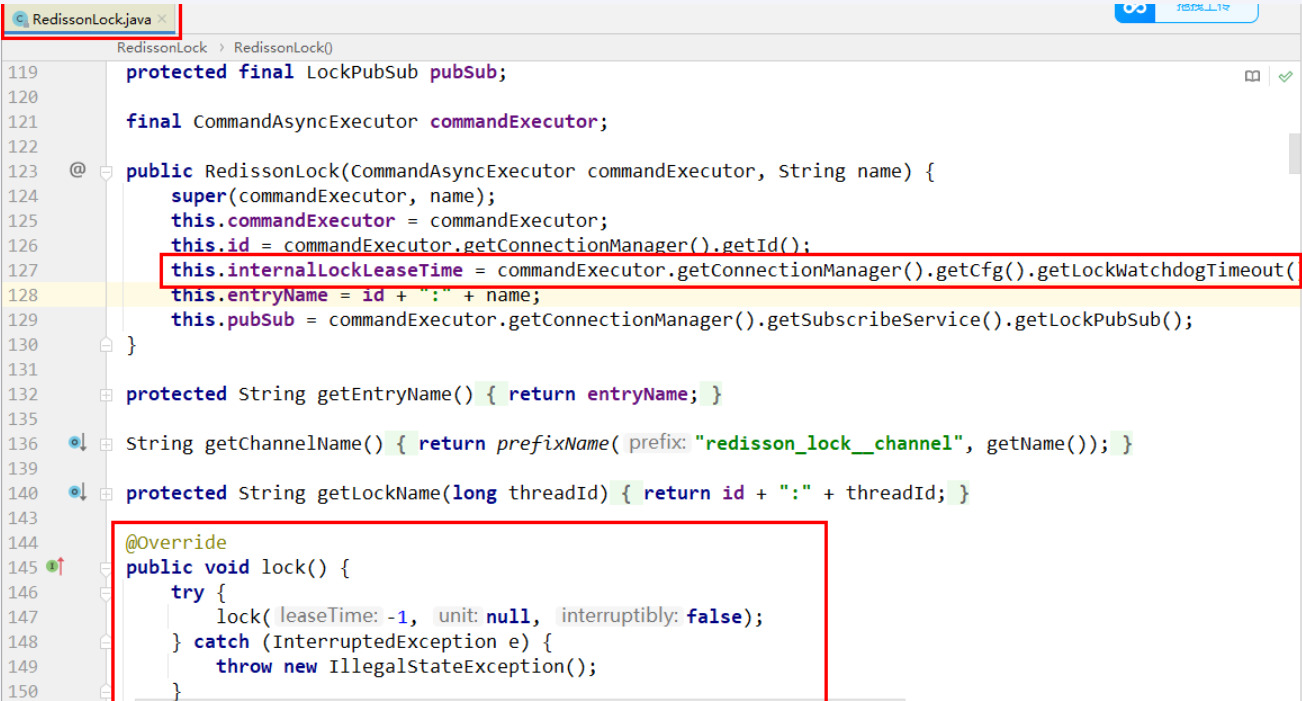
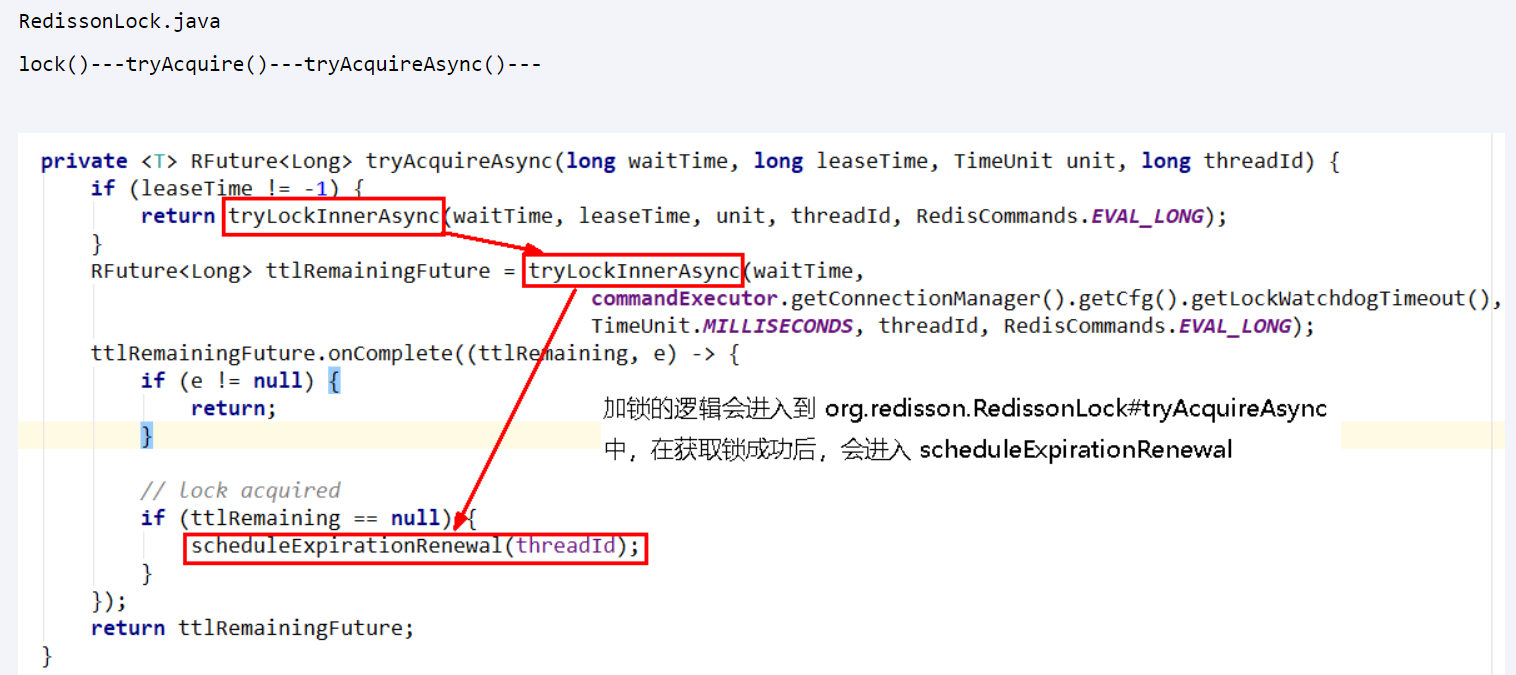
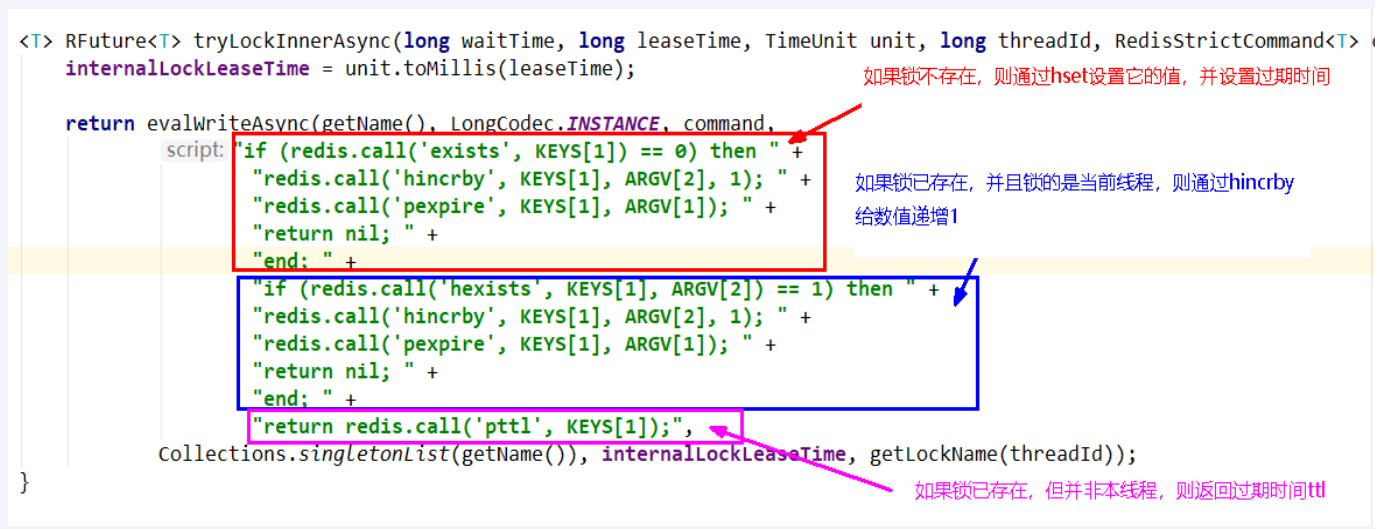
加锁过程
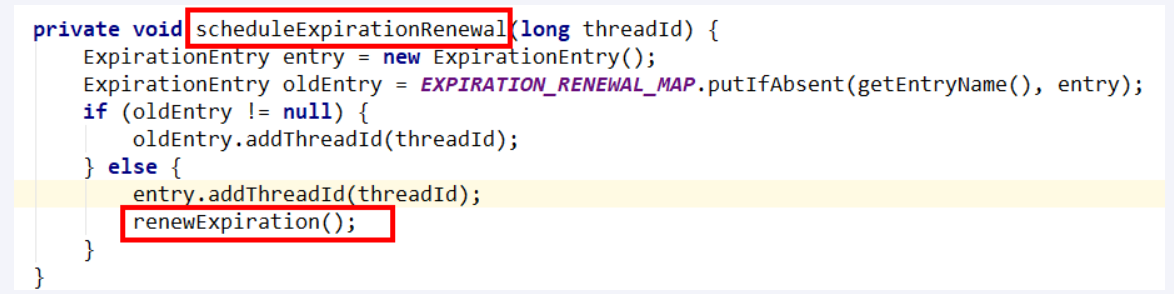
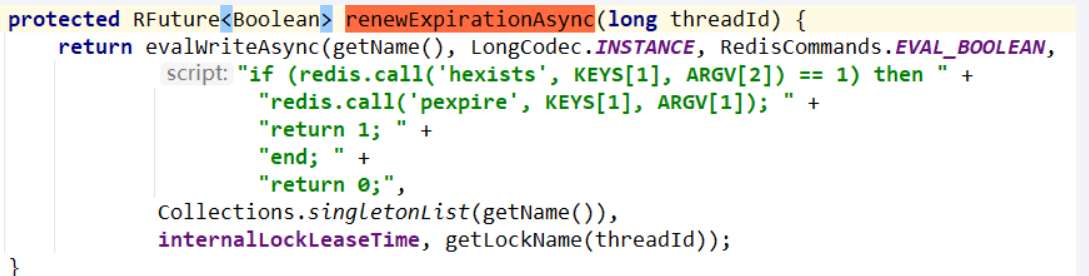
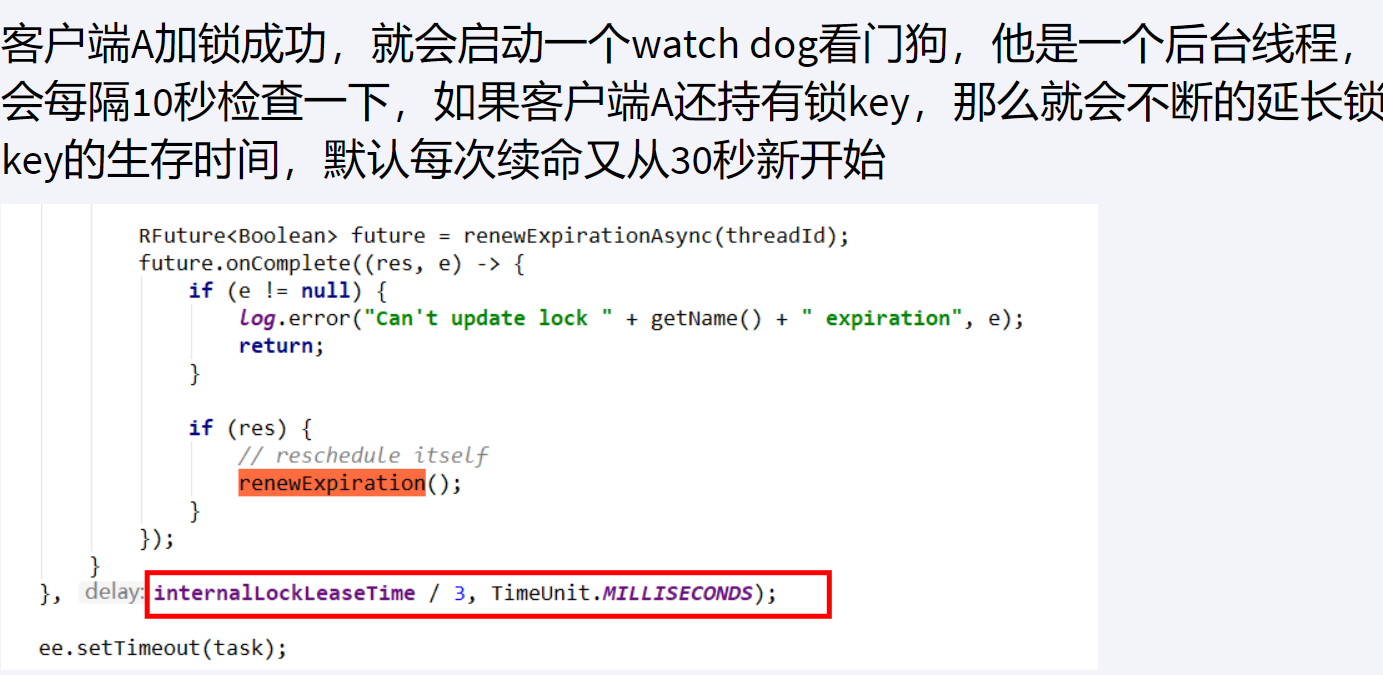
scheduleExpriationRenewal给缓存续期
续期
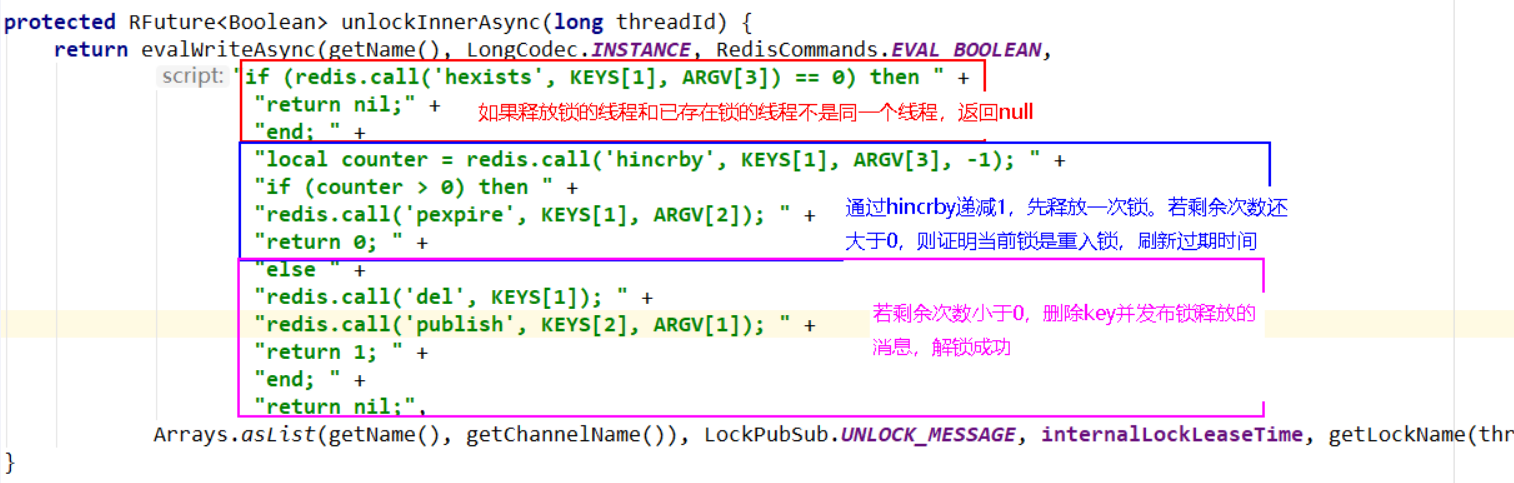
解锁
多机案例
基于故障转移实现的 reids 主从无法实现真正的 redlock
java
        <dependency>
            <groupId>org.redisson</groupId>
            <artifactId>redisson</artifactId>
            <version>3.19.1</version>
        </dependency>


server.port=9090
spring.application.name=redlock


spring.swagger2.enabled=true


spring.redis.database=0
spring.redis.password=
spring.redis.timeout=3000
spring.redis.mode=single
//池化技术
spring.redis.pool.conn-timeout=3000
spring.redis.pool.so-timeout=3000
spring.redis.pool.size=10

spring.redis.single.address1=192.168.111.185:6381
spring.redis.single.address2=192.168.111.185:6382
spring.redis.single.address3=192.168.111.185:6383
Redis 缓存过期淘汰策略
内存设置
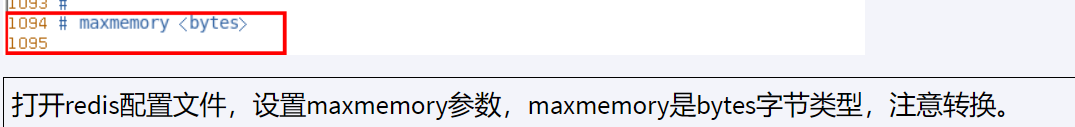
如果不设置或者设置为 0, 在 64 位操作系统下不限制内存大小,在 32 位操作系统最多使用 3GB ,一般推荐设置 Redis 内存为最大物理内存的四分之三
maxmemory
maxmemory 128mb
超出内存会爆 OOM
修改 : 配置文件/命令 config set maxmemory xxx
查看 : info memory / config get maxmemory
过期键的删除策略
如果一个键是过期的,那它到了过期时间之后是不是马上就从内存中被被删除呢?
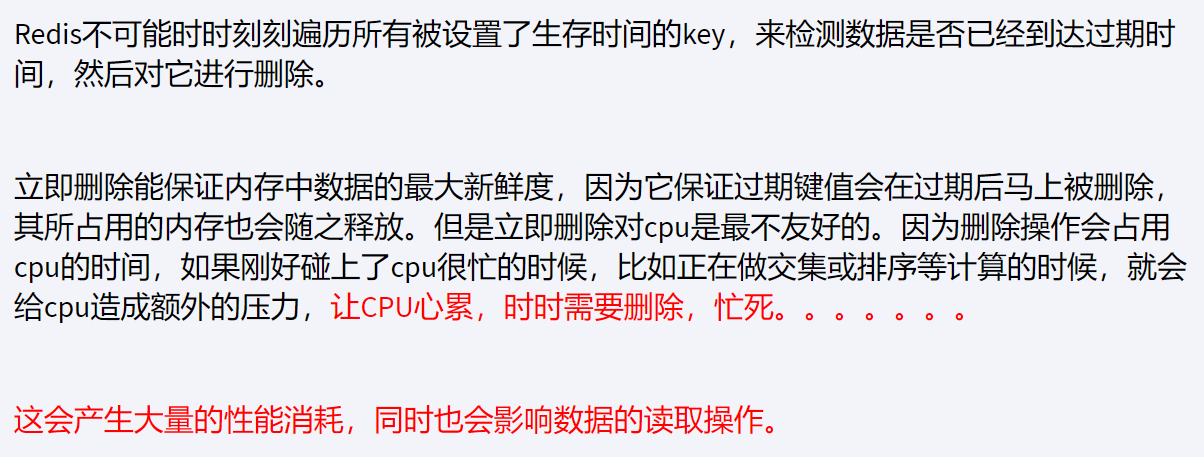
立即删除
对 CPU 不好,用处理器性能换取储存空间 (时间换空间)
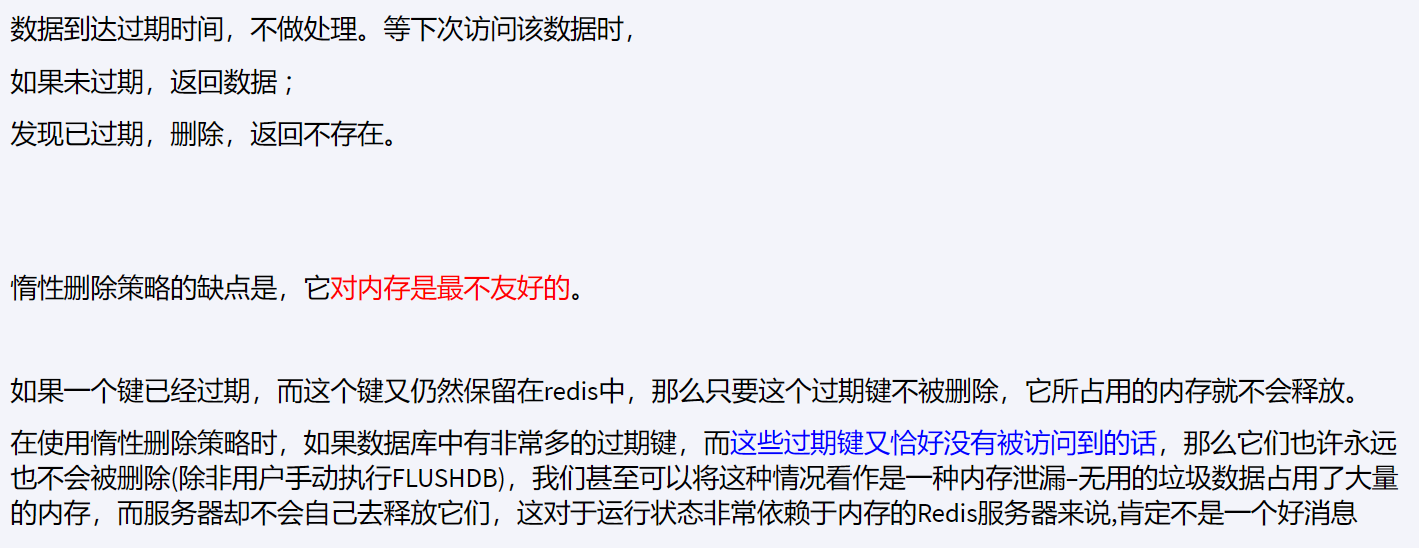
惰性删除
开启 : lazyfree-lazy-eviction=yes
对内存不友好,用储存空间换取处理器性能 (空间换时间)
只扫描访问的 key, 没有访问的 key 即使过期也不知道,不会被删除
定期删除
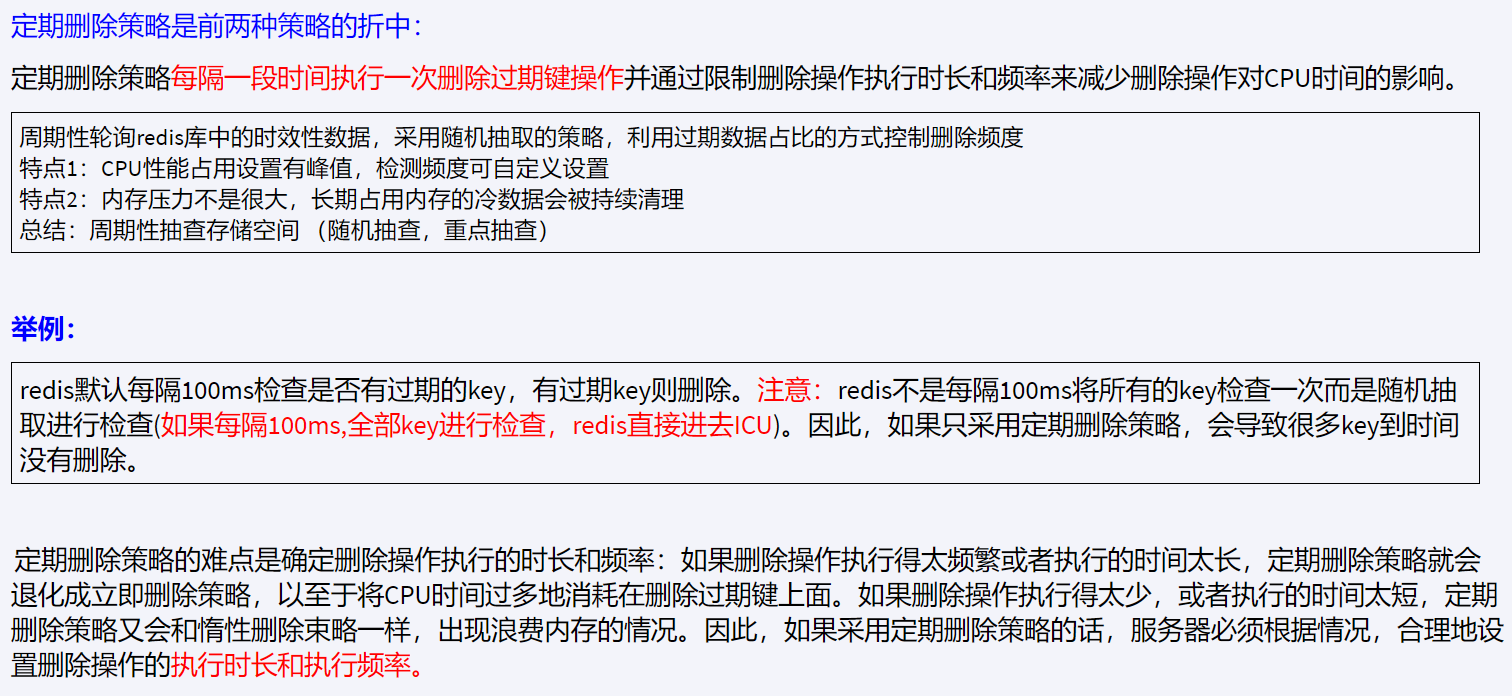
定期删除是前两种检查策略的折中
每隔一段时间抽取 一部分key 检查是否有过期的 key, 会产生漏网之鱼
缓存淘汰策略
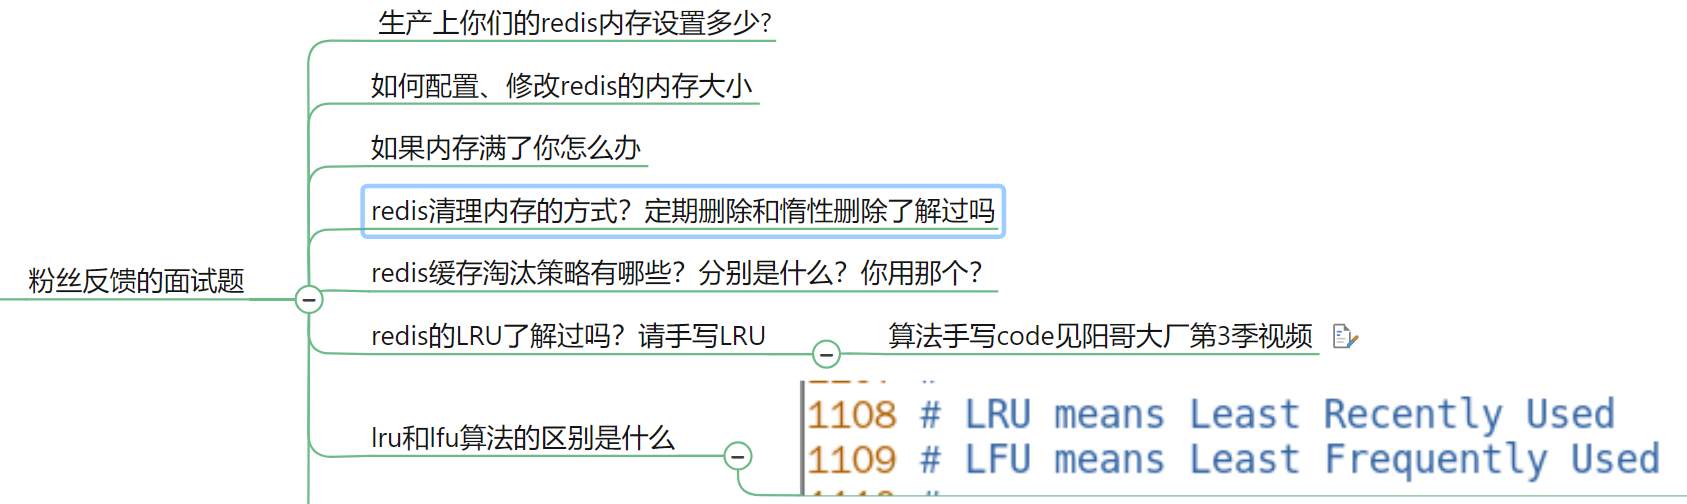
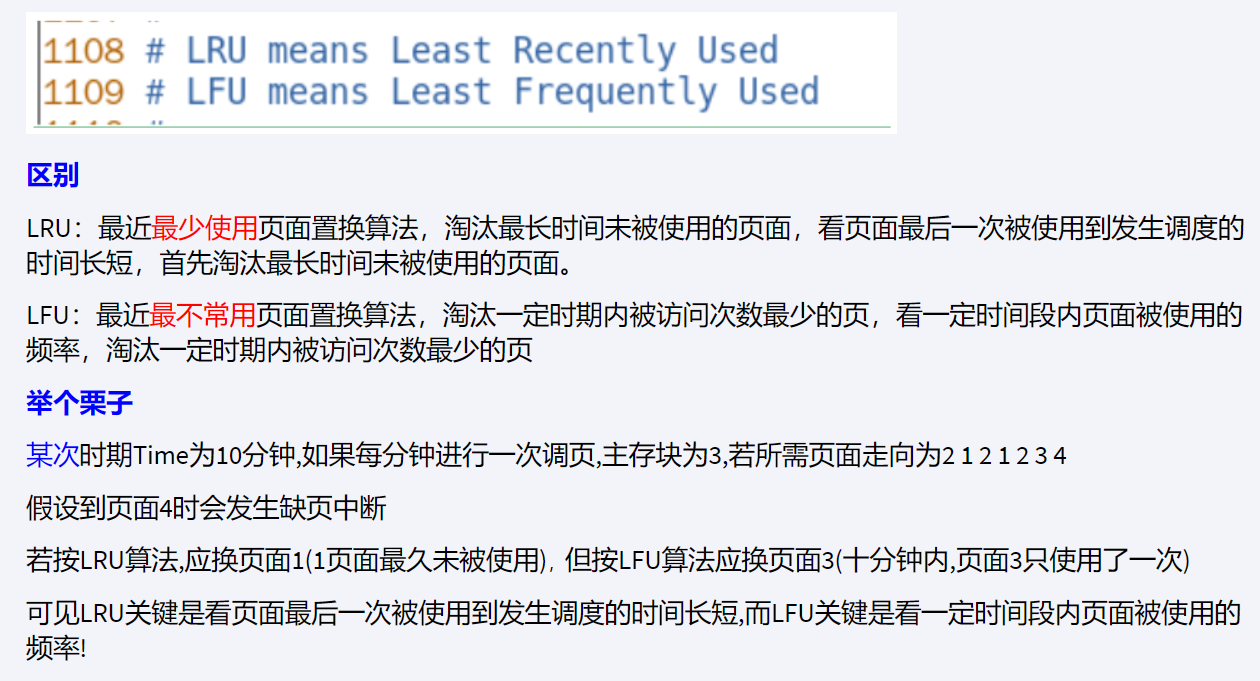
lru和lfu算法的区别是什么
LRU:最近 最少使用 页面置换算法,使用时间上来讲
LFU:最近 最不常用 页面置换算法,频率上来讲
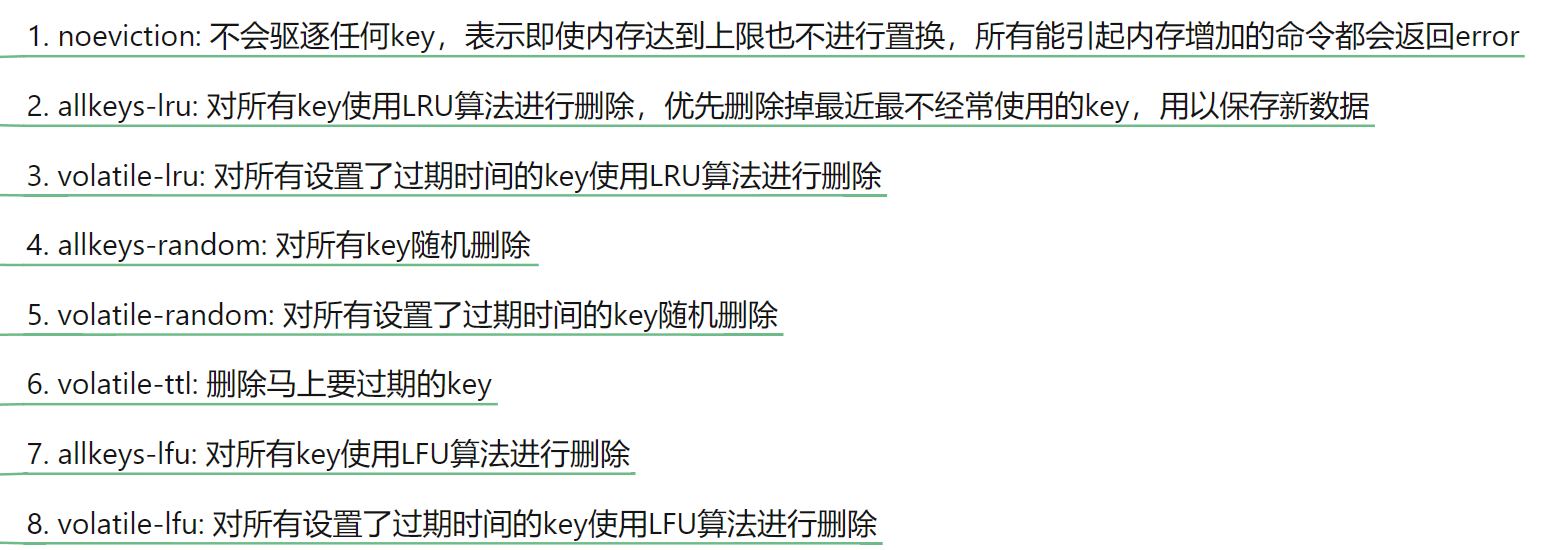
一共八种
两个维度 : 过期键中筛选/所有键中筛选
四个方面 : LRU/LFU/random/ttl
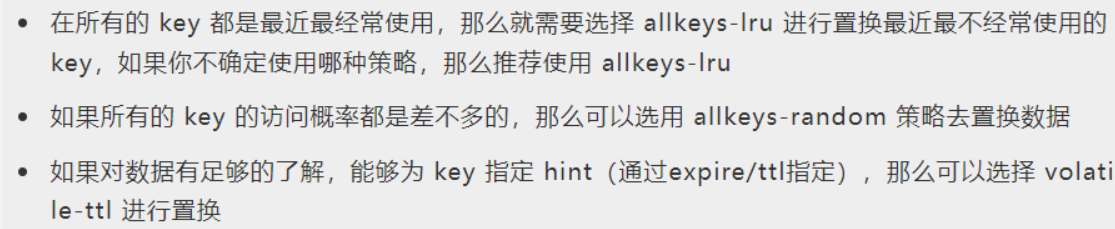
配置
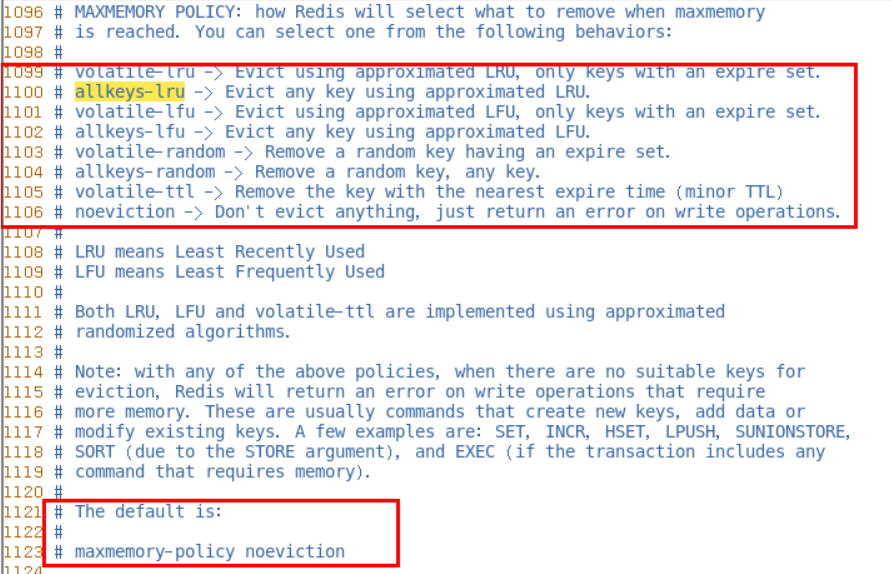
缓存配置建议
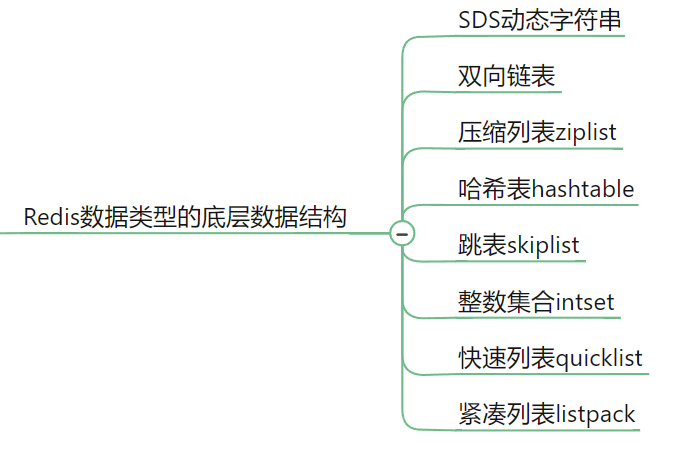
Redis 经典五大类型源码及底层实现
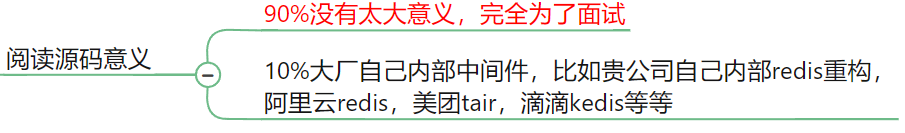
这一章完全为了面试,没有太多学习的意义
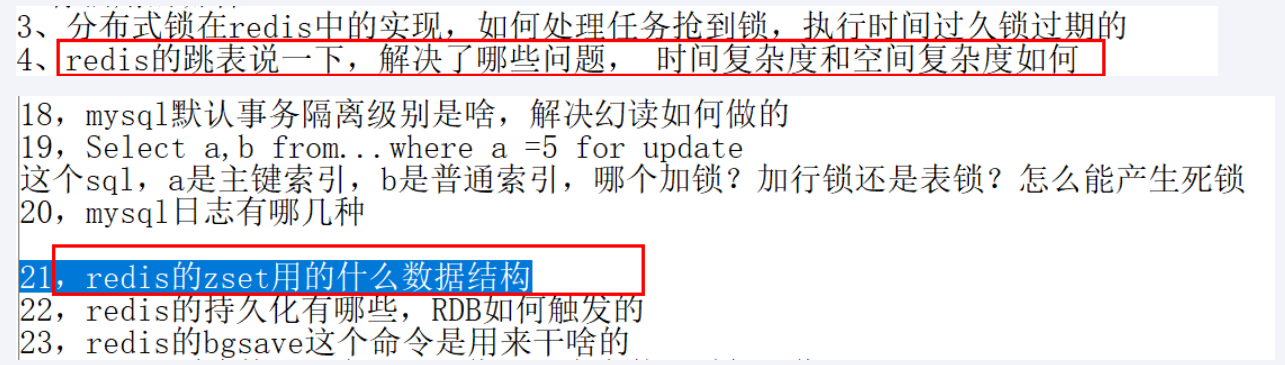
面试
高性能设计之 epoll 和 IO 多路复用深度解析
总结
资料
- 起步思维: 官网
- 排除故障思维 : 日志
^u0ikb3